
La conversación sobre IA local suele empezar mal planteada. Se pregunta cuál herramienta es mejor antes de definir para qué se usará, con qué hardware y...

Mientras las grandes tecnológicas gastan miles de millones en GPUs, el proyecto open source Colibri ejecutó GLM-5.2, un modelo de 744 mil millones de parámetros, en...

Una GPU vieja no tiene por qué terminar relegada a un cajón. En 2026, una tarjeta como la GeForce GTX 1080, lanzada en 2016 con 8...


Correr LLMs locales en una GPU de 8GB no depende de encontrar un modelo milagroso, sino de elegir bien la cuantización, repartir las tareas entre modelos...

Discord prepara un posible Game Mode detectado en el código de su cliente de escritorio. La función, todavía sin anuncio oficial, aparece descrita como una opción...
Esta semana, los jugadores de GeForce tienen grandes novedades: el muy esperado CONTROL Resonant de Remedy Entertainment se lanza el 24 de septiembre con trazado de...


La decodificación especulativa puede acelerar de forma perceptible la respuesta de un modelo local sin cambiar la salida final validada por el modelo principal.
La plataforma de agentes locales de Perplexity ahora es compatible con PC equipados con tarjetas gráficas GeForce RTX (Windows), lo que permite a más usuarios ejecutar...

NVIDIA ha lanzado Nemotron 3.5 ASR Streaming 0.6B, un modelo de reconocimiento automático de voz (ASR) con 600 millones de parámetros diseñado para transcripción multilingüe en...
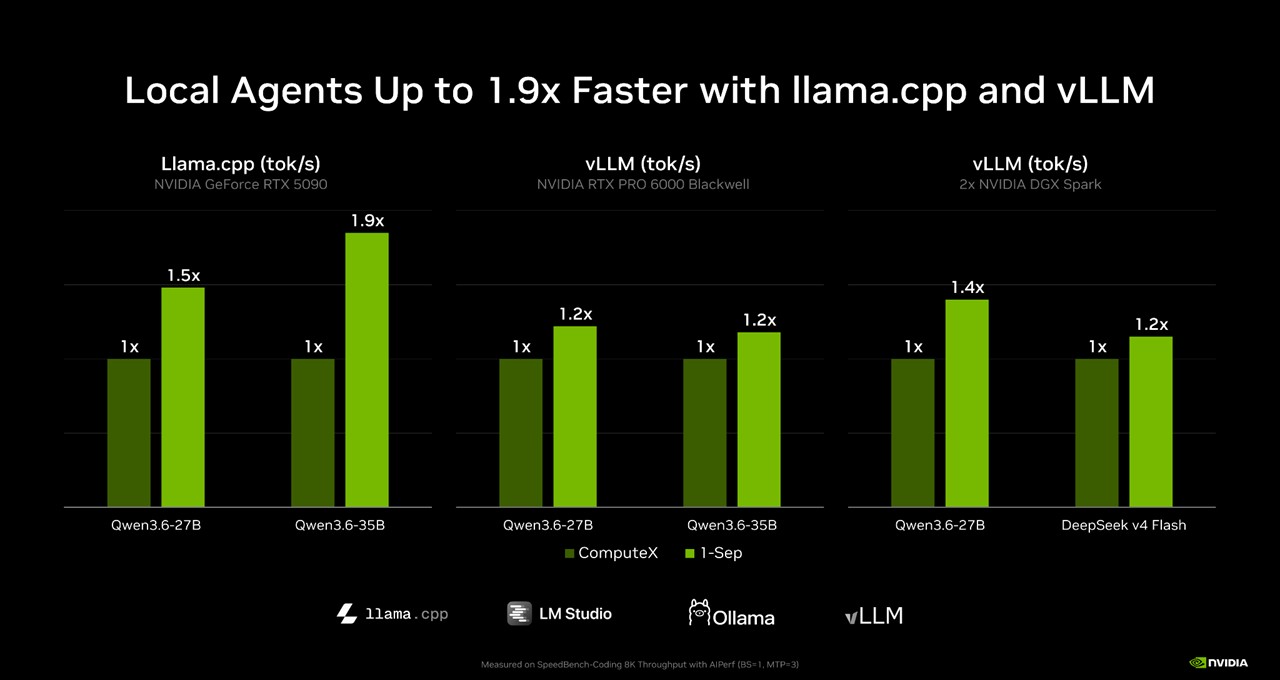
NVIDIA PAIR es una herramienta gratuita y de código abierto que permite usar el poder de cómputo inactivo de varios PCs en tu red doméstica para...

En hardware modesto, la discusión no debería comenzar con el modelo más grande disponible, sino con una pregunta más útil: cuánto margen real deja la GPU...

En el mundo de la inteligencia artificial, el fine-tuning de modelos de lenguaje es una tarea compleja que suele requerir hardware costoso y conocimientos técnicos avanzados....

Shieldstral es un clasificador multimodal de 3B parámetros desarrollado por Mistral AI que evalúa la seguridad de contenido en texto e imágenes. A diferencia de otros...


Muchos usuarios de IA local cometen el mismo error: usar un solo modelo para todo. En la práctica, ese enfoque rara vez da los mejores resultados....
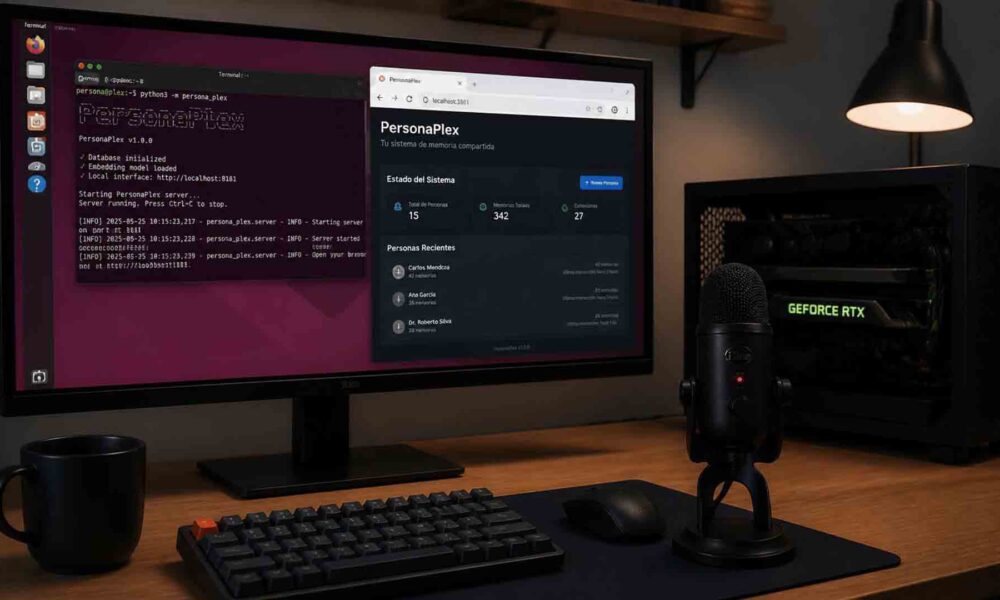

PersonaPlex es una IA de voz desarrollada por NVIDIA para mantener conversaciones en tiempo real con una dinámica más natural que la de los asistentes convencionales....


Por primera vez en la historia, la GPU más popular en Steam es una tarjeta para laptop: la RTX 4060 Laptop (3.81% de los sistemas). Este...


Si quieres ejecutar modelos de lenguaje grandes (LLMs) como Llama 3, Mistral o Phi-3 en tu propia computadora, elegir la distribución de Linux adecuada es el...

Ejecutar modelos de IA de forma local se ha vuelto mucho más accesible en el último año. Ya sea por privacidad, menor dependencia de servicios externos,...

El LLM Council es una idea publicada por Andrej Karpathy para consultar varios modelos, hacer que revisen de forma anónima las respuestas de los demás y sintetizar una respuesta final...


Ejecutar modelos de lenguaje avanzados en hardware propio dejó de ser exclusivo de empresas con infraestructura de servidores. Con una tarjeta gráfica como la Nvidia GeForce...


Los modelos de lenguaje locales ya no requieren tarjetas gráficas de gama alta. En esta guía, te mostramos qué modelos puedes ejecutar según la VRAM de...
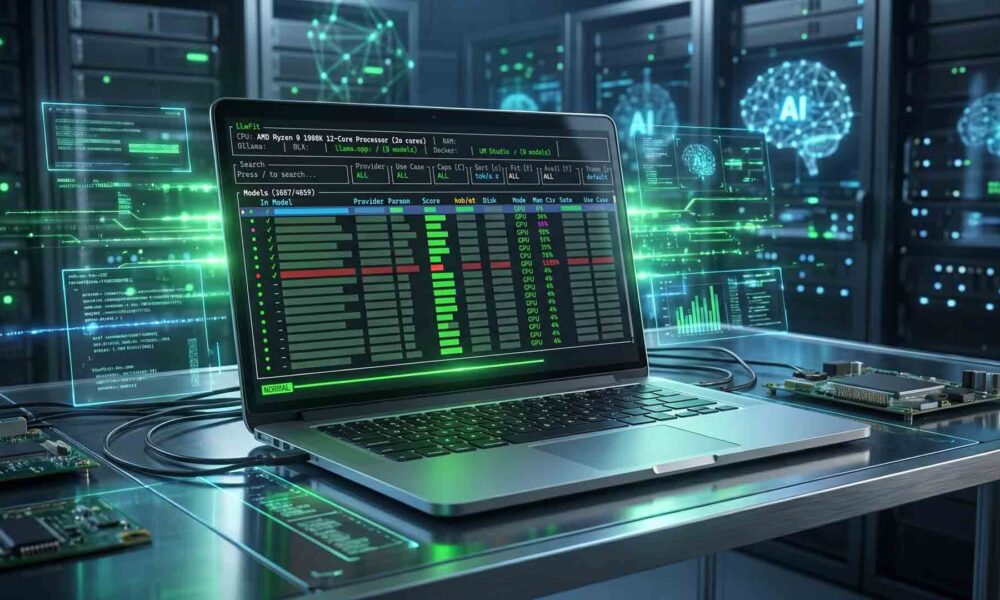


Si has descargado modelos de IA local que no funcionan en tu PC, LLMFit es la solución: analiza tu hardware en segundos y te recomienda los...
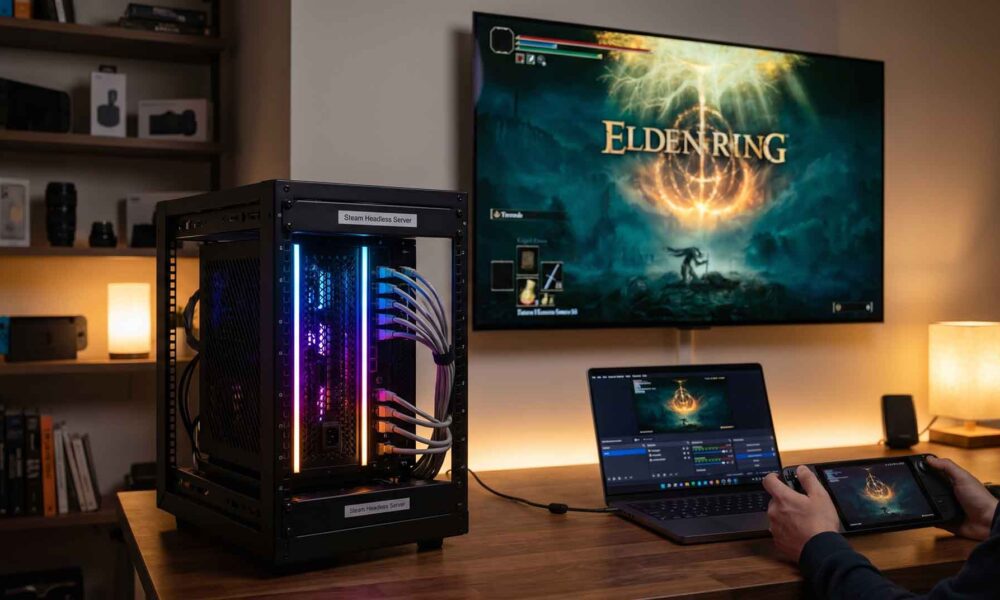

Steam Headless convierte tu servidor con GPU en una consola en la nube casera, permitiendo jugar desde cualquier dispositivo en tu red local. Aquí te explicamos...


El investigador de privacidad Alexander Hanff descubrió que Google Chrome descargó en segundo plano Gemini Nano, un modelo de IA local de 4 GB, en perfiles...
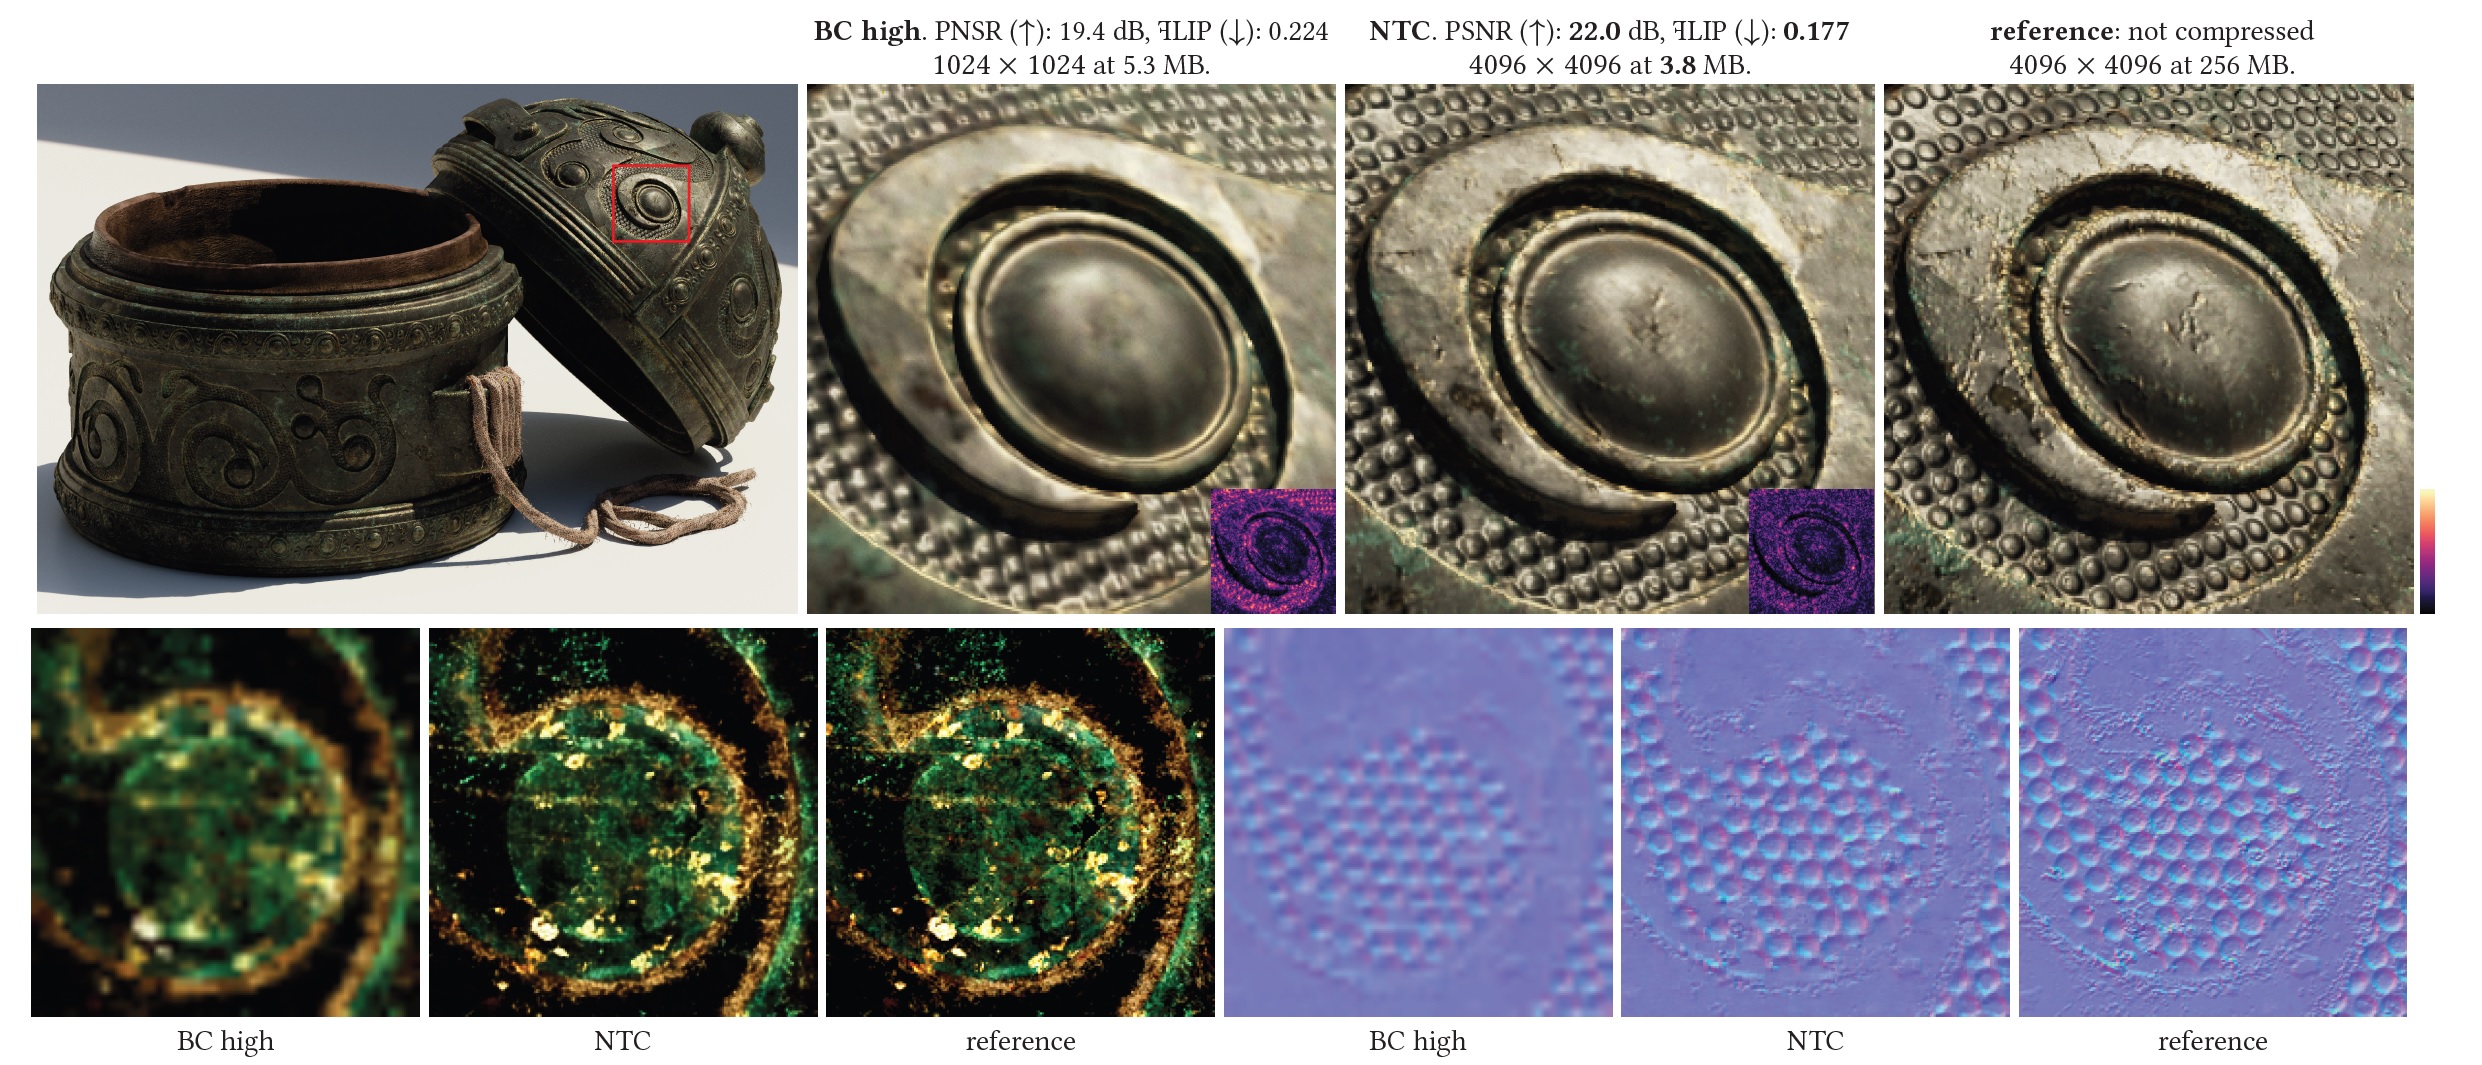
En el GTC 2026, NVIDIA presentó Neural Texture Compression (NTC), una tecnología que promete reducir drásticamente el uso de VRAM en juegos, pasando de 6.5GB a...


Aprende a instalar Pop_OS! en equipos con hardware antiguo, como GPUs Nvidia Pascal, y configúralo para gaming. Esta guía paso a paso incluye la instalación del...

Nemotron 3 Super 120B es el nuevo modelo abierto de NVIDIA, diseñado para desarrollar agentes de inteligencia artificial con alta eficiencia y capacidad de razonamiento. Con...


Ejecutar un modelo de lenguaje local en tu propio equipo es posible en casi cualquier hardware moderno: desde una laptop con procesador Snapdragon X Elite hasta...


Descubre qué GPU rinde mejor para gaming en Linux: AMD, NVIDIA o Intel. Benchmarks reales, drivers y compatibilidad comparados en 2026.


Bienvenido a una experiencia que te convierte en el arquitecto del caos cósmico más espectacular. Esta propuesta te sumerge en un universo donde las leyes de...