
Curiosidades
¿Cómo convertir una GPU vieja en el cerebro de tu casa inteligente?

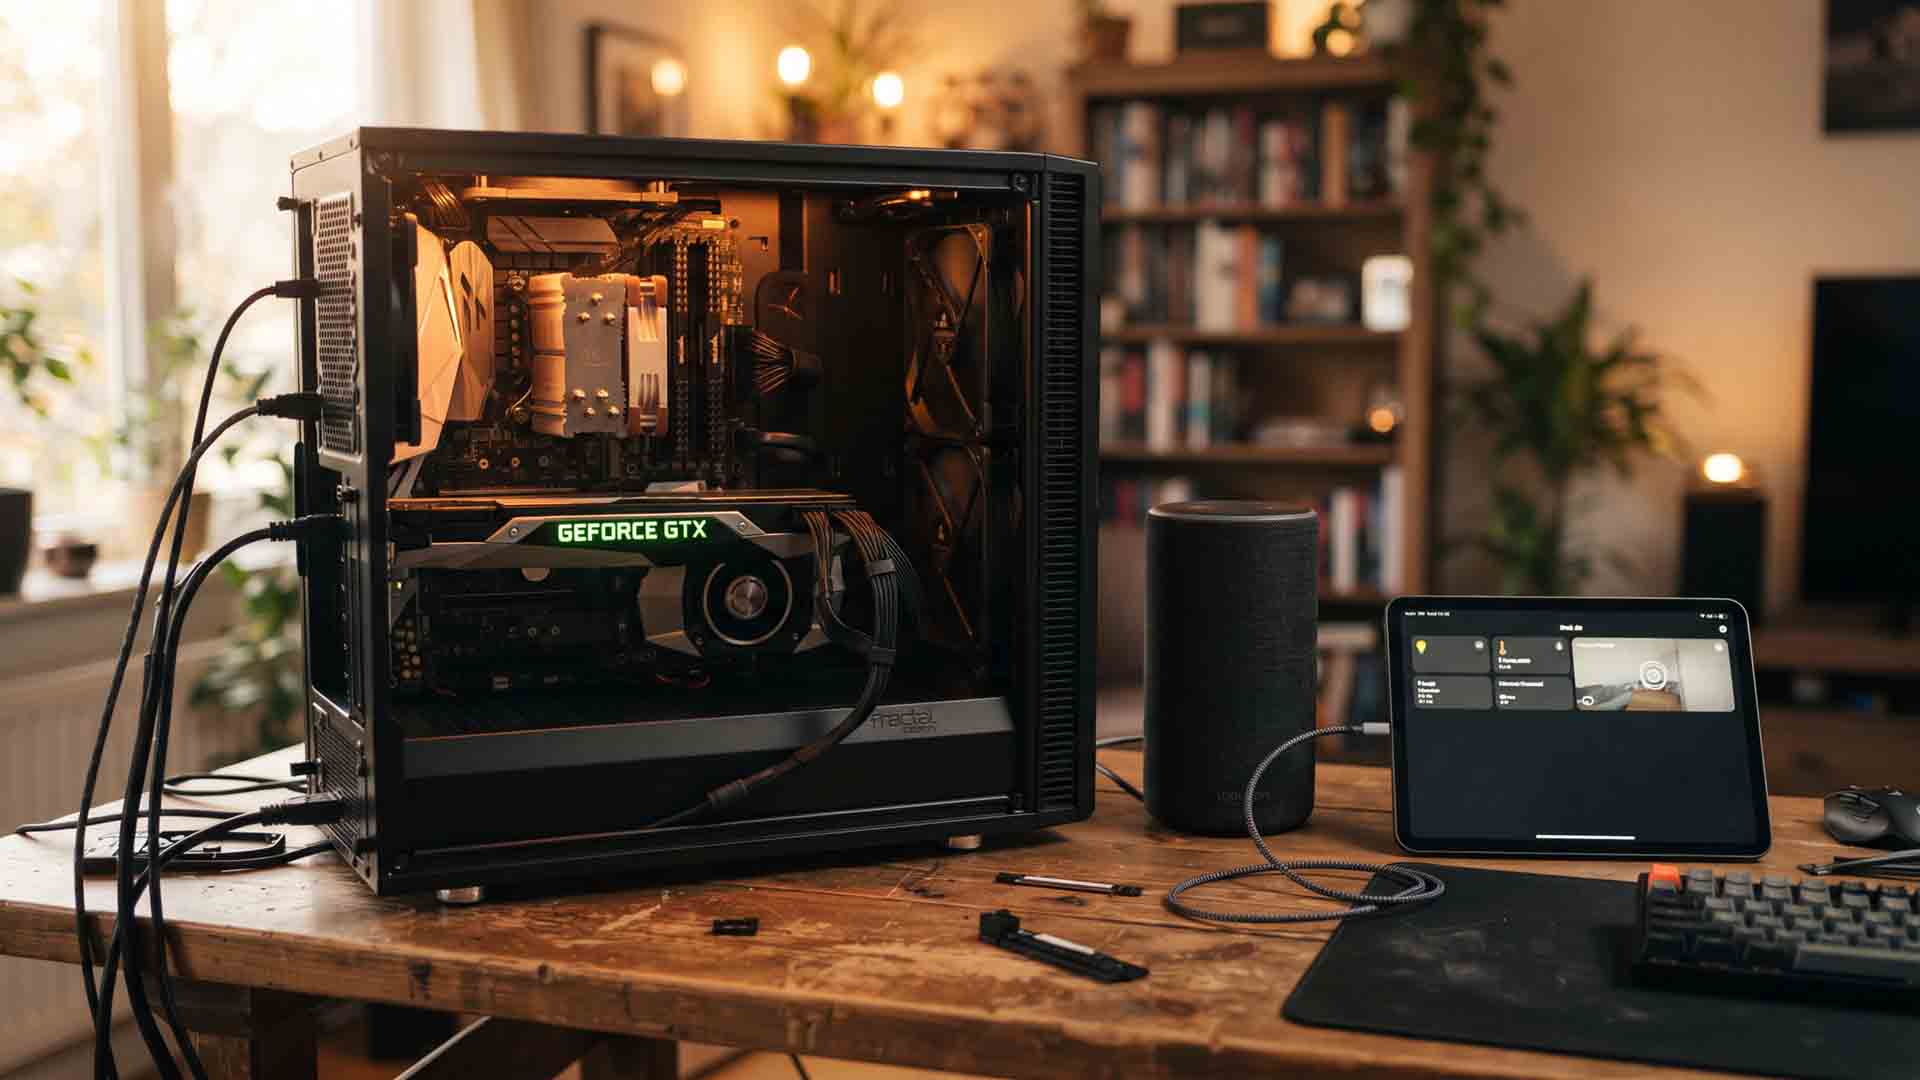
Una GPU vieja no tiene por qué terminar relegada a un cajón. En 2026, una tarjeta como la GeForce GTX 1080, lanzada en 2016 con 8 GB de GDDR5X, todavía puede convertirse en el núcleo de un sistema de IA local para el hogar si se la combina con modelos compactos, cuantización adecuada y una arquitectura bien repartida.
La idea ya no consiste solo en rescatar una PC lenta con un SSD. Hoy, el verdadero valor de ese hardware heredado está en la inferencia local: conversación, control de dispositivos, voz, automatizaciones e incluso análisis visual sin depender de servicios remotos. Herramientas como llama.cpp permiten ejecutar modelos en CPU y GPU, además de exponer un servidor local compatible con flujos tipo OpenAI API, lo que facilita integraciones domésticas y servicios en red. En ese sentido, el enfoque encaja con el modelo de servidor local para correr LLMs en GPUs modestas, donde una máquina antigua deja de ser un estorbo y se transforma en infraestructura útil.
La viabilidad técnica de este enfoque no es meramente teórica. Google documenta que Gemma 4 E4B existe como modelo oficial y que su variante Q4_0 requiere alrededor de 4.5 GB para cargar los pesos base, una cifra que vuelve razonable su uso en una GPU de 8 GB, siempre con el matiz de que la memoria para contexto, caché y sobrecarga del runtime también cuenta.
¿Por qué una GPU vieja todavía sirve para IA local?
Porque una cosa es jugar en ultra a resoluciones altas y otra muy distinta ejecutar inferencia sobre modelos cuantizados. Una GPU Pascal como la GTX 1080 ya quedó atrás frente a las exigencias gráficas actuales, pero aún conserva dos activos importantes para IA doméstica: ancho de banda y memoria suficiente para modelos compactos.
En otras palabras, esa tarjeta ya no compite como acelerador de gaming contemporáneo, pero sí puede seguir siendo útil como motor de un asistente local. La clave está en no exigirle más de lo que puede dar. En una tarjeta de 8 GB, el margen razonable suele estar en modelos pequeños o medianos, preferentemente en formatos cuantizados y con contextos moderados. Por eso, antes de elegir un modelo, conviene revisar qué LLM local elegir según la VRAM disponible, ya que el tamaño nominal de un modelo no siempre refleja su consumo real en memoria.
¿Qué conviene validar antes de empezar?
Antes de montar el sistema, conviene validar cuatro cosas. La primera es la VRAM real disponible, porque no basta con que el modelo “quepa” en el papel: también necesita espacio para contexto y ejecución. La segunda es la compatibilidad del backend, ya que llama.cpp soporta aceleración CUDA en GPU NVIDIA, pero el resultado final depende del build, del sistema anfitrión y de los controladores.
La tercera es el tipo de tarea. Si el objetivo es conversación y control del hogar, una GTX 1080 todavía tiene margen. Si además se pretende sumar visión, videovigilancia, contextos largos y varios servicios pesados al mismo tiempo, el proyecto deja de ser una simple reutilización y empieza a pedir una estrategia más cuidadosa de reparto de cargas. La cuarta es la plataforma de virtualización: Proxmox permite estos montajes, pero el passthrough de GPU a LXC suele requerir más ajustes manuales y puede ser más frágil tras cambios de kernel o controladores.
Arquitectura recomendada
La forma más sensata de replicar una configuración parecida no es intentar que todo corra en el mismo lugar, sino repartir funciones. Así, la GPU vieja se reserva para la conversación y, si alcanza, para tareas multimodales puntuales; el resto se distribuye entre la máquina virtual de Home Assistant y, si hace falta, otro acelerador dedicado para cámaras.
| Componente | Función | Ubicación recomendada | Observación práctica |
|---|---|---|---|
| llama.cpp | Inferencia del LLM local | Contenedor LXC o VM con acceso a la GPU | Conviene usar modelos cuantizados y medir consumo real de VRAM. |
| Gemma 4 E4B u otro modelo compacto | Conversación y control | GPU principal | El tamaño del modelo debe elegirse por memoria disponible, no por moda. |
| Whisper u otro STT local | Voz a texto | VM de Home Assistant o nodo secundario | Separarlo del LLM evita contención innecesaria. |
| Piper u otro TTS local | Texto a voz | VM de Home Assistant | Es una carga ligera y encaja bien fuera de la GPU principal. |
| Frigate | Detección de objetos en cámaras | Acelerador o GPU dedicada | Si comparte GPU con el LLM, la latencia de voz puede resentirse. |
| Modelo de embeddings | Búsqueda semántica o memoria contextual | CPU o contenedor separado | No es obligatorio para automatización básica. |
Montaje con Proxmox y passthrough
Un equipo con Ryzen de primera generación y una GTX 1080 puede reutilizarse como nodo con Proxmox, pero conviene asumir desde el principio que el éxito del montaje dependerá menos de la potencia bruta y más de la estabilidad del passthrough. Si se elige LXC, la ventaja será la ligereza; si se elige VM, el beneficio será un aislamiento más limpio y, en muchos casos, una depuración menos caprichosa.
La mejor recomendación práctica aquí no es dogmática. Si el objetivo es exprimir recursos y se aceptan ajustes manuales, LXC tiene sentido. Si el objetivo es un sistema más fácil de mantener en el tiempo, una VM dedicada al servicio del LLM puede resultar más prudente. En ambos casos, la regla útil es la misma: primero se valida que la GPU funcione bien en el host, luego se prueba el acceso desde la carga virtualizada y solo después se instala la capa de inferencia.
¿Qué modelo conviene usar en una GTX 1080?
La respuesta corta es que convienen modelos compactos y cuantizados. En una GTX 1080 de 8 GB, modelos como Gemma 4 E4B resultan plausibles precisamente porque fueron diseñados con foco en eficiencia, despliegue local y hardware más contenido.
Lo que no conviene es asumir que 8 GB bastan para cualquier modelo “de 8B”. El nombre comercial de un modelo no resuelve por sí solo el consumo efectivo de memoria, y menos aún cuando se suman contexto largo, multimodalidad o cachés cuantizadas. En una guía seria, la decisión correcta no es elegir el modelo más llamativo, sino el más sostenible para la tarea concreta.
Integración con Home Assistant
Assist ya permite control por voz y puede ejecutarse de forma local en hardware propio. Eso cambia el enfoque de la automatización doméstica: Home Assistant ya no depende necesariamente de un proveedor en la nube para entender órdenes o responder en lenguaje natural.
En la práctica, el LLM local puede conectarse como agente conversacional del sistema o a través de puentes comunitarios cuando el flujo requiere un backend concreto. Aquí conviene introducir una corrección importante: no todas las instalaciones necesitan un modelo de embeddings. Si la intención es encender luces, consultar sensores o disparar automatizaciones, el embeddings puede ser prescindible. Su valor aparece cuando se quiere añadir búsqueda semántica, recuperación de contexto o memoria sobre documentación, dispositivos o estados históricos.
¿Cómo sumar voz 100% local?
La ruta local ya está bastante madura. Home Assistant Assist documenta un pipeline propio, y su aplicación de Android permite detección de palabra de activación en el propio dispositivo, incluso con la pantalla bloqueada, aunque la función sigue marcada como experimental y tiene impacto visible en la batería.
Eso permite reutilizar una tablet o un celular viejo como satélite de voz sin recurrir de inmediato a hardware dedicado. La mejora práctica aquí es evidente: en lugar de cargar toda la pila de voz sobre la GPU principal, conviene separar funciones. El STT puede ejecutarse con Whisper o una alternativa local en la VM de Home Assistant; el TTS con Piper; y el LLM en la GPU. Esa división reduce cuellos de botella y mejora la sensación de respuesta inmediata.
Frigate, cámaras y análisis visual
Frigate es un NVR local con detección de objetos por IA y está pensado para trabajar con aceleradores o GPU, no para descansar de forma seria sobre CPU en producción. Eso lo vuelve especialmente útil cuando se quiere sumar vigilancia sin enviar el video a la nube.
Aquí también hace falta una corrección conceptual. Frigate detecta; el resumen en lenguaje natural pertenece a otra capa. Si se quiere que una cámara no solo detecte una persona, sino que además describa una escena o resuma un clip, hará falta añadir automatizaciones y un modelo visual compatible con el backend elegido. Ese paso puede hacerse, pero no debe confundirse con una función nativa básica del NVR.
Por esa razón, cuando la GPU vieja se reserva para conversación y voz, suele ser mejor mover la detección de cámaras a otro acelerador o a otro equipo. Esa decisión no solo libera recursos: también vuelve más predecible el sistema. En un entorno doméstico, la mejor experiencia casi siempre proviene de la separación de cargas, no del apilamiento total sobre una sola tarjeta.
Limitaciones reales
Este tipo de montaje tiene límites claros. Una GTX 1080 puede responder bien con modelos compactos, pero no convierte un servidor reciclado en estación de inferencia ilimitada. Las instrucciones largas, las automatizaciones complejas con varios dispositivos, la multimodalidad sostenida y los contextos muy amplios siguen siendo escenarios donde aparecerán latencias, errores de interpretación o caídas de rendimiento.
También hay límites operativos. El passthrough de GPU en LXC puede romperse tras una actualización; la voz local en Android consume batería; y Frigate compite con cualquier LLM si ambos dependen del mismo acelerador. La mejor forma de decirlo no es pesimista, sino honesta: el montaje funciona mejor cuando se diseña para tareas concretas y no para cubrir todos los frentes con un solo recurso heredado.
Conclusión
La verdadera lección no es que una GTX 1080 pueda correr un LLM, sino que el umbral de lo útil volvió a moverse. Una GPU descartada para juegos puede seguir teniendo un papel sólido como motor de conversación, automatización y servicios locales dentro del hogar. No sirve para todo, ni de cualquier manera, pero sí para un conjunto de tareas muy concreto y cada vez más relevante.
Cuando el montaje se plantea con criterios realistas —modelo compacto, cuantización correcta, reparto de cargas y expectativas técnicas sobrias— el resultado deja de ser una curiosidad de laboratorio y se vuelve una forma convincente de darle nueva vida al hardware viejo. En ese terreno, la IA local no solo recicla componentes: también redefine qué significa que una máquina siga siendo vigente.
Lo más leído en Curiosidades
-
 Curiosidades
Agent Pets convierte tus agentes de IA en mascotas dentro de Chrome
Agent Pets es una extensión de Chrome que transforma cada sesión de Claude Code, OpenCode y omp en…
-
 Curiosidades
Strata: motor de IA local en tu PC gaming
Strata es un motor de inferencia gratuito y de código abierto que ejecuta el modelo Qwen3.8-Flash-Next, de 125…




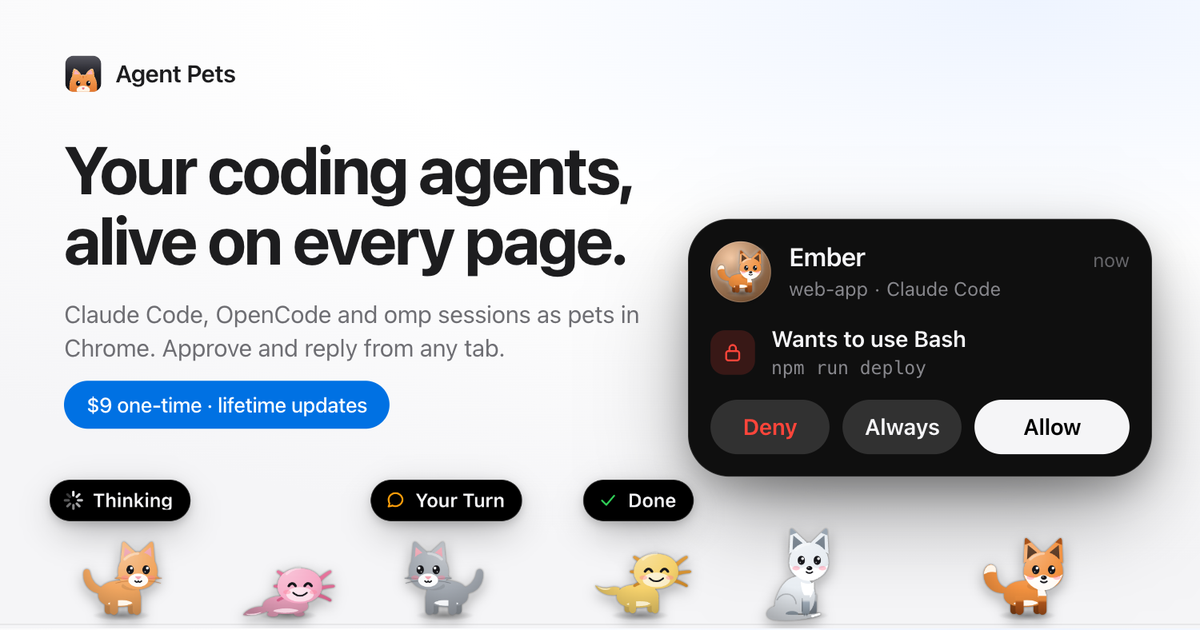
Agent Pets es una extensión de Chrome que transforma cada sesión de Claude Code, OpenCode y omp en una mascota animada que camina al pie de cada página. Cuando un agente necesita permiso o respuesta, su mascota salta y el usuario aprueba sin regresar a la terminal.
Lo más leído en Curiosidades
-
Curiosidades
Agent Pets convierte tus agentes de IA en mascotas dentro de Chrome
Agent Pets es una extensión de Chrome que transforma cada sesión de Claude Code, OpenCode y omp en…
-
Curiosidades
Strata: motor de IA local en tu PC gaming
Strata es un motor de inferencia gratuito y de código abierto que ejecuta el modelo Qwen3.8-Flash-Next, de 125…
Strata es un motor de inferencia gratuito y de código abierto que ejecuta el modelo Qwen3.8-Flash-Next, de 125 mil millones de parámetros, en una computadora gaming común con Windows o Linux. Converse, escribe código, entiende imágenes y ofrece una API compatible con OpenAI en tu propio equipo, sin que nada salga de tu PC.
Lo más leído en Curiosidades
-
Curiosidades
Agent Pets convierte tus agentes de IA en mascotas dentro de Chrome
Agent Pets es una extensión de Chrome que transforma cada sesión de Claude Code, OpenCode y omp en…
-
Curiosidades
Strata: motor de IA local en tu PC gaming
Strata es un motor de inferencia gratuito y de código abierto que ejecuta el modelo Qwen3.8-Flash-Next, de 125…
Curiosidades
Qwen3.8-27B a 381 tps en una RTX 3090: qué significa y qué sí puedes replicar en tu GPU

La cifra suena escandalosa: 381 tokens por segundo con Qwen3.8-27B en una sola RTX 3090. Si se lee rápido, parece la clase de avance que vuelve obsoleto medio mercado de GPUs. Pero para quien sí piensa correr modelos locales en casa, la pregunta útil no es si alguien logró un récord. La pregunta útil es otra: qué parte de ese resultado sirve en una PC real, qué parte no, y si vale la pena intentarlo con tu tarjeta.
Lo más leído en Curiosidades
-
Curiosidades
Agent Pets convierte tus agentes de IA en mascotas dentro de Chrome
Agent Pets es una extensión de Chrome que transforma cada sesión de Claude Code, OpenCode y omp en…
-
Curiosidades
Strata: motor de IA local en tu PC gaming
Strata es un motor de inferencia gratuito y de código abierto que ejecuta el modelo Qwen3.8-Flash-Next, de 125…
Lo más leído
-
 Entretenimiento
Primeras impresiones: Escape from Playtime – Horror en miniatura
-
 Entretenimiento
EA cierra BioWare y cancela el próximo Mass Effect
-
 Consola
Revisión: Stupid Never Dies – Acción zombi con crecimiento veloz
-
 Consola
Revisión: Megapack Dokiwatch 2.0 – Cosméticos de luz y oscuridad
-
 Cine
Tomb Raider celebra su 30 aniversario con Lara Croft
-

 Apps11 años ago
AMPcast, la herramienta de Pandora que permite a los artistas grabar mensajes de audio directamente a sus seguidores
-
 Blogs5 años ago
Conoce los mejores sitios de Torrents para descargar todo tipo de contenidos
-
Android5 años ago
Aprende cómo usar Discord para ver películas con tus amigos
-
Arte y Cultura14 años ago
Colección de fondos de pantalla basados en Super Héroes
-

 Almacenamiento2 años ago
Cómo usar TeraBox: La guía definitiva para aprovechar 1 TB de almacenamiento en la nube
-
Diseño13 años ago
css3ps: plugin que convierte archivos PSD a CSS3
-
Apps9 años ago
Picturethat, app que usa la Realidad Aumentada para visualizar cómo quedarían los cuadros antes de colgarlos
-
Eventos Especiales13 años ago
Especial Día de la Madres: fondos de pantalla especiales para Mamá