
Especificaciones
Cómo usar LLM en una GPU de 8GB con el patrón de servidor local

Correr LLMs locales en una GPU de 8GB no depende de encontrar un modelo milagroso, sino de elegir bien la cuantización, repartir las tareas entre modelos pequeños y conectar todo a tus apps mediante un servidor local compatible con la API de OpenAI.
Los lanzamientos de modelos locales no dejan de crecer y muchos de los más comentados siguen pidiendo más memoria de la que ofrece una tarjeta de gama media. La tentación es renunciar o perseguir la cuantización más agresiva, pero hay otra ruta: montar un stack pequeño en el que cada modelo se encargue de lo que mejor hace. En vez de forzar un único modelo generalista al límite, el objetivo es encontrar un equilibrio real entre memoria, velocidad, contexto y tipo de tarea.
¿Por qué la clave está en repartir habilidades y no en el tamaño del modelo?
En una GPU de 8GB, el margen es demasiado estrecho como para pedirle a un solo modelo que resuelva con la misma solvencia programación, agentes, visión, audio, contexto largo y búsqueda web. Lo que mejor funciona es un reparto por destrezas: un modelo más capaz para trabajo largo y agentes, otro rápido para tareas multimodales y uno muy ligero para funciones auxiliares cuando convenga.
| Modelo | Cuantización sugerida | Rol en el sistema |
|---|---|---|
| Qwen3.5-9B | Q4_K_M o una variante dinámica equivalente | Tareas largas, agentes, archivos, programación y trabajo general |
| Gemma 4 E4B | Q4_0 o GGUF equivalente según el backend | Consultas rápidas y trabajo multimodal con texto, imagen y audio |
| LFM2.5-1.2B-Instruct | Versión Instruct o GGUF ligero | Modelo auxiliar para tool calling y flujos agenticos ligeros, incluida búsqueda web con herramienta externa |
Qwen3.5-9B resulta especialmente interesante para equipos modestos porque su arquitectura híbrida reduce el crecimiento del caché KV frente a un transformer denso convencional. En papel soporta un contexto nativo muy amplio, pero en una GPU de 8GB el límite real depende de la cuantización elegida, del caché KV, del offload y de cuánta memoria ya esté usando el sistema. Dicho de otra forma: una cosa es la ventana máxima del modelo y otra, muy distinta, la ventana práctica que cabe en tu hardware.
Gemma 4 E4B, por su parte, funciona bien como modelo rápido y multimodal. Puede procesar texto, imagen y audio, lo que lo vuelve útil para consultas breves o tareas donde interesa una respuesta ágil. La velocidad real variará según el backend y la máquina, así que conviene tratar cualquier cifra de tokens por segundo como referencia de una prueba concreta y no como promesa universal.
LFM2.5-1.2B-Instruct merece un matiz importante. No es un “modelo de Brave Search” por sí mismo, pero sí un modelo muy ligero, con buen tool calling y bajo consumo, que puede servir como pieza auxiliar para búsquedas web si se integra con una herramienta externa. Ahí está buena parte de su valor: ocupa poco, responde rápido y permite descargar del modelo principal tareas más mecánicas.
Elegir bien la cuantización importa tanto como elegir el modelo. En muchos casos, una cuantización de 4 bits bien resuelta en un modelo más capaz da mejores resultados que un modelo menor en 8 bits dentro del mismo presupuesto de memoria. Si quieres profundizar en ese equilibrio, ya analizamos en detalle cuándo la cuantización de modelos Qwen afecta y cuándo no.
¿Dónde descargar cada modelo?
Lo esencial es no bajar el primer archivo que aparezca. Del mismo modelo circulan múltiples versiones con distinta cuantización, distinto ajuste fino y distinto grado de mantenimiento. Una ruta práctica es usar el catálogo integrado de LM Studio, que facilita encontrar modelos y variantes GGUF alojadas en Hugging Face sin salir del mismo entorno.
- Buscar el modelo por nombre exacto, por ejemplo “Qwen3.5-9B”, “Gemma 4 E4B” o “LFM2.5-1.2B-Instruct”.
- Comparar autor, fecha de actualización y variantes disponibles antes de descargar.
- Priorizar cuantizaciones de 4 bits para una GPU de 8GB, salvo que tu caso de uso exija más precisión y puedas asumir menor margen de contexto.
- Usar el estimado de memoria de LM Studio como filtro inicial, no como garantía absoluta.
Si existe una variante bien mantenida por publicadores reconocidos, como lmstudio-community o Unsloth, suele valer la pena compararla. En el caso de Qwen3.5, por ejemplo, hoy hay variantes dinámicas de Unsloth que pueden ofrecer una mejor relación entre tamaño y calidad que una cuantización clásica equivalente. Aun así, no conviene convertir una sola procedencia en regla: lo correcto es revisar compatibilidad, tamaño real y comportamiento en tu flujo.
¿Qué parámetros de carga usar en LM Studio?
Los ajustes de carga se fijan antes de arrancar el modelo y son los que determinan si realmente cabe o no en la VRAM. En 8GB, esos parámetros valen tanto como el modelo mismo.
| Parámetro | Valor recomendado | Por qué |
|---|---|---|
| GPU Offload | Lo más alto posible sin desbordar la VRAM | Maximiza velocidad; si faltan capas, el sistema deriva parte del trabajo a la RAM y el rendimiento cae |
| Longitud de contexto | Empezar en 8k-16k y subir con pruebas | El contexto consume memoria dinámica vía KV cache; el máximo teórico rara vez coincide con el máximo práctico |
| Caché KV | q8_0 como punto de partida | Reduce aproximadamente a la mitad la memoria del KV cache frente a f16, con una pérdida moderada o poco visible en muchos usos |
| Cuantización del modelo | 4 bits bien elegidos | Es el punto de equilibrio más realista entre calidad y memoria en una tarjeta de 8GB |
La recomendación sensata no es empezar por 40k de contexto, sino hacerlo por una longitud intermedia, comprobar consumo real y ampliar después. En agentes, además, el contexto se llena mucho más rápido que en un chat normal. Un flujo con archivos, herramientas y respuestas largas puede disparar el caché KV en pocos minutos, así que conviene pensar el contexto como presupuesto, no como casilla para llevar al máximo.
También hay que recordar que cuantizar el KV cache no es lo mismo que cuantizar los pesos del modelo. Son dos palancas distintas. Reducir el caché KV puede abrir espacio para más contexto; reducir los pesos puede permitir cargar un modelo más capaz. La mezcla concreta dependerá del backend y del tipo de tarea.
El costo de operar modelos pequeños sigue ahí: exigen instrucciones más precisas y toleran peor los encargos ambiguos. En un entorno limitado, conviene dividir tareas grandes en subtareas estrechas y evitar pedirle a un solo modelo pequeño que improvise de todo a la vez.
¿Cómo un servidor local multiplica el valor de tus 8GB?
El giro decisivo está en usar LM Studio como servidor local. Cuando el modelo cargado se expone mediante una API compatible con OpenAI, deja de ser solo un chat local y se convierte en un servicio reutilizable por varias apps. Ahí es donde 8GB dejan de sentirse tan escasos: una misma carga puede alimentar distintos clientes sin duplicar el esfuerzo de configuración.
- Obsidian Copilot puede conectarse al endpoint local para conversar con tu base de notas sin enviar el contenido a la nube.
- Herramientas agenticas como Eigent aceptan runtimes locales y endpoints compatibles para ejecutar flujos sobre modelos servidos en tu equipo.
- Editores, clientes de automatización y frontends que ya hablan el dialecto OpenAI suelen integrarse con solo cambiar el base URL.
- Servidores MCP o herramientas externas pueden ampliar capacidades como filesystem, navegación o búsqueda web.
En la práctica, esto cambia la lógica de compra. Ya no se trata solo de cuántos parámetros caben en la tarjeta, sino de cuántos flujos cotidianos puedes centralizar sobre una misma máquina.
¿Programar y llamar herramientas son la misma habilidad?
No, y conviene separarlas. Un modelo fuerte en código no siempre es el más fiable para tool calling, y uno competente usando herramientas no necesariamente será el mejor escribiendo HTML, CSS o scripts complejos. Por eso el enrutamiento por destreza tiene más sentido que la idea de un único modelo “para todo”.
Si el foco está en diseño asistido por IA, conviene recordar que muchas de estas herramientas terminan generando HTML y CSS por debajo. En ese escenario, un modelo de código como Qwen2.5-Coder-7B-Instruct sigue siendo una apuesta lógica para tarjetas contenidas, sobre todo cuando el flujo exige editar, corregir o extender interfaces.
Casos de éxito según tu perfil de usuario
El mismo patrón de servidor local más modelos especializados se adapta a perfiles distintos sin cambiar la arquitectura general, solo el reparto de tareas.
| Perfil | Modelo protagonista | Qué logra en la práctica |
|---|---|---|
| Estudiante o investigador | LFM2.5-1.2B-Instruct + Qwen3.5-9B | Búsquedas asistidas por herramienta y resúmenes largos de documentos con mejor control de contexto |
| Desarrollador | Qwen3.5-9B o Qwen2.5-Coder-7B-Instruct | Código, revisión de archivos y flujos locales servidos a editores vía API |
| Diseñador | Qwen2.5-Coder-7B-Instruct | Mejor soporte para herramientas que terminan produciendo HTML, CSS y componentes |
| Usuario de notas y documentación | Qwen3.5-9B vía Obsidian Copilot | Conversar con el repositorio personal sin sacar la información del equipo |
| Curioso sin equipo potente | Rotación entre varios modelos ligeros | Un mismo PC puede servir distintos flujos locales, aunque normalmente con un modelo cargado a la vez |
¿Qué cambia si tienes 12GB de VRAM?
Con 12GB no cambia la estrategia: cambia el margen. Cabe el mismo stack con más holgura para contexto, menos dependencia del offload y más libertad para elegir cuantizaciones menos agresivas o modelos algo mayores. Esa diferencia se nota menos en chats breves que en agentes, documentos largos y flujos con herramientas.
También empiezan a aparecer opciones que en 8GB solo resultan teóricas. Algunas combinaciones de modelos medianos con cuantizaciones agresivas pueden funcionar, pero aquí conviene separar muy bien lo oficial de los reportes de usuarios. En esta franja es común encontrar pruebas comunitarias con ternarios, KV cache comprimido o configuraciones de llama.cpp que abren posibilidades interesantes, aunque no siempre maduras ni consistentes.
En otras palabras, 12GB no garantizan un salto limpio a otra categoría, pero sí permiten respirar. Y esa holgura puede aprovecharse mejor si se acompaña con técnicas como la decodificación especulativa, una vía de aceleración que ya cubrimos en cómo usar la decodificación especulativa en LM Studio con una RTX de 12GB.
¿Cómo aprovechar un Mac Mini M4 con 24GB de RAM?
En un Mac Mini M4 con 24GB no hay VRAM dedicada: hay memoria unificada. Eso cambia bastante el juego porque CPU y GPU comparten el mismo presupuesto. El resultado no es magia, pero sí una flexibilidad que en muchos casos permite cargar modelos que en PC exigirían una tarjeta dedicada con más memoria.
La lógica del stack especializado sigue siendo válida. Puedes conservar el mismo reparto de tareas —un modelo más capaz para trabajo largo, uno más ágil para multimodalidad y otro diminuto para tareas auxiliares—, pero con más libertad para subir contexto o elegir modelos mayores sin quedar tan rápidamente atrapado por la VRAM.
Y si el Mac Mini va a vivir como máquina central, el siguiente paso natural es convertirlo en servidor local permanente, algo que ya explicamos en la guía de Mac Mini como servidor en casa.
Conclusiones
Una GPU de 8GB no necesita un reemplazo inmediato si el enfoque cambia de potencia bruta a arquitectura. La clave no está en encontrar un modelo imposible que lo haga todo, sino en combinar modelos pequeños, cuantizaciones sensatas, parámetros de carga medidos y un servidor local que reutilice el mismo hardware en varias aplicaciones.
Ese patrón además escala sin romperse. Con 12GB ganas aire para contexto y menos dependencia del offload. Con un Mac Mini M4 de 24GB ganas flexibilidad gracias a la memoria unificada. En todos los casos, la idea es la misma: menos obsesión por el modelo único y más atención al ecosistema que construyes alrededor.
Lo más leído en Especificaciones
-
 Apps
Productividad en Windows con apps gratis que sustituyen hardware
Un menú circular de accesos, una app de pantalla extendida y una app de webcam para smartphone elevan…
-
 Android
Revisión: KDE Connect – Integración inalámbrica entre dispositivos
KDE Connect es una app gratuita de código abierto que conecta un teléfono Android con la computadora por…





Un menú circular de accesos, una app de pantalla extendida y una app de webcam para smartphone elevan la productividad en Windows al reutilizar el hardware que ya se tiene: un ratón común, una tablet y un teléfono en lugar de periféricos costosos.
Lo más leído en Especificaciones
-
Apps
Productividad en Windows con apps gratis que sustituyen hardware
Un menú circular de accesos, una app de pantalla extendida y una app de webcam para smartphone elevan…
-
Android
Revisión: KDE Connect – Integración inalámbrica entre dispositivos
KDE Connect es una app gratuita de código abierto que conecta un teléfono Android con la computadora por…
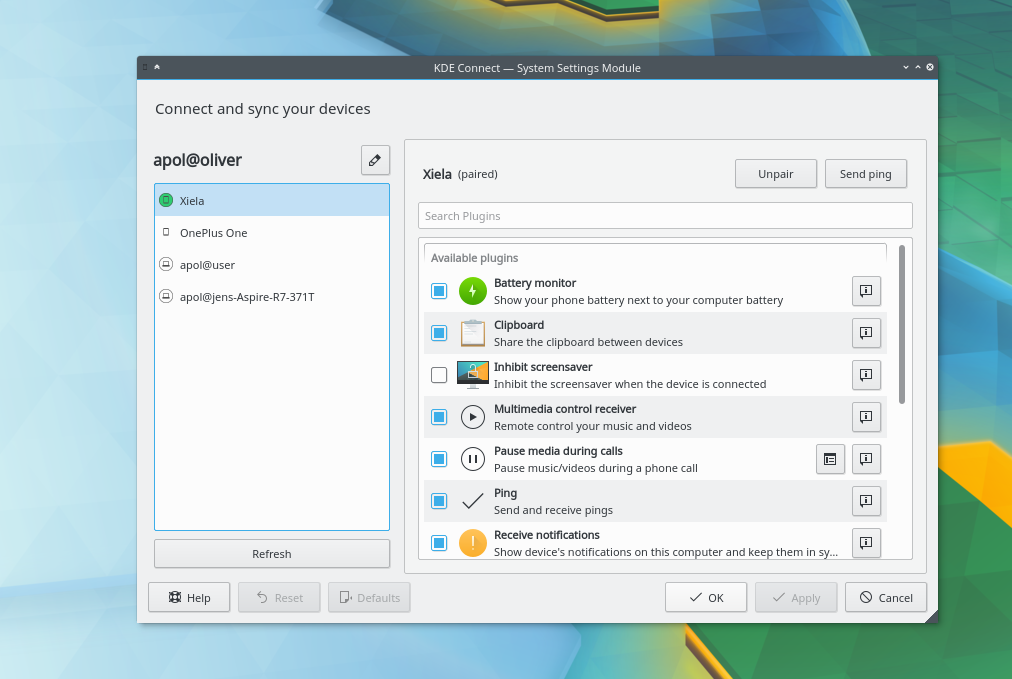
KDE Connect es una app gratuita de código abierto que conecta un teléfono Android con la computadora por Wi-Fi: transferencia de archivos, portapapeles compartido, notificaciones sincronizadas y control remoto, con cifrado TLS de extremo a extremo y sin enviar datos a servidores externos.
Lo más leído en Especificaciones
-
Apps
Productividad en Windows con apps gratis que sustituyen hardware
Un menú circular de accesos, una app de pantalla extendida y una app de webcam para smartphone elevan…
-
Android
Revisión: KDE Connect – Integración inalámbrica entre dispositivos
KDE Connect es una app gratuita de código abierto que conecta un teléfono Android con la computadora por…
Apps
T1 lanza Uno, su inteligencia artificial, e incorpora punto de venta y facturación a su plataforma

Lo más leído en Especificaciones
-
Apps
Productividad en Windows con apps gratis que sustituyen hardware
Un menú circular de accesos, una app de pantalla extendida y una app de webcam para smartphone elevan…
-
Android
Revisión: KDE Connect – Integración inalámbrica entre dispositivos
KDE Connect es una app gratuita de código abierto que conecta un teléfono Android con la computadora por…
Lo más leído
-
 Entretenimiento
Primeras impresiones: Escape from Playtime – Horror en miniatura
-
 Entretenimiento
EA cierra BioWare y cancela el próximo Mass Effect
-
 Consola
Revisión: Stupid Never Dies – Acción zombi con crecimiento veloz
-
 Consola
Revisión: Megapack Dokiwatch 2.0 – Cosméticos de luz y oscuridad
-
 Cine
Tomb Raider celebra su 30 aniversario con Lara Croft
-

 Apps11 años ago
AMPcast, la herramienta de Pandora que permite a los artistas grabar mensajes de audio directamente a sus seguidores
-
 Blogs5 años ago
Conoce los mejores sitios de Torrents para descargar todo tipo de contenidos
-
Android5 años ago
Aprende cómo usar Discord para ver películas con tus amigos
-
Arte y Cultura14 años ago
Colección de fondos de pantalla basados en Super Héroes
-

 Almacenamiento2 años ago
Cómo usar TeraBox: La guía definitiva para aprovechar 1 TB de almacenamiento en la nube
-
Diseño13 años ago
css3ps: plugin que convierte archivos PSD a CSS3
-
Apps9 años ago
Picturethat, app que usa la Realidad Aumentada para visualizar cómo quedarían los cuadros antes de colgarlos
-
Eventos Especiales13 años ago
Especial Día de la Madres: fondos de pantalla especiales para Mamá