
Curiosidades
Guía práctica: cómo usar la decodificación especulativa en LM Studio para potenciar tu IA local

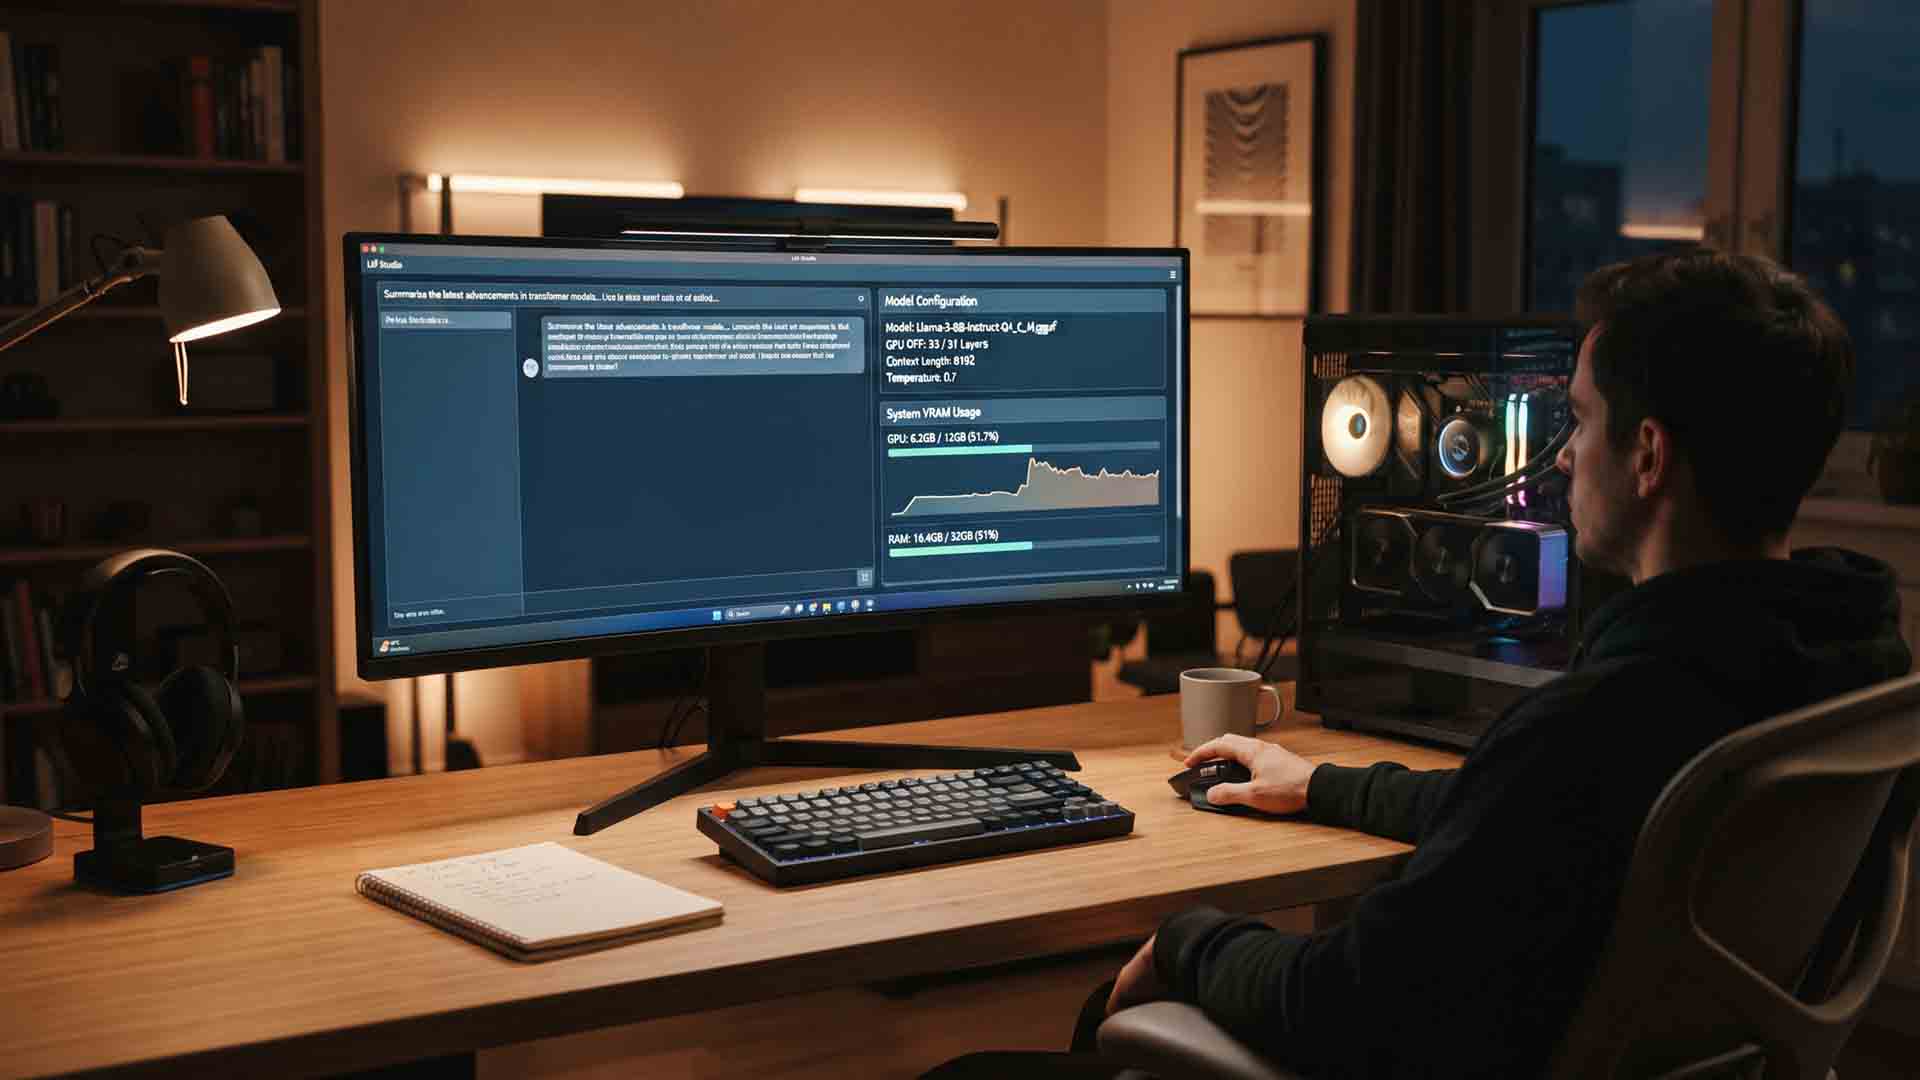
La decodificación especulativa puede acelerar de forma perceptible la respuesta de un modelo local sin cambiar la salida final validada por el modelo principal.
En lugar de generar token por token con una sola red, el sistema combina una ruta más rápida, que adelanta propuestas, con otra más precisa, que las verifica antes de aceptarlas. Bien configurada, esta técnica permite que una IA local se sienta más ágil sin perder consistencia.
En 2026, además, el panorama ya no se limita al esquema clásico de un modelo grande acompañado por un borrador pequeño. También existen variantes como MTP, presentes en familias más recientes. En un equipo con RTX de 12 GB de VRAM y 16 GB de RAM, lo más recomendable es empezar con una combinación sencilla, estable y fácil de reproducir.
¿Qué es la decodificación especulativa?
La decodificación especulativa es una técnica de inferencia que intenta reducir la latencia durante la generación de texto. Su lógica es directa: un modelo más pequeño propone varios tokens por adelantado y el modelo principal revisa esas propuestas en bloque. Si coinciden con lo que el modelo grande habría producido, se aceptan. Si no coinciden, se descartan y el modelo principal continúa.
La ventaja aparece cuando el modelo de borrador acierta con frecuencia suficiente para ahorrar trabajo al modelo principal. La desventaja es igual de clara: se necesita memoria adicional y una combinación compatible entre ambos modelos. Por eso, el resultado depende tanto del hardware como del tipo de tarea y de la pareja elegida.
¿Qué modelos conviene usar hoy?
Las familias más sólidas para este tipo de configuración son Qwen3 y Gemma 4. Ambas siguen activas en el catálogo de LM Studio y cuentan con variantes pensadas para uso local.
Qwen3 es la opción más clara para una configuración clásica con modelo principal y modelo de borrador porque ofrece una escala de tamaños muy cómoda, desde 0.6B hasta 32B. Eso permite armar combinaciones realistas para equipos domésticos sin depender de configuraciones extremas. Puede revisarse en LM Studio y en la colección oficial de Qwen3.
Gemma 4 también es una familia importante, sobre todo porque abre la puerta a rutas más modernas de aceleración, como MTP. Puede consultarse en LM Studio. Para una primera implementación, sin embargo, la ruta más simple y estable sigue siendo Qwen3 con un modelo de borrador pequeño.
Modelos como Qwen3.6 y Qwen3.8 siguen siendo excelentes como modelos principales, sobre todo en tareas de programación, agentes y contexto amplio. En una GPU de 12 GB, no obstante, ya pertenecen a una gama menos cómoda para speculative decoding con margen suficiente.
¿Qué combinaciones tienen más sentido en una RTX de 12 GB?
La combinación más equilibrada para este escenario es Qwen3-8B como modelo principal con Qwen3-1.7B como modelo de borrador. Tiene una diferencia de tamaño razonable, cabe con margen suficiente y funciona bien en tareas como programación, resúmenes, documentación y asistencia técnica.
Si se busca una opción todavía más ligera, Qwen3-4B con Qwen3-0.6B ofrece una experiencia más holgada. La mejora potencial puede ser algo menor, pero también reduce la presión sobre VRAM y RAM.
Como segunda ruta, más moderna pero menos directa para principiantes, puede considerarse Gemma 4 12B QAT con aceleración por MTP. Es una opción vigente, aunque más ajustada en una GPU de 12 GB y menos intuitiva como punto de partida. Puede verse en su versión QAT.
¿Qué tan viable es en una RTX de 12 GB con 16 GB de RAM?
En un equipo con 12 GB de VRAM y 16 GB de RAM, no basta con sumar el tamaño de los archivos del modelo principal y del modelo de borrador. La GPU también necesita espacio para el contexto activo, la caché KV, los buffers del runtime y cierta holgura para evitar desbordes hacia la RAM del sistema.
Como regla práctica, conviene reservar entre 2 y 4 GB de VRAM para ese margen operativo. Eso deja un presupuesto razonable de 8 a 10 GB efectivos para pesos si se quiere una experiencia estable. Con solo 16 GB de RAM, además, no resulta aconsejable depender demasiado del offload hacia memoria del sistema.
| Configuración | Peso del modelo principal | Peso del draft o MTP | Total estimado de pesos | Margen restante sobre 12 GB | Lectura práctica |
|---|---|---|---|---|---|
| Qwen3-4B Q4_K_M + Qwen3-0.6B Q4_K_M | 2.50 GB | 0.48 GB | 2.98 GB | 9.02 GB | Muy holgada y fácil de mantener estable. |
| Qwen3-8B Q4_K_M + Qwen3-1.7B Q4_K_M | 5.03 GB | 1.28 GB | 6.31 GB | 5.69 GB | La combinación más equilibrada para este hardware. |
| Gemma 4 12B QAT + MTP | 7.40 GB | 0.47 GB | 7.87 GB | 4.13 GB | Viable, pero más justa en contexto y margen. |
| Qwen3.8-27B | 16.10 GB | No aplica | 16.10 GB | -4.10 GB | No recomendable en una sola RTX de 12 GB. |
| Gemma 4 31B | 19.00 GB | No aplica | 19.00 GB | -7.00 GB | Fuera del rango práctico para este equipo. |
El margen restante de la tabla es una referencia simple a partir del tamaño de los pesos, no una promesa de rendimiento. Aun así, sirve para descartar combinaciones que ya nacen demasiado ajustadas. En este hardware, la mejor decisión suele ser elegir un modelo mediano que quepa con soltura y dejar espacio suficiente para que la especulación siga aportando velocidad.
¿Qué configuración conviene elegir?
Para un uso cotidiano, la mejor recomendación es Qwen3-8B + Qwen3-1.7B. Mantiene una buena relación entre calidad, velocidad y consumo de memoria, y deja margen suficiente para trabajar con contexto moderado sin castigar demasiado el sistema.
Si la prioridad es una experiencia más ligera, Qwen3-4B + Qwen3-0.6B es una ruta excelente. Sigue siendo moderna, cabe con mucha holgura y resulta apropiada para resúmenes, borradores, consultas técnicas y automatizaciones sencillas.
Gemma 4 12B QAT tiene sentido como una segunda opción para quien quiera experimentar con MTP, pero exige más atención al contexto, la estabilidad y el margen real de VRAM.
Configuración paso a paso en LM Studio
Paso 1: descargar los modelos
Abre LM Studio y entra en la sección de modelos. Descarga primero una pareja razonable. Para la configuración principal, lo más recomendable es usar Qwen3-8B como modelo principal y Qwen3-1.7B como modelo de borrador.
Si LM Studio ofrece varias cuantizaciones, empieza por una moderada como Q4_K_M. Esa cuantización suele ser un buen equilibrio entre tamaño, calidad y viabilidad en una GPU de 12 GB. Si prefieres una opción todavía más liviana, descarga Qwen3-4B y Qwen3-0.6B.
Paso 2: preparar el modelo principal en My Models
Cuando la descarga termine, entra en My Models. Ahí aparecen los modelos que ya tienes guardados en LM Studio. Busca el modelo principal que vas a utilizar, por ejemplo Qwen3-8B, y selecciónalo.
Si estás usando la configuración ligera, en este paso deberías seleccionar Qwen3-4B. El procedimiento es el mismo.
Paso 3: activar la decodificación especulativa desde My Models
La forma más clara de dejar esta función configurada es desde My Models, dentro de los parámetros de carga del modelo principal. En algunas versiones de LM Studio, si no aparecen las opciones avanzadas, primero hay que activar Developer Mode en Settings > Developer.
- Abre My Models.
Entra en la sección donde LM Studio muestra todos los modelos descargados. - Selecciona el modelo principal.
Haz clic sobre el modelo que quieras usar como base. En este ejemplo, Qwen3-8B. - Abre la configuración del modelo.
Busca el botón de configuración, el menú del modelo o la opción para editar sus parámetros predeterminados. Dependiendo de la versión, puede aparecer como un engrane o como una opción de edición del modelo. - Entra en la sección Load.
Dentro de la configuración del modelo, abre la pestaña o bloque llamado Load. Ahí se ajustan los parámetros que afectan la forma en que el modelo se carga en memoria. - Busca la sección Speculative Decoding.
Dentro de Load, localiza el bloque con ese nombre. Si no aparece, revisa si tu versión requiere activar antes Developer Mode. - Activa la opción de modelo de borrador (draft).
Cambia la opción correspondiente para habilitar speculative decoding. - Selecciona el modelo compatible.
LM Studio mostrará una lista con los modelos de borrador que considera compatibles con el modelo principal. Si estás usando Qwen3-8B, lo habitual es elegir Qwen3-1.7B. Si estás usando Qwen3-4B, el modelo lógico es Qwen3-0.6B. - No fuerces combinaciones que no aparezcan.
Si LM Studio no muestra un modelo en esa lista, lo prudente es asumir que no es una pareja adecuada para esa configuración. - Deja una configuración conservadora para la primera prueba.
Empieza con Max draft tokens = 3 y Min draft tokens = 0. Son valores razonables para una RTX de 12 GB. - Guarda la configuración.
Si LM Studio ofrece una opción para recordar o guardar estos ajustes como predeterminados, actívala. - Carga el modelo.
Una vez guardada la configuración, carga el modelo principal con esos parámetros.
Tras completar estos pasos, LM Studio ya puede aplicar la decodificación especulativa cuando uses ese modelo. A partir de ahí, basta con abrir el chat y trabajar con normalidad.
Paso 4: empezar con parámetros prudentes
En una RTX de 12 GB conviene evitar ajustes agresivos desde el principio. Un punto de partida razonable es mantener Max draft tokens en 3, Min draft tokens en 0 y un contexto inicial de 4K.
Si el sistema se comporta de forma estable, puede intentarse 8K. Lo que no conviene es aumentar al mismo tiempo contexto, profundidad de draft y exigencia del modelo principal, porque esa combinación suele tensionar la memoria demasiado pronto.
Paso 5: probar con un prompt de control
Con el modelo ya cargado, ejecuta un prompt sencillo y repetible. Por ejemplo: “Explica cómo funciona la decodificación especulativa en tres párrafos y añade un ejemplo práctico”. Lo importante es usar el mismo prompt con la función activada y desactivada para poder comparar.
Durante esa prueba, observa tres cosas: la rapidez con la que aparece el primer token, la velocidad general de generación y el comportamiento de la VRAM. Si el sistema responde con soltura y no empieza a derramarse demasiado hacia la RAM, vas por buen camino.
¿Cómo validar si la mejora es real?
La forma más útil de comprobar si la técnica realmente vale la pena es comparar el comportamiento con y sin decodificación especulativa usando el mismo prompt, la misma cuantización y el mismo contexto. No basta con fijarse en una sola cifra.
Conviene observar al menos cuatro cosas: la velocidad de generación, el tiempo hasta el primer token, el uso de VRAM durante respuestas largas y la estabilidad general cuando la conversación crece. Si el modelo de borrador es demasiado grande o si la tarea es demasiado abierta, la tasa de aceptación bajará y la ventaja puede reducirse o desaparecer.
¿En qué casos de uso se nota más?
La decodificación especulativa suele rendir mejor en tareas estructuradas. Programación, documentación técnica, resúmenes, asistentes internos y respuestas de formato repetitivo son escenarios donde el borrador pequeño tiene más opciones de acertar y, por lo tanto, de acelerar la validación del modelo principal.
También puede funcionar bien en automatización ligera y soporte técnico local. En cambio, en escritura muy abierta, ficción o tareas especialmente creativas, la ganancia suele ser menos consistente porque hay demasiadas continuaciones posibles y el borrador falla más a menudo.
¿Qué limitaciones conviene tener presentes?
La decodificación especulativa no es una mejora automática. Exige memoria adicional, depende mucho del tipo de prompt y puede perder eficacia si el modelo de borrador es demasiado grande o si el sistema ya está al límite de VRAM. En ese caso, buena parte del beneficio teórico se pierde por la presión de memoria.
También conviene evitar expectativas irreales con modelos mucho más grandes. Qwen3.8-27B, Qwen3.6-27B, Qwen3-30B-A3B o Gemma 4 31B son familias vigentes y potentes, pero no representan una recomendación honesta para una sola RTX de 12 GB si además se quiere speculative decoding con margen suficiente.
¿Vale la pena?
Sí, siempre que se use con criterio. En un equipo con RTX de 12 GB y 16 GB de RAM, la decodificación especulativa puede marcar una diferencia real si se combina con modelos actuales y tamaños razonables. En ese contexto, Qwen3-8B + Qwen3-1.7B es la mejor recomendación general, mientras que Qwen3-4B + Qwen3-0.6B ofrece una ruta todavía más estable y ligera.
La técnica no convierte un hardware modesto en una estación de trabajo de gama alta, pero sí puede transformar una experiencia correcta en una mucho más fluida. Y en IA local, esa diferencia entre “funciona” y “da gusto usarlo” suele ser más importante de lo que parece.




El Visor de eventos de Windows 11 acumula cientos de alertas que casi nadie sabe interpretar. Exportar ese registro y entregárselo a un asistente de IA, ya sea Claude, ChatGPT, Gemini o Kimi, permite separar el ruido de las fallas reales: un caso real reveló un controlador que crasheaba en silencio y 13 supuestos bloqueos que nunca ocurrieron.
Usar un asistente de inteligencia artificial como si fuera un buscador es uno de los errores más comunes. Se escribe una pregunta, se recibe una respuesta genérica y se da por bueno el resultado. El problema, muchas veces, no está en el modelo, sino en la forma de redactar el prompt. Estas cinco técnicas de prompting pueden mejorar de forma notable los resultados en ChatGPT, Claude, Gemini, Copilot o Mistral, porque no dependen de palabras mágicas, sino de pedirle a la IA diagnóstico, criterio y refinamiento en lugar de información suelta.

Un port no oficial lleva Super Mario Bros. Wonder a PC sin emuladores: usa código C++ recompilado y una capa de traducción NVN-a-Vulkan. Nintendo probablemente no estará contenta.
-

 Apps11 años ago
AMPcast, la herramienta de Pandora que permite a los artistas grabar mensajes de audio directamente a sus seguidores
-
 Blogs5 años ago
Conoce los mejores sitios de Torrents para descargar todo tipo de contenidos
-
Android5 años ago
Aprende cómo usar Discord para ver películas con tus amigos
-
Arte y Cultura13 años ago
Colección de fondos de pantalla basados en Super Héroes
-

 Almacenamiento2 años ago
Cómo usar TeraBox: La guía definitiva para aprovechar 1 TB de almacenamiento en la nube
-
Diseño13 años ago
css3ps: plugin que convierte archivos PSD a CSS3
-
Apps9 años ago
Picturethat, app que usa la Realidad Aumentada para visualizar cómo quedarían los cuadros antes de colgarlos
-
Eventos Especiales13 años ago
Especial Día de la Madres: fondos de pantalla especiales para Mamá