Investigadores del Institute of Science and Technology Austria (ISTA) publicaron versiones GGUF cuantizadas de DeepSeek-V4.1-Flash-1017, un modelo sparse mixture-of-experts de 763.2 mil millones de parámetros con...

Qwythos 9B es, literalmente, un destilado: un modelo de 9B entrenado con las trazas de razonamiento de Claude Mythos 5 que cabe en una GPU de...

PS5LM es un proyecto de código abierto que ejecuta llama.cpp directamente en la GPU de una PlayStation 5 con jailbreak, convirtiendo la consola en un servidor...

Una prueba documentada muestra cómo el flag –n-cpu-moe de llama.cpp descarga los expertos de un modelo Mixture-of-Experts a la RAM del sistema y multiplica por ocho...

La cifra suena escandalosa: 381 tokens por segundo con Qwen3.8-27B en una sola RTX 3090. Si se lee rápido, parece la clase de avance que vuelve...

La conversación sobre IA local suele empezar mal planteada. Se pregunta cuál herramienta es mejor antes de definir para qué se usará, con qué hardware y...
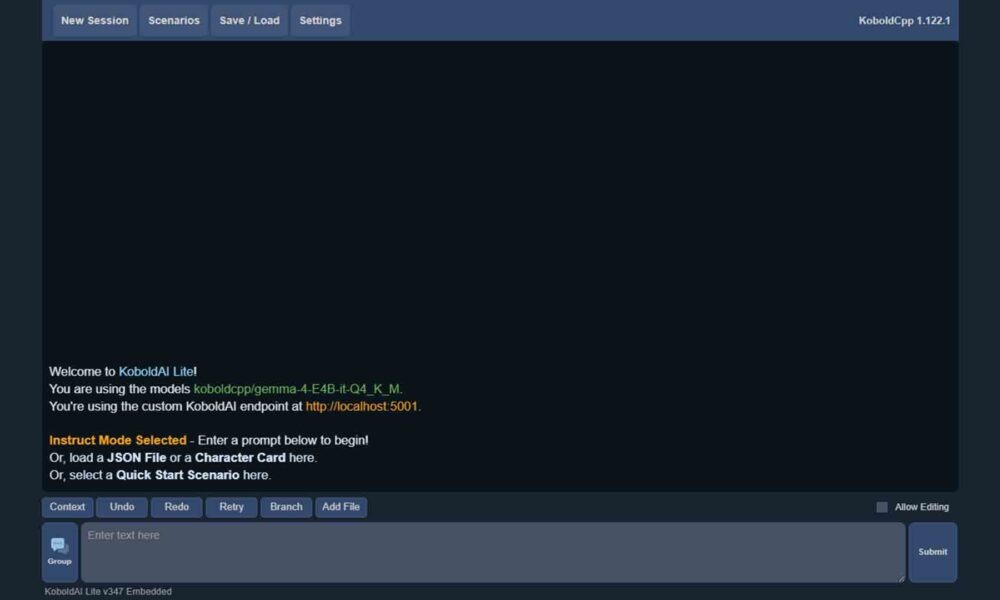

KoboldCpp, el runtime gratuito para ejecutar modelos GGUF en local, publicó a finales de septiembre su versión 1.122.1 con un agente de IA integrado. Te contamos...


La decodificación especulativa puede acelerar de forma perceptible la respuesta de un modelo local sin cambiar la salida final validada por el modelo principal.


Los modelos de lenguaje locales (LLMs) suelen asociarse con entornos de escritorio por sus altos requisitos de recursos. Sin embargo, la necesidad de privacidad y la...


Instala llama.cpp en Windows y Mac sin compilar, compara con Ollama y LM Studio, y aprende a compartir modelos GGUF entre las tres herramientas sin duplicar...