
Digitalización
La IA local tiene dos caminos: destilería artesanal o fábrica NVIDIA

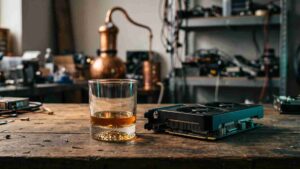
Qwythos 9B es, literalmente, un destilado: un modelo de 9B entrenado con las trazas de razonamiento de Claude Mythos 5 que cabe en una GPU de 8 GB. En el otro extremo, la ola de modelos presentada por NVIDIA en GTC Berlín funciona como una fábrica: estandarizada, compatible con todo y pensada para plataforma. Elegir tu próxima IA local ya no es comparar puntajes, es decidir qué filosofía quieres en tu escritorio.
¿Por qué la metáfora del destilado es literal aquí?
En el mundo del whisky, una destilería artesanal toma el producto de un gigante y lo transforma en algo propio, con carácter y nicho. En IA, Empero AI hizo exactamente eso: tomó Qwen3.5-9B de Alibaba como base y lo entrenó de forma supervisada con más de 500 millones de tokens de trazas de razonamiento de alta calidad generadas a partir de Claude Mythos 5, el modelo insignia de Anthropic. El resultado, reportado por el propio laboratorio: +34 puntos en MMLU y +30 en GSM8K-strict sobre la base, con licencia Apache 2.0 que permite uso comercial.

La palabra “reportado” es deliberada: son benchmarks del propio equipo, sin auditoría externa, y el modelo no tiene vínculo oficial con Anthropic. Afirmar haber aprendido de las salidas de Claude no es lo mismo que ser Claude, y un lector de IA debe conservar esa distinción siempre. Dicho esto, la destilación como técnica es una de las más legítimas del campo: transfiere estilo de razonamiento a un tamaño accesible.
La historia de la casa tiene incluso su capítulo de lote defectuoso: la versión 1 sufría bucles de repetición bajo decodificación greedy. La versión 2, lanzada en junio de 2026, lo corrigió con un método propio llamado FTPO (Final-Token Preference Optimization), entrenado con unas 2,000 tuplas de preferencia extraídas automáticamente de los propios bucles del modelo: el destilador probando su propio lote, detectando el defecto y redestilando sin perder el carácter original: la cadena de pensamiento profunda, la postura de investigación sin filtros y el contexto de un millón de tokens.
¿Y la fábrica cómo funciona?
NVIDIA presentó en GTC Berlín su catálogo completo para IA local con la lógica inversa: no un modelo con carácter, sino una cadena de montaje donde cada pieza encaja. Como documentamos en la cobertura del anuncio de RTX Spark en GTC Berlín, la fábrica ofrece estandarización (compatibilidad desde el primer día con Nemotron, GLM, DeepSeek, Qwen, MiniMax y FLUX.3), optimización (aceleraciones para llama.cpp y vLLM, y checkpoints optimizados) y distribución (laptops de ASUS, Dell, HP, Lenovo, Microsoft y MSI disponibles con el hardware dentro).
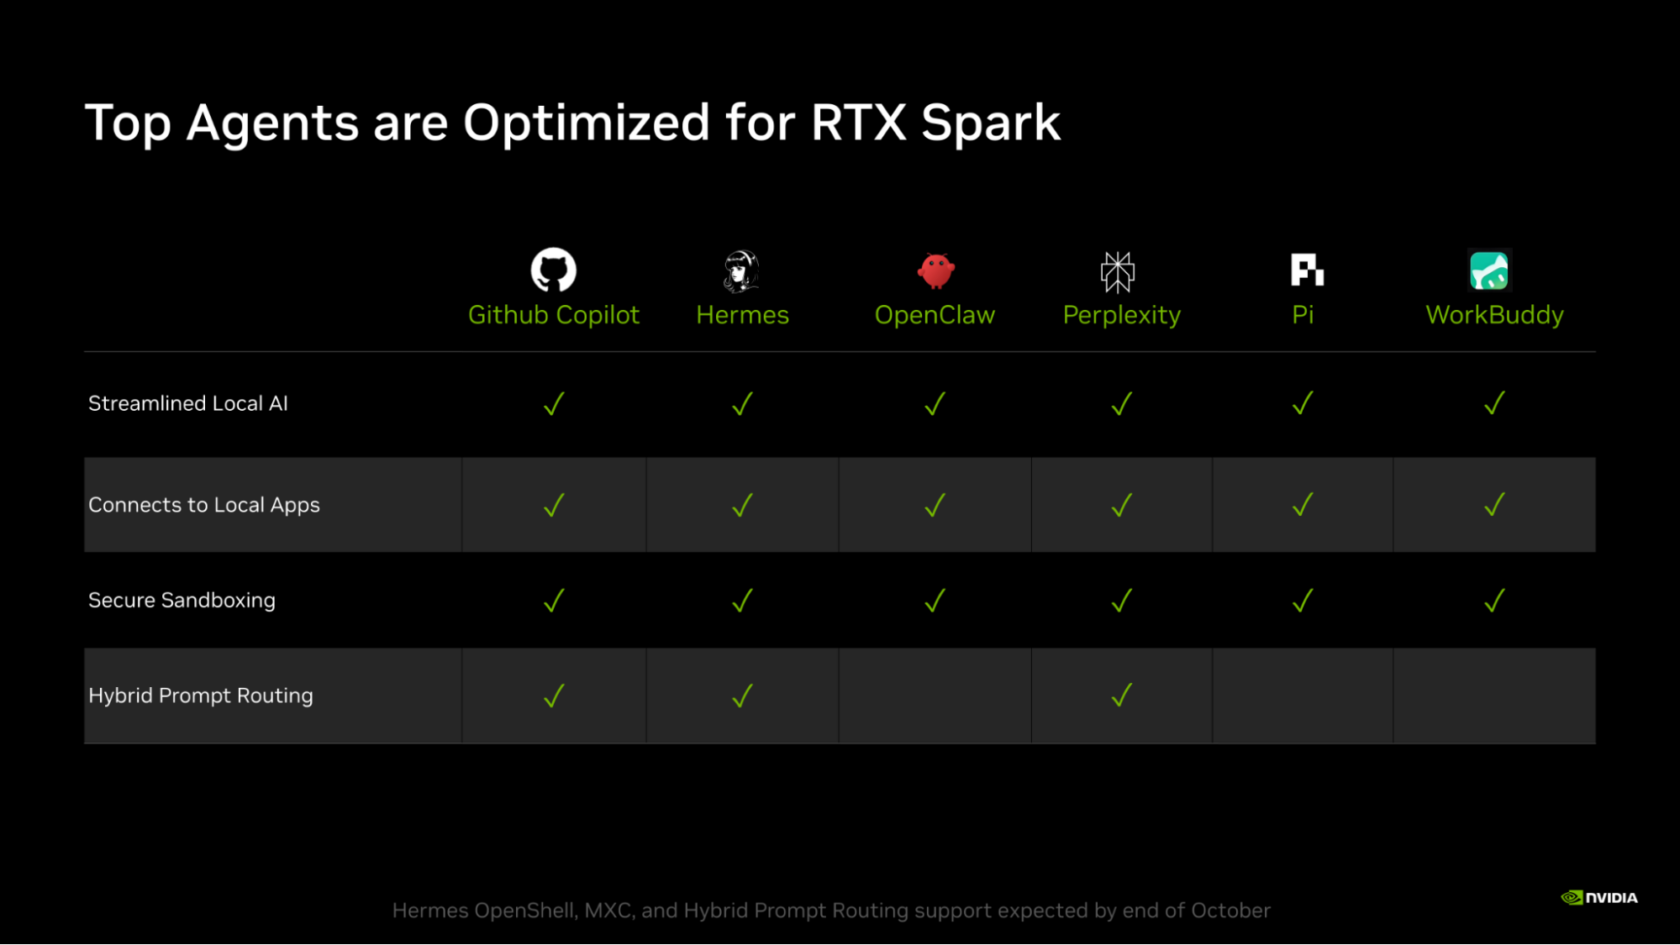
Los productos de la fábrica cubren cada estante del supermercado: agentes multirrol en 4 GB, programadores veloces, contextos largos y hasta generación de imágenes. La fábrica no destila carácter; fabrica conveniencia.
Mesa de cata: ¿qué ofrece cada etiqueta?
| Etiqueta | Origen | Tamaño | Memoria | Carácter | Licencia |
|---|---|---|---|---|---|
| Qwythos 9B v2 | Destilería Empero AI | 9B denso | 8 GB (Q4_K_M) | Razonamiento profundo estilo Claude, contexto de 1M tokens, postura sin filtros | Apache 2.0 |
| Recursive Flint | Recursive Superintelligence | 40B MoE, 2.5B activos | Más de 8 GB: los pesos completos deben caber en memoria | Programación con agentes: SWE-Bench Pro v2, Terminal-Bench 2.1; +55% de velocidad en RTX Spark con kernels Eureka Machine | Apache 2.0 |
| Nemotron Bolt E4B | Fábrica NVIDIA | 4B | 4 GB | Agentes multirrol, voz local, personajes de videojuegos | NVIDIA Open Model License |
| LFM2.5-24B-A2B | Liquid AI | 24B MoE, 2B activos | Orientado a equipos RTX Spark | Razonamiento agéntico con herramientas | Pesos abiertos |
| MiniMax M3.1 Flash | MiniMax | Modelo abierto | DGX Station y DGX Spark | Contexto largo en escritorio | Abierta |
| Qwen3.5-9B | Alibaba (la base del destilado) | 9B denso | Similar a Qwythos | Conocimiento general: MMLU-Pro 82.5, GPQA Diamond 81.7, visión nativa | Apache 2.0 |
Dos notas de sommelier. FLUX.3 Klein (5.6B) es de difusión de imágenes, no compite como modelo de lenguaje y sale de la cata. Y cuidado con la etiqueta “MoE con pocos parámetros activos”: Recursive Flint activa solo 2.5B por token, pero sus 40B de pesos totales deben caber en la memoria del equipo; en una GPU de consumo de 8 GB, ese whisky no cabe en el vaso.
¿Cómo embotellarlo en tu GPU según su tamaño?
El repositorio GGUF oficial publica los tamaños exactos de cada botella, lo que permite recomendar por tarjeta sin estimaciones:
| Botella (GGUF) | Tamaño real | GPU recomendada | Notas de cata |
|---|---|---|---|
| Q4_K_M | 5.74 GB | 8 GB (RTX 3060 Ti / 4060) | El valor por defecto del laboratorio: el más pequeño práctico con buena calidad |
| Q5_K_M | 6.52 GB | 8 GB con margen justo | Mejor fidelidad que Q4 aún cabiendo en 8 GB; la mejor compra para contexto moderado |
| Q6_K | 7.46 GB | 12 GB | Fidelidad alta; en 8 GB no deja espacio para el KV-cache |
| Q8_0 | 9.53 GB | 16 GB | Casi sin pérdida según el laboratorio |
| BF16 | 17.9 GB | 24 GB o multi-GPU | Base de conversión; sin valor de uso diario |
Aclaración que evita resacas: el archivo no es el único consumo de memoria. El KV-cache del contexto se suma encima, así que en 8 GB tendrás contextos moderados, no el millón de tokens nominal. Y dos detalles de embotellado: los archivos MTP (con cabeza de predicción multi-token) son ligeramente más grandes y no los necesitas para uso estándar; el projector de visión (mmproj, 922 MB) es opcional e intercambiable con el de cualquier Qwen3.5-9B si quieres entrada de imágenes. Vale la pena señalar un detalle técnico de la casa: al ser un modelo híbrido con bloques lineales, los K-quants oficiales conservan los tensores de estado SSM en precisión alta (por eso pesan un 2-4% más que una cuantización plana), y esa es una de las razones por las que la calidad se sostiene.
¿Cómo configurarlo en LM Studio sin equivocarte?
La ficha oficial y el repositorio GGUF publican recomendaciones de muestreo concretas, así que no hace falta adivinar. La carta de servicio para Qwythos 9B v2 es esta:
| Parámetro | Valor recomendado | Por qué |
|---|---|---|
| Temperature | 0.6 | Recomendación oficial del laboratorio para su postura de razonamiento |
| Top P | 0.95 | Compañero oficial del muestreo a 0.6 |
| Top K | 20 | Limita el abanico de candidatos y evita derivas |
| Penalty de repetición | Opcional (1.05 o desactivada) | El bucle de la v1 está entrenado a 0%; ya no hace falta como parche |
| Máximo de tokens nuevos | Generoso (8,192 o más) | Es un modelo de razonamiento: cada respuesta abre con un bloque de pensamiento que consume tokens |
| Contexto | 16,384 como punto de partida | Es el valor del ejemplo oficial de llama.cpp; súbelo solo si tu VRAM sobra tras cargar el modelo |
Tres avisos de barra. Si tu runtime no soporta aún los archivos MTP (speculative decoding con cabeza de predicción multi-token), usa los archivos normales: son equivalentes para uso estándar. Para entrada de imágenes, descarga además el mmproj oficial de 922 MB. Y si vienes de la v1 y tenías activada una penalización de repetición alta por los bucles, en la v2 puedes retirarla: el defecto ya no existe en el lote.
¿Dónde comprar la botella correcta?
La destilería vende en dos direcciones oficiales. La ficha del modelo está en https://huggingface.co/empero-ai/Qwythos-9B-v2, con la carta completa y las discusiones de la comunidad. Las botellas GGUF listas para LM Studio, Ollama, llama.cpp, Jan y KoboldCpp están en el repositorio dedicado: https://huggingface.co/empero-ai/Qwythos-9B-v2-GGUF, con sumas SHA256 publicadas para verificar la autenticidad de cada descarga.
En el mismo estante vive Qwythos-9B-Claude-Mythos-5-1M, la primera cosecha y base de la v2. No es una estafa: es el lote original, útil para reproducir los resultados de lanzamiento. Para consumo diario, la v2 es la recomendada: el defecto del bucle ya está corregido. Si montas tu propio bar local, el espacio de trabajo Odysseus, creado por PewDiePie (gratuito, AGPL-3.0) o AnythingLLM te dan las copas; la guía de cómo usar un LLM local como asistente en Windows mediante MCP te da el flujo.
¿Qué puede salir mal con cada camino?
- El destilado no es un modelo de frontera: 9B transferidos con estilo no igualan la capacidad bruta de los grandes propietarios en tareas extremas.
- Benchmarks autoreportados: el +34 en MMLU lo publica la propia destilería, sin auditoría independiente.
- Carácter sin filtros: la etiqueta uncensored es virtud en investigación y bandera roja en un entorno corporativo.
- La fábrica elige por ti: sus modelos MoE están optimizados para RTX Spark (hasta 128 GB de memoria unificada); su licencia NVIDIA Open Model License tiene condiciones que un departamento legal revisará.
- El contexto de 1M tiene letra pequeña: exige memoria de sobra para el KV-cache; en 8 GB queda en promesa nominal.
- Sin vínculo oficial con Anthropic: aprender de las salidas de Claude Mythos 5 no convierte a Qwythos en un producto de Anthropic.
Veredicto: ¿para qué ocasión es cada uno?
La pregunta correcta no es cuál es mejor, sino para qué ocasión lo quieres. Para la cata privada (documentos largos, razonamiento profundo, cero datos saliendo de tu equipo) en una GPU de consumo, el destilado gana: Qwythos 9B v2 en Q4_K_M o Q5_K_M, con Apache 2.0 y costo marginal cero por consulta. Para el bar de trabajo diario (programación con agentes, ecosistema NVIDIA, hardware ya integrado), la fábrica gana por comodidad pura: Recursive Flint si tienes memoria, Bolt E4B si necesitas lo mínimo. Y si tu ocasión es el conocimiento general con visión, la base Qwen3.5-9B sigue siendo una de las mejores compras de su estante, como confirma la ola de pesos abiertos que analizamos con MiniMax M2 y su arquitectura Mixture-of-Experts.
El detalle técnico del destilado, incluida la tabla pública de benchmarks y la explicación del FTPO, está en la publicación de lanzamiento de Empero. Lo cierto es que la IA local maduró: ya no eliges entre grande o pequeño, sino entre dos formas de entender el oficio.
Lo más leído en Digitalización
-
 Digitalización
Skill Recorder convierte tus tareas grabadas en agentes de IA
Skill Recorder es la herramienta de código abierto de Microsoft que graba una sesión real de trabajo en…
-
 Digitalización
La IA local tiene dos caminos: destilería artesanal o fábrica NVIDIA
Qwythos 9B es, literalmente, un destilado: un modelo de 9B entrenado con las trazas de razonamiento de Claude…



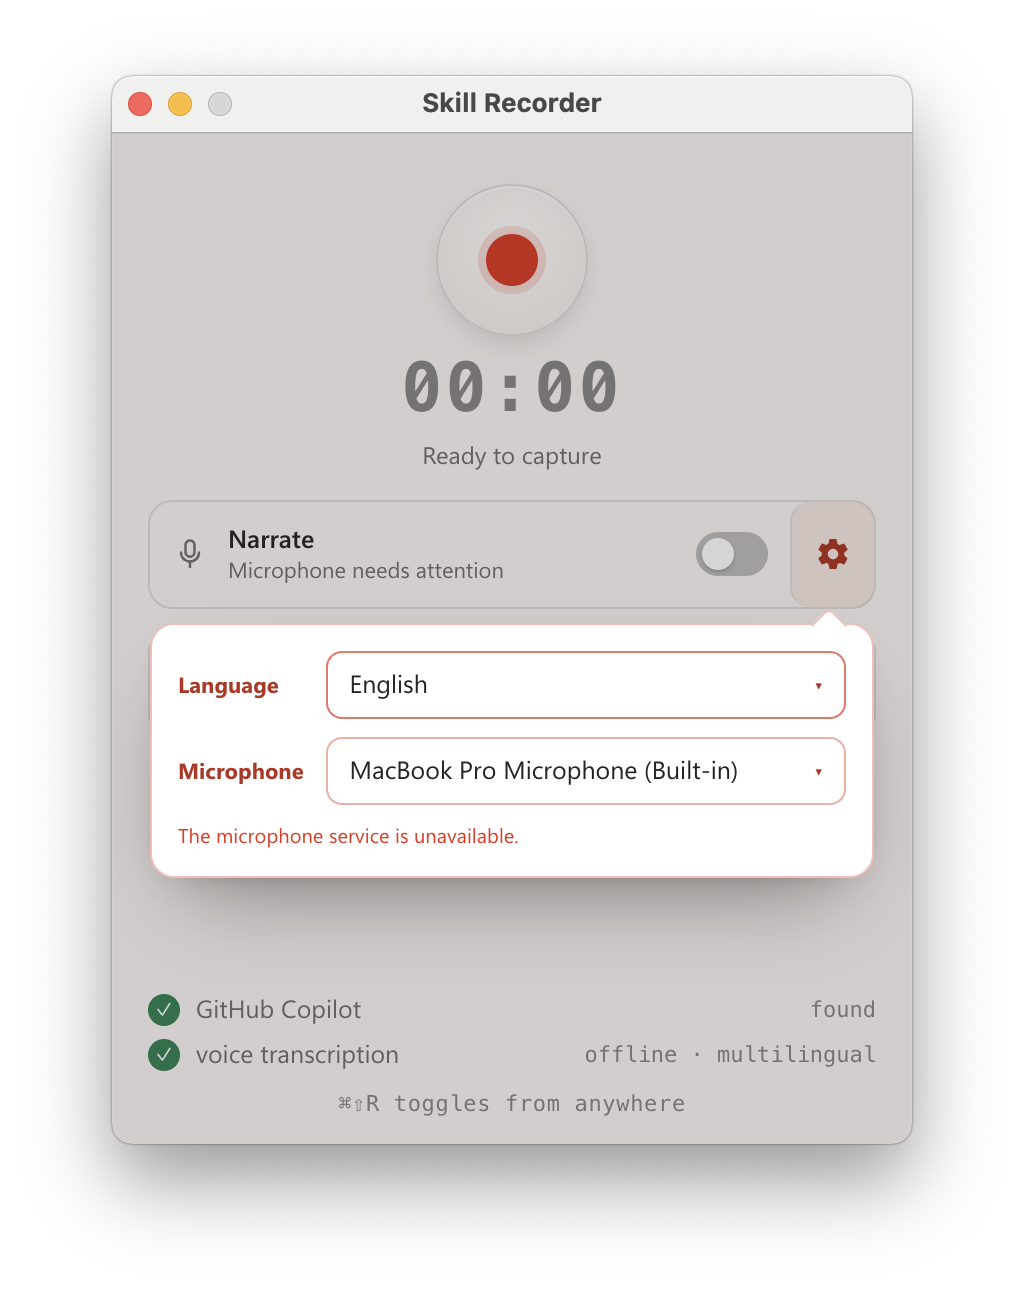
Skill Recorder es la herramienta de código abierto de Microsoft que graba una sesión real de trabajo en tu pantalla y la transforma en un procedimiento reutilizable que un agente de inteligencia artificial puede repetir por ti. Captura clics, cambios de ventana, páginas visitadas, la actividad de una terminal opcional y hasta tu narración hablada, y usa GitHub Copilot para reconstruir lo que hiciste como una intención clara más una lista ordenada de pasos.
Lo más leído en Digitalización
-
Digitalización
Skill Recorder convierte tus tareas grabadas en agentes de IA
Skill Recorder es la herramienta de código abierto de Microsoft que graba una sesión real de trabajo en…
-
Digitalización
La IA local tiene dos caminos: destilería artesanal o fábrica NVIDIA
Qwythos 9B es, literalmente, un destilado: un modelo de 9B entrenado con las trazas de razonamiento de Claude…
Comunicados de Prensa
NVIDIA amplía RTX Spark con nuevas herramientas y modelos de IA local en GTC Berlín
NVIDIA anunció en GTC Berlín nuevas herramientas, modelos de IA y optimizaciones para RTX Spark, la plataforma que ejecuta agentes de IA personales en PC con Windows. El anuncio incluye la aplicación Underdog Desktop Agent, el modelo de programación Recursive Flint y compatibilidad desde el primer día con Nemotron, GLM, DeepSeek, Qwen, MiniMax y FLUX.3.
Lo más leído en Digitalización
-
Digitalización
Skill Recorder convierte tus tareas grabadas en agentes de IA
Skill Recorder es la herramienta de código abierto de Microsoft que graba una sesión real de trabajo en…
-
Digitalización
La IA local tiene dos caminos: destilería artesanal o fábrica NVIDIA
Qwythos 9B es, literalmente, un destilado: un modelo de 9B entrenado con las trazas de razonamiento de Claude…
Canva presentó Canva Craft, su primer modelo de generación de imágenes desarrollado y entrenado por Canva Research, su laboratorio interno de inteligencia artificial. El modelo genera imágenes de alta calidad en resolución de hasta 2K, admite más de 30 relaciones de aspecto y crea texto en 55 idiomas. Ya está disponible para todos los usuarios de Canva a nivel global desde Dream Lab.
Lo más leído en Digitalización
-
Digitalización
Skill Recorder convierte tus tareas grabadas en agentes de IA
Skill Recorder es la herramienta de código abierto de Microsoft que graba una sesión real de trabajo en…
-
Digitalización
La IA local tiene dos caminos: destilería artesanal o fábrica NVIDIA
Qwythos 9B es, literalmente, un destilado: un modelo de 9B entrenado con las trazas de razonamiento de Claude…
Lo más leído
-
 Consola
Revisión: Call of Duty: Modern Warfare 4 – Edición Bóveda
-
 Herramientas
Clairic: el modelo de extracción de Cloudflare que no genera texto
-
 Herramientas
Kimi K3.1 Pro desafía a los gigantes de la IA con pesos abiertos
-
Digitalización
Skill Recorder convierte tus tareas grabadas en agentes de IA
-
Digitalización
La IA local tiene dos caminos: destilería artesanal o fábrica NVIDIA
-

 Apps11 años ago
AMPcast, la herramienta de Pandora que permite a los artistas grabar mensajes de audio directamente a sus seguidores
-
 Blogs5 años ago
Conoce los mejores sitios de Torrents para descargar todo tipo de contenidos
-
Android5 años ago
Aprende cómo usar Discord para ver películas con tus amigos
-
Arte y Cultura14 años ago
Colección de fondos de pantalla basados en Super Héroes
-

 Almacenamiento2 años ago
Cómo usar TeraBox: La guía definitiva para aprovechar 1 TB de almacenamiento en la nube
-
Diseño13 años ago
css3ps: plugin que convierte archivos PSD a CSS3
-
Apps9 años ago
Picturethat, app que usa la Realidad Aumentada para visualizar cómo quedarían los cuadros antes de colgarlos
-
Eventos Especiales13 años ago
Especial Día de la Madres: fondos de pantalla especiales para Mamá