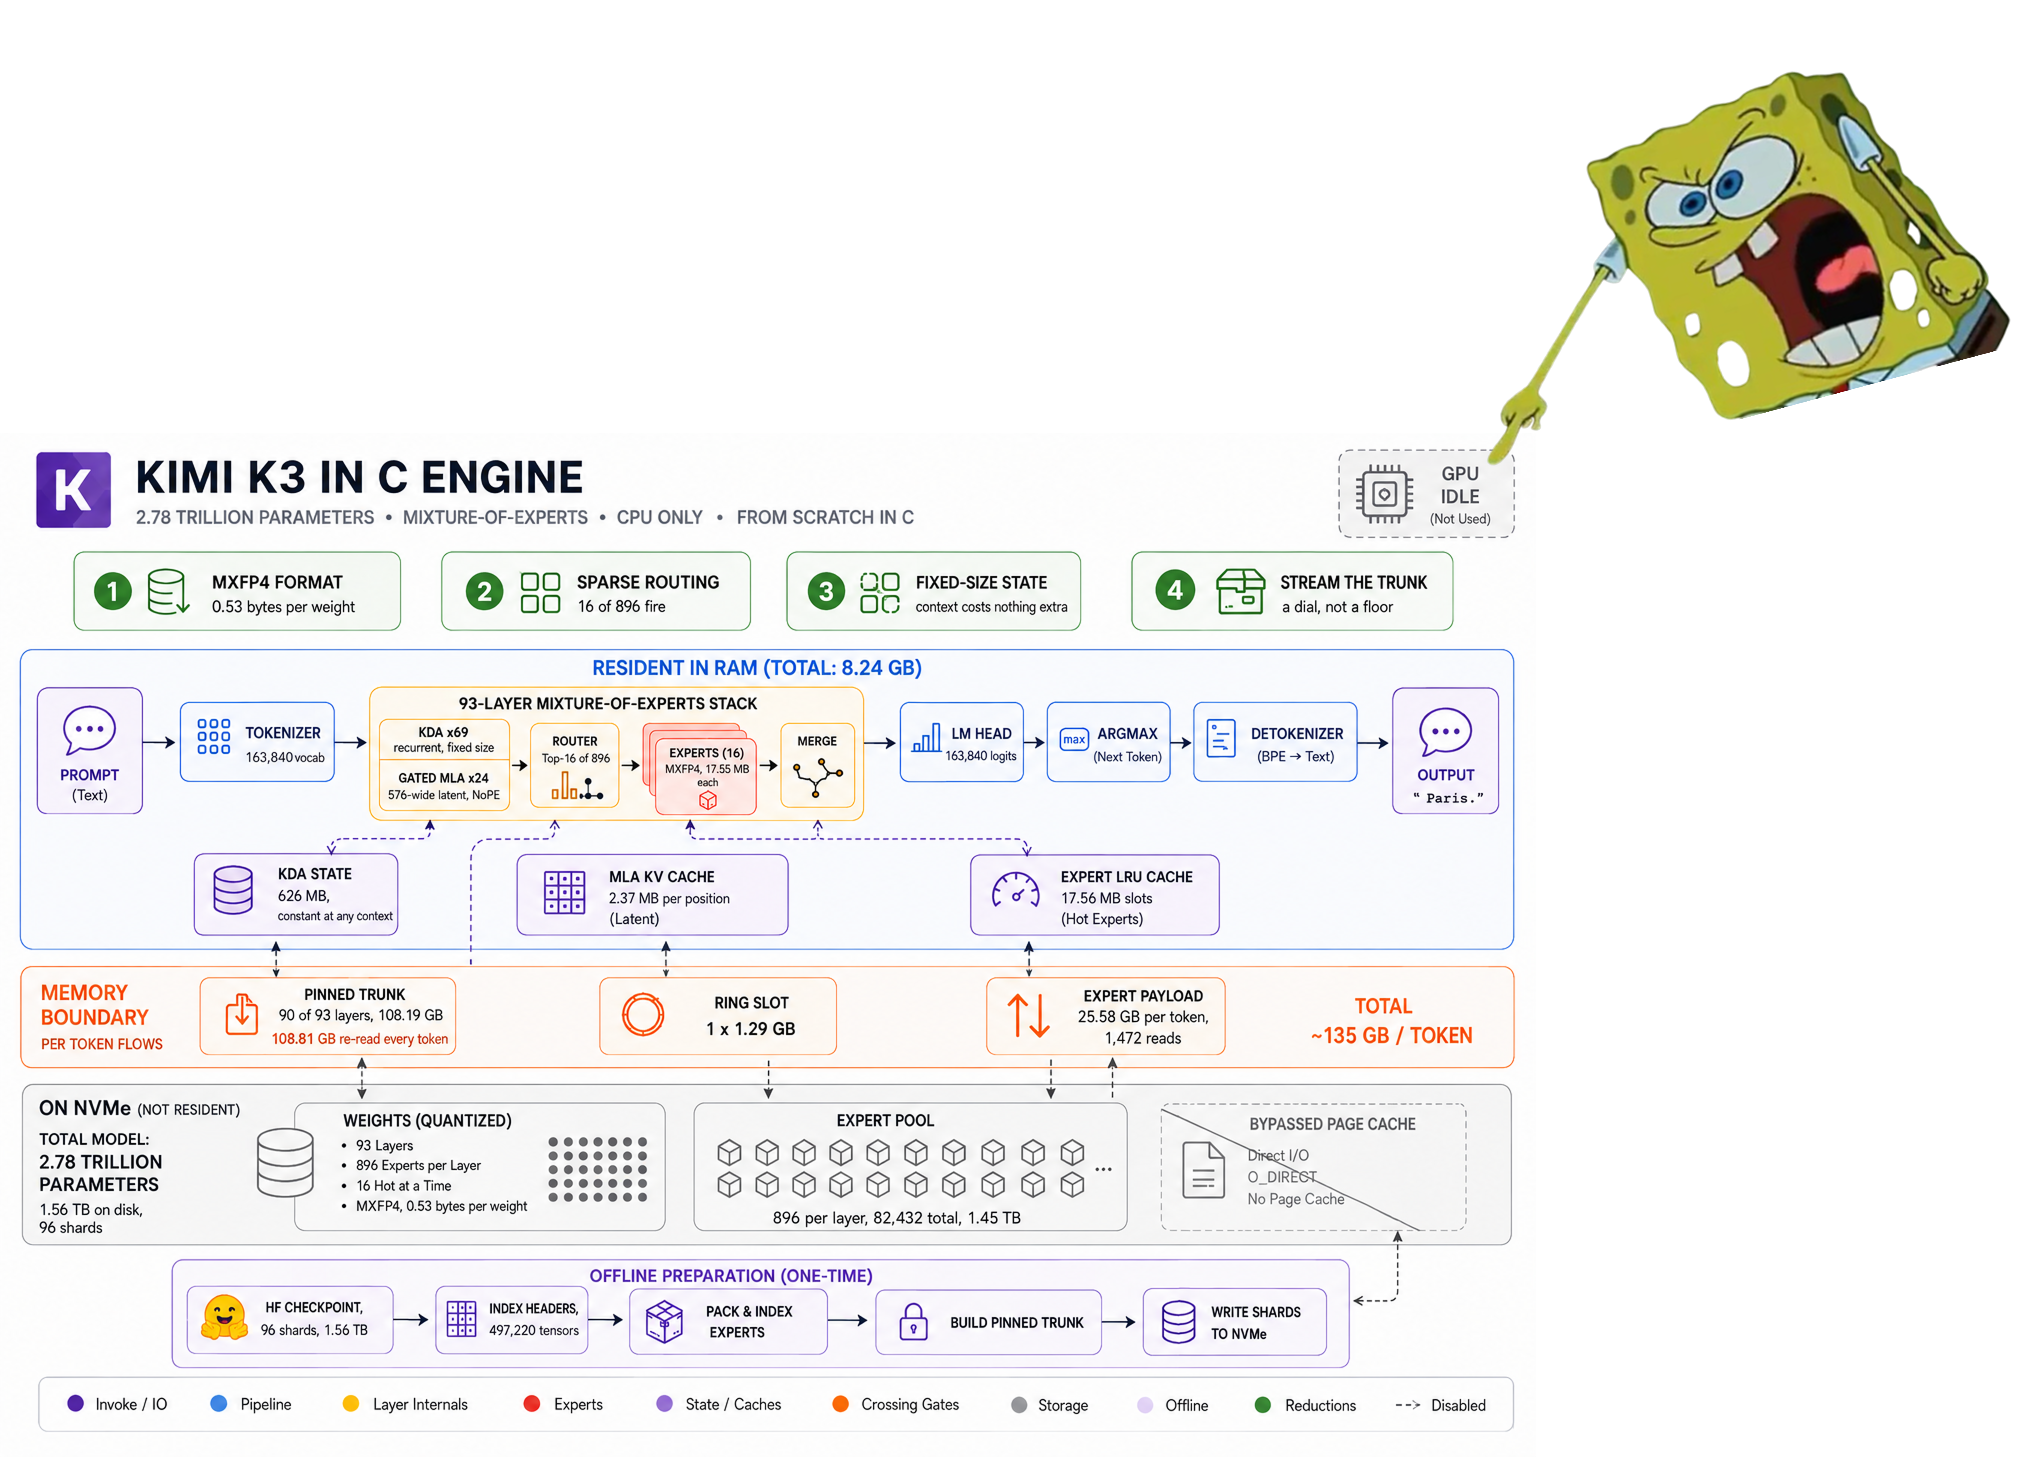
Un desarrollador logró ejecutar el modelo Kimi K3 de 2.78 billones de parámetros en una CPU común con solo 8.24 GB de RAM, sin GPU, sin...

Investigadores del Institute of Science and Technology Austria (ISTA) publicaron versiones GGUF cuantizadas de DeepSeek-V4.1-Flash-1017, un modelo sparse mixture-of-experts de 763.2 mil millones de parámetros con...

Qwythos 9B es, literalmente, un destilado: un modelo de 9B entrenado con las trazas de razonamiento de Claude Mythos 5 que cabe en una GPU de...

Una prueba documentada muestra cómo el flag –n-cpu-moe de llama.cpp descarga los expertos de un modelo Mixture-of-Experts a la RAM del sistema y multiplica por ocho...

La respuesta corta es sí, pero con matices importantes. Bonsai 27B permite correr en una GPU de 8 GB un modelo derivado de Qwen3.6 27B gracias...


Correr LLMs locales en una GPU de 8GB no depende de encontrar un modelo milagroso, sino de elegir bien la cuantización, repartir las tareas entre modelos...
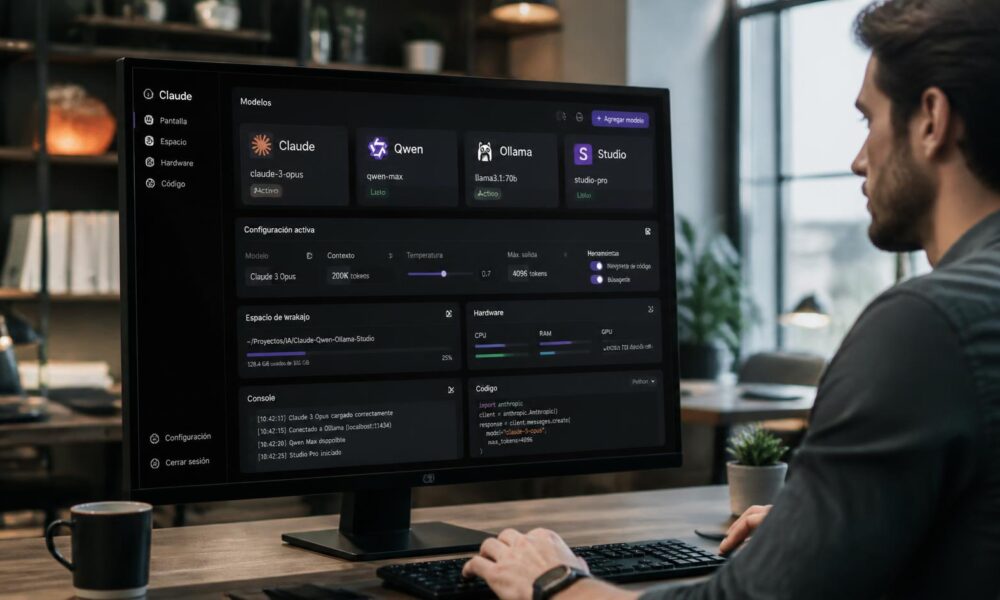


La compresión de modelos de inteligencia artificial permite ejecutar arquitecturas avanzadas como Qwen 2.5, Qwen 3 y Qwen 3.6 en tarjetas gráficas de consumo general. Reducir...


Los modelos de lenguaje locales ya no son territorio exclusivo de estaciones de trabajo con GPU dedicada. Hoy, un celular moderno puede ejecutar modelos pequeños con...


Los modelos de lenguaje locales ya no requieren tarjetas gráficas de gama alta. En esta guía, te mostramos qué modelos puedes ejecutar según la VRAM de...
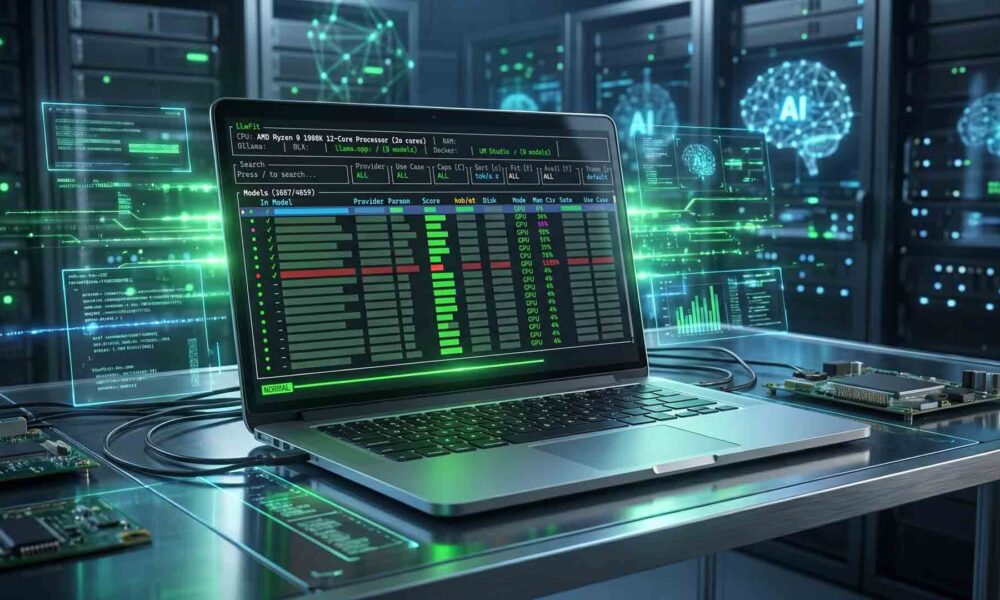


Si has descargado modelos de IA local que no funcionan en tu PC, LLMFit es la solución: analiza tu hardware en segundos y te recomienda los...


Instala llama.cpp en Windows y Mac sin compilar, compara con Ollama y LM Studio, y aprende a compartir modelos GGUF entre las tres herramientas sin duplicar...


¿Quieres ejecutar inteligencia artificial avanzada en tu computadora personal sin gastar en hardware costoso? Esta guía te muestra cómo aprovechar modelos de lenguaje locales como Gemma...


TurboQuant comprime la memoria de trabajo de los modelos de IA a 3 bits sin reentrenamiento ni pérdida de precisión: el avance de compresión más notable...


Ejecutar un modelo de lenguaje local en tu propio equipo es posible en casi cualquier hardware moderno: desde una laptop con procesador Snapdragon X Elite hasta...