

Digitalización
DeepSeek-V4.1-Flash en GGUF: cuantización que corre un modelo de 763B en 12 GB de VRAM

Investigadores del Institute of Science and Technology Austria (ISTA) publicaron versiones GGUF cuantizadas de DeepSeek-V4.1-Flash-1017, un modelo sparse mixture-of-experts de 763.2 mil millones de parámetros con 384 expertos enrutados por capa. Gracias a un método de cuantización no uniforme, las tres builds disponibles corren en una GPU de 12 GB de VRAM con Strata. La versión recomendada retiene el 100% del desempeño del modelo base.
¿Qué hace especial a esta publicación?
Lo llamativo no es el modelo en sí, sino cómo lo comprimieron. A diferencia de la cuantización uniforme, que aplica un solo tipo de cuantización a todos los tensores, este trabajo asigna un tipo de cuantización distinto a cada tensor del modelo. La asignación se obtiene mediante una búsqueda basada en gradientes que reparte la precisión según la sensibilidad de cada tensor, sujeto a un presupuesto total de tamaño. El resultado son archivos GGUF estándar que cualquier runtime compatible puede leer.
El método combina dos técnicas desarrolladas en el Deep Algorithms and Systems Lab (DASLab) de ISTA: GSQ (Gumbel-Softmax Quantization), que aprende de forma conjunta las asignaciones de la rejilla por coordenada y las escalas por grupo mediante una relajación Gumbel-Softmax, y RCO (Riemannian Constrained Optimization), que asigna los tipos de cuantización bajo un presupuesto de tamaño exacto reformulando la restricción como una variedad riemanniana suave en el espacio de logits. Vale la pena señalar que GSQ cierra la mayor parte de la brecha entre cuantización escalar y vectorial en el rango de 2 a 3 bits.
Si ya seguimos antes el lanzamiento del modelo base en nuestra cobertura de DeepSeek V4.1-Flash como el modelo de IA más económico y potente, esta publicación es el siguiente paso lógico: llevarlo a hardware de consumo.
¿Cuáles son las builds disponibles?
El repositorio ofrece tres tamaños, cada uno con su archivo backbone en cuatro shards más un archivo Engram compartido que contiene las tablas de búsqueda del modelo (196.6B parámetros a 4.50 bpw) y se descarga una sola vez:
- IQ1_M (1.75 bits por peso): 231.32 GB totales, la opción más pequeña; retiene 98.7% del promedio de tareas del modelo base.
- IQ2_XXS (2.00 bpw): 248.84 GB, la recomendada; iguala al modelo base en los tres benchmarks y alcanza el 100% de su promedio.
- IQ2_XS (2.25 bpw): 265.83 GB, con 99.8% de recuperación.
Un detalle técnico interesante: como los expertos enrutados dominan el conteo de parámetros, la búsqueda concentra ahí su margen de maniobra y asigna los tipos por capa, no por experto, porque el formato GGUF no puede expresar precisiones por experto individual. Las tablas Engram se leen de forma dispersa, una fila por token, así que pueden permanecer mapeadas en disco sin ocupar VRAM ni RAM.
¿Qué resultados obtiene frente al modelo base?
Los modelos se evaluaron contra el checkpoint original deepseek-ai/DeepSeek-V4.1-Flash-1017 (pesos densos FP8, expertos FP4) en tres benchmarks de razonamiento y generación, medidos a reasoning effort 50:
| Variante | AIME25 | GPQA-Diamond | LiveCodeBench v6 | Promedio | Recuperación |
|---|---|---|---|---|---|
| Base (FP8 / FP4) | 100.00 | 90.91 | 89.71 | 93.54 | 100.0% |
| GSQ-RCO IQ1_M | 100.00 | 88.38 | 88.57 | 92.32 | 98.7% |
| GSQ-RCO IQ2_XXS | 100.00 | 90.91 | 89.71 | 93.54 | 100.0% |
| GSQ-RCO IQ2_XS | 100.00 | 90.40 | 89.71 | 93.37 | 99.8% |
Que una build de 2 bits por peso iguale el promedio del modelo base en los tres benchmarks es, sencillamente, un hito para la inferencia local. Lo cierto es que hace un año un resultado así habría parecido ciencia ficción.
¿Cómo ejecutarlo hoy?
Aquí viene la letra pequeña: al 23 de octubre de 2026, llama.cpp aún no soporta DeepSeek-V4.1, así que por ahora los GGUF solo corren en Strata, el runtime con el que se optimizaron las builds y que ofrece un instalador de un clic más un endpoint compatible con OpenAI en localhost. Si te interesa el ecosistema de runtimes para LLM locales, ya comparamos opciones en nuestra guía práctica para elegir entre llama.cpp, Ollama, LM Studio y KoboldCpp.
El repositorio incluye además los comandos de llama.cpp listos para cuando llegue el soporte, junto con una plantilla de chat embebida que reproduce exactamente el codificador de DeepSeek, incluyendo el control de reasoning effort de 1 a 100 (por defecto, high). Cada build también incluye los artefactos de reproducibilidad: un archivo de texto con el tipo de cuantización asignado a cada uno de los 1008 tensores, auditable sin abrir el modelo.
Los pesos heredan la licencia MIT del modelo base, y las implementaciones de referencia de GSQ y RCO están publicadas en GitHub. Para quien quiera montar su propio stack de IA sin depender de la nube, la publicación completa está en el repositorio del modelo en Hugging Face.
Lo más leído en Digitalización
-
 Digitalización
Alibaba lanza Qwen4-Max: cuánto cuesta y qué tan fuerte es frente a Claude, GPT y Gemini
Alibaba presentó Qwen4-Max como el nuevo modelo insignia de la familia Qwen. La compañía lo posiciona para trabajo…
-
 Android
ArtCraft Android lleva las apps creativas de PC a tu celular sin recortar funciones
ArtCraft Android es un proyecto no oficial que porta las aplicaciones creativas de ArtCraft, escritas en Rust, a…


Digitalización
Alibaba lanza Qwen4-Max: cuánto cuesta y qué tan fuerte es frente a Claude, GPT y Gemini
Alibaba presentó Qwen4-Max como el nuevo modelo insignia de la familia Qwen. La compañía lo posiciona para trabajo profesional y científico complejo, con mejoras en seguridad y eficiencia. El lanzamiento general fue reportado el 16 de noviembre de 2026, después de una vista previa breve iniciada el 11 de noviembre, y llegó con precio público por API.
Lo más leído en Digitalización
-
Digitalización
Alibaba lanza Qwen4-Max: cuánto cuesta y qué tan fuerte es frente a Claude, GPT y Gemini
Alibaba presentó Qwen4-Max como el nuevo modelo insignia de la familia Qwen. La compañía lo posiciona para trabajo…
-
Android
ArtCraft Android lleva las apps creativas de PC a tu celular sin recortar funciones
ArtCraft Android es un proyecto no oficial que porta las aplicaciones creativas de ArtCraft, escritas en Rust, a…
ArtCraft Android es un proyecto no oficial que porta las aplicaciones creativas de ArtCraft, escritas en Rust, a dispositivos Android sin quitarles funciones de escritorio. Los APKs se descargan gratis desde GitHub Releases y conservan la misma base de código que sus versiones de PC, con integraciones nativas de archivos, teclado, mouse y pantalla táctil.
Lo más leído en Digitalización
-
Digitalización
Alibaba lanza Qwen4-Max: cuánto cuesta y qué tan fuerte es frente a Claude, GPT y Gemini
Alibaba presentó Qwen4-Max como el nuevo modelo insignia de la familia Qwen. La compañía lo posiciona para trabajo…
-
Android
ArtCraft Android lleva las apps creativas de PC a tu celular sin recortar funciones
ArtCraft Android es un proyecto no oficial que porta las aplicaciones creativas de ArtCraft, escritas en Rust, a…
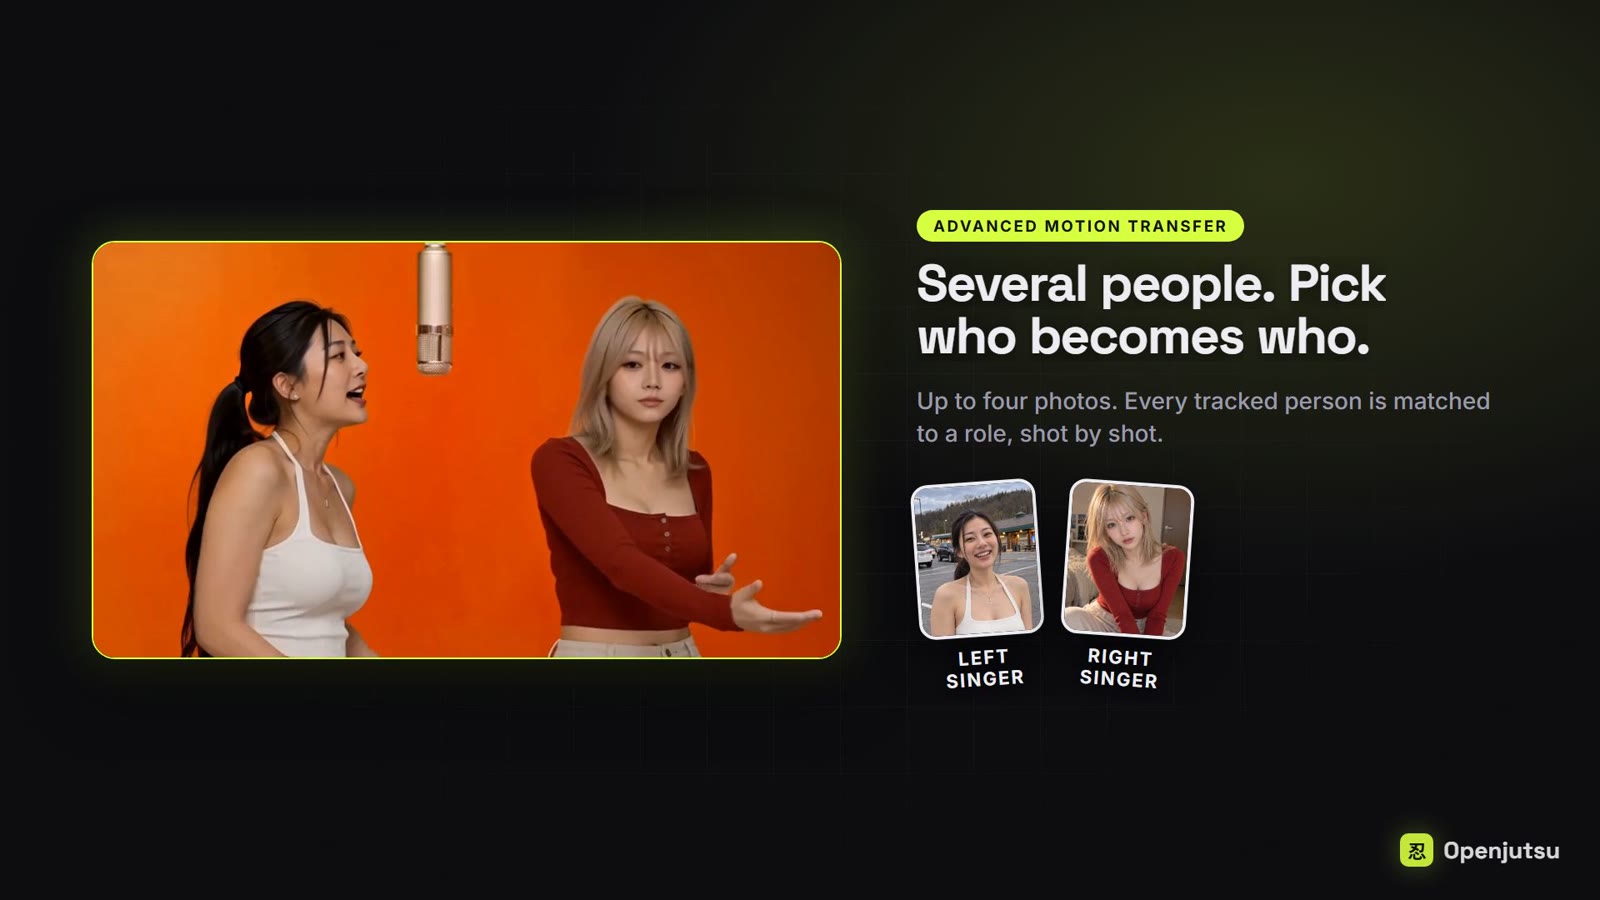
Openjutsu es una aplicación de código abierto que reemplaza a la persona principal de un video por cualquier personaje a partir de una foto, preservando cámara, cortes, movimiento y banda sonora. Es una alternativa local y gratuita al estilo Higgsfield Genjutsu, construida sobre ComfyUI con MiniMax H3 para el video, SAM 3.1 para rastrear personas y Qwen3-VL 8B para describir las escenas. Todo corre con pesos abiertos en tu propia GPU, bajo licencia MIT.
Lo más leído en Digitalización
-
Digitalización
Alibaba lanza Qwen4-Max: cuánto cuesta y qué tan fuerte es frente a Claude, GPT y Gemini
Alibaba presentó Qwen4-Max como el nuevo modelo insignia de la familia Qwen. La compañía lo posiciona para trabajo…
-
Android
ArtCraft Android lleva las apps creativas de PC a tu celular sin recortar funciones
ArtCraft Android es un proyecto no oficial que porta las aplicaciones creativas de ArtCraft, escritas en Rust, a…
Lo más leído
-
 Sin categoría
Revisión: Here Comes the Horde – Hordas masivas en automático
-
 Entretenimiento
Primeras impresiones: Chess of the Hidden Gates – Ajedrez y mazos
-
 Gaming
optimizerDuck: el optimizador de Windows de código abierto
-
 Entretenimiento
Revisión: Pegs of Hell – Pachinko roguelike de casino infernal
-
 Consola
Revisión: Highway Blossoms: Gold Rush Edition en Switch
-

 Apps11 años ago
AMPcast, la herramienta de Pandora que permite a los artistas grabar mensajes de audio directamente a sus seguidores
-
 Blogs5 años ago
Conoce los mejores sitios de Torrents para descargar todo tipo de contenidos
-
Android5 años ago
Aprende cómo usar Discord para ver películas con tus amigos
-
Arte y Cultura14 años ago
Colección de fondos de pantalla basados en Super Héroes
-

 Almacenamiento2 años ago
Cómo usar TeraBox: La guía definitiva para aprovechar 1 TB de almacenamiento en la nube
-
Diseño13 años ago
css3ps: plugin que convierte archivos PSD a CSS3
-
Apps9 años ago
Picturethat, app que usa la Realidad Aumentada para visualizar cómo quedarían los cuadros antes de colgarlos
-
Eventos Especiales14 años ago
Especial Día de la Madres: fondos de pantalla especiales para Mamá