

Guía
Guía práctica para elegir un LLM local: llama.cpp, Ollama, LM Studio y KoboldCpp

La conversación sobre IA local suele empezar mal planteada. Se pregunta cuál herramienta es mejor antes de definir para qué se usará, con qué hardware y con cuánto margen técnico cuenta el usuario. Ese orden confunde, porque ninguna opción resuelve de la misma manera la instalación, la ejecución, la gestión de modelos y la integración con otras apps.
La forma más útil de tomar una decisión es otra: primero conviene entender el escenario de uso, después el tipo de modelo que cabe en el equipo y solo al final el runtime adecuado. Desde esa lógica, llama.cpp, Ollama, LM Studio y KoboldCpp dejan de competir como si fueran equivalentes y pasan a ocupar lugares distintos dentro del ecosistema local.
Esta guía está pensada como un documento universal. No parte del entusiasmo técnico ni del hype del momento, sino de una necesidad concreta: ayudar al lector a elegir qué instalar, qué modelo probar primero, qué puerto local usar y qué rendimiento esperar sin perderse entre siglas, benchmarks aislados o recomendaciones demasiado vagas. Si aún no tienes claro si la IA local es para ti, antes conviene resolver cuándo usar modelos locales en lugar de ChatGPT o Claude.
¿Qué significa realmente usar un LLM local?
Usar un LLM local significa ejecutar el modelo directamente en la computadora del usuario, ya sea con CPU, con GPU o con un reparto híbrido entre ambas. En lugar de enviar prompts a un servicio remoto, la inferencia ocurre dentro del propio equipo, normalmente mediante un servidor local accesible desde localhost.
Eso cambia tres cosas de fondo. La primera es el control: el usuario decide qué modelo instala, cuánto contexto asigna y cómo se reparte el trabajo entre memoria y cómputo. La segunda es la privacidad: el contenido no tiene por qué salir de la máquina. La tercera es la economía de uso: desaparecen las cuotas por consulta, aunque siguen existiendo los límites físicos del hardware.
La consecuencia práctica es sencilla: un buen sistema local no es el más grande ni el más complejo, sino el que se mantiene estable, responde con fluidez y cabe con holgura razonable en la memoria disponible.
¿Qué debe evaluarse antes de instalar cualquier herramienta?
Antes de descargar un runtime conviene revisar cuatro variables. La primera es el objetivo: no es lo mismo resumir texto que programar, traducir o conversar durante sesiones largas. La segunda es el hardware: una laptop con memoria unificada no se comporta igual que una PC con GPU dedicada. La tercera es el nivel técnico del usuario: algunas herramientas están hechas para empezar rápido y otras para afinar al detalle. La cuarta es la forma de uso: hay quien solo quiere una ventana de chat y hay quien necesita una API local para conectarla con editores, agentes o automatizaciones.
Si esas cuatro variables no están claras, la elección suele terminar mal. Lo más frecuente es instalar un modelo demasiado grande, abrir un contexto innecesario, culpar a la herramienta por el mal rendimiento y concluir que la IA local todavía no está lista. En la mayoría de los casos, el problema no era la idea, sino la combinación elegida.
¿Qué papel juega cada herramienta?
| Herramienta | Qué resuelve mejor | Perfil más natural |
|---|---|---|
| llama.cpp | Inferencia eficiente, control fino y ajuste manual | Usuarios avanzados, desarrolladores, entusiastas |
| Ollama | Despliegue rápido con API local lista para usar | Desarrolladores, usuarios productivos, integraciones |
| LM Studio | Instalación simple, interfaz visual y prueba rápida de modelos | Principiantes, usuarios de escritorio, evaluación inicial |
| KoboldCpp | Chat local con interfaz web ligera y uso práctico de modelos GGUF | Usuarios que quieren una experiencia directa y flexible para conversar |
Las cuatro opciones pueden ejecutar modelos locales, pero lo hacen con enfoques distintos. Esa es la diferencia importante. No se trata solo de qué corre un modelo, sino de cómo lo instala, cómo lo expone, cómo lo administra y cuánto control entrega sobre el proceso.
¿Qué conviene instalar primero?
| Si el usuario quiere… | La opción más lógica | Motivo |
|---|---|---|
| Probar IA local sin pelear con la terminal | LM Studio | Interfaz gráfica, búsqueda de modelos y arranque muy guiado |
| Levantar un backend local para usarlo con apps y scripts | Ollama | La API local queda disponible en pocos pasos y el flujo es muy corto |
| Exprimir el hardware y ajustar cada parámetro importante | llama.cpp | Mayor control sobre contexto, backends, CPU, GPU y memoria |
| Conversar con modelos locales desde una interfaz web sencilla | KoboldCpp | Enfoque práctico, menos áspero que llama.cpp y muy orientado a chat |
Para un lector que entra por primera vez al tema, la mejor recomendación no es única. Si busca una experiencia de escritorio y cero fricción, LM Studio suele ser el punto de arranque correcto. Si necesita una API local desde el principio, Ollama es más natural. Si ya entiende la relación entre modelo, memoria y rendimiento, llama.cpp ofrece más margen. Si lo central es el chat local con una capa web liviana, KoboldCpp merece una consideración seria.
¿Por qué importa tanto localhost y el rango 127.0.0.x?
Cuando una herramienta expone un modelo en local, normalmente lo hace a través de una dirección del rango 127.0.0.x, también llamado loopback. En la práctica, eso significa que el servicio escucha dentro de la propia máquina. Para la mayoría de los usuarios, esa es la forma correcta de operar.
127.0.0.1 es la dirección habitual. Vincular el servicio a esa IP ayuda a evitar que el modelo quede expuesto a otros equipos de la red local. También simplifica la integración con apps que corren en la misma computadora, ya sea un editor, una interfaz web, un cliente compatible con OpenAI o un agente local.
Las direcciones como 127.0.0.2 o 127.0.0.3 pueden servir para separar pruebas simultáneas, pero no son una necesidad general. Para casi todos los casos, 127.0.0.1 basta.
Puertos habituales de uso local
| Herramienta | Dirección local típica | Uso habitual |
|---|---|---|
| llama.cpp | 127.0.0.1:8080 | Servidor local configurable para chat e integraciones |
| Ollama | 127.0.0.1:11434 | API local nativa para modelos, generación y embeddings |
| LM Studio | 127.0.0.1:1234 | Servidor local integrado en la app |
| KoboldCpp | 127.0.0.1:5001 o puerto similar configurable | Interfaz web local y servicio de chat |
El puerto no dice nada sobre la calidad del runtime. Solo indica dónde escucha. La recomendación general es mantener el servicio en loopback y cambiar el puerto únicamente si entra en conflicto con otro proceso local.
¿Qué es GGUF y por qué aparece en casi todas estas herramientas?
GGUF es uno de los formatos más importantes para la IA local actual. En términos prácticos, es un contenedor optimizado para ejecutar modelos cuantizados con metadatos necesarios para la inferencia. Su relevancia es simple: ha facilitado la distribución de modelos listos para correr en entornos locales sin exigir conversiones complejas a cada usuario.
Eso explica por qué herramientas como llama.cpp y KoboldCpp giran tan claramente alrededor de este formato, mientras que otras, como LM Studio y Ollama, también conviven de una u otra forma con ese ecosistema. Para el usuario final, lo importante no es memorizar el detalle técnico, sino entender que una misma familia de modelos puede aparecer en varias variantes GGUF con distintos tamaños, distinta cuantización y distinto consumo de memoria.
¿Qué es la cuantización y cómo afecta la experiencia?
La cuantización reduce la precisión numérica de los pesos del modelo para disminuir su tamaño y hacer posible su ejecución en hardware más modesto. En la práctica, es uno de los factores que más influyen en la elección de un modelo local.
Cuando la cuantización es más conservadora, el modelo suele mantener mejor calidad, pero consume más memoria. Cuando es más agresiva, cabe en equipos más limitados, aunque puede degradar parte del razonamiento, la coherencia o la precisión en tareas técnicas. No existe una variante universalmente superior: el valor está en el equilibrio.
Como regla de arranque, la mayoría de los usuarios debería optar por cuantizaciones intermedias, que suelen ofrecer una relación sana entre tamaño, velocidad y calidad. Si el hardware es muy justo, tiene sentido bajar más. Si hay margen amplio de memoria, se puede subir. Para ir más allá de esta regla básica, existe una guía completa para optimizar modelos de lenguaje locales en Ollama, LM Studio y llama.cpp.
¿Qué modelo conviene según el equipo?
La pregunta decisiva no es qué modelo está de moda, sino cuál puede ejecutarse con soltura razonable en el equipo disponible. Un modelo más pequeño y bien elegido suele resultar mucho más útil que uno grande obligado a trabajar al límite de la RAM o de la VRAM.
| Tipo de equipo | Rango recomendable | Uso más realista |
|---|---|---|
| CPU moderna, 16 GB de RAM, sin GPU dedicada | 1B a 4B cuantizado | Redacción, resúmenes, clasificación y pruebas básicas |
| Memoria unificada o GPU con 8 GB | 3B a 8B cuantizado | Chat general, escritura, traducción y ayuda ligera con código |
| GPU con 12 GB | 7B a 14B cuantizado | Uso diario más sólido y tareas técnicas moderadas |
| GPU con 16 GB | 8B a 14B densos y algunas variantes mayores bien ajustadas | Asistencia cotidiana seria, programación y automatización |
| GPU con 24 GB o más | 14B a 32B según cuantización y contexto | Tareas más complejas, mejor calidad y sesiones más largas |
El punto de equilibrio más universal sigue estando en los modelos instruct de tamaño medio. Para la mayoría de los equipos personales bien equipados, un rango entre 7B y 8B suele ofrecer una experiencia muy razonable. Para máquinas modestas, un 3B o 4B bien cuantizado suele ser una decisión más inteligente que un 7B demasiado pesado.
¿Qué familias de modelos suelen funcionar mejor en local?
| Tipo de uso | Familias habituales | Tamaño sensato para empezar |
|---|---|---|
| Uso general | Qwen, Llama, Gemma | 3B a 8B |
| Programación y asistencia técnica | Qwen coder y variantes coder abiertas | 7B a 14B |
| Equipos muy limitados | Modelos compactos instruct | 1B a 4B |
| Equipos con margen amplio | Modelos densos medianos y grandes | 14B en adelante |
En casi todos los casos conviene empezar con una variante instruct, porque está ajustada para seguir instrucciones y conversar. Un modelo base puede ser valioso en contextos más especializados, pero no suele ser la opción más natural para quien quiere resultados útiles desde el primer día. Para comparar candidatos concretos, vale la pena revisar la comparativa de modelos de IA local de 2026 entre Llama 3.1 8B, DeepSeek R1 Distill, Qwen 3.5 y Gemma 4.
¿Qué rendimiento puede esperarse en la práctica?
El rendimiento no depende solo del runtime. Lo determinan, sobre todo, el tamaño del modelo, la cuantización, el contexto, el backend de inferencia y la memoria disponible. Aun así, hay rangos orientativos que ayudan a evitar expectativas irreales.
| Clase de modelo | Hardware razonable | Rendimiento orientativo |
|---|---|---|
| 1B a 4B cuantizado | CPU moderna o GPU básica | 10 a 40 tokens por segundo |
| 7B a 8B cuantizado | 8 GB a 12 GB de VRAM | 15 a 50 tokens por segundo |
| 12B a 14B cuantizado | 12 GB a 16 GB de VRAM | 10 a 30 tokens por segundo |
| 20B a 32B cuantizado | 24 GB o más de VRAM | 8 a 25 tokens por segundo |
| 7B a 8B solo en CPU | RAM abundante y CPU moderna | 3 a 12 tokens por segundo |
Traducido a experiencia real, la escala suele sentirse así: por encima de 20 tokens por segundo el chat suele resultar fluido; entre 10 y 20 sigue siendo cómodo; entre 5 y 10 ya aparecen pausas perceptibles; por debajo de eso la conversación se vuelve más intermitente y la fricción aumenta.
¿Qué afecta más el rendimiento que la herramienta elegida?
Hay cinco variables que suelen pesar más que el nombre del runtime. La primera es la cuantización: un modelo mejor ajustado al hardware cambia por completo la experiencia. La segunda es el contexto: subirlo demasiado pronto consume memoria y castiga la velocidad. La tercera es el reparto entre CPU y GPU: cuando el modelo cabe bien en VRAM, la mejora puede ser muy clara. La cuarta es la tarea: no exige lo mismo un prompt corto que una sesión extensa con muchos documentos. La quinta es el backend: según la plataforma, el mismo modelo puede rendir de forma muy distinta.
Por eso los problemas más comunes no suelen resolverse “cambiando de herramienta” sin más, sino corrigiendo la combinación entre modelo, contexto y memoria.
¿Cómo instalar y usar LM Studio?
LM Studio es la puerta de entrada más accesible para muchos usuarios. Su fortaleza está en la experiencia de escritorio: búsqueda de modelos, descarga, carga y prueba dentro de una misma interfaz.
¿Cuándo conviene?
Conviene cuando el usuario quiere explorar modelos, empezar a conversar rápido y evitar, en la medida de lo posible, una curva técnica temprana. También es una buena opción para comparar varios modelos en un mismo equipo sin construir primero un flujo más complejo.
Ruta rápida de arranque
- Instalar la aplicación desde su sitio oficial en LM Studio.
- Abrir la sección de búsqueda de modelos.
- Elegir un modelo instruct acorde con la memoria disponible.
- Descargar una variante cuantizada razonable.
- Cargar el modelo dentro de la app.
- Activar el servidor local en 127.0.0.1:1234.
- Hacer una prueba simple en el chat integrado.
Ventajas reales
Reduce la fricción del primer contacto, simplifica la gestión visual de modelos y hace muy fácil validar si la IA local cabe dentro de una rutina cotidiana.
Limitaciones reales
No es la vía más ligera ni la más flexible para usuarios que quieren ajustar todo a mano. Cuando el proyecto crece en complejidad técnica, suele aparecer la necesidad de pasar a otra capa.
¿Cómo instalar y usar Ollama?
Ollama es especialmente útil para quien necesita un backend local simple, con una API clara y un flujo muy corto entre descargar el modelo y usarlo.
¿Cuándo conviene?
Conviene cuando el usuario quiere integrar el modelo con otras herramientas, usarlo desde scripts o levantar un servicio local rápidamente sin entrar todavía en la afinación profunda de la inferencia.
Ruta rápida de arranque
- Instalar Ollama desde su repositorio oficial o desde su instalador.
- Descargar un modelo adecuado para el hardware.
- Ejecutarlo localmente.
- Verificar que el servicio responde en 127.0.0.1:11434.
ollama pull qwen2.5:7b
ollama run qwen2.5:7b
Ventajas reales
Es rápido, ordenado y muy práctico para integraciones. El usuario puede pasar de cero a una API local funcional en pocos minutos.
Limitaciones reales
Abstrae parte del control técnico. Para muchos eso es una virtud, pero quien quiera gestionar al detalle el contexto, la carga en GPU o ciertos parámetros de inferencia terminará buscando una capa más abierta.
¿Cómo instalar y usar llama.cpp?
llama.cpp es el motor de referencia para buena parte del ecosistema local. Su prestigio no viene de la comodidad visual, sino del control, la eficiencia y la amplitud de hardware que soporta.
¿Cuándo conviene?
Conviene cuando el usuario quiere exprimir el hardware, entender qué está haciendo el runtime y ajustar manualmente variables importantes como contexto, offload a GPU, hilos o backends.
Ruta rápida de arranque
- Instalar binarios o compilar desde el repositorio oficial.
- Descargar un modelo GGUF adecuado.
- Cargarlo mediante CLI o servidor local.
- Exponerlo en una dirección local como 127.0.0.1:8080.
- Medir consumo y respuesta antes de aumentar complejidad.
llama serve -hf ggml-org/Qwen3.5-0.8B-GGUF --host 127.0.0.1 --port 8080Ventajas reales
Es la opción más flexible para afinación, aprendizaje técnico y optimización seria. También es la más adecuada para quien quiere entender de manera directa por qué un modelo rinde como rinde.
Limitaciones reales
Su curva de entrada es más exigente. No siempre es la mejor puerta para principiantes y puede resultar innecesaria para quien solo quiere una ventana de chat o una API sencilla.
¿Cómo instalar y usar KoboldCpp?
KoboldCpp merece estar en cualquier guía amplia porque ocupa un espacio intermedio muy útil. Toma el mundo GGUF y lo acerca a una experiencia más orientada al chat, con una interfaz web integrada y menos fricción que una configuración manual desde cero.
¿Cuándo conviene?
Conviene cuando el objetivo principal es conversar con modelos locales desde una interfaz web ligera, con una capa práctica y con cierto margen de ajuste sin tener que construir todo alrededor del runtime.
Ruta rápida de arranque
- Descargar la versión adecuada desde su repositorio en KoboldCpp.
- Cargar un modelo GGUF compatible.
- Levantar la interfaz web local.
- Mantener el servicio vinculado a 127.0.0.1 y al puerto configurado por la app, comúnmente en el rango de 5001.
- Probar sesiones cortas antes de ampliar contexto o complejidad.
Ventajas reales
Ofrece una experiencia más directa para chat local, con una interfaz web cómoda y un enfoque muy práctico para quien quiere conversar y ajustar lo esencial sin entrar de inmediato en una capa más áspera.
Limitaciones reales
No es la opción más natural para integraciones modernas por API al estilo de Ollama, ni ofrece el mismo grado de control técnico fino que llama.cpp. Su lugar más fuerte está en el uso conversacional local.
¿Qué errores conviene evitar desde el primer día?
El primero es cargar un modelo demasiado grande para el equipo. El segundo es abrir un contexto excesivo desde la prueba inicial. El tercero es confundir almacenamiento con memoria realmente utilizable. El cuarto es exponer el servicio fuera de localhost sin necesidad. El quinto es evaluar el sistema con prompts triviales, en lugar de usar tareas que se parezcan a las del trabajo real.
Una validación útil debería incluir al menos tres pruebas: redactar algo breve, resumir un texto de tamaño medio y ejecutar una tarea alineada con el objetivo principal del usuario, ya sea programación, clasificación o traducción. Si el sistema responde con fluidez aceptable ahí, la elección inicial fue buena.
¿Cuál es la ruta de adopción más sensata?
Para la mayoría de los usuarios, la secuencia más inteligente suele ser esta: empezar con una herramienta amigable o práctica, elegir un modelo instruct mediano, operar en 127.0.0.1, probar durante varios días con tareas reales y escalar solo cuando surja una necesidad concreta.
En esa lógica, una ruta razonable puede verse así:
- Empezar con LM Studio si se valora la facilidad visual, o con Ollama si se prioriza una API local.
- Probar un modelo instruct entre 3B y 8B, según el hardware.
- Medir rendimiento, memoria y utilidad cotidiana.
- Pasar a KoboldCpp si se quiere una experiencia de chat local más directa con interfaz web ligera.
- Dar el salto a llama.cpp cuando haga falta más control, más ajuste o mejor comprensión del costo técnico de cada decisión.
Conclusión
No existe una herramienta única que gane en todos los escenarios. LM Studio simplifica el arranque. Ollama organiza el despliegue rápido y la integración. llama.cpp sigue siendo la referencia cuando el control y la eficiencia importan más que la comodidad inicial. KoboldCpp, por su parte, merece un lugar propio como opción centrada en chat local y uso práctico de modelos GGUF con interfaz web ligera.
La mejor elección no es la más llamativa, sino la más adecuada para el equipo y la tarea. Si un modelo mediano, bien cuantizado y correctamente vinculado a 127.0.0.1 responde con soltura y cubre el trabajo diario, ya se tiene un sistema local útil. Y, para la mayoría de los usuarios, eso vale más que perseguir configuraciones grandilocuentes o modelos que obligan al hardware a trabajar al límite.
La regla final puede resumirse sin adornos: empezar pequeño, medir con honestidad y escalar solo cuando haga falta.
Lo más leído en Guía
-
ChatGPT
Convierte tu foto en tu propia Catrina con ChatGPT Images este Día de Muertos
La Catrina, figura icónica del Día de Muertos, ya no exige horas de maquillaje ni sesión de estudio:…
-
 Curiosidades
Oh-my-hermes guía completa para orquestar el agente Hermes con modelos en paralelo
Oh-my-hermes, o OMH, es una capa de operación de código abierto para Hermes Agent que convierte objetivos amplios…




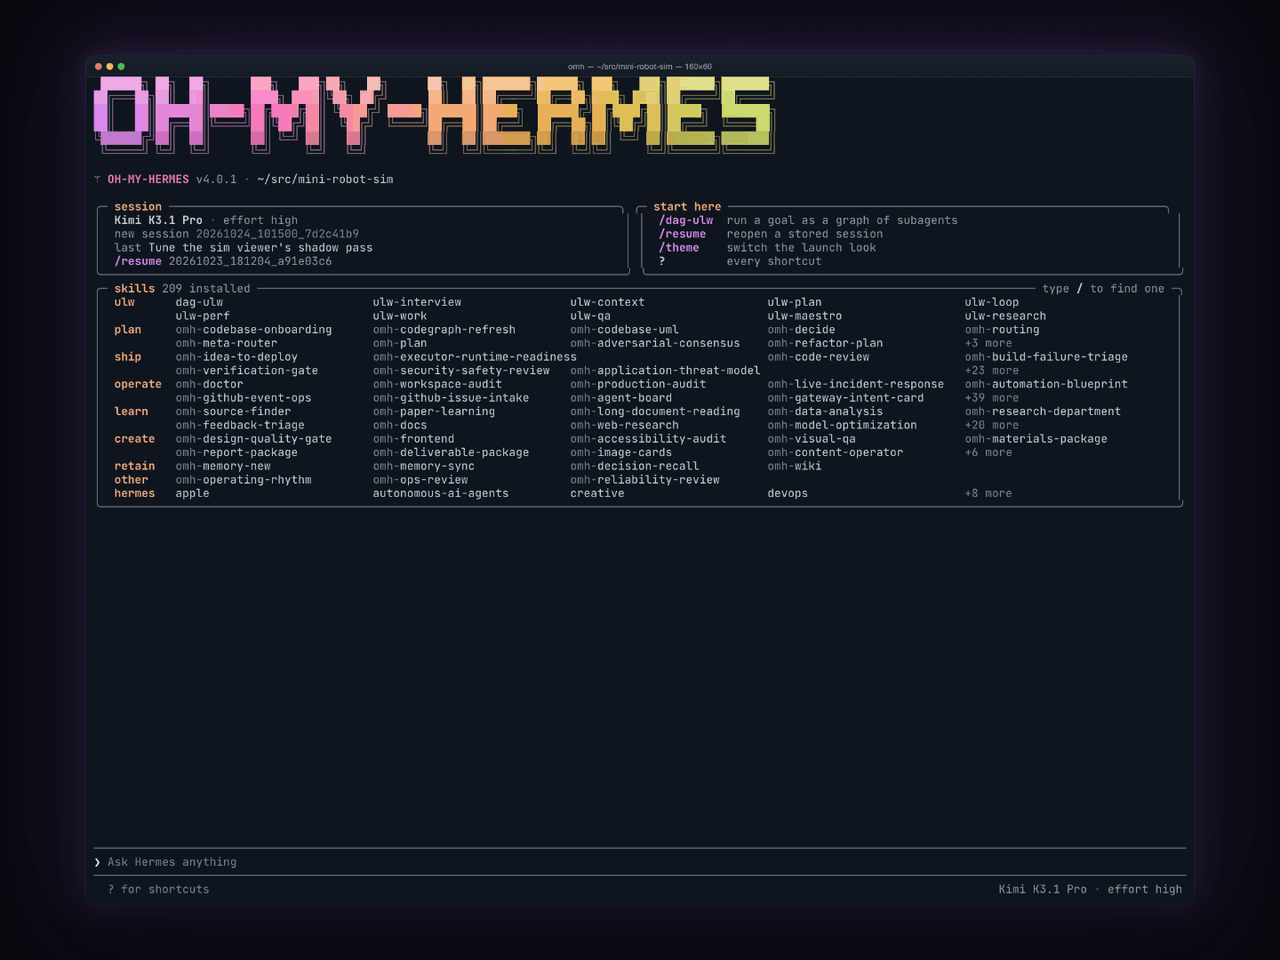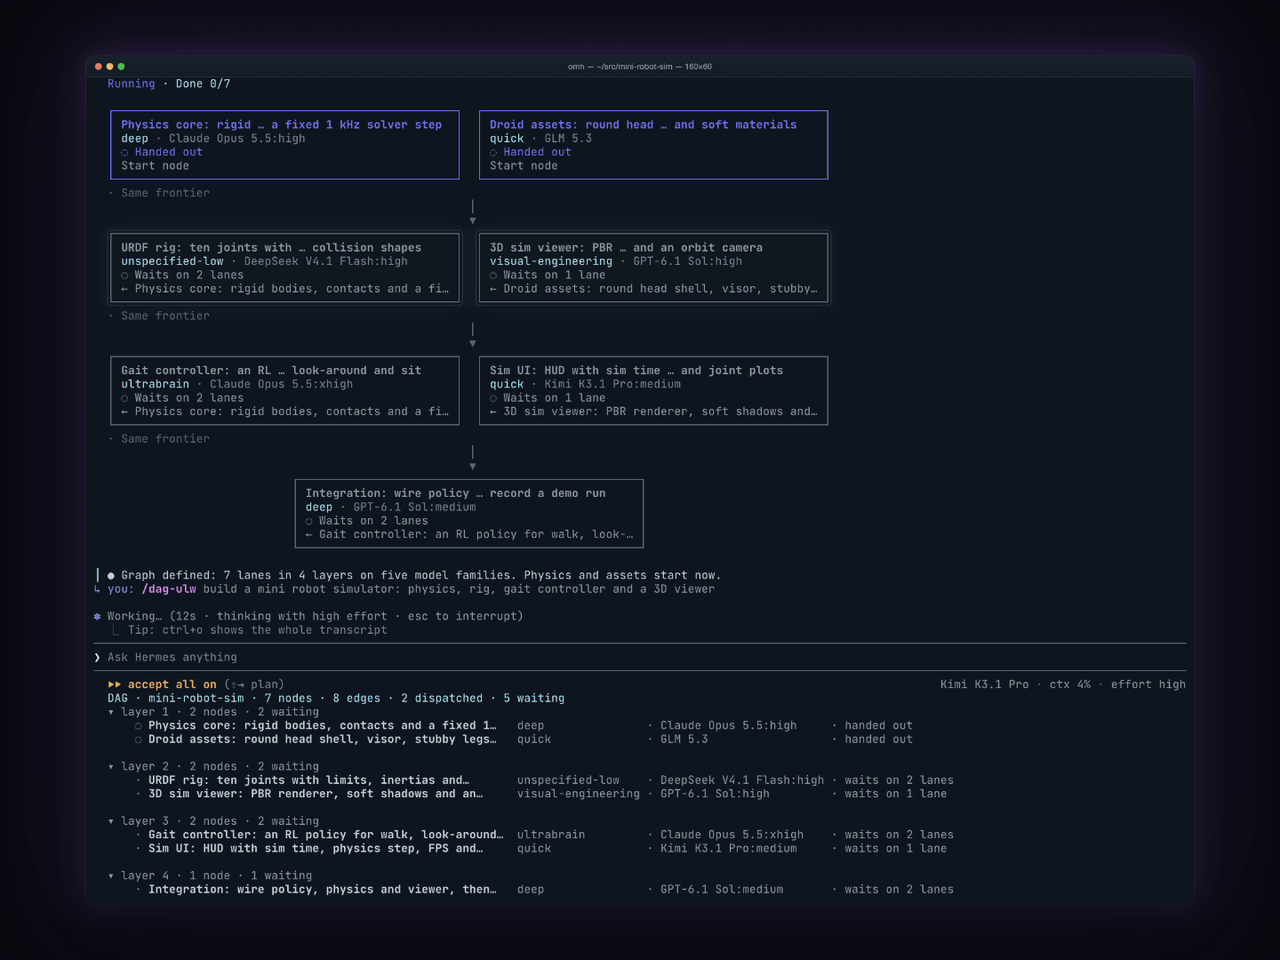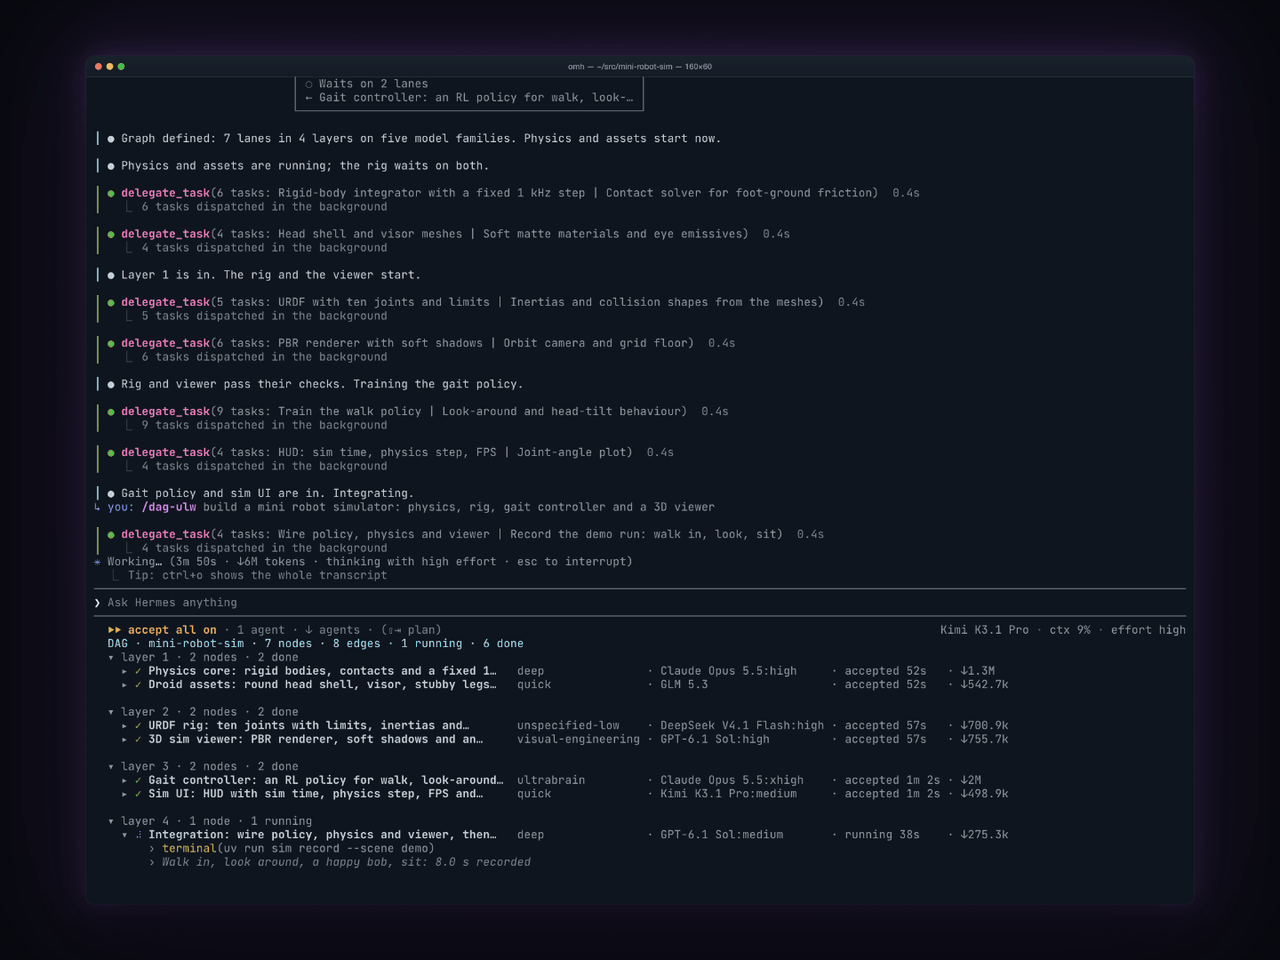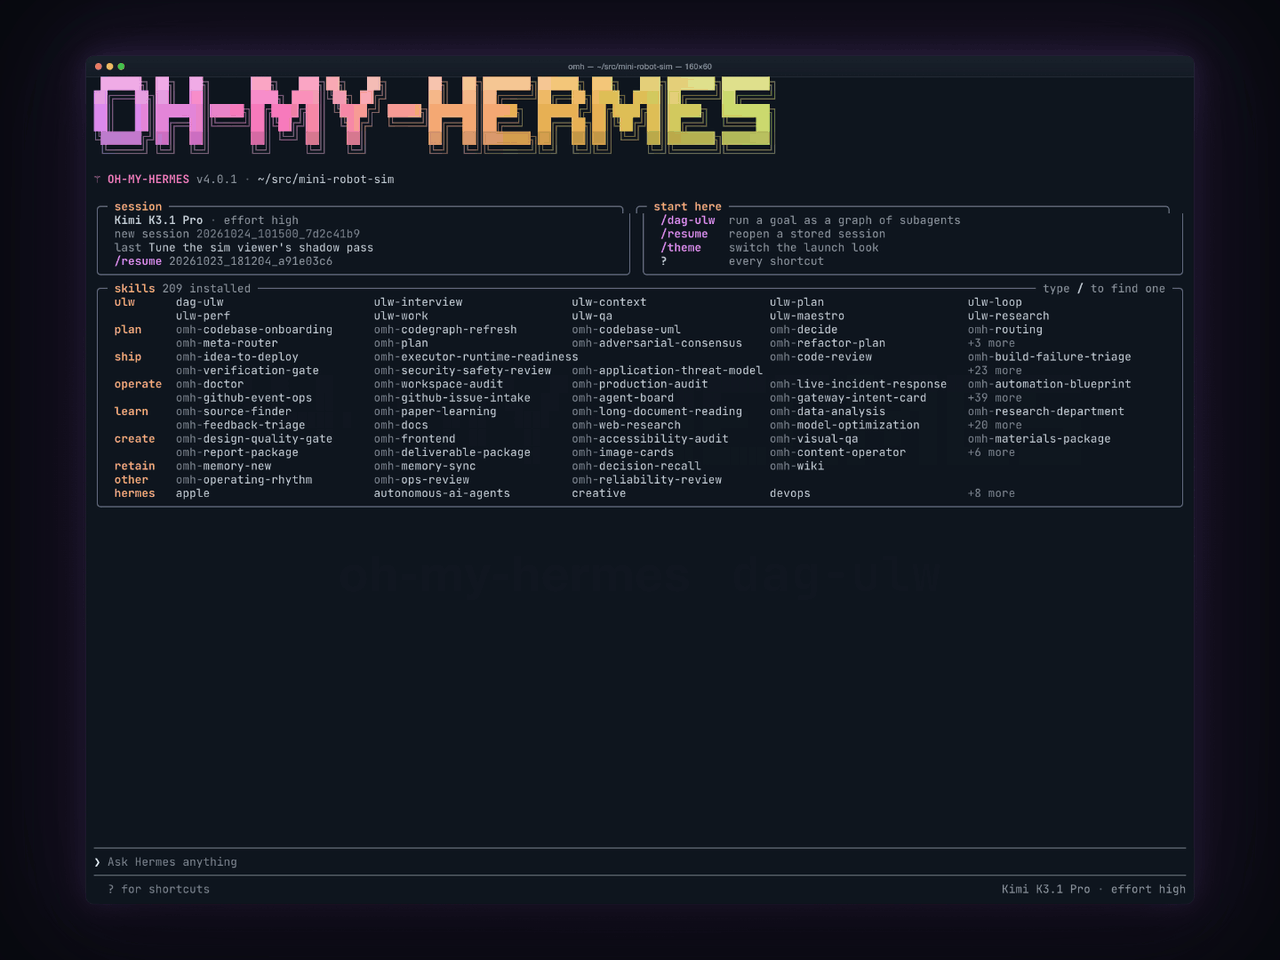
Oh-my-hermes, o OMH, es una capa de operación de código abierto para Hermes Agent que convierte objetivos amplios en flujos de trabajo verificables. En vez de tratar una petición como una sola conversación con un único modelo, la descompone en tareas pequeñas, decide qué modelo y qué nivel de razonamiento convienen en cada tramo, ejecuta trabajo en paralelo cuando no hay conflicto de escritura y separa con claridad lo planeado, lo ejecutado y lo verificado.
Lo más leído en Guía
-
ChatGPT
Convierte tu foto en tu propia Catrina con ChatGPT Images este Día de Muertos
La Catrina, figura icónica del Día de Muertos, ya no exige horas de maquillaje ni sesión de estudio:…
-
Curiosidades
Oh-my-hermes guía completa para orquestar el agente Hermes con modelos en paralelo
Oh-my-hermes, o OMH, es una capa de operación de código abierto para Hermes Agent que convierte objetivos amplios…

La Catrina, figura icónica del Día de Muertos, ya no exige horas de maquillaje ni sesión de estudio: ChatGPT Images puede transformar una fotografía en un diseño de Catrina único, inspirado en la personalidad, gustos y estilo de cada persona. OpenAI comparte el prompt exacto para lograrlo conservando los rasgos del rostro original.
Lo más leído en Guía
-
ChatGPT
Convierte tu foto en tu propia Catrina con ChatGPT Images este Día de Muertos
La Catrina, figura icónica del Día de Muertos, ya no exige horas de maquillaje ni sesión de estudio:…
-
Curiosidades
Oh-my-hermes guía completa para orquestar el agente Hermes con modelos en paralelo
Oh-my-hermes, o OMH, es una capa de operación de código abierto para Hermes Agent que convierte objetivos amplios…
Apple lanzó iOS 27.2, la primera gran actualización de iOS 27, con Siri AI en español, portugués, francés, japonés y coreano, perfiles en la app Apple TV, mejoras en Podcasts y soporte de Apple Pencil para el iPhone Duo. La actualización llegó el 26 de octubre de 2026 a todos los iPhone compatibles con iOS 27 y se instala desde Ajustes, General y Actualización de software. Eso sí: Siri AI en español no estará disponible en la Unión Europea ni en China continental.
Lo más leído en Guía
-
ChatGPT
Convierte tu foto en tu propia Catrina con ChatGPT Images este Día de Muertos
La Catrina, figura icónica del Día de Muertos, ya no exige horas de maquillaje ni sesión de estudio:…
-
Curiosidades
Oh-my-hermes guía completa para orquestar el agente Hermes con modelos en paralelo
Oh-my-hermes, o OMH, es una capa de operación de código abierto para Hermes Agent que convierte objetivos amplios…
Lo más leído
-
 Consola
Indie World Showcase octubre 2026: Witchbrook y todo lo anunciado para Nintendo Switch 2
-
 Entretenimiento
Primeras impresiones: Everlast: Undying Tale – RPG de acción MMO-Lite
-
 Desarrolladores
Pullboard: la fábrica de software con agentes IA que verifica cada cambio
-
 Animación
Revisión: 1008.ai – Plataforma de IA para crear imágenes y videos
-
 Herramientas
Vane la alternativa open source a Perplexity que puedes alojar en tu equipo
-

 Apps11 años ago
AMPcast, la herramienta de Pandora que permite a los artistas grabar mensajes de audio directamente a sus seguidores
-
 Blogs5 años ago
Conoce los mejores sitios de Torrents para descargar todo tipo de contenidos
-
Android5 años ago
Aprende cómo usar Discord para ver películas con tus amigos
-
Arte y Cultura14 años ago
Colección de fondos de pantalla basados en Super Héroes
-

 Almacenamiento2 años ago
Cómo usar TeraBox: La guía definitiva para aprovechar 1 TB de almacenamiento en la nube
-
Diseño13 años ago
css3ps: plugin que convierte archivos PSD a CSS3
-
Apps9 años ago
Picturethat, app que usa la Realidad Aumentada para visualizar cómo quedarían los cuadros antes de colgarlos
-
Eventos Especiales13 años ago
Especial Día de la Madres: fondos de pantalla especiales para Mamá