

Curiosidades
Comparativa de modelos de IA local en 2026: Llama 3.1 8B vs DeepSeek R1 Distill vs Qwen 3.5 vs Gemma 4

Muchos usuarios de IA local cometen el mismo error: usar un solo modelo para todo. En la práctica, ese enfoque rara vez da los mejores resultados. Un modelo generalista como Qwen2.5-7B-Instruct o Gemma 2 9B puede responder bien en conversación, pero quedarse corto en razonamiento paso a paso; otro, como DeepSeek R1 Distill o Gemma 4, puede destacar en lógica y análisis, pero ser menos ágil en tareas largas de redacción o asistencia cotidiana. La diferencia no siempre está en el número de parámetros, sino en cómo fue afinado el modelo y para qué clase de trabajo rinde mejor.
En 2026, el panorama de la IA local ha evolucionado con el lanzamiento de modelos como Gemma 4 y Qwen 3.5, que llevan el rendimiento a nuevos niveles en áreas específicas. Sin embargo, modelos como Llama 3.1 8B y DeepSeek R1 Distill siguen siendo referentes por su equilibrio y especialización.
¿Qué es DeepSeek R1 Distill?
DeepSeek-R1 es un modelo de razonamiento abierto que, según su documentación oficial, es comparable a OpenAI o1 en matemáticas, código y tareas de reasoning. A partir de ese modelo, DeepSeek publicó una familia de variantes distiladas sobre backbones abiertos como Qwen2.5 y Llama 3.x. En lugar de pedir al usuario que ejecute un modelo gigantesco, la idea es trasladar parte de ese comportamiento de razonamiento a modelos más pequeños y viables para hardware de consumo.
Los modelos DeepSeek-R1-Distill fueron afinados usando 800,000 muestras de razonamiento de alta calidad generadas por DeepSeek-R1. Esto explica por qué no son solo “versiones ligeras”, sino checkpoints concretos con una personalidad clara: priorizan la descomposición del problema y la generación de cadenas de razonamiento visibles. La familia incluye tamaños de 1.5B a 70B parámetros, todos basados en Qwen2.5 y Llama 3.x.
En abril de 2026, DeepSeek lanzó DeepSeek-V4, con avances arquitectónicos significativos para hacer que el contexto ultra largo sea utilizable en producción. Para quienes busquen más detalles sobre cómo implementar estos modelos en hardware específico, como procesadores AMD, pueden consultar la guía de OneDigital sobre DeepSeek R1 con hardware AMD Ryzen AI y Radeon.
¿Qué ofrece Llama 3.1 8B?
Llama 3.1 8B Instruct es uno de los modelos abiertos más versátiles de su tamaño. Meta lo lanzó con una ventana de contexto de 128K tokens, soporte multilingüe y mejoras claras frente a la generación anterior en tareas de código, matemáticas, seguimiento de instrucciones y uso general como asistente. Según su documentación en Ollama, es competitivo con modelos líderes como GPT-4, GPT-4o y Claude 3.5 Sonnet en más de 150 conjuntos de datos de evaluación.
No es un modelo de razonamiento especializado en el mismo sentido que DeepSeek R1, pero sí es una opción muy equilibrada cuando se busca un modelo único para productividad, desarrollo y conversación. Además, es uno de los modelos mejor soportados por runtimes y herramientas del ecosistema local.
Si necesitas ayuda para elegir el modelo ideal según las limitaciones de tu equipo, la guía de LLMFit en OneDigital te ayudará a analizar tu hardware y recomendar los modelos compatibles, ordenados por velocidad, calidad y contexto.
Modelos recientes: Gemma 4 y Qwen 3.5
El campo de la IA local avanza rápidamente, y en 2026 han surgido modelos como Gemma 4 y Qwen 3.5, que llevan el rendimiento a nuevos niveles:
- Gemma 4: Lanzado en julio de 2026 por Google, este modelo destaca por su ventana de contexto de hasta 256K tokens y soporte para más de 140 idiomas. Es multimodal (puede procesar texto e imágenes, y audio en modelos E2B, E4B y 12B), y está disponible en versiones que van desde E2B hasta 31B parámetros. Según su documentación oficial, Gemma 4 introduce mejoras significativas en código, razonamiento y soporte nativo para function-calling, lo que lo hace ideal para agentes autónomos y aplicaciones multimodales.
- Qwen 3.5: Lanzado el 16 de febrero de 2026, este modelo de Alibaba utiliza una arquitectura híbrida que combina Gated Delta Networks (atención lineal) con Mixture-of-Experts. Según su anuncio oficial, Qwen 3.5 obtiene 91.3 puntos en AIME 2026 y 94.8 en HMMT Feb 2026, siendo competitivo en tareas de razonamiento y matemáticas. Su diseño lo hace especialmente adecuado para código, programación y tareas técnicas.
Si estás evaluando estas opciones, te recomendamos probarlos en tu hardware y comparar su rendimiento con modelos como Llama 3.1 8B o DeepSeek R1 Distill para ver cuál se adapta mejor a tus necesidades.
La comparación correcta: ¿cuál modelo usar para cada tarea?
La pregunta no es cuál es “mejor” en abstracto, sino cuál conviene usar para cada tarea. Llama 3.1 8B tiende a responder de forma más directa y estable en flujos generales de trabajo, mientras que DeepSeek R1 Distill suele mostrar más disposición a explicitar pasos intermedios, revisar su propio hilo lógico y llegar a soluciones razonadas en tareas de matemática, lógica o análisis estructurado.
Esto se vuelve especialmente evidente en preguntas donde el valor no está solo en dar una respuesta, sino en exponer cómo se llega a ella. En pruebas con acertijos simples, análisis heurísticos y revisión de markup, los modelos distilled de DeepSeek tendieron a verbalizar mejor el proceso, mientras que Llama resultó más natural como asistente general y más cómodo en tareas continuas de productividad.
Un ejemplo simple: razonamiento frente a respuesta directa
Un ejemplo útil para ilustrar esa diferencia es el clásico acertijo de lectura atenta: “Un granjero tiene 17 ovejas. Todas menos 9 mueren. ¿Cuántas quedan?”. Un modelo afinado para razonamiento, como DeepSeek R1 Distill, no necesariamente “sabe” más, pero suele:
- Detenerse en la estructura de la frase.
- Identificar que “todas menos 9” significa que 9 sobreviven.
- Verificar la intuición con un caso análogo (ej: “10 ovejas, todas menos 2 mueren → quedan 2”).
Esto no significa que otros modelos fallen siempre, pero sí muestra una diferencia de estilo. En muchos flujos reales, lo importante no es solo acertar, sino hacerlo de una manera que permita al usuario confiar en el diagnóstico.
¿Dónde DeepSeek R1 Distill aporta más valor?
Los modelos DeepSeek-R1-Distill tienen sentido cuando la tarea exige una estructura argumental visible. Esto incluye:
- Resolución de problemas matemáticos.
- Revisión lógica y debugging conceptual.
- Evaluación heurística de interfaces.
- Interpretación de restricciones.
- Diagnóstico de causas raíz.
En escenarios de UX, por ejemplo, su ventaja no está tanto en “tener mejor gusto”, sino en su tendencia a explorar hipótesis de forma más explícita antes de proponer una conclusión.
¿Dónde Llama 3.1 8B sigue siendo una excelente elección?
Llama 3.1 8B sigue siendo muy competitivo cuando el trabajo requiere flexibilidad. En asistencia general, redacción, scripting, ayuda en código, explicaciones técnicas, resúmenes, brainstorming y productividad cotidiana, su equilibrio pesa mucho. También ofrece una ventana de contexto larga (128K tokens), lo que le permite comportarse bien en documentos extensos, bases de notas y conversaciones continuas donde importa conservar historial.
Además, Llama 3.1 8B destaca por su enorme disponibilidad práctica: hay más cuantizaciones, más guías de uso, mejor compatibilidad con herramientas y una comunidad amplia. Para quien solo quiere un modelo local fiable que sirva para muchas tareas razonablemente bien, Llama sigue siendo una decisión sólida.
Si buscas optimizar el rendimiento en equipos con recursos limitados, como una laptop con 8GB de RAM, la guía para ejecutar IA local en equipos con 8GB de RAM en OneDigital explica cómo hacerlo de manera eficiente.
Qwen y Gemma no son “malos”
Parte del problema en muchas comparativas es que se habla de Qwen o Gemma como si fueran modelos únicos, cuando en realidad son familias enteras. Qwen2.5-7B-Instruct, por ejemplo, tiene resultados muy fuertes en matemáticas y código, e incluso en la documentación oficial aparece superando a Llama 3.1 8B Instruct en varios benchmarks específicos. Del mismo modo, Gemma 2 9B o Gemma 3 4B tienen sus propias fortalezas según el contexto.
En una comparación bien construida, lo razonable es reconocer que:
- Qwen2.5-7B-Instruct compite muy bien como modelo generalista técnico, especialmente en código y matemáticas.
- Las versiones concretas de Gemma pueden funcionar mejor como modelos ligeros o eficientes según el entorno.
Comparativa práctica por tipo de tarea (2026)
| Modelo | Tamaño | Ventana de Contexto | Fortalezas | Límites | Caso de Uso Ideal | Fecha de Lanzamiento |
|---|---|---|---|---|---|---|
| Llama 3.1 8B | 8B | 128K tokens | Asistencia general, código, multilingüe, uso de herramientas avanzado | No especializado en razonamiento visible | Productividad, scripting, chat | 2024 (actualizado 2026) |
| DeepSeek R1 Distill | 1.5B – 70B | Variable | Razonamiento paso a paso, análisis estructurado, matemáticas, lógica | Puede ser más verboso y lento | Resolución de problemas, UX, debugging | 2025-2026 |
| Qwen 3.5 | 397B (y otros) | Variable | Arquitectura híbrida (Gated DeltaNet + MoE), alto rendimiento en benchmarks | Requiere hardware potente | Código, matemáticas, tareas técnicas | Febrero 2026 |
| Gemma 4 | E2B – 31B | 128K – 256K tokens | Multimodal (texto + imagen), soporte para 140+ idiomas, función function-calling | Modelos grandes requieren más VRAM | Aplicaciones multimodales, agentes autónomos | Julio 2026 |
| Qwen2.5-7B-Instruct | 7.6B | Variable | Fuerte en código y matemáticas, equilibrio técnico | Menos especializado en razonamiento | Uso técnico general, programación | 2025 |
| Gemma 2 9B | 9B | Variable | Eficiencia, ecosistema sólido, buen desempeño general | Conviene afinar la elección de variante | Resúmenes, análisis general | 2025 |
Hardware local: ¿qué sí se puede afirmar sin simplificar?
La relación entre modelo y hardware local no se puede resumir en una sola cifra fija de VRAM. Decir que un modelo de 7B “requiere 6 GB” o que uno de 70B “entra en 24 GB” como regla general es demasiado simplista. La memoria real depende del formato, la cuantización, la longitud del contexto, el runtime y el porcentaje del modelo que se descarga a GPU.
Como regla editorial prudente:
- Los modelos de 7B a 8B suelen ser los más cómodos para GPUs de consumo con cuantizaciones razonables (ej: Q4_K_M, Q5_K_M).
- Los modelos de 14B ya exigen más margen o CPU offload.
- Los de 32B en adelante empiezan a entrar en otra categoría, y los 70B no son el punto de partida natural para una PC gamer estándar.
La mejor estrategia: construir un stack de modelos locales
Quien trabaja con IA local con cierta frecuencia suele descubrir lo mismo: un solo modelo rara vez cubre todas las necesidades con la misma elegancia. Lo más útil es pensar en un pequeño stack:
- Llama 3.1 8B como asistente general.
- DeepSeek-R1-Distill-Llama-8B para tareas de razonamiento y análisis estructurado.
- Qwen 3.5 para código y tareas técnicas avanzadas.
- Gemma 4 para aplicaciones multimodales o agentes autónomos.
Esta combinación aprovecha mejor el hardware y evita obligar a un único modelo a resolver trabajos para los que no fue ajustado.
¿Cómo empezar a probarlos en local?
Para empezar, conviene usar una herramienta que facilite la carga de modelos y el cambio entre cuantizaciones. LM Studio es una de las opciones más accesibles para escritorio, y Ollama sigue siendo una alternativa popular si se prefiere una experiencia más simple desde terminal.
Los pesos oficiales se encuentran en:
- Hugging Face para Llama 3.1 8B.
- Hugging Face para DeepSeek-R1-Distill-Llama-8B.
- Hugging Face para Qwen 3.5.
- Google AI para Gemma 4.
La recomendación práctica es simple:
- Elige un modelo de 7B u 8B.
- Carga una cuantización razonable que no fuerce la VRAM al límite.
- Prueba con prompts reales de tu flujo de trabajo: redacción, código, reasoning y análisis.
Conclusión
La IA local es un campo en constante evolución. Mientras que modelos como Llama 3.1 8B, DeepSeek R1 Distill, Qwen2.5-7B-Instruct y Gemma 2 9B siguen siendo excelentes opciones para la mayoría de los usuarios, los lanzamientos recientes como Gemma 4 y Qwen 3.5 están redefiniendo lo que es posible en términos de razonamiento, multimodalidad y eficiencia.
La clave sigue siendo la misma: no hay un modelo universal. La mejor estrategia es construir un stack de modelos que se complementen según tus necesidades y el hardware disponible. Y, por supuesto, mantenerse actualizado con las últimas versiones y sus capacidades.
Lo más leído en Curiosidades
-
ChatGPT
Retratos de mascotas con ChatGPT Images para el Día de Muertos
Las mascotas también forman parte de las historias que se recuerdan durante el Día de Muertos: con ChatGPT…
-
 Curiosidades
Cómo crear con IA un script de respaldo automático para Windows
Un asistente de inteligencia artificial puede ayudar a escribir y adaptar un script de PowerShell para copiar archivos…





Lo más leído en Curiosidades
-
ChatGPT
Retratos de mascotas con ChatGPT Images para el Día de Muertos
Las mascotas también forman parte de las historias que se recuerdan durante el Día de Muertos: con ChatGPT…
-
Curiosidades
Cómo crear con IA un script de respaldo automático para Windows
Un asistente de inteligencia artificial puede ayudar a escribir y adaptar un script de PowerShell para copiar archivos…

Las mascotas también forman parte de las historias que se recuerdan durante el Día de Muertos: con ChatGPT Images es posible transformar una fotografía guardada en el celular o en un álbum en un retrato conmemorativo que celebre su vida y ocupe un lugar especial en la ofrenda.
Lo más leído en Curiosidades
-
ChatGPT
Retratos de mascotas con ChatGPT Images para el Día de Muertos
Las mascotas también forman parte de las historias que se recuerdan durante el Día de Muertos: con ChatGPT…
-
Curiosidades
Cómo crear con IA un script de respaldo automático para Windows
Un asistente de inteligencia artificial puede ayudar a escribir y adaptar un script de PowerShell para copiar archivos…
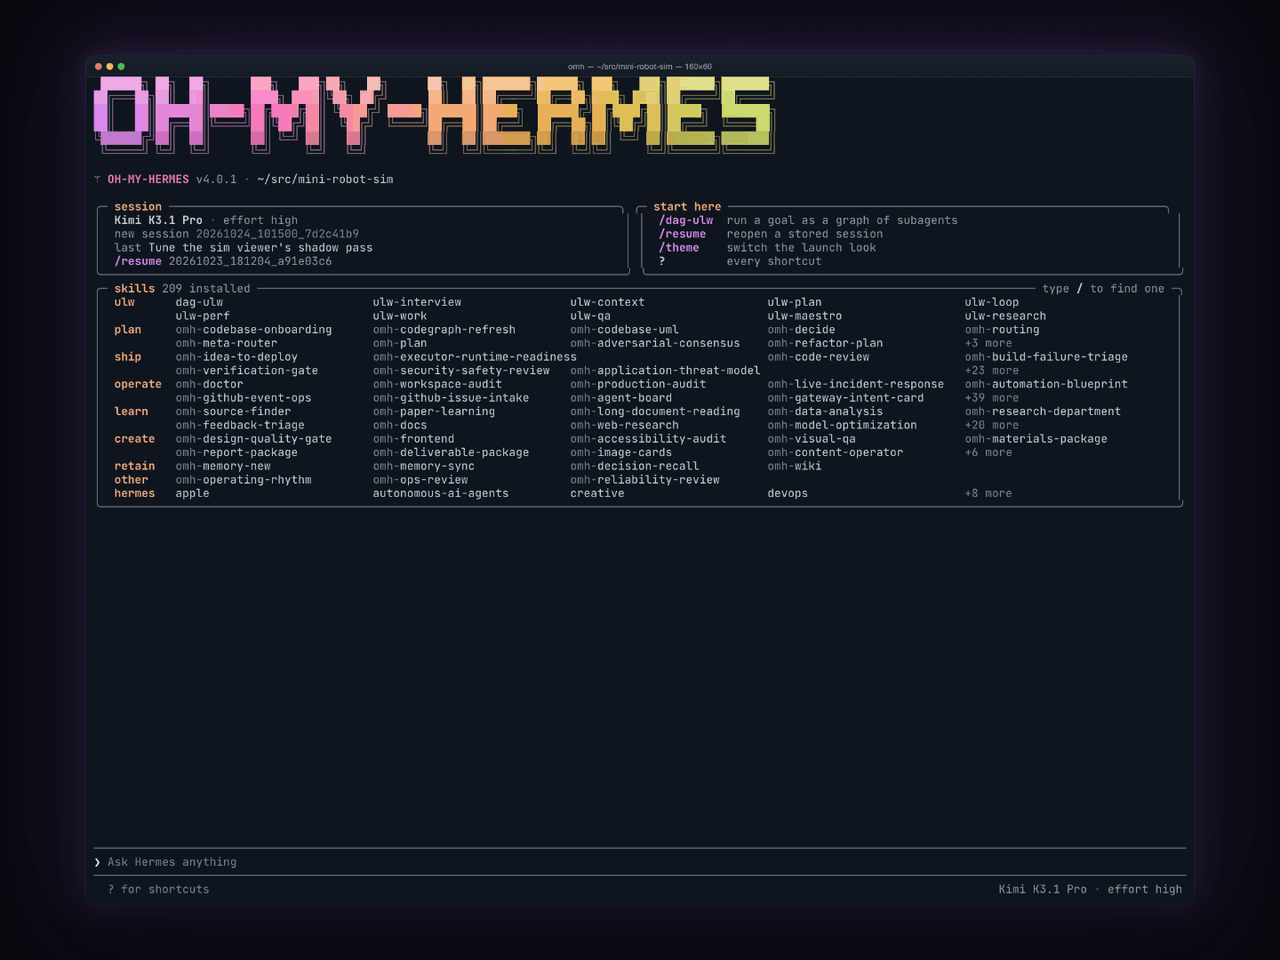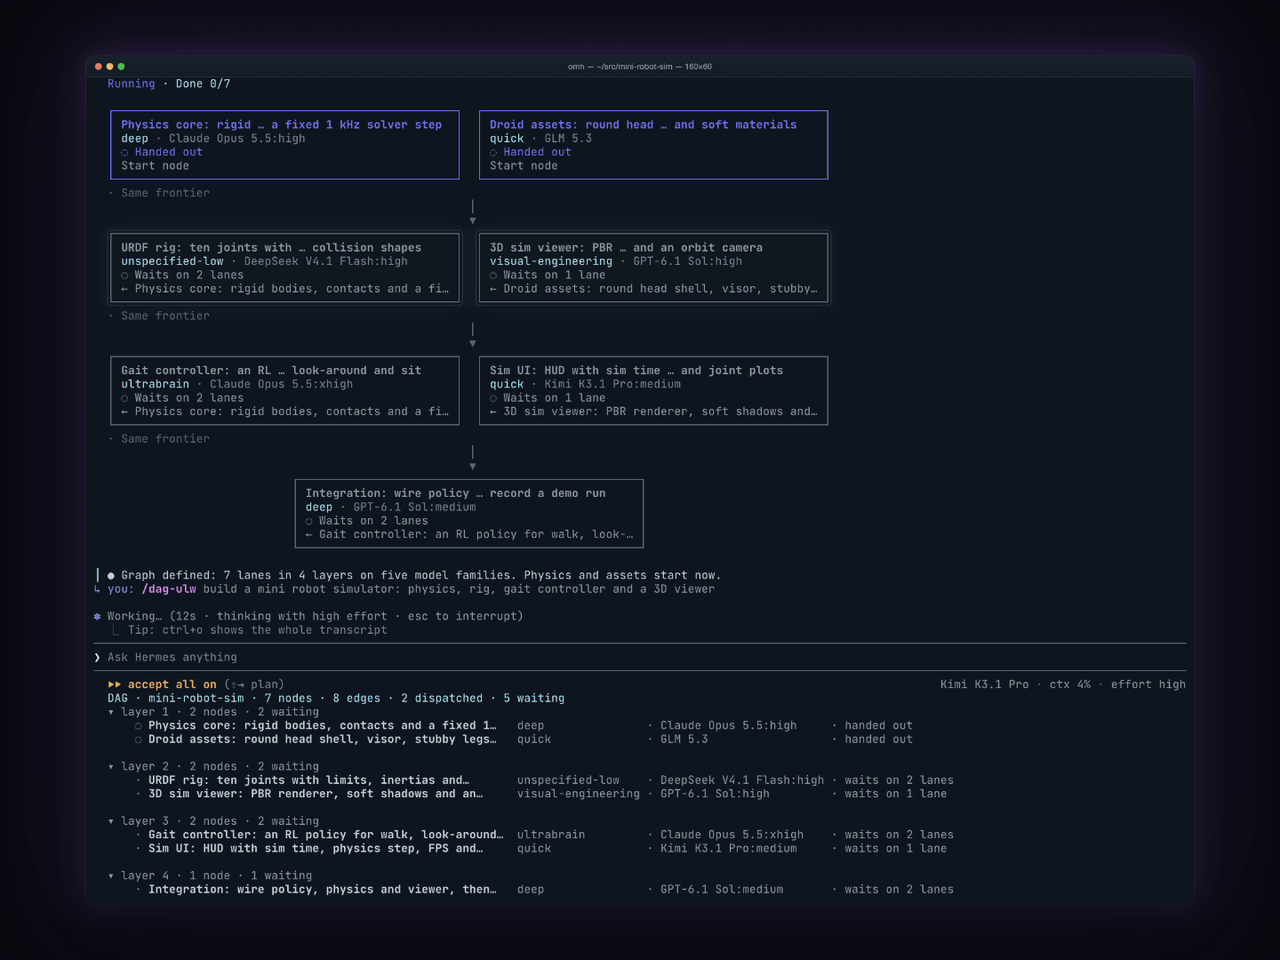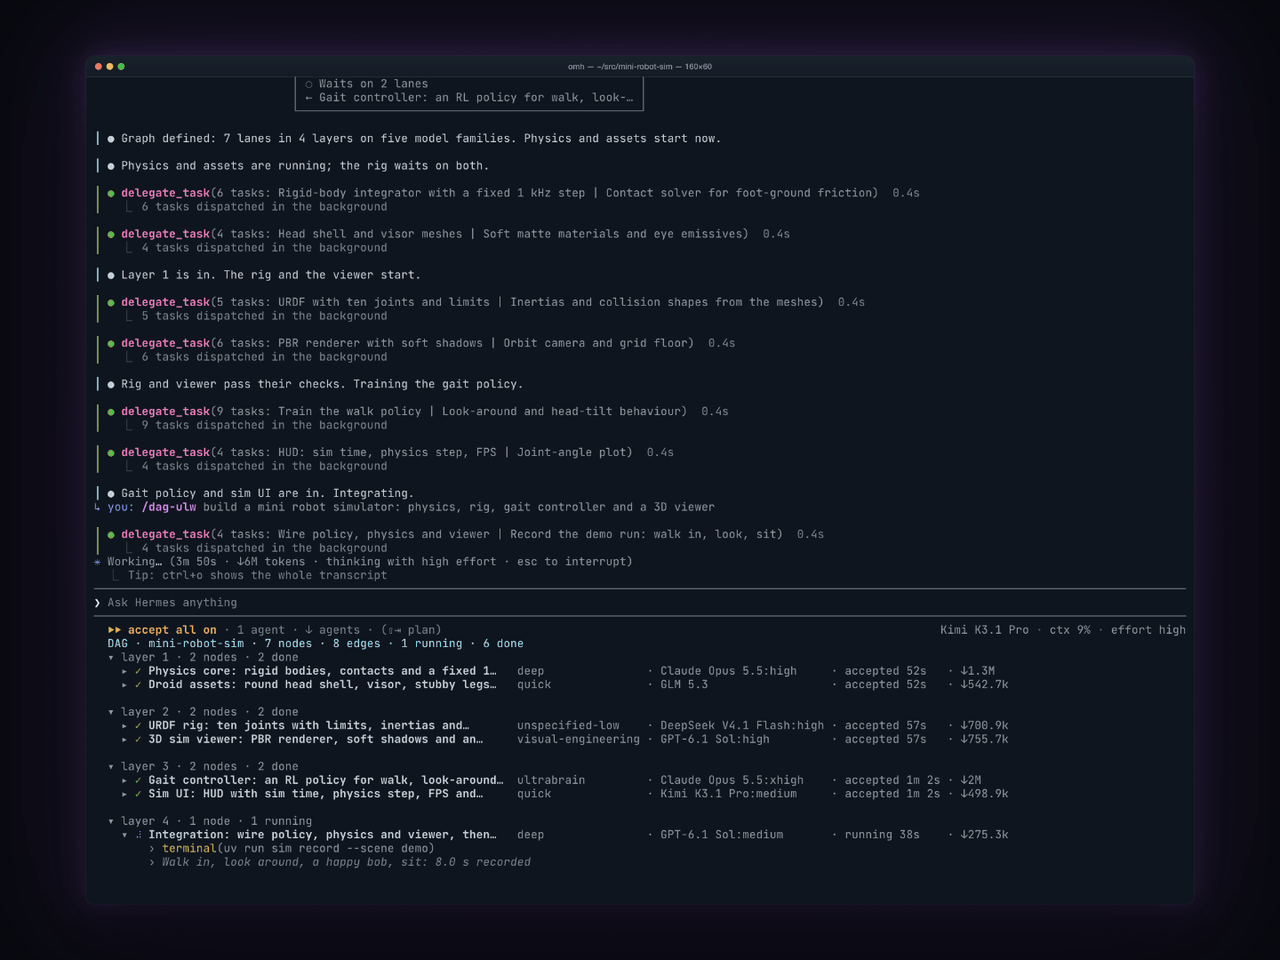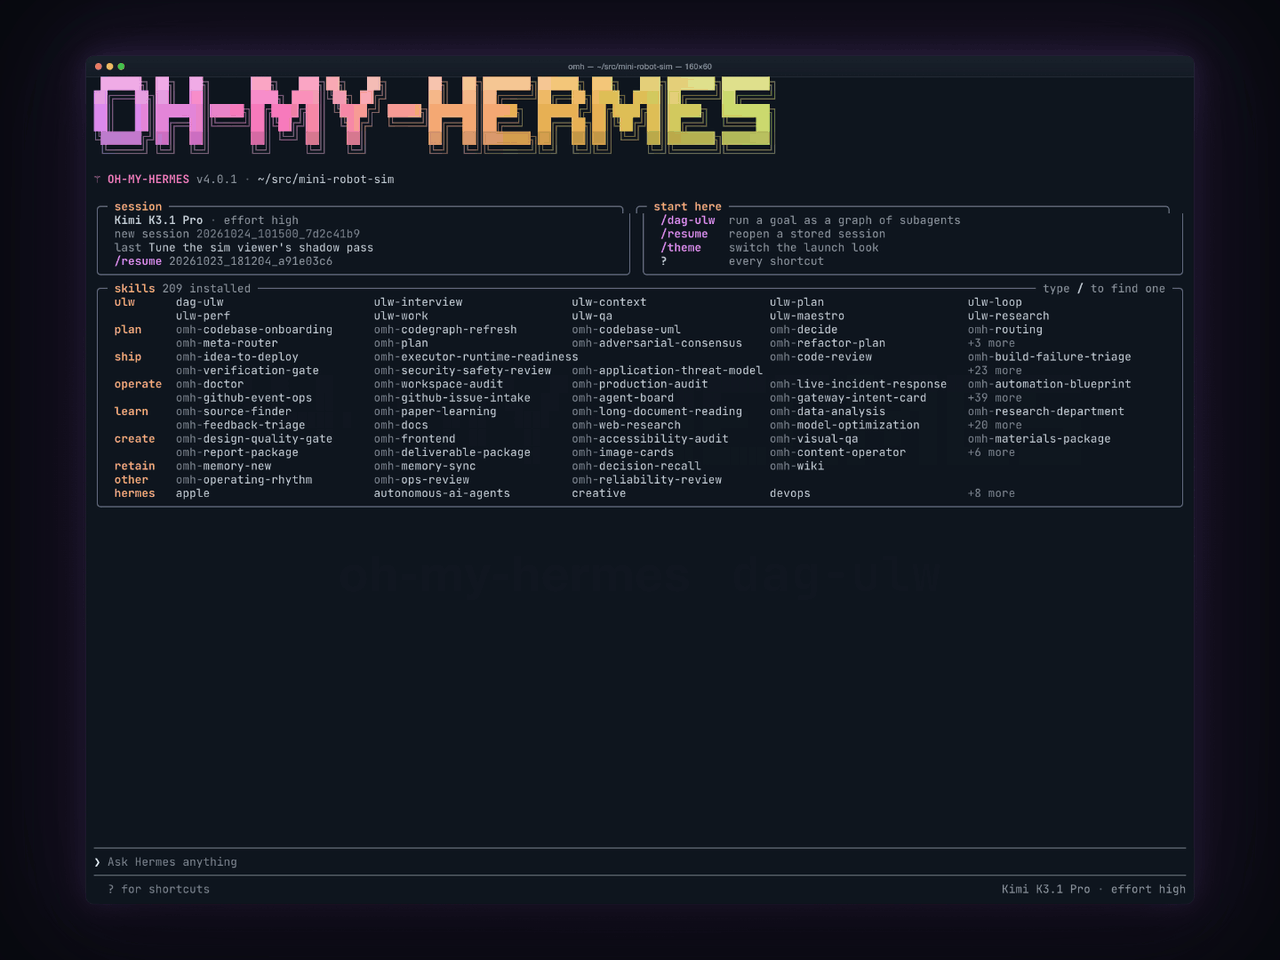
Oh-my-hermes, o OMH, es una capa de operación de código abierto para Hermes Agent que convierte objetivos amplios en flujos de trabajo verificables. En vez de tratar una petición como una sola conversación con un único modelo, la descompone en tareas pequeñas, decide qué modelo y qué nivel de razonamiento convienen en cada tramo, ejecuta trabajo en paralelo cuando no hay conflicto de escritura y separa con claridad lo planeado, lo ejecutado y lo verificado.
Lo más leído en Curiosidades
-
ChatGPT
Retratos de mascotas con ChatGPT Images para el Día de Muertos
Las mascotas también forman parte de las historias que se recuerdan durante el Día de Muertos: con ChatGPT…
-
Curiosidades
Cómo crear con IA un script de respaldo automático para Windows
Un asistente de inteligencia artificial puede ayudar a escribir y adaptar un script de PowerShell para copiar archivos…
Lo más leído
-
 Desarrolladores
Gemini 4 Carbon el modelo de IA más potente de Google enfocado en ciberseguridad
-
Curiosidades
Cómo crear con IA un script de respaldo automático para Windows
-
 Comunicados de Prensa
Qué significa la IA para inversionistas asesoría y regulación según Vanguard
-
 Cine
Cómo los proyectos culturales usan el correo electrónico para construir una audiencia propia
-
 Comunicados de Prensa
Attack on Titan 3 abre preventas para Nintendo Switch 2 con tráiler exclusivo
-

 Apps11 años ago
AMPcast, la herramienta de Pandora que permite a los artistas grabar mensajes de audio directamente a sus seguidores
-
 Blogs5 años ago
Conoce los mejores sitios de Torrents para descargar todo tipo de contenidos
-
Android5 años ago
Aprende cómo usar Discord para ver películas con tus amigos
-
Arte y Cultura14 años ago
Colección de fondos de pantalla basados en Super Héroes
-

 Almacenamiento2 años ago
Cómo usar TeraBox: La guía definitiva para aprovechar 1 TB de almacenamiento en la nube
-
Diseño13 años ago
css3ps: plugin que convierte archivos PSD a CSS3
-
Apps9 años ago
Picturethat, app que usa la Realidad Aumentada para visualizar cómo quedarían los cuadros antes de colgarlos
-
Eventos Especiales13 años ago
Especial Día de la Madres: fondos de pantalla especiales para Mamá