
Curiosidades
Oh-my-hermes guía completa para orquestar el agente Hermes con modelos en paralelo

Oh-my-hermes, o OMH, es una capa de operación de código abierto para Hermes Agent que convierte objetivos amplios en flujos de trabajo verificables. En vez de tratar una petición como una sola conversación con un único modelo, la descompone en tareas pequeñas, decide qué modelo y qué nivel de razonamiento convienen en cada tramo, ejecuta trabajo en paralelo cuando no hay conflicto de escritura y separa con claridad lo planeado, lo ejecutado y lo verificado.
La promesa del proyecto es seductora por su sencillez: instalar una vez y después trabajar con flujos como dag-ulw, ulw-plan, ulw-work o ulw-loop. A partir de ahí, la meta deja de depender de un solo agente que intenta hacerlo todo y pasa a un sistema más disciplinado, donde la investigación, la planeación, la ejecución y la verificación se ordenan en capas. El proyecto vive en su repositorio oficial de GitHub, funciona sobre Hermes y no lo reemplaza: el usuario sigue hablando con Hermes, pero OMH decide qué entra en el circuito, con qué especialidad y bajo qué criterio de evidencia.
Para quien llega por primera vez, conviene entenderlo en una frase simple: OMH no es un chatbot nuevo, sino un sistema para organizar mejor el trabajo que Hermes ya puede hacer. Su valor aparece cuando la tarea es grande, ambigua, costosa o sensible al error: refactors, investigación técnica, revisión de seguridad, optimización, QA, handoffs a otros entornos y, en general, cualquier encargo que no deba darse por terminado solo porque alguien dijo “ya quedó”.
¿Qué es OMH y qué problema resuelve?
OMH parte de una observación bastante conocida en el ecosistema de agentes: usar un solo modelo para todo suele ser una mala negociación. El modelo más potente puede resultar excelente para arquitectura, análisis profundo o decisiones difíciles, pero innecesariamente caro para tareas menores. Uno veloz puede servir para clasificar, resumir o revisar, pero no necesariamente para razonar con el mismo nivel. La respuesta de OMH a esa tensión es el enrutamiento por categoría de trabajo: cada línea o carril recibe una categoría y esa categoría determina la cadena de modelos y el esfuerzo de razonamiento que le convienen.
La idea puede sonar técnica, pero su efecto práctico es fácil de entender. En vez de pedirle a un solo agente que piense, investigue, escriba, revise y verifique en un mismo bloque, OMH reparte esas responsabilidades. Una pieza del objetivo puede requerir razonamiento profundo; otra, velocidad; otra, criterio visual; otra, una revisión distinta de la que produjo el cambio. Así, la tarea deja de verse como una sola respuesta larga y empieza a comportarse como una operación orquestada.
Dos reglas sostienen todo el sistema. La primera es que la elección del modelo y la propiedad del cambio de código son decisiones separadas. Dicho de otro modo, quién razona no es automáticamente quien escribe. La segunda es todavía más valiosa: nada preparado se reporta como ejecutado. Si un hijo no hizo trabajo o si un ejecutor solo declaró haber terminado, OMH no lo presenta como una fila verde equivalente a una prueba realmente superada.
Esa diferencia importa porque corrige uno de los vicios más frecuentes en la IA aplicada al trabajo: el optimismo operativo. Muchos agentes son hábiles para hablar como si algo estuviera listo. OMH intenta lo contrario: construir una frontera visible entre intención, ejecución observada y evidencia de cierre.
¿Cómo se usa para un usuario nuevo?
La forma más sencilla de explicarlo a un principiante es esta: OMH añade modos de trabajo sobre Hermes. El usuario no tiene que diseñar una arquitectura ni aprender una sintaxis críptica para empezar. Lo normal es abrir Hermes, expresar la meta en lenguaje natural y activar el flujo adecuado.
Si la petición todavía está mal definida, OMH puede entrevistar al usuario. Si ya hay claridad, puede investigar el repositorio o la web para construir un plan. Si el plan fue aceptado, puede ejecutar líneas paralelas sin choque de escritura. Si lo importante es insistir hasta que un criterio real pase, puede entrar en bucle. Y si el encargo es grande, puede convertirlo en una ejecución en grafo.
En la práctica, eso significa que OMH no obliga a pensar en “un prompt perfecto” desde el inicio. Permite llegar por fases. Primero se aclara. Luego se planea. Después se ejecuta. Al final se verifica. Para alguien que nunca ha trabajado con agentes más allá de una conversación simple, esa secuencia ya representa una mejora importante porque reduce improvisación, ambigüedad y falsas conclusiones.
¿Qué puede generar realmente?
Una duda razonable para cualquier lector es si OMH “solo genera código”. La respuesta corta es no. El proyecto puede generar muchas más cosas que una respuesta textual o un parche de archivos.
Puede generar entrevistas de aclaración cuando el encargo está borroso. Puede generar investigación con fuentes cuando hace falta excavar en código real o en la web. Puede generar planes revisados con opciones, riesgos y criterios de terminado. Puede generar líneas de ejecución paralela cuando un trabajo ya está aprobado y conviene dividirlo. Puede generar bucles de cierre que siguen corrigiendo hasta que un gate concreto pase. Puede generar pruebas hostiles para intentar romper lo construido. Puede generar diagnósticos de rendimiento para detectar una ruta caliente real en vez de optimizar a ciegas.
También puede generar artefactos menos vistosos pero muy útiles: rutas de modelo por categoría, árboles de tareas, vistas de estado, resúmenes de costo, pruebas potencialmente afectadas por un cambio, panoramas de arquitectura y handoffs mejor estructurados hacia otras superficies de ejecución.
Lo importante es la combinación. OMH no solo produce salida; produce proceso. Y ese proceso puede dejar detrás una entrevista, un plan, una ejecución dividida, una revisión separada y una evidencia de cierre mucho más clara de lo que dejaría un solo turno de chat.
¿Qué incluye además de los flujos?
OMH integra varias capas. Una de las más visibles es su colección de especialistas omh-*, que cubren áreas como frontend, backend, Rust, revisión de seguridad y verificación. El usuario normal no suele invocarlos a mano. El enrutador decide cuándo cargarlos como herramientas dentro del flujo.
Otra pieza importante es la memoria a largo plazo. OMH insiste en que no recuerda cosas de forma silenciosa: cada candidato a memoria se conserva, se rechaza o se difiere con una razón escrita. Además, su documentación deja claro que la memoria propia de Hermes no se lee ni se parchea. OMH opera con una capa separada y más explícita.
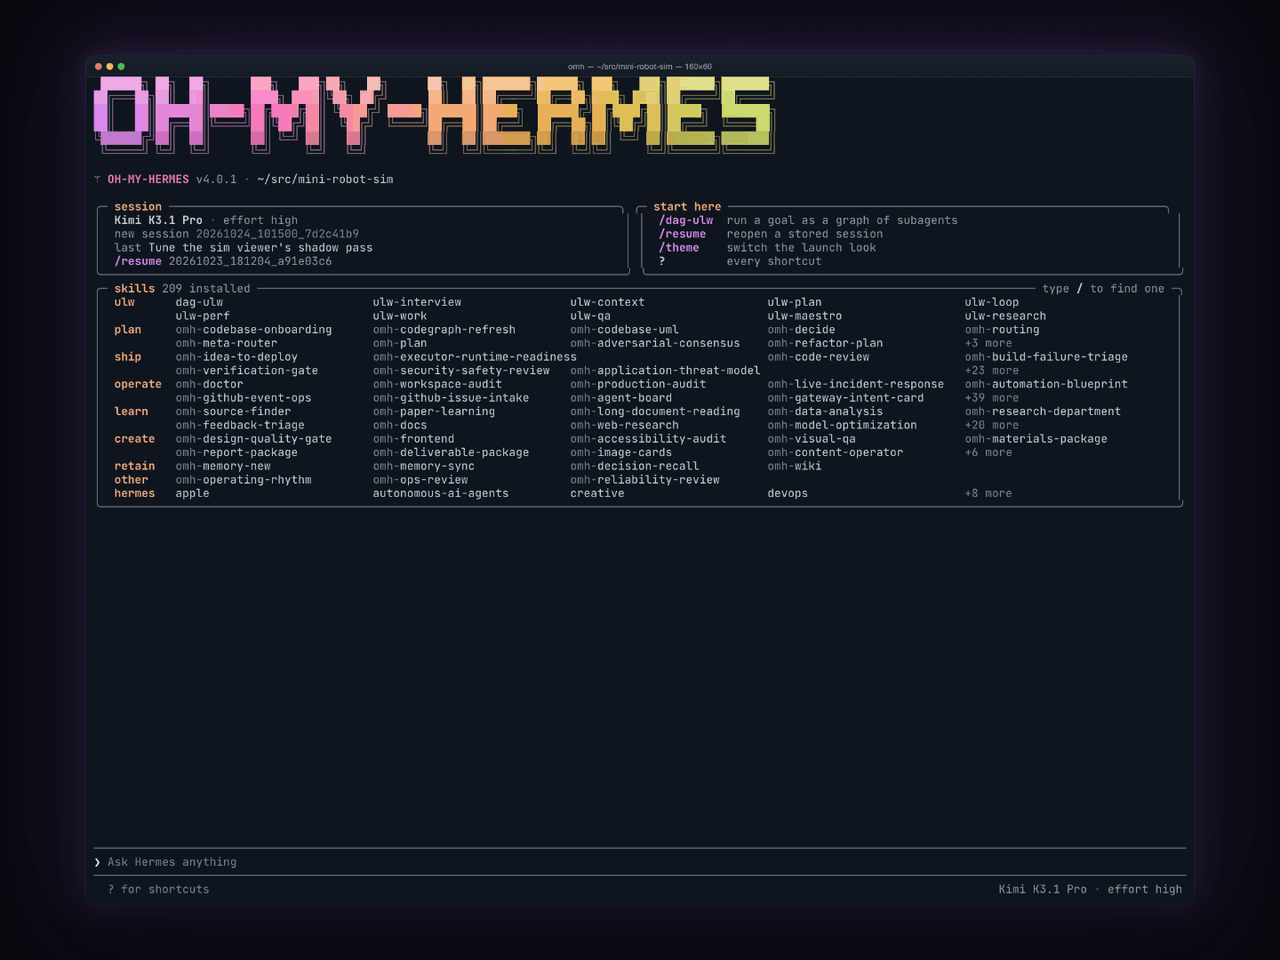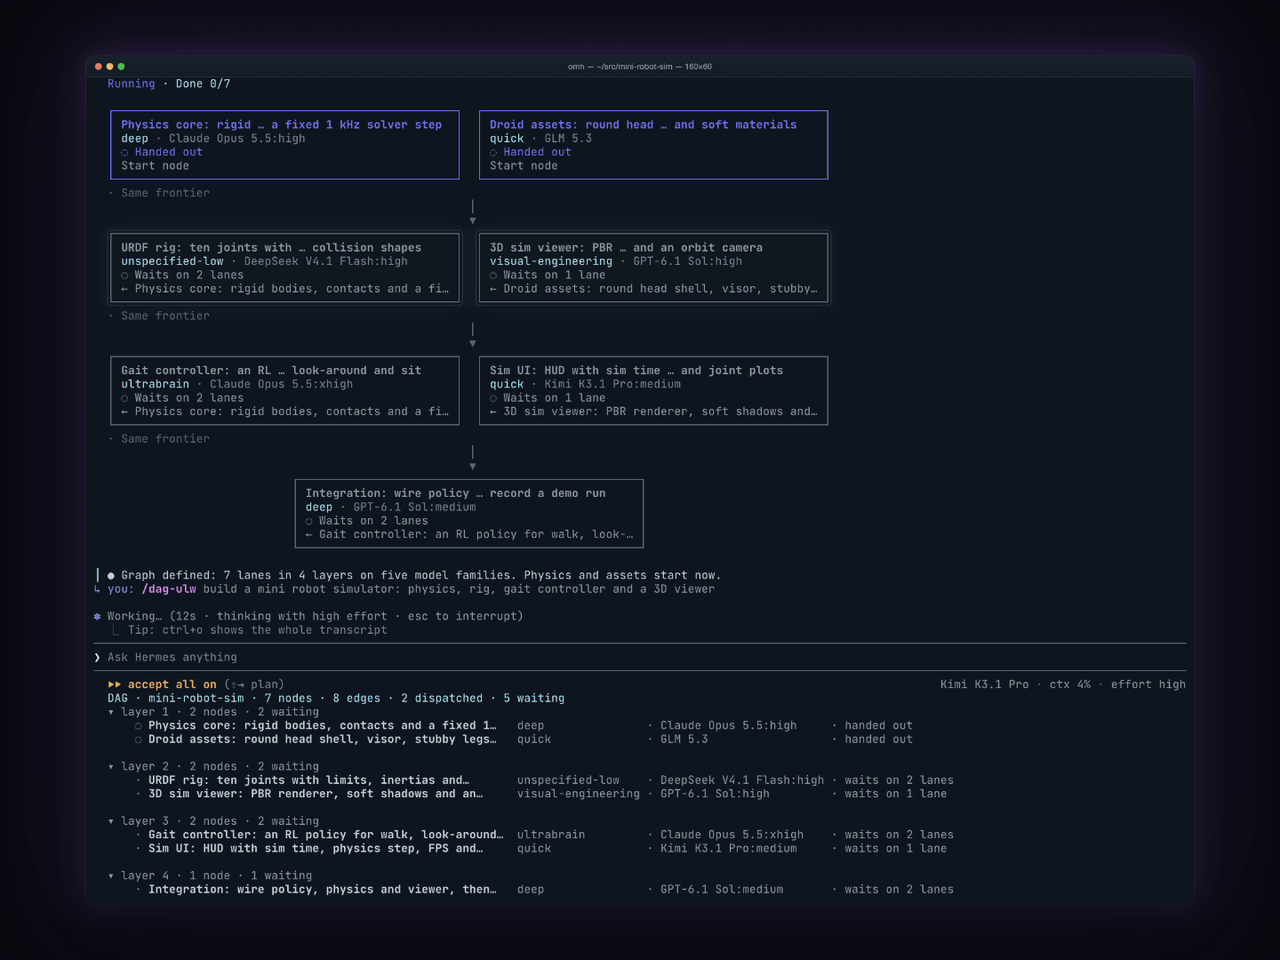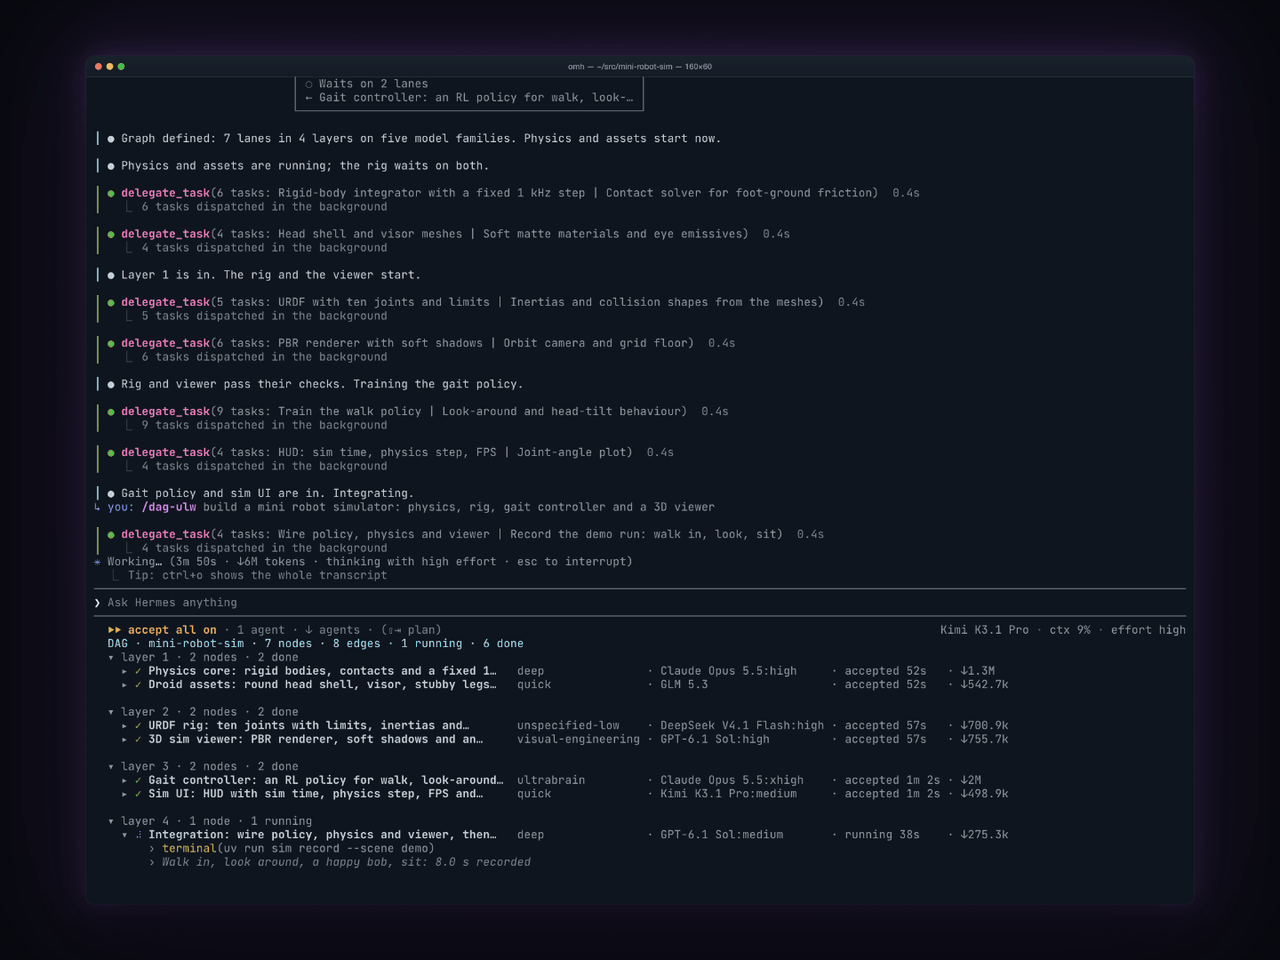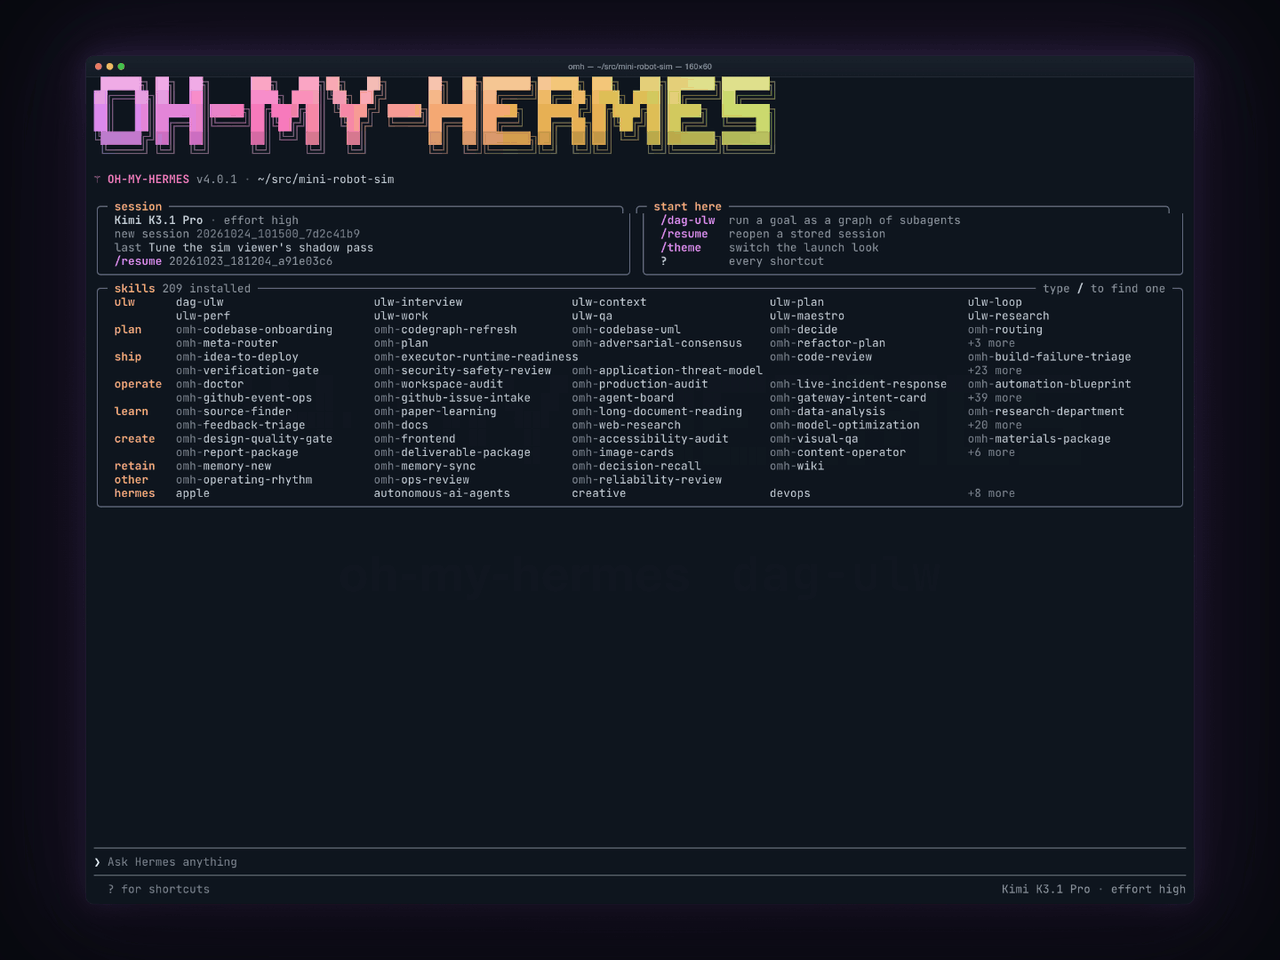
También ofrece una TUI nativa. El comando omh abre una interfaz propia sobre el gateway de Hermes. Allí aparecen filas en vivo con categoría, turnos, costo, caché, plan activo y, cuando la tarea lo exige, una representación del árbol de agentes o del grafo de ejecución. Para un principiante, esta parte es especialmente útil porque vuelve visible lo que de otro modo quedaría oculto: qué está corriendo, qué espera, qué terminó y qué sigue sin verificación.
A eso se suma una telemetría de costos que muestra tokens y, cuando es posible, cifras monetarias. La gracia no está en una suma decorativa, sino en la honestidad del diseño: si un costo no puede calcularse, OMH lo marca como unknown y no como si hubiese costado cero.
En el terreno más técnico, incorpora búsqueda estructural de código con ast-grep, generación de panoramas de arquitectura con omh codegraph uml y rastreo de pruebas alcanzadas por un cambio con omh codegraph tests --changed. Para quien recién empieza, basta con entender que OMH no solo escribe o coordina, sino que también puede ayudar a leer mejor un repositorio.
¿Cómo funciona dag-ulw?
El flujo más llamativo del proyecto es dag-ulw. Su nombre alude a un grafo dirigido acíclico, pero para explicarlo a un lector general basta una imagen sencilla: en vez de avanzar con una sola lista lineal de pasos, OMH dibuja un mapa de nodos pequeños donde algunas tareas dependen de otras y otras pueden correr al mismo tiempo.
Eso significa que una meta grande deja de avanzar como un bloque opaco. Si una tarea B depende de que la A termine, OMH respeta ese orden. Si C y D no comparten ámbito de escritura ni se estorban, ambas pueden correr en paralelo. El beneficio no es solamente velocidad. También mejora la supervisión y reduce la ilusión de progreso.
La documentación del proyecto subraya tres salvaguardas concretas. La primera es que los nodos concurrentes no comparten ámbito de escritura, de modo que no se suelta a dos líneas paralelas a editar los mismos archivos. La segunda es que la verificación va por separado: una cosa es ejecutar y otra declarar que el objetivo quedó probado. La tercera es que los nodos fallidos pueden repararse antes del reporte final, en lugar de convertirse de inmediato en una conclusión apresurada.
Para el usuario, el efecto es muy claro. Ya no se trata de esperar a que “el agente conteste algo largo”, sino de ver cómo un objetivo complejo se descompone en capas, carriles y dependencias observables.
¿Cómo instalar OMH paso a paso?
Antes de instalarlo conviene dejar clara una base: OMH no sustituye a Hermes. Está pensado para funcionar sobre Hermes Agent, así que el primer requisito real es tener Hermes instalado y operativo en la máquina o entorno donde se vaya a trabajar.
Una vez cubierta esa base, la ruta más simple en macOS y Linux es el instalador oficial:
curl -fsSL https://raw.githubusercontent.com/rlaope/oh-my-hermes/main/install.sh | sh
omh setup
El primer comando instala la herramienta. El segundo, omh setup, realiza la configuración guiada y registra la integración con Hermes. Para un usuario nuevo, el matiz importante es este: instalar no equivale todavía a dejar todo listo. La configuración posterior forma parte de la ruta normal.
En Windows nativo, el proyecto ofrece un instalador oficial para PowerShell 5.1 o superior:
irm https://raw.githubusercontent.com/rlaope/oh-my-hermes/main/install.ps1 | iexEn términos prácticos, esta es la vía más recomendable para un usuario que trabaja de forma nativa en Windows. Aunque existen otros caminos posibles, el propio proyecto trata esa ruta como la respuesta más directa para ese entorno.
Si el trabajo ocurre dentro de WSL2, entonces la referencia correcta deja de ser Windows y pasa a ser Linux. En ese caso, lo más limpio es ejecutar todo dentro de la distro, no desde PowerShell:
sudo apt update && sudo apt install -y curl git build-essential
curl -fsSL https://raw.githubusercontent.com/nvm-sh/nvm/master/install.sh | sh
source ~/.bashrc
nvm install --lts
curl -fsSL https://raw.githubusercontent.com/rlaope/oh-my-hermes/main/install.sh | sh
omh setup
En WSL2 conviene trabajar sobre el sistema de archivos Linux, por ejemplo en ~/proyectos, y no sobre /mnt/c, para evitar penalizaciones de rendimiento en acceso a archivos y git. Después de configurar, lo mejor es cerrar con un diagnóstico:
omh doctorOMH también puede instalarse con gestores de paquetes. En macOS existe la opción de Homebrew:
brew install rlaope/tap/omhY en entornos compatibles también puede usarse Bun o npm:
bun install -g oh-my-hermesnpm install -g oh-my-hermesSin embargo, estas rutas no eliminan la necesidad del siguiente paso:
omh setupAdemás, Bun y npm requieren Node 18 o superior y Python 3.11 o superior disponibles en el PATH. En Windows nativo, la documentación favorece el instalador oficial de PowerShell antes que estas variantes.
Existe una ruta adicional desde el sistema de habilidades de Hermes:
hermes skills tap add rlaope/oh-my-hermes
hermes skills install rlaope/oh-my-hermes/skills/omh-routing --yes
Pero conviene tratarla como una alternativa, no como algo que deba apilarse sin cuidado encima de omh setup. Para la mayoría de usuarios nuevos, la experiencia más limpia sigue siendo instalador oficial más configuración guiada.
¿Qué hace omh setup y qué cambia después?
Este punto merece una explicación separada porque suele generar confusión. omh setup no es un adorno posterior a la instalación, sino el paso que conecta OMH con Hermes. Ahí se instalan o registran las habilidades gestionadas, se ajustan rutas y se prepara la base para que Hermes pueda descubrir y usar la capa de OMH.
La documentación del proyecto insiste en otra idea importante: para una persona usuaria, la superficie directa de OMH suele limitarse a omh setup, omh update y omh doctor. El resto del CLI existe, pero muchas de esas piezas están pensadas como infraestructura, automatización, wrappers o superficies avanzadas. En el uso diario, lo normal es hablar con Hermes y dejar que OMH opere detrás.
Después de la configuración, lo recomendable es reiniciar o recargar Hermes si el entorno lo necesita, para asegurar que la nueva capa quede visible y activa.
¿Cómo se configuran los modelos por categoría?
Una vez instalado OMH, la configuración más representativa es la de modelos por tipo de trabajo. El comando central es:
omh modelEse selector interactivo permite moverse entre categorías con las flechas, cambiar el modelo principal de la cadena con izquierda y derecha y ajustar el esfuerzo de razonamiento con los signos menos y más. Dentro de la TUI de OMH, el mismo selector se abre con /omh-model.
Para un principiante, el punto clave es este: OMH no obliga a elegir un único modelo para todo. Permite definir preferencias por clase de tarea. Un trabajo profundo puede ir por una cadena distinta a una tarea rápida o a una revisión visual.
Si se quiere incorporar una familia nueva de modelos, el propio proyecto recomienda la habilidad /omh-model-setup dentro de Hermes. Para quienes necesiten un control más fino, existen superficies adicionales como omh model-chains show o omh model-chains set, pero no son imprescindibles para arrancar.
Si algo falla, la comprobación más útil sigue siendo:
omh doctor¿Qué flujos existen y para qué sirve cada uno?
OMH organiza su propuesta alrededor de diez grandes flujos de trabajo. Más que memorizar la lista, conviene reconocer cuándo usar cada uno.
ulw-context sirve para alinear términos del proyecto. Resulta útil cuando un repositorio o una redacción maneja vocabulario propio y conviene fijarlo antes de avanzar.
ulw-interview entrevista al usuario hasta saber exactamente qué quiere. Es la puerta adecuada cuando la idea todavía está incompleta.
ulw-research excava en código real y en la web, conserva fuentes y verifica lo dudoso. Es el flujo para cuando todavía falta contexto antes de decidir.
ulw-plan construye un plan revisado con opciones comparadas, riesgos nombrados y criterios de terminado.
ulw-work ejecuta un plan aceptado en líneas paralelas que nunca tocan el mismo archivo.
dag-ulw lleva esa lógica a trabajos grandes: los convierte en un grafo de nodos pequeños, verifica la meta por separado y repara lo que falle.
ulw-maestro ejecuta una tarea delegada sobre Claude Code o Codex mediante un handoff estructurado y una sesión guiable.
ulw-loop cicla entre planeación, construcción y revisión hasta que una condición real pase.
ulw-qa somete el resultado a escenarios hostiles para encontrar qué se rompe y corregirlo.
ulw-perf mide dónde está el verdadero costo o cuello de botella y corrige una ruta caliente a la vez.
¿Cuál es la rutina de uso recomendada?
Para quien empieza, la lógica del proyecto se entiende mejor en tres momentos: dar forma, construir y cerrar. Si la idea todavía es difusa, lo correcto es entrevistar. Si el cambio ya se conoce pero tiene riesgo, conviene planear. Solo después hace sentido pasar a ejecución. Y cuando el objetivo exige una condición real de salida, entra el bucle.
La documentación propone ejemplos muy directos. Cuando el objetivo todavía está verde:
ulw-interview: I want a CLI that tracks the ISS and warns me before it passes overheadCuando el objetivo ya se entiende pero requiere planeación:
ulw-plan: analyze this project's circular dependencies and plan the refactorCuando el plan fue aceptado y toca construir:
ulw-work: run the accepted planY cuando el cierre depende de una condición verificable:
ulw-loop: keep going until npm test passesLa lección más útil para un principiante es no empezar siempre por el flujo más pesado. Muchas veces lo más inteligente no es correr, sino aclarar o planear primero. OMH gana valor precisamente cuando respeta esas fases en vez de saltarlas.
¿Cómo se vería un caso real en desarrollo?
La forma más clara de entender el potencial del proyecto es seguir un caso concreto. Imaginemos un escenario común: un equipo quiere añadir inicio de sesión con Google a una aplicación web ya existente, pero sin romper el login actual, sin mezclar cambios delicados y sin confundir una implementación reportada con una implementación realmente verificada.
Sin OMH, el encargo podría lanzarse como una sola petición: “analiza el proyecto, decide la mejor estrategia, implementa el login con Google, actualiza el frontend, añade pruebas y dime si ya quedó”. El problema es que esa cadena mezcla tareas de naturaleza distinta y deja poco espacio para auditar qué sí pasó y qué no. Con OMH, el trabajo puede volverse mucho más legible.
Aclarar primero
Si el equipo todavía no ha definido todos los bordes, la entrada natural sería:
ulw-interview: quiero añadir inicio de sesión con Google a esta app sin romper el login actualAquí OMH puede hacer preguntas concretas: qué stack usa el proyecto, si ya existe autenticación por correo y contraseña, si ambos sistemas deben convivir, qué proveedor OAuth se usará, si hay ambiente de staging y qué condición exacta definirá que el trabajo está terminado. Para un lector nuevo, esta fase ya ilustra un punto importante: OMH puede generar claridad antes de generar código.
Investigar y construir un plan
Después vendría la planeación propiamente dicha:
ulw-plan: analiza este proyecto y propone la forma más segura de agregar login con GoogleEn esta etapa, OMH puede inspeccionar el repositorio, localizar el sistema actual de autenticación, detectar archivos sensibles, revisar dependencias existentes y comparar rutas posibles. Si hace falta, puede combinar ese análisis con investigación sobre documentación del proveedor o buenas prácticas de OAuth. El resultado no tendría por qué ser todavía una implementación, sino un plan con piezas como estas: biblioteca o estrategia recomendada, rutas de callback, adaptación del modelo de usuario, cambios de interfaz, pruebas necesarias y riesgos de seguridad.
Ahí aparece otra virtud del proyecto: no solo genera una solución; puede generar una ruta razonada hacia la solución.
Ejecutar sin que dos líneas choquen
Si el plan ya fue aceptado, la siguiente fase sería:
ulw-work: ejecuta el plan aceptadoEn vez de mandar a un solo agente a tocar todo a la vez, OMH puede dividir el trabajo por carriles. Una línea puede encargarse de la integración backend con Google. Otra, del frontend del formulario o del botón de acceso. Otra, de preparar o ajustar pruebas. Mientras esos carriles no escriban sobre los mismos archivos, OMH puede correrlos en paralelo.
Ese detalle traduce muy bien la promesa de orquestación: OMH puede generar varios frentes de trabajo coordinados dentro de una misma meta, cada uno con el modelo y el nivel de esfuerzo que le convengan.
Escalar a un grafo si el cambio es grande
Si la tarea creciera y ya no fuera solo “añadir un botón y una ruta”, sino migrar toda la capa de autenticación, mantener compatibilidad, revisar sesiones y validar pruebas críticas, entonces el flujo natural sería:
dag-ulw: migra este proyecto a un sistema de autenticación con Google y sesiones reforzadas, mantén compatibilidad con el login actual y verifica que los tests críticos sigan pasandoOMH podría convertir esa meta en nodos pequeños: análisis del auth actual, adaptación del modelo de usuario, actualización del backend, cambios visuales, pruebas y revisión. Algunos nodos tendrían que esperar; otros podrían correr al mismo tiempo. El valor está en que el trabajo grande deja de ser una caja negra.
Cerrar con evidencia, no con entusiasmo
Al final, el cierre razonable sería algo como esto:
ulw-loop: sigue hasta que el login con Google funcione y la suite de autenticación paseLa diferencia aquí es decisiva. OMH no debería decir “ya quedó” solo porque un ejecutor afirmó haber terminado. Si un test falla, corrige. Si una revisión detecta un hueco, repara. Si el gate no pasa, la tarea sigue abierta. El resultado final no es solo código; es código más una condición verificada.
En un caso así, OMH podría dejar detrás una entrevista de aclaración, un plan con riesgos, cambios separados por línea de trabajo, una ejecución visible en árbol o grafo, correcciones posteriores y un estado final con evidencia de cierre. En otras palabras, no solo puede generar implementación, sino también método.
¿Cómo se vería una investigación para periodistas?
El potencial de OMH no se limita al desarrollo. También puede resultar útil en una investigación periodística donde hay que cruzar documentos, separar hipótesis de hechos y mantener visible qué parte está confirmada y cuál sigue siendo apenas un indicio.
Un ejemplo realista sería una pesquisa sobre contratos públicos adjudicados a empresas que parecen distintas en el papel, pero comparten vínculos societarios, representantes, domicilios o patrones de contratación. En una situación así, el problema no es “escribir una nota” desde el primer minuto, sino organizar una investigación amplia sin perder el rastro de la evidencia.
Definir la hipótesis
La fase inicial podría arrancar con algo así:
ulw-interview: quiero investigar si varias empresas proveedoras del municipio están relacionadas entre sí y concentran contratos públicosOMH podría ayudar a precisar el alcance: qué periodo se observará, qué dependencia interesa, qué tipo de contratos entran en la muestra, qué se considerará una relación relevante entre compañías y qué nivel de evidencia hará falta para sostener la hipótesis. Esto ya es útil periodísticamente porque obliga a abandonar una sospecha demasiado vaga y convertirla en una pregunta investigable.
Levantar fuentes y corpus documental
Con la hipótesis delimitada, la siguiente fase sería:
ulw-research: reúne fuentes sobre contratos públicos, razones sociales, representantes legales, domicilios y antecedentes de adjudicación de estas empresasAquí OMH puede ordenar la búsqueda entre portales de transparencia, gacetas oficiales, padrones de proveedores, registros mercantiles, bases de contrataciones, notas previas y cualquier otro documento público pertinente. El punto fuerte no es solo recuperar nombres o fechas, sino conservar el origen de cada hallazgo para que la redacción sepa de dónde vino cada pieza.
En este tramo, el sistema puede generar un inventario de empresas, personas, teléfonos, domicilios compartidos, fechas de constitución, montos adjudicados y documentos que valga la pena revisar a mano con más cuidado.
Convertir la búsqueda en un plan editorial
Una vez reunido un primer corpus, la investigación puede ordenarse con:
ulw-plan: organiza la investigación sobre estas empresas, separa hallazgos confirmados de indicios y define qué falta verificarEl plan podría dividirse en frentes como estos: relaciones societarias, cronología de contratos, domicilios o representantes repetidos, concentración de montos, cambios de razón social, litigios, sanciones previas y contexto político o administrativo. Lo importante es que OMH puede convertir una masa documental en una hoja de trabajo más clara.
Ahí también aparece su disciplina de evidencia. Compartir un domicilio puede ser un indicio. Compartir domicilio, socios, representante legal y patrones de adjudicación cercanos ya sugiere una red más fuerte. Pero una sospecha atractiva no equivale todavía a una conclusión publicable. OMH puede ayudar a mantener separados esos niveles.
Dividir la pesquisa en líneas paralelas
Si el caso crece, el flujo puede escalar a una ejecución más ambiciosa:
dag-ulw: investiga la red de relaciones entre estas empresas, sus contratos públicos y los posibles patrones de concentración, con verificación separada por cada línea de evidenciaEn este escenario, una línea puede concentrarse en identidad corporativa; otra, en cronología de adjudicaciones; otra, en domicilios y teléfonos; otra, en montos y patrones; otra, en antecedentes mediáticos o judiciales. No se trata de “automatizar una exclusiva”, sino de organizar una pesquisa compleja en capas más trazables.
Preparar salidas sin confundirlas con verdad cerrada
Más adelante, OMH también podría ayudar a producir material de trabajo para la redacción: cronologías, memorandos editoriales, mapas de conexiones, listas de preguntas para entrevistas y resúmenes de vacíos documentales. Todo eso puede ahorrar tiempo y ordenar la discusión interna.
Pero su mayor aportación no sería escribir una nota cerrada, sino evitar que una hipótesis prometedora se publique como si ya estuviera demostrada. En una investigación periodística, esa diferencia vale tanto como una buena exclusiva. OMH no sustituye la reportería ni la verificación humana; la disciplina.
¿Qué método conceptual hay detrás?
Más allá de los comandos, el proyecto documenta un método de ocho etapas: Entender, Investigar, Decidir, Planear, Ejecutar, Verificar, Operar y Aprender. La gracia de ese recorrido es que no mezcla lo que aún no debería mezclarse.
Primero se confirma intención, restricciones, términos y condición de parada. Luego se reemplazan suposiciones por contexto respaldado. Después se vuelven explícitas las opciones y sus compensaciones. Más tarde eso se traduce en un plan ejecutable. Solo entonces se despacha trabajo acotado. La verificación se apoya en resultados observados, no en afirmaciones. La operación mantiene visibles salud, incidentes o rollback. Y, al final, las lecciones revisadas pueden pasar a memoria o a mejora de flujo.
Es una secuencia simple de leer, pero poderosa en la práctica. Muchas herramientas intentan comprimirlo todo en una única respuesta. OMH, en cambio, gana valor precisamente porque lo separa.
¿Por qué importa tanto la regla de evidencia antes de “listo”?
Este es, probablemente, el rasgo más valioso del proyecto. OMH distingue entre lo que fue preparado, lo que está corriendo, lo que un ejecutor reportó como terminado y lo que en verdad fue verificado. Sus estados lo hacen visible. Plan · not run significa que hay plan, pero no ejecución. Code · running indica actividad observada. Code · reported done registra que el ejecutor dijo haber terminado, aunque aún no haya una comprobación. Test · verified solo aparece cuando un test, una revisión o un gate de CI realmente pasaron.
Puede parecer un matiz semántico, pero no lo es. En agentes, ese matiz separa la publicidad de la trazabilidad. Y OMH apuesta claramente por la segunda.
¿Cómo se mantiene actualizado?
La ruta principal de mantenimiento es:
omh updateEse comando detecta cómo fue instalado OMH y actualiza el paquete por el canal correspondiente. Después refresca las habilidades gestionadas, el paquete de plugins y el registro en Hermes. Para la mayoría de usuarios, esta debería ser la forma normal de ponerse al día, en vez de mezclar instaladores o rutas manuales.
Tras una actualización, lo sensato es volver a comprobar el estado:
omh doctorSi omh update informa que el gestor propietario no está disponible, entonces sí tiene sentido recurrir al comando directo del gestor correspondiente. Para una desinstalación completa, el orden recomendado es ejecutar primero omh uninstall --all y después retirar el paquete con el gestor de instalación que toque.
La documentación extensa del proyecto vive en su sitio oficial. Y para quien primero necesite dominar la base sobre la que opera esta capa, sigue siendo útil revisar la guía para crear agentes en la plataforma Hermes. Como contexto adicional del ecosistema, también aportan el análisis de OpenCode 2.0 y la guía sobre Skills, Gemas y Agents reutilizables.
Conclusión
OMH no destaca por prometer magia, sino por proponer orden. Su aporte real no consiste solamente en “usar varios modelos”, sino en volver más disciplinado el trabajo de un agente: preguntar antes de asumir, investigar antes de decidir, planear antes de tocar, dividir antes de chocar y verificar antes de declarar victoria.
Visto desde fuera, puede parecer una capa para usuarios muy técnicos. Y en parte lo es. Pero sus principios son comprensibles incluso para quien apenas empieza: no mezclar razonamiento con ejecución sin control, no llamar hecho a lo que sigue siendo borrador y no depender de un único carril para resolver tareas complejas. En ese sentido, OMH no es solo una colección de comandos. Es una propuesta sobre cómo debería trabajar un agente cuando el objetivo importa de verdad.
Lo más leído en Curiosidades
-
 Curiosidades
Tareas personales en el trabajo: la nueva jornada laboral que ya es realidad
Casi 6 de cada 10 profesionales europeos realizan tareas personales durante su jornada laboral varias veces a la…
-
Curiosidades
Oh-my-hermes guía completa para orquestar el agente Hermes con modelos en paralelo
Oh-my-hermes, o OMH, es una capa de operación de código abierto para Hermes Agent que convierte objetivos amplios…





Casi 6 de cada 10 profesionales europeos realizan tareas personales durante su jornada laboral varias veces a la semana, según una encuesta de LiveCareer a 1.000 trabajadores de Alemania, España, Francia e Italia. El 72% afirma que esos descansos breves lo hacen más productivo, no menos.
Lo más leído en Curiosidades
-
Curiosidades
Tareas personales en el trabajo: la nueva jornada laboral que ya es realidad
Casi 6 de cada 10 profesionales europeos realizan tareas personales durante su jornada laboral varias veces a la…
-
Curiosidades
Oh-my-hermes guía completa para orquestar el agente Hermes con modelos en paralelo
Oh-my-hermes, o OMH, es una capa de operación de código abierto para Hermes Agent que convierte objetivos amplios…

PS5LM es un proyecto de código abierto que ejecuta llama.cpp directamente en la GPU de una PlayStation 5 con jailbreak, convirtiendo la consola en un servidor privado de modelos de lenguaje para toda la red doméstica. Sin nube, sin cuentas y sin necesidad de una PC encendida: cualquier laptop, teléfono o herramienta de programación puede consultar al modelo cargado en la consola. Te contamos cómo funciona esta peculiar herramienta.
Lo más leído en Curiosidades
-
Curiosidades
Tareas personales en el trabajo: la nueva jornada laboral que ya es realidad
Casi 6 de cada 10 profesionales europeos realizan tareas personales durante su jornada laboral varias veces a la…
-
Curiosidades
Oh-my-hermes guía completa para orquestar el agente Hermes con modelos en paralelo
Oh-my-hermes, o OMH, es una capa de operación de código abierto para Hermes Agent que convierte objetivos amplios…
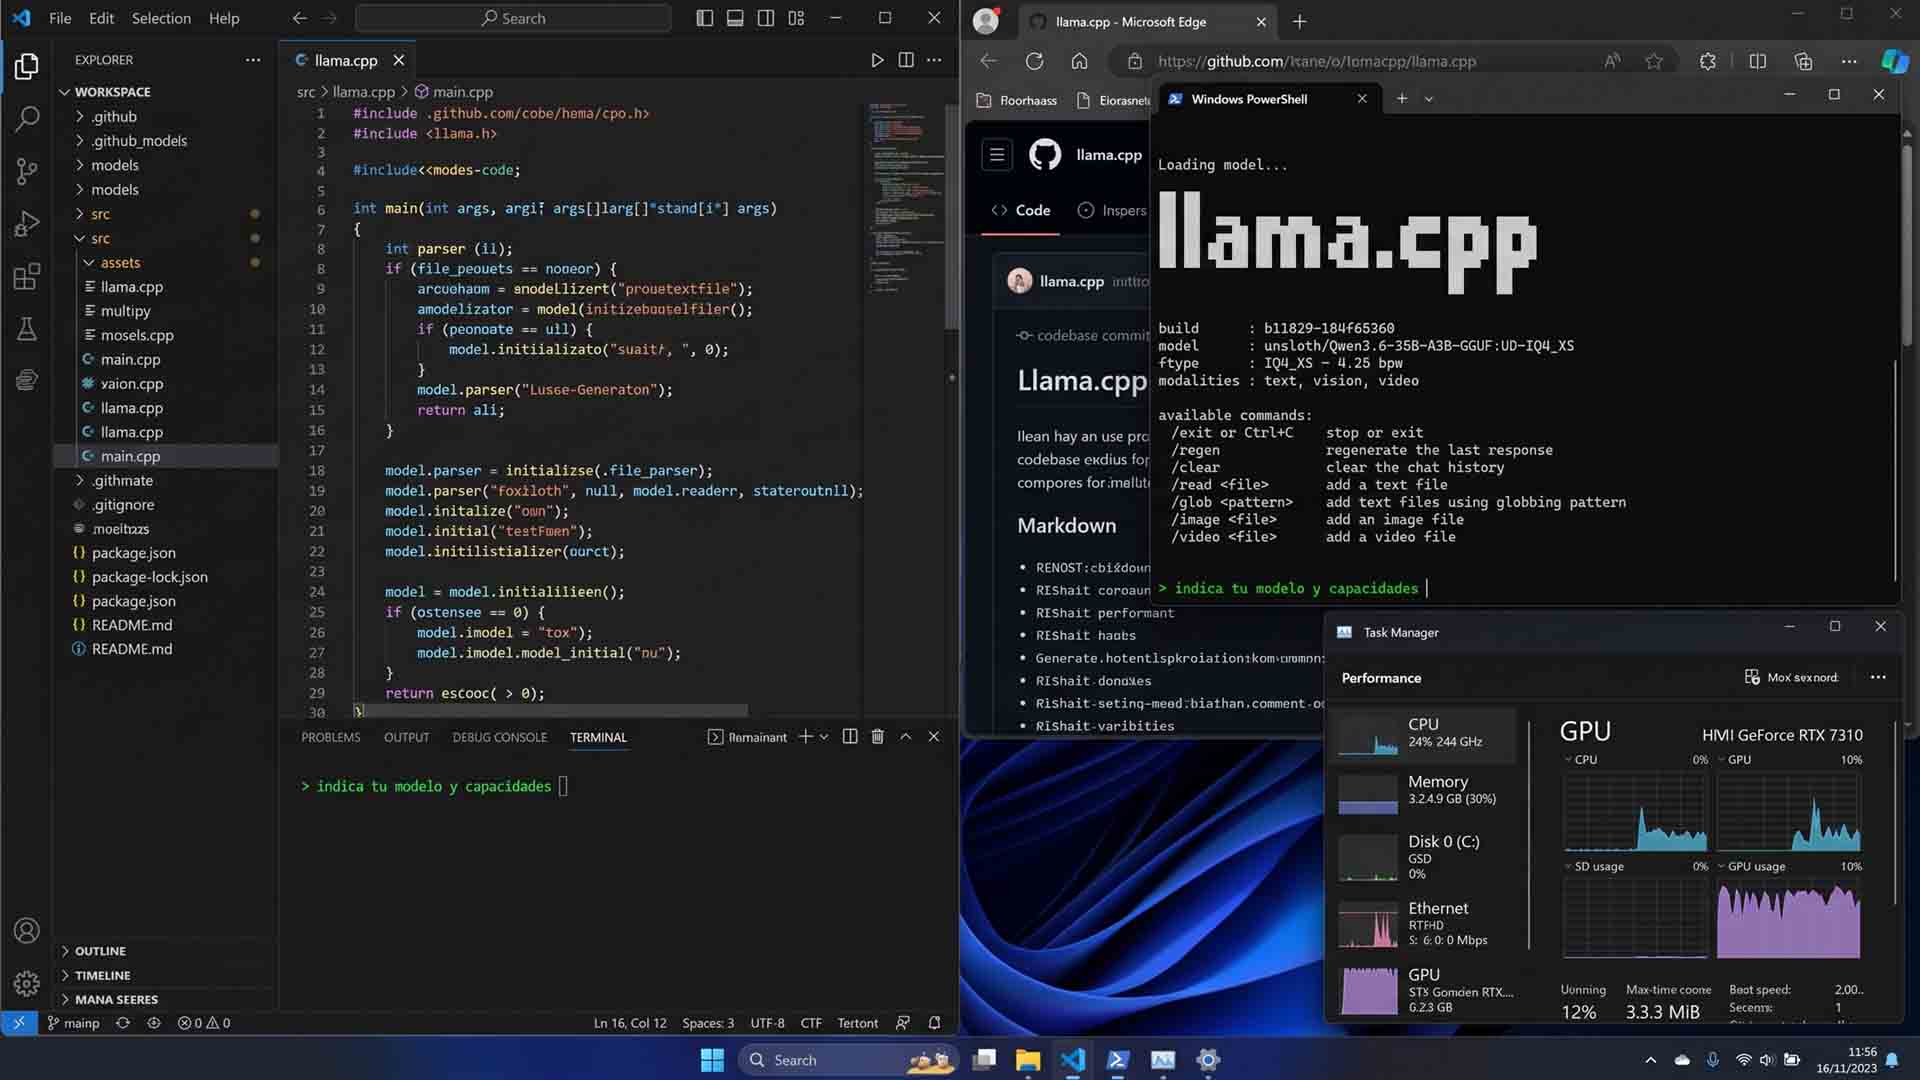
Una prueba documentada muestra cómo el flag –n-cpu-moe de llama.cpp descarga los expertos de un modelo Mixture-of-Experts a la RAM del sistema y multiplica por ocho la velocidad de generación en una GPU de laptop de 8GB. Aquí la guía completa paso a paso para Windows.
Lo más leído en Curiosidades
-
Curiosidades
Tareas personales en el trabajo: la nueva jornada laboral que ya es realidad
Casi 6 de cada 10 profesionales europeos realizan tareas personales durante su jornada laboral varias veces a la…
-
Curiosidades
Oh-my-hermes guía completa para orquestar el agente Hermes con modelos en paralelo
Oh-my-hermes, o OMH, es una capa de operación de código abierto para Hermes Agent que convierte objetivos amplios…
Lo más leído
-
 Especificaciones
La IA china se desploma en bolsa y Pekín no puede frenar la sangría
-
 Especificaciones
Overmind la plataforma de un ex agente del MI6 para entrenar modelos IA propios
-
 Entretenimiento
Revisión: Warehouse Catastrophe – Orden cozy tras el caos felino
-
Curiosidades
Oh-my-hermes guía completa para orquestar el agente Hermes con modelos en paralelo
-
 Comunicados de Prensa
RTX Remix 1.6 transforma Minecraft con Path Tracing y DLSS
-

 Apps11 años ago
AMPcast, la herramienta de Pandora que permite a los artistas grabar mensajes de audio directamente a sus seguidores
-
 Blogs5 años ago
Conoce los mejores sitios de Torrents para descargar todo tipo de contenidos
-
Android5 años ago
Aprende cómo usar Discord para ver películas con tus amigos
-
Arte y Cultura14 años ago
Colección de fondos de pantalla basados en Super Héroes
-

 Almacenamiento2 años ago
Cómo usar TeraBox: La guía definitiva para aprovechar 1 TB de almacenamiento en la nube
-
Diseño13 años ago
css3ps: plugin que convierte archivos PSD a CSS3
-
Apps9 años ago
Picturethat, app que usa la Realidad Aumentada para visualizar cómo quedarían los cuadros antes de colgarlos
-
Eventos Especiales13 años ago
Especial Día de la Madres: fondos de pantalla especiales para Mamá