
Los modelos Mixture of Experts cambiaron una de las reglas más repetidas del hardware para IA local: que una GPU necesita alojar todos los parámetros del...


Correr LLMs locales en una GPU de 8GB no depende de encontrar un modelo milagroso, sino de elegir bien la cuantización, repartir las tareas entre modelos...


La compresión de modelos de inteligencia artificial permite ejecutar arquitecturas avanzadas como Qwen 2.5, Qwen 3 y Qwen 3.6 en tarjetas gráficas de consumo general. Reducir...

En hardware modesto, la discusión no debería comenzar con el modelo más grande disponible, sino con una pregunta más útil: cuánto margen real deja la GPU...

Muse Glimmer, el modelo de 30B parámetros lanzado por Meta Superintelligence Labs bajo licencia Apache 2.0, ya está disponible en Ollama. Este modelo multimodal está diseñado...


Google Chrome y Microsoft Edge ahora requieren 20GB de espacio libre en Windows 11 para descargar sus modelos de IA en el dispositivo. Este cambio afecta...


Muchos usuarios de IA local cometen el mismo error: usar un solo modelo para todo. En la práctica, ese enfoque rara vez da los mejores resultados....


Por primera vez en la historia, la GPU más popular en Steam es una tarjeta para laptop: la RTX 4060 Laptop (3.81% de los sistemas). Este...


Con una cantidad razonable de VRAM, ya es posible montar un entorno local serio para modelos de lenguaje, navegación web, extracción de contenido y memoria persistente....


Ejecutar modelos de lenguaje avanzados en hardware propio dejó de ser exclusivo de empresas con infraestructura de servidores. Con una tarjeta gráfica como la Nvidia GeForce...


Los modelos de lenguaje locales ya no requieren tarjetas gráficas de gama alta. En esta guía, te mostramos qué modelos puedes ejecutar según la VRAM de...
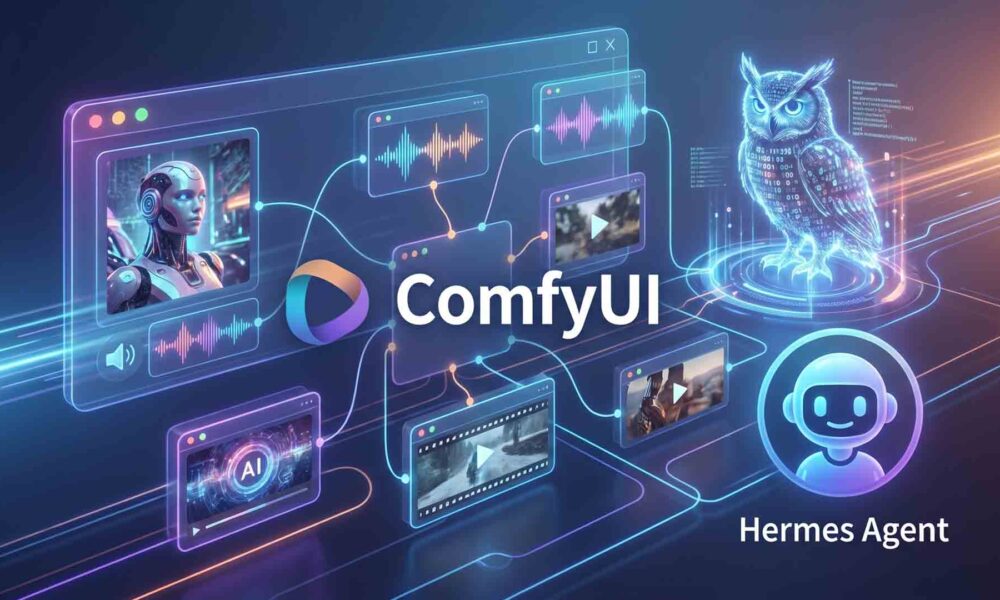


Aprende a instalar, configurar y ejecutar ComfyUI con Hermes Agent en local o en la nube, con ejemplos detallados para generación de imágenes, audio y video....


¿Quieres ejecutar inteligencia artificial avanzada en tu computadora personal sin gastar en hardware costoso? Esta guía te muestra cómo aprovechar modelos de lenguaje locales como Gemma...
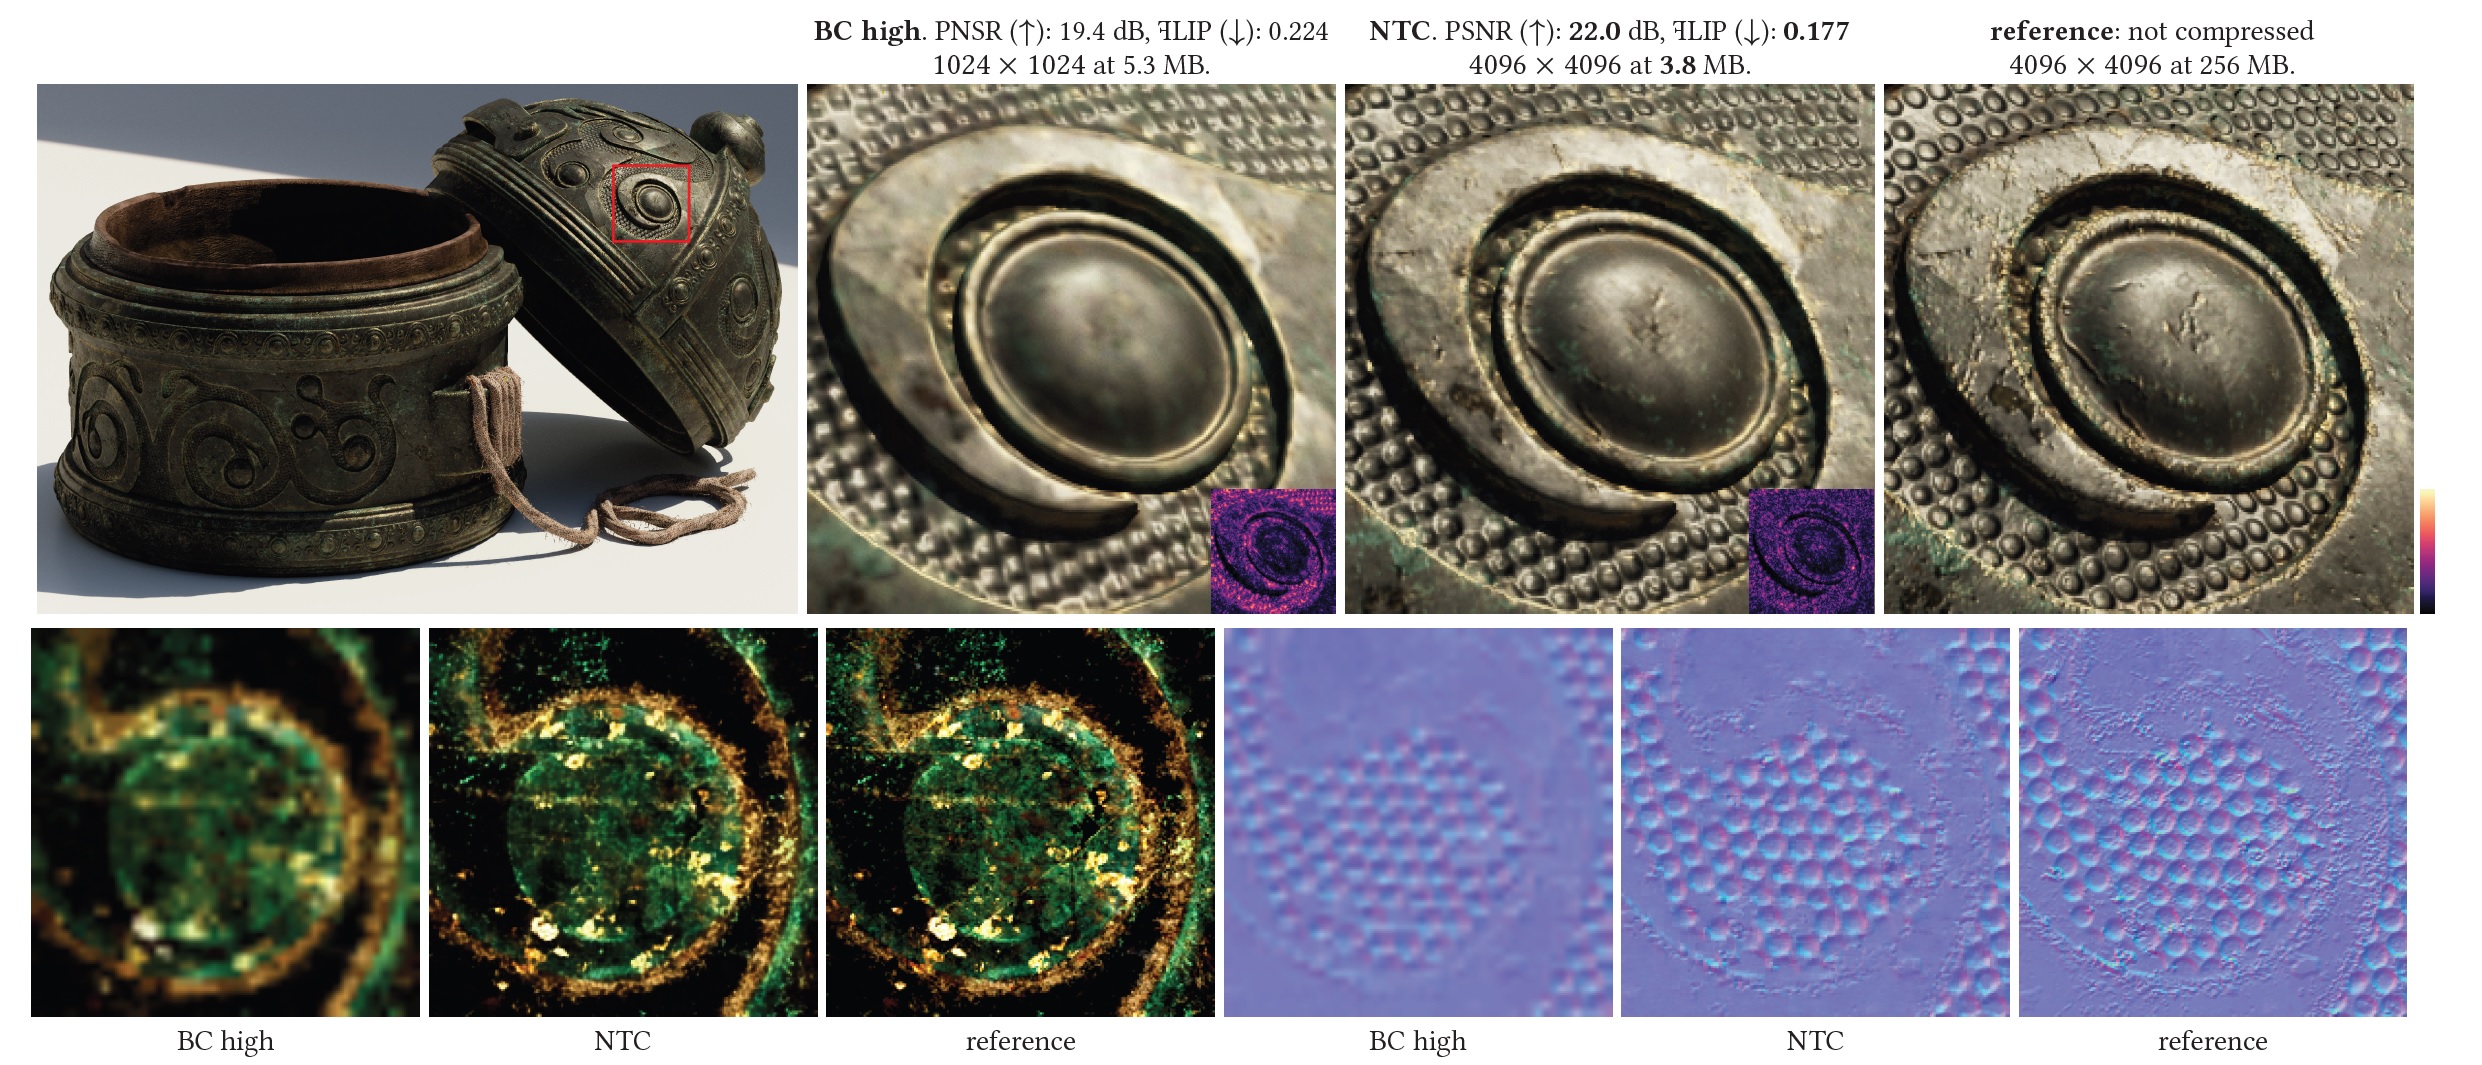
En el GTC 2026, NVIDIA presentó Neural Texture Compression (NTC), una tecnología que promete reducir drásticamente el uso de VRAM en juegos, pasando de 6.5GB a...


Ejecutar un modelo de lenguaje local en tu propio equipo es posible en casi cualquier hardware moderno: desde una laptop con procesador Snapdragon X Elite hasta...