

Desarrolladores
Qwen3.6-27B frente a Claude Opus 4.8: cómo ejecutar modelos de lenguaje localmente sin suscripciones

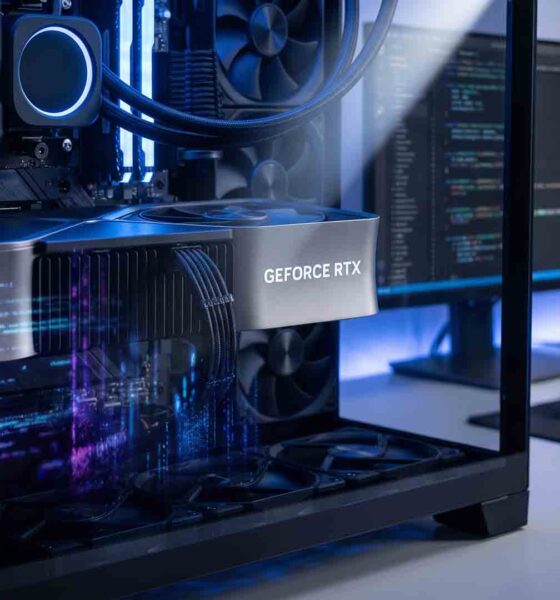
Ejecutar modelos de lenguaje avanzados en hardware propio dejó de ser exclusivo de empresas con infraestructura de servidores. Con una tarjeta gráfica como la Nvidia GeForce RTX 5090 y herramientas de código abierto como Ollama u OpenCode, es posible obtener resultados comparables a los de servicios en la nube, sin costos recurrentes ni dependencia de terceros. Esta guía analiza cómo aprovechar la GPU para trabajar con inteligencia artificial de forma local, eficiente y privada, usando como modelo de referencia Qwen3.6-27B, lanzado el 27 de abril de 2026.
¿Por qué ejecutar modelos de IA localmente?
Los servicios de inteligencia artificial en la nube tienen ventajas evidentes: acceso inmediato a los modelos más recientes, sin instalación y desde cualquier dispositivo. Pero también implican condiciones que el usuario no controla. Con frecuencia, los proveedores modifican sus precios, restringen el acceso a determinados modelos o actualizan sus políticas de uso de datos sin previo aviso. Para quienes dependen de estas herramientas en su trabajo diario, eso representa una variable de riesgo constante.
Ejecutar modelos de forma local elimina esa dependencia. Los datos no salen del equipo, no hay límites de uso por suscripción y el flujo de trabajo no queda sujeto a decisiones externas. Esto resulta especialmente relevante para quienes trabajan con código propietario, documentos confidenciales o simplemente prefieren mantener el control completo sobre su entorno de desarrollo.
RTX 5090: especificaciones reales para inferencia local
La Nvidia GeForce RTX 5090, lanzada en enero de 2025 con un precio de referencia de 1,999 dólares, está construida sobre la arquitectura Blackwell (GB202). Sus especificaciones más relevantes para inferencia de modelos de lenguaje son:
- VRAM: 32 GB GDDR7
- Ancho de banda de memoria: 1.792 GB/s
- Bus de memoria: 512 bits
- Consumo máximo (TDP): 575 W (puede alcanzar 650 W en pico)
- Fuente de poder recomendada: mínimo 1.000 W
Con 32 GB de VRAM, la tarjeta puede ejecutar Qwen3.6-27B en cuantización Q8_0 (~28,6 GB), que representa precisión casi completa, sin necesidad de distribuir capas del modelo entre la GPU y la memoria del sistema. La inferencia de modelos de lenguaje es una carga principalmente limitada por el ancho de banda de memoria, no por la potencia de cómputo, por lo que el salto de GDDR6X a GDDR7 tiene un impacto directo en la velocidad de generación de texto.
En cuanto al costo eléctrico: la tarjeta consume 575 W bajo carga completa, pero durante inferencia de modelos de lenguaje el consumo real es menor, aproximadamente entre 150 y 300 W según el modelo y el nivel de cuantización. A una tarifa de 0,10–0,15 dólares por kWh y un uso diario de cuatro horas dedicadas a inferencia, el costo anual estimado oscila entre 22 y 66 dólares. Esto contrasta con suscripciones a servicios en la nube que van de 20 a 200 dólares mensuales.
Fuera del ámbito de la inteligencia artificial, la RTX 5090 también es una tarjeta competitiva para juegos, edición de video y renderizado, lo que amplía el argumento económico de la inversión inicial.
Qwen3.6-27B: el modelo local de referencia en 2026
Qwen3.6 es la serie más reciente de modelos de lenguaje de Alibaba Cloud, lanzada en abril de 2026 bajo licencia Apache 2.0, lo que permite su uso comercial sin restricciones. El modelo Qwen3.6-27B, publicado específicamente el 27 de abril de 2026, es un modelo denso de 27.000 millones de parámetros con las siguientes características:
- Ventana de contexto nativa: 262,144 tokens (ampliable a ~1,000,000)
- Idiomas: 201 idiomas y dialectos
- Modalidades: texto, imagen y video
- Modo de razonamiento: integrado, con preservación del contexto de pensamiento entre turnos
- Licencia: Apache 2.0
Los requisitos de VRAM aproximados para ejecutarlo localmente con Ollama son:
- Q4_K_M (4 bits): ~16,8 GB — equilibrio entre velocidad y calidad
- Q5_K_M (5 bits): ~19,5 GB — mayor fidelidad al modelo original
- Q6_K (6 bits): ~22,5 GB — alta calidad, ajustado en 24 GB
- Q8_0 (8 bits): ~28,6 GB — precisión cercana a la completa, requiere RTX 5090
Para iniciarlo con Ollama basta con ejecutar:
ollama run qwen3.6:27bComparativa práctica: Qwen3.6-27B frente a Claude Opus 4.8
Las siguientes pruebas comparan el comportamiento de Qwen3.6-27B ejecutado localmente en una RTX 5090 con Claude Opus 4.8 de Anthropic, identificado en la API como claude-opus-4-8 y anunciado el 28 de mayo de 2026. Las pruebas se diseñaron para evaluar áreas donde los modelos tienden a divergir: detección de errores no obvios, manejo de código asíncrono y generación a partir de especificaciones incompletas. Cada prueba se ejecutó usando OpenCode para el modelo local y Claude Code para el modelo en la nube, en dos terminales simultáneas.
Prueba 1: condición de carrera en código asíncrono
Se presentó a ambos modelos una función que simula la actualización paralela de registros en una base de datos en memoria. El código contiene tres errores: una condición de carrera, una pérdida silenciosa de datos y una promesa que nunca se rechaza aunque falle la operación.
Código de prueba:
const db = {};

async function syncUserRecords(userIds, fetchData) {
  const results = [];

  userIds.forEach(async (id) => {
    const data = await fetchData(id);
    db[id] = data;
    results.push({ id, status: "ok" });
  });

  return results;
}

async function runSync() {
  const ids = ["u1", "u2", "u3"];
  const records = await syncUserRecords(ids, async (id) => {
    return { id, value: Math.random() };
  });

  console.log("Sincronizados:", records.length);
}
Errores intencionales:
- Error 1:
forEachcon funciónasyncinterna. Los cierres asíncronos dentro deforEachno son esperados por el bucle externo, por lo queresultssiempre devuelve un arreglo vacío al momento delreturn. - Error 2: escrituras concurrentes sin control sobre
db[id]. SifetchDatatarda tiempos distintos, el orden de escritura en el objeto compartido es indeterminado. - Error 3: ausencia de manejo de errores en
fetchData. Si la función falla, el error se pierde en silencio ydb[id]queda sin actualizar sin ninguna señal al llamador.
Resultados:
- Claude Opus 4.8: Identificó los tres errores con precisión. Explicó el problema de
forEachconasyncde forma clara, señaló la condición de carrera como un riesgo dependiente del entorno de ejecución, y propuso reemplazar el bloque conPromise.allmás un bloquetry/catchpor elemento. Clasificó la condición de carrera como de bajo riesgo en Node.js por su modelo de un solo hilo de eventos, lo cual es técnicamente correcto pero puede dar una falsa sensación de seguridad si el código migra a otro entorno. - Qwen3.6-27B: Identificó los tres errores y añadió una advertencia adicional: si
fetchDatarealiza operaciones de entrada/salida reales, la ausencia de manejo individual de errores puede corromper el estado dedbde forma parcial sin que el llamador lo detecte. PropusoPromise.allSettleden lugar dePromise.all, argumentando que permite registrar los fallos individuales sin interrumpir la sincronización del resto de los registros. La respuesta fue más extensa y tardó aproximadamente el doble en generarse respecto a Claude Opus 4.8 vía API.
En esta prueba, Qwen3.6-27B ofreció un análisis más defensivo al preferir Promise.allSettled sobre Promise.all, una diferencia de criterio de diseño con implicaciones reales en sistemas de producción.
Prueba 2: refactorización con lógica contradictoria
Se entregó a ambos modelos una función de validación de formulario con lógica contradictoria y se les pidió refactorizarla para que fuera “más robusta y manejable”. Las instrucciones fueron deliberadamente ambiguas para observar cómo cada modelo resuelve la contradicción sin que se le señale explícitamente.
Código de prueba:
function validateForm(data) {
  let valid = true;
  const errors = [];

  if (!data.email || data.email.length === 0) {
    errors.push("El correo es obligatorio");
    valid = false;
  }

  if (data.email && !data.email.includes("@")) {
    errors.push("El correo no es válido");
    valid = false;
  }

  if (data.age !== undefined && data.age < 18) {
    errors.push("El usuario debe ser mayor de edad");
    valid = false;
  }

  if (data.age === undefined) {
    valid = true;
  }

  return { valid, errors };
}
Errores intencionales:
- Error 1: La última condición (
if (data.age === undefined)) sobreescribevalidatrueaunque se hayan registrado errores anteriores en el correo. Un formulario con correo inválido y sin campo de edad pasará la validación sin advertencias. - Error 2: La validación de formato de correo solo verifica la presencia de
@, lo que acepta cadenas como"@","a@"o"@b"como válidas. - Error 3: El campo
agese compara directamente como número sin verificar su tipo. Si llega como cadena de texto desde un formulario HTML ("17"), la comparación< 18puede producir resultados inesperados según el motor de JavaScript.
Resultados:
- Claude Opus 4.8: Detectó los errores 1 y 2 de inmediato. Para el primero, señaló que la lógica es contradictoria y parece un error de diseño, no una decisión intencional. Para el segundo, propuso una expresión regular básica. No detectó el error 3 en la primera respuesta; lo identificó solo cuando se le señaló en una segunda iteración. Formuló una pregunta de seguimiento sobre si el campo
agepodría llegar como cadena desde un formulario HTML. - Qwen3.6-27B: Detectó los tres errores en la primera respuesta. Sobre el error 3, indicó proactivamente que los valores de formularios HTML son siempre cadenas de texto y que la comparación numérica requiere conversión explícita con
Number()o el operador unario+. Refactorizó el código completo sin preguntas adicionales, eliminando la contradicción y documentando cada cambio con comentarios en línea.
En esta prueba, Qwen3.6-27B identificó los tres errores sin iteración adicional y entregó el código corregido en la primera respuesta. Claude Opus 4.8 requirió una segunda vuelta para el error de tipo en age, aunque su pregunta de seguimiento sobre el origen del dato refleja un razonamiento contextual más explícito antes de asumir decisiones de diseño.
Prueba 3: generación desde una especificación incompleta
Se pidió a ambos modelos que generaran una función para exportar datos de usuarios a formato CSV, con la única restricción de que “debe funcionar en el navegador”. La restricción implícita es que no se puede usar el sistema de archivos de Node.js.
Instrucción: “Escribe una función en JavaScript que tome un arreglo de objetos de usuario con las propiedades name, email, role y createdAt, y los exporte como archivo CSV. Debe funcionar en el navegador.”
Resultados:
- Claude Opus 4.8: Generó correctamente una función que construye el contenido CSV como cadena de texto, crea un objeto
Blob, genera una URL temporal conURL.createObjectURLy descarga el archivo mediante un elemento<a>generado de forma programática. Añadió el manejo del campocreatedAtcomo fecha legible contoLocaleDateString. Preguntó si se necesitaba soporte para campos con comas o saltos de línea dentro del valor (escapado RFC 4180). - Qwen3.6-27B: Generó la misma solución estructural, pero añadió sin que se le solicitara: escapado de comillas dobles dentro de los valores, envoltura de campos que contienen comas en comillas dobles conforme al estándar RFC 4180, y limpieza de la URL temporal con
URL.revokeObjectURLtras la descarga para liberar memoria. No formuló preguntas de seguimiento.
En esta prueba ambos modelos resolvieron el objetivo correctamente. Qwen3.6-27B entregó una solución más completa en la primera respuesta, mientras que Claude Opus 4.8 identificó los casos borde mediante preguntas antes de implementarlos, un enfoque más cauteloso pero que requiere mayor interacción.
Claude Code, OpenCode y Crush: qué herramienta usar según el caso
La elección de la herramienta de terminal afecta directamente la experiencia de trabajo, independientemente del modelo subyacente. En 2026 existen tres opciones consolidadas:
Claude Code es el agente de codificación oficial de Anthropic. Su punto fuerte es la profundidad de razonamiento combinada con funciones exclusivas como la vista de agente para gestionar entre 5 y 10 sesiones paralelas, el comando /goal para definir objetivos de largo alcance y la revisión automatizada de código. En índices de referencia como SWE-bench Verified alcanza el 88,6% con Claude Opus 4.8. El costo se factura por uso de tokens: 5 dólares por millón de tokens de entrada y 25 dólares por millón de tokens de salida. Es la mejor opción para equipos que necesitan las funciones de nube y el mayor techo de razonamiento disponible.
OpenCode es la alternativa de código abierto más adoptada en 2026, con más de 165,000 estrellas en GitHub. Lanzado en abril de 2025, admite más de 75 proveedores de modelos, incluyendo conexiones locales a través de Ollama, y permite enrutar consultas tanto a modelos locales como a APIs externas desde la misma sesión. Cuenta con modos de agente diferenciados: Build para edición y ejecución con acceso completo a herramientas, y Plan para análisis en modo solo lectura. Está disponible como herramienta de terminal, aplicación de escritorio en fase de prueba y como extensión para VS Code, Cursor, JetBrains y Zed. Para quien quiere usar Qwen3.6-27B local junto a Claude Opus 4.8 en la nube sin cambiar de entorno, OpenCode es la opción más directa y sin costo.
Crush, desarrollado por Charmbracelet y escrito en Go, se distingue por la calidad visual de su interfaz de terminal y por permitir el cambio de modelo dentro de la misma sesión sin perder el contexto acumulado. Integra soporte para LSP y MCP y funciona en macOS, Linux, Windows y Android. Es la opción indicada para quienes priorizan la experiencia de uso en terminal sobre la cobertura de índices de referencia.
Configuraciones recomendadas según la VRAM disponible
No todos los usuarios disponen de una tarjeta con 32 GB de VRAM. A continuación se presentan opciones verificadas para los rangos más comunes de hardware de consumo, actualizadas a junio de 2026.
32 GB de VRAM — RTX 5090
- Qwen3.6-27B Q8_0: ~28,6 GB. Precisión casi completa, ventana de contexto nativa de 262.000 tokens. Comando:
ollama run qwen3.6:27b - Gemma 4 31B Q4: ~18,6 GB. Modelo denso de Google, lanzado el 31 de marzo de 2026. Tercero en el índice de referencia Arena AI entre modelos de código abierto. Deja margen para contexto extendido dentro de los 32 GB disponibles.
16 GB de VRAM
- Qwen3.6-27B Q4_K_M: ~16,8 GB. Equilibrio entre tamaño y calidad. Requiere ajuste del contexto para no superar el límite de VRAM.
- Gemma 4 26B A4B Q4: ~14–16 GB. Modelo de Mezcla de Expertos de Google con velocidad de inferencia comparable a un modelo denso de 7B. Sexto en el índice Arena AI entre modelos de código abierto.
- Qwen3-14B FP16: Modelo denso de la generación anterior. Corre en precisión completa dentro de los 16 GB sin cuantización.
12 GB de VRAM
- Qwen3-8B: Modelo denso con ventana de contexto de 128.000 tokens. Corre limpiamente en 12 GB.
- Gemma 4 26B A4B Q4: Con contexto corto cabe en 12 GB. Rendimiento superior a su tamaño por la arquitectura de Mezcla de Expertos.
- Mistral 7B Q8: ~8 GB. Eficiente en razonamiento y generación de texto para su tamaño. Deja margen para contexto en una tarjeta de 12 GB.
8 GB de VRAM
- Qwen3-4B: Modelo denso. Adecuado para generación de texto y codificación básica.
- Mistral 7B Q4_K_M: ~5,5 GB de VRAM. Viable en tarjetas de 8 GB con margen para el contexto.
- Gemma 4 E2B: Variante de 2B parámetros efectivos de Gemma 4, diseñada para dispositivos con recursos muy limitados. Menos de 3 GB de VRAM.
Para maximizar el rendimiento en los rangos inferiores de VRAM se recomienda usar cuantización Q4_K_M a través de Ollama o LM Studio. Cuando el modelo no cabe completamente en la VRAM disponible, estas herramientas permiten distribuir capas a la memoria del sistema con una reducción de velocidad proporcional al porcentaje transferido.
Privacidad y control en la inferencia local
Cuando se usan servicios en la nube como Claude o Codex, las consultas se envían a servidores externos. Aunque la mayoría de los proveedores ofrecen opciones para desactivar el uso de datos en el entrenamiento de modelos futuros, esta opción no siempre está activa por defecto y las políticas pueden cambiar.
Con un modelo ejecutado localmente, los datos no salen del equipo en ningún momento. No existe una API intermediaria, no hay registros en servidores de terceros y no hay límites de uso por plan. Esto es relevante para quienes trabajan con código propietario, bases de datos internas o historiales de consultas que prefieren que no sean procesados externamente.
Conclusión
Ejecutar modelos de lenguaje localmente es una alternativa viable si se dispone del hardware adecuado y se tienen claros los compromisos. Qwen3.6-27B en una RTX 5090 ofrece un rendimiento comparable al de Claude Opus 4.8 en tareas prácticas de programación, con la ventaja de la privacidad, el control sobre el entorno y la eliminación de costos variables por uso de tokens. En las tres pruebas realizadas, Qwen3.6-27B mostró mayor cobertura de errores en la primera respuesta; Claude Opus 4.8 compensó con mayor transparencia en su razonamiento y funciones de agente más avanzadas a través de Claude Code.
La diferencia principal no está tanto en la calidad de las respuestas como en la velocidad de generación —mayor en la nube— y en el costo a largo plazo. Para usuarios con cargas de trabajo intensivas o con requisitos de privacidad, el argumento económico a mediano plazo favorece la inferencia local.
Quienes dispongan de hardware con menos VRAM también tienen opciones funcionales. Desde 16 GB con Qwen3.6-27B en Q4 hasta 8 GB con Qwen3-4B o Mistral 7B cuantizado, el ecosistema de modelos de código abierto de 2026 cubre un rango amplio de configuraciones. Herramientas como Ollama, LM Studio, OpenCode y Crush simplifican la puesta en marcha y hacen accesible la curva de entrada incluso para quienes no tienen experiencia previa en administración de modelos.
Lo más leído en Desarrolladores
-
 Desarrolladores
Gemini 4 Carbon el modelo de IA más potente de Google enfocado en ciberseguridad
Google DeepMind anunció el 28 de octubre de 2026 su nuevo modelo de vanguardia: Gemini 4 Carbon, presentado…
-
 Curiosidades
Cómo crear con IA un script de respaldo automático para Windows
Un asistente de inteligencia artificial puede ayudar a escribir y adaptar un script de PowerShell para copiar archivos…




Lo más leído en Desarrolladores
-
Desarrolladores
Gemini 4 Carbon el modelo de IA más potente de Google enfocado en ciberseguridad
Google DeepMind anunció el 28 de octubre de 2026 su nuevo modelo de vanguardia: Gemini 4 Carbon, presentado…
-
Curiosidades
Cómo crear con IA un script de respaldo automático para Windows
Un asistente de inteligencia artificial puede ayudar a escribir y adaptar un script de PowerShell para copiar archivos…
Google DeepMind anunció el 28 de octubre de 2026 su nuevo modelo de vanguardia: Gemini 4 Carbon, presentado como el más potente de su catálogo, con capacidades de ciberseguridad de última generación y de ejecución de tareas de largo plazo. El modelo llega solo dos semanas después de Gemini 4 Argón y lidera el Índice de Inteligencia de Artificial Analysis en su versión 5.0 con 59 puntos, aunque por ahora su acceso está restringido a un grupo selecto de ciberdefensores.
Lo más leído en Desarrolladores
-
Desarrolladores
Gemini 4 Carbon el modelo de IA más potente de Google enfocado en ciberseguridad
Google DeepMind anunció el 28 de octubre de 2026 su nuevo modelo de vanguardia: Gemini 4 Carbon, presentado…
-
Curiosidades
Cómo crear con IA un script de respaldo automático para Windows
Un asistente de inteligencia artificial puede ayudar a escribir y adaptar un script de PowerShell para copiar archivos…

Mistral AI publicó los pesos abiertos de Mistral Large 4 (Le Chonk), su modelo insignia de un billón de parámetros y multimodal por naturaleza. La compañía francesa lo posiciona como el mejor modelo de peso abierto para programación, con avances notables en ciberseguridad defensiva, eficiencia de razonamiento y un precio de 0.70 dólares por millón de tokens de entrada.
Lo más leído en Desarrolladores
-
Desarrolladores
Gemini 4 Carbon el modelo de IA más potente de Google enfocado en ciberseguridad
Google DeepMind anunció el 28 de octubre de 2026 su nuevo modelo de vanguardia: Gemini 4 Carbon, presentado…
-
Curiosidades
Cómo crear con IA un script de respaldo automático para Windows
Un asistente de inteligencia artificial puede ayudar a escribir y adaptar un script de PowerShell para copiar archivos…
Lo más leído
-
 Entretenimiento
Revisión: Tombwater – Soulslike western en pixel art
-
 Cine
Revisión: Queen’s Domain – RPG de acción retro y mazmorras oscuras
-
 Herramientas
Cómo reemplazar Audible y Kindle con alternativas autoalojadas y ser dueño de tu biblioteca
-
 Consola
Revisión: Air Hares – Bullet hell de siembra y cooperación local
-
 Entretenimiento
Revisión: Rat Game – Ratas contra chef en un restaurante
-

 Apps11 años ago
AMPcast, la herramienta de Pandora que permite a los artistas grabar mensajes de audio directamente a sus seguidores
-
 Blogs5 años ago
Conoce los mejores sitios de Torrents para descargar todo tipo de contenidos
-
Android5 años ago
Aprende cómo usar Discord para ver películas con tus amigos
-
Arte y Cultura14 años ago
Colección de fondos de pantalla basados en Super Héroes
-

 Almacenamiento2 años ago
Cómo usar TeraBox: La guía definitiva para aprovechar 1 TB de almacenamiento en la nube
-
Diseño13 años ago
css3ps: plugin que convierte archivos PSD a CSS3
-
Apps9 años ago
Picturethat, app que usa la Realidad Aumentada para visualizar cómo quedarían los cuadros antes de colgarlos
-
Eventos Especiales13 años ago
Especial Día de la Madres: fondos de pantalla especiales para Mamá