FreeVideo, un motor de inferencia local de código abierto para el modelo MiniMax H3, permite crear videos con IA en computadoras de consumo desde solo 8...
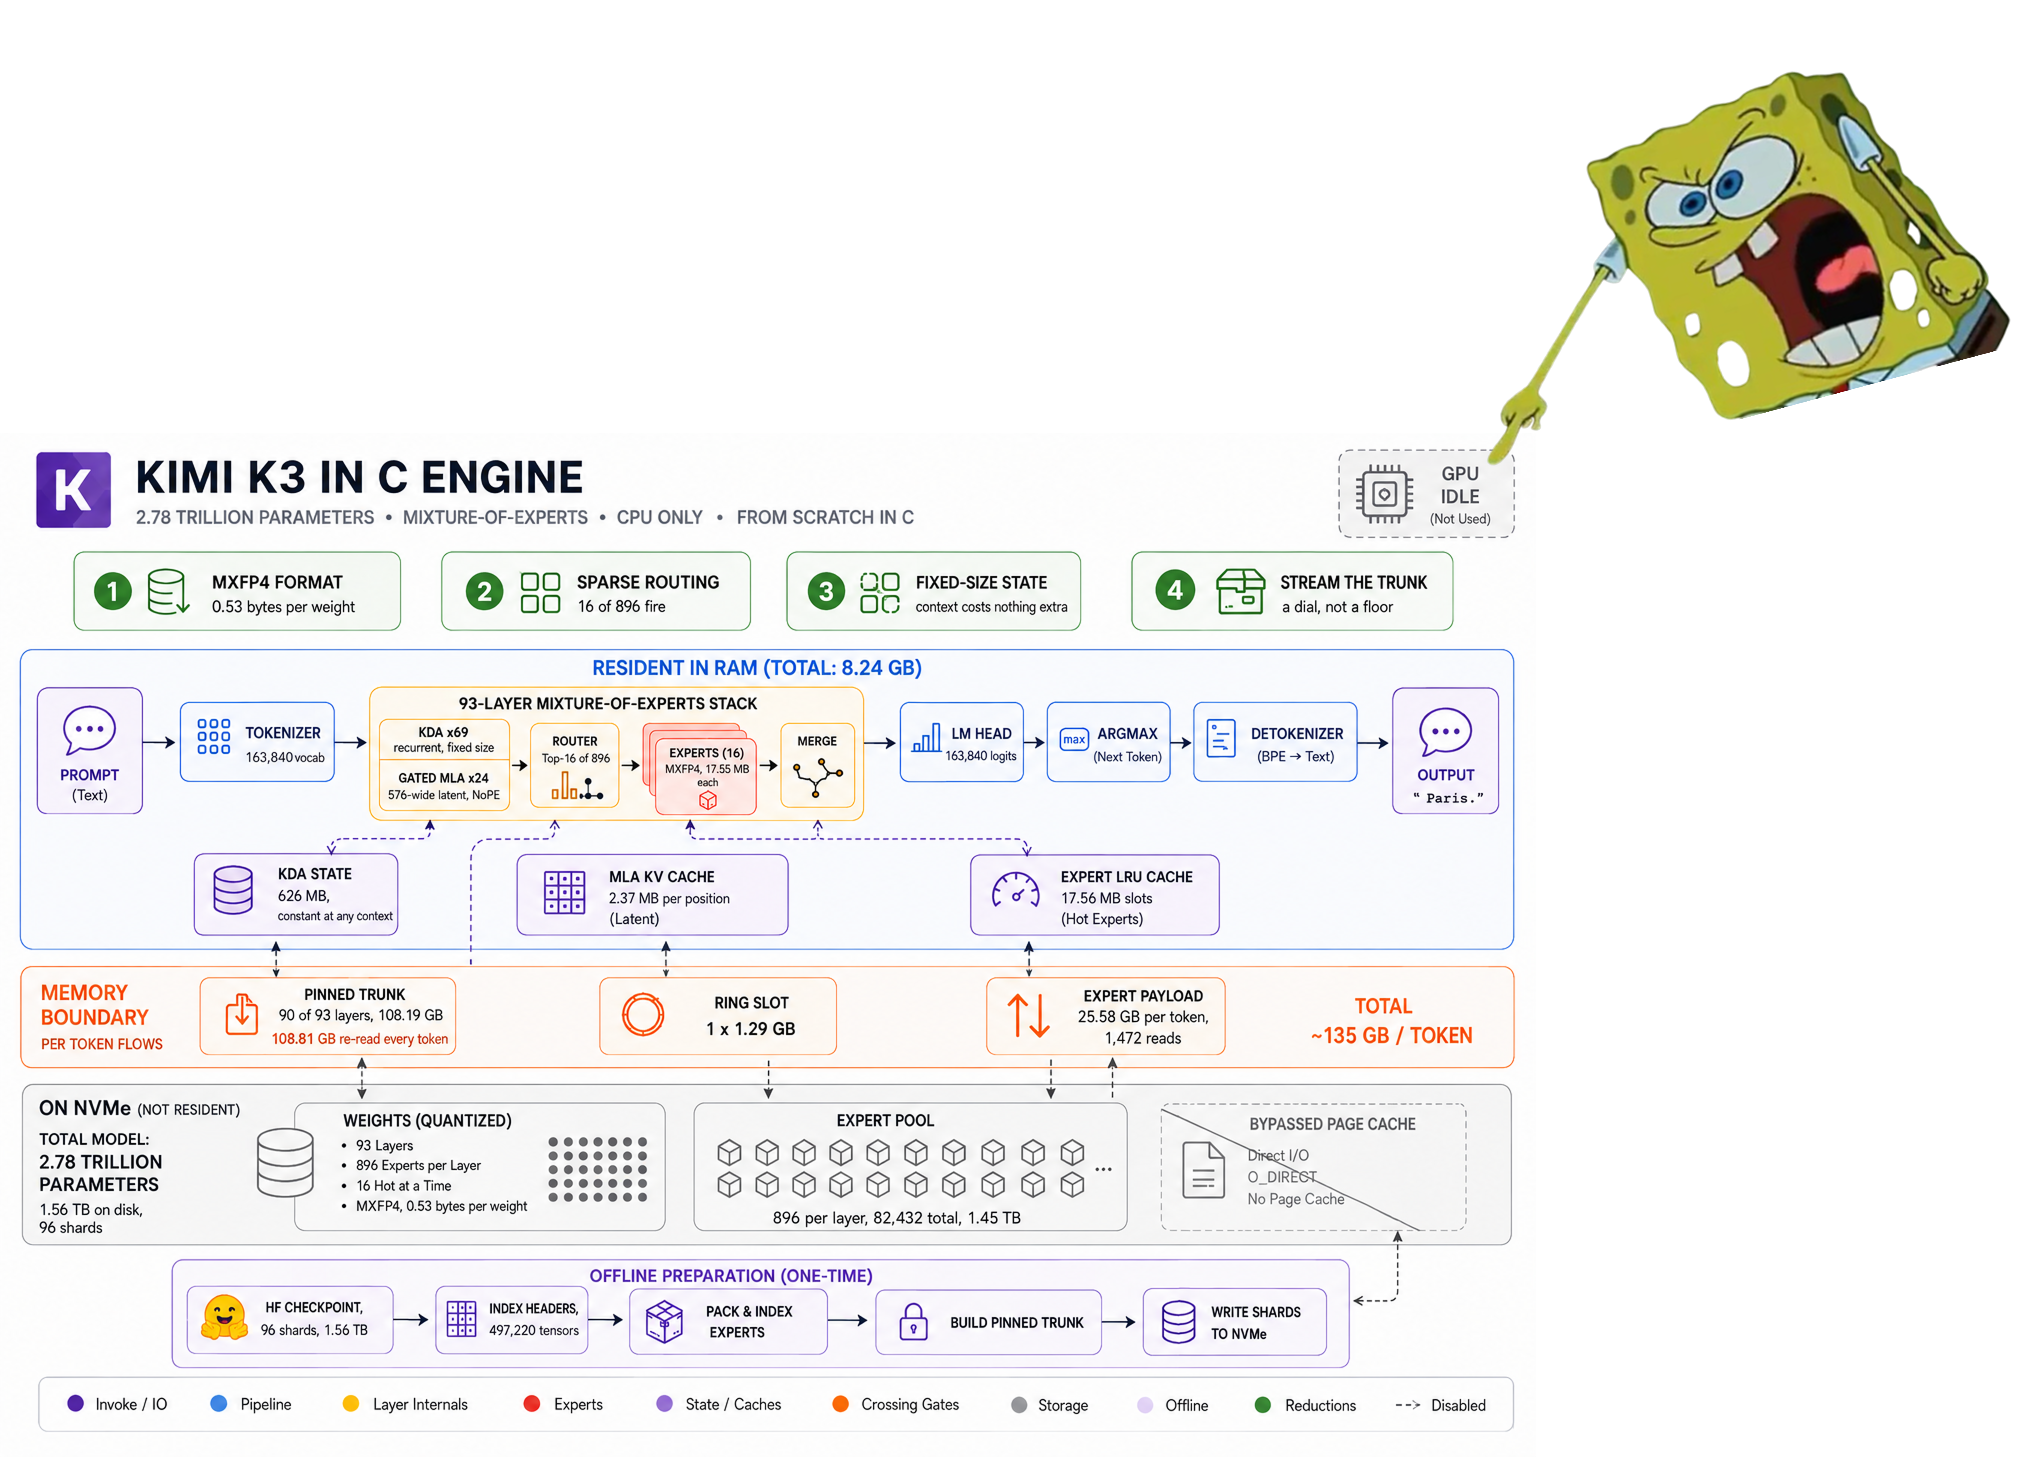
Un desarrollador logró ejecutar el modelo Kimi K3 de 2.78 billones de parámetros en una CPU común con solo 8.24 GB de RAM, sin GPU, sin...

Strata es un motor de inferencia gratuito y de código abierto que permite chatear, programar y trabajar con imágenes ejecutando modelos de IA directamente en tu...
llamAmpere es un fork de código abierto de llama.cpp optimizado para tarjetas NVIDIA de la generación Ampere, especialmente la RTX 3090 y la 3090 Ti. Según...

Ingenieros e investigadores vinculados a la Universidad de California en Berkeley crearon vLLM, un motor de inferencia de código abierto capaz de multiplicar por 24 el...

Investigadores del Institute of Science and Technology Austria (ISTA) publicaron versiones GGUF cuantizadas de DeepSeek-V4.1-Flash-1017, un modelo sparse mixture-of-experts de 763.2 mil millones de parámetros con...
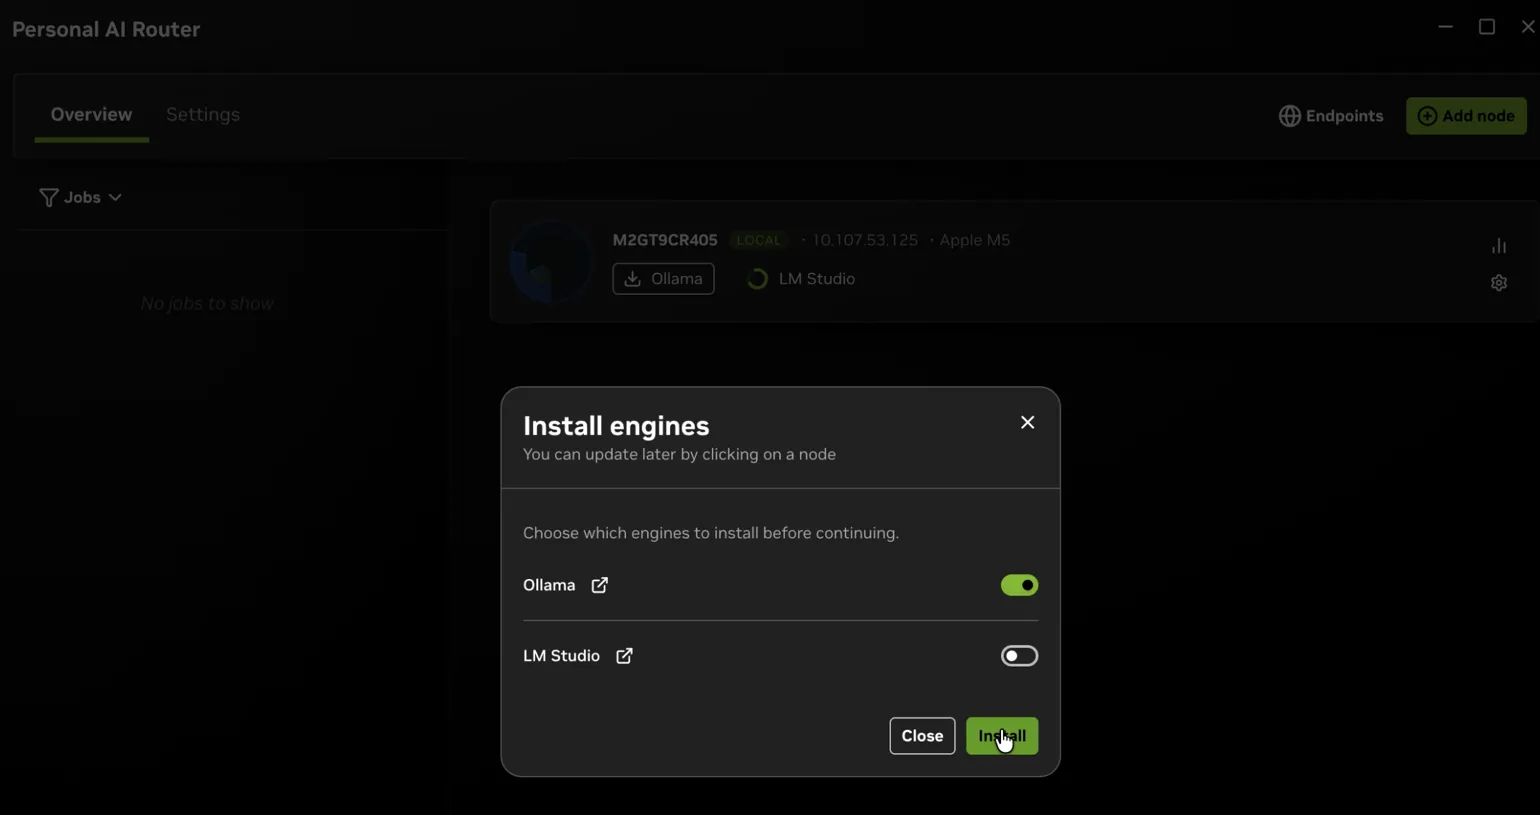
NVIDIA liberó la versión 1.0.0 de PAIR, su router de IA personal gratuito y de código abierto que reparte solicitudes de inferencia local entre varios equipos...
Strata es un motor de inferencia gratuito y de código abierto que ejecuta el modelo Qwen3.8-Flash-Next, de 125 mil millones de parámetros, en una computadora gaming...

El proyecto open source dsv41-flash-offload logra servir DeepSeek V4.1 Flash, un modelo de unos 200GB en expertos, desde una única RTX 3090 de 24GB apoyada en...
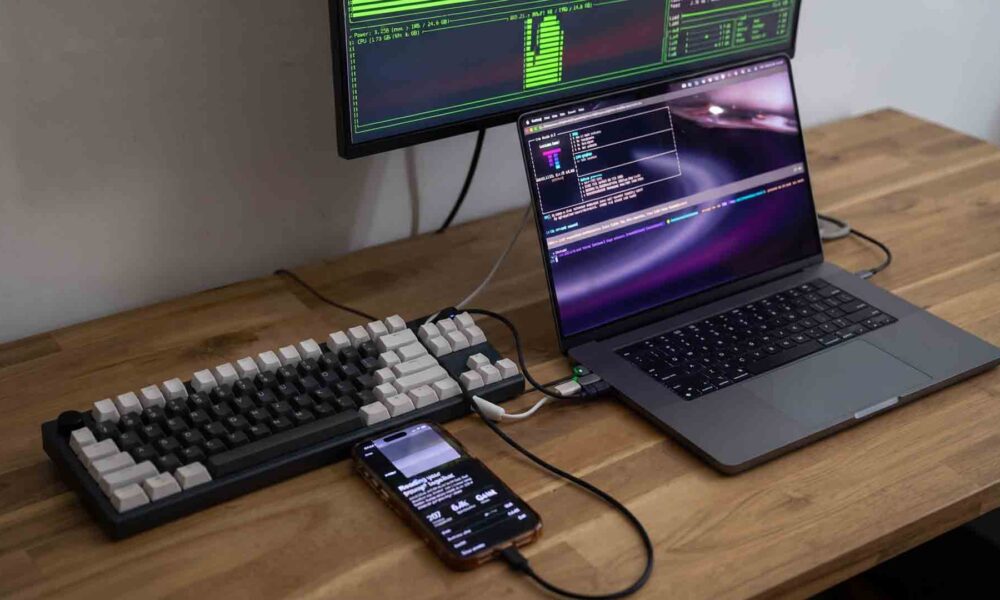

Un experimento viral de Reddit convierte el iPhone en una GPU auxiliar para ejecutar un modelo de 27 mil millones de parámetros en una MacBook de...

Mientras las grandes tecnológicas gastan miles de millones en GPUs, el proyecto open source Colibri ejecutó GLM-5.2, un modelo de 744 mil millones de parámetros, en...

NVIDIA Nemotron 3.5 Lightning es un modelo abierto de tipo Mixture of Experts (MoE) de 30B parámetros, con solo 3B parámetros activos, diseñado para optimizar la...


Ejecutar modelos de lenguaje avanzados en hardware propio dejó de ser exclusivo de empresas con infraestructura de servidores. Con una tarjeta gráfica como la Nvidia GeForce...


Aprende qué es Edge AI en finanzas, qué sí se puede hacer hoy, qué es puro marketing y cómo usar modelos locales con ejemplos prácticos.


Instala llama.cpp en Windows y Mac sin compilar, compara con Ollama y LM Studio, y aprende a compartir modelos GGUF entre las tres herramientas sin duplicar...


TurboQuant comprime la memoria de trabajo de los modelos de IA a 3 bits sin reentrenamiento ni pérdida de precisión: el avance de compresión más notable...


Ejecutar un modelo de lenguaje local en tu propio equipo es posible en casi cualquier hardware moderno: desde una laptop con procesador Snapdragon X Elite hasta...