
Hardware
Colibri ejecuta un modelo de IA de 744B en una laptop sin GPU

Mientras las grandes tecnológicas gastan miles de millones en GPUs, el proyecto open source Colibri ejecutó GLM-5.2, un modelo de 744 mil millones de parámetros, en una laptop sin tarjeta gráfica y completamente sin conexión. Su truco: mantener en RAM solo lo imprescindible y transmitir el resto desde el SSD.
No es exageración publicitaria. Colibri es un motor de inferencia escrito en C puro, desarrollado por el programador italiano JustVugg y publicado bajo licencia Apache-2.0, capaz de correr GLM-5.2 —el modelo Mixture-of-Experts (MoE) de Z.ai— en hardware de consumo: 25 GB de RAM, sin dependencias de Python en tiempo de ejecución y con un endpoint compatible con OpenAI disponible para servir el modelo.
¿Por qué puede funcionar sin una GPU?
La respuesta está en la arquitectura del modelo, no en magia. GLM-5.2 es un modelo MoE: para cada token solo se activa una pequeña fracción de sus 21.504 expertos enrutados (unos 19 MB cada uno en formato int4). Colibri aprovecha esa estadística e invierte el enfoque habitual: las partes densas del modelo (atención, expertos compartidos, embeddings) viven en RAM ocupando unos 10 GB, y los expertos enrutados —cerca de 370 GB en total— permanecen en el disco hasta que se necesitan.
Para amortizar las lecturas usa decodificación especulativa nativa (Multi-Token Prediction), que valida entre 2,2 y 2,8 tokens por pasada hacia adelante, junto con una caché KV comprimida de tipo MLA que reduce drásticamente la memoria por token. Es la misma filosofía de exprimir el hardware propio que ya inspira las guías para optimizar modelos de lenguaje locales en Ollama, LM Studio y llama.cpp, llevada a un extremo que nadie había probado.
Requisitos reales para probarlo
Vale la pena ser precisos con las cifras, porque el titular genera expectativas que conviene aterrizar. Esto es lo que necesita el proyecto según su documentación:
| Requisito | Detalle |
|---|---|
| Almacenamiento | ~370 GB en SSD NVMe (modelo int4 completo) |
| RAM | Mínimo 25 GB; el motor mantiene ~9,9 GB residentes |
| CPU | Procesador moderno con AVX2; compilación con gcc y OpenMP |
| GPU | Ninguna necesaria (también escala a configuraciones con GPU) |
| Carga inicial | ~30 segundos |
| Plataformas | Linux, macOS y Windows 11 |
Un detalle tranquilizador: el streaming de Colibri es de solo lectura, así que no desgasta el SSD de forma significativa. Eso sí, la velocidad del NVMe es parte del contrato: en un disco lento o casi lleno, la experiencia se degrada. Y si tu equipo está lejos de estas cifras, conviene revisar qué LLM local elegir según tu VRAM antes de intentar hazañas.
¿Qué tan rápido es realmente?
Aquí llega la letra pequeña que el hype suele omitir. No es rápido. El propio README del proyecto lo admite sin rodeos: es un modelo de clase frontera respondiendo correctamente en una máquina que cuesta menos que el ventilador de un H100, pero el cuello de botella es el disco, no el cálculo. Con la caché fría, generar un token puede exigir leer cerca de 11 GB desde el SSD, y las velocidades típicas lo colocan en el terreno de la investigación y la exploración, no en el del asistente en tiempo real.
El análisis técnico de IQ Source lo resume con una metáfora de aviación: Colibri demuestra que el modelo corre, en principio, en hardware imposible, pero no que esté listo para despegar con pasajeros a bordo.
Cómo usarlo en la práctica
El proyecto arranca en modo chat tras compilarlo, y también puede levantar un servidor con un endpoint compatible con OpenAI, lo que permite conectar herramientas existentes sin depender de la nube. La persistencia de la caché KV permite retomar conversaciones con el motor ya caliente. Es la misma lógica que ya aplica quien conecta Claude Code con modelos locales vía un servidor de LM Studio, solo que aquí el “modelo local” pesa 744 mil millones de parámetros.
Para quienes quieran reproducir la prueba, el análisis práctico publicado en Dev Community detalla comandos, benchmarks y expectativas realistas de velocidad.
Un hito para la IA local, con letra pequeña
Lo cierto es que la demostración tiene consecuencias concretas: modelos masivos corriendo en equipos propios, cero costos de API y datos que nunca salen de la máquina. Pero la conclusión honesta es que Colibri demuestra viabilidad, no comodidad. Su valor está en marcar el rumbo: a medida que el NVMe y la capacidad de las máquinas de consumo sigan mejorando, la clase de modelos que pueden ejecutarse así crecerá con cada generación de hardware. La IA local, en efecto, se está volviendo seria.
Lo más leído en Hardware
-
 Comunicados de Prensa
Tecnología NVIDIA RTX llega con descuentos para jugar crear y explorar la IA en México
NVIDIA lanzó una campaña de descuentos en México con tarjetas gráficas GeForce RTX Serie 50 y laptops equipadas…
-
 Curiosidades
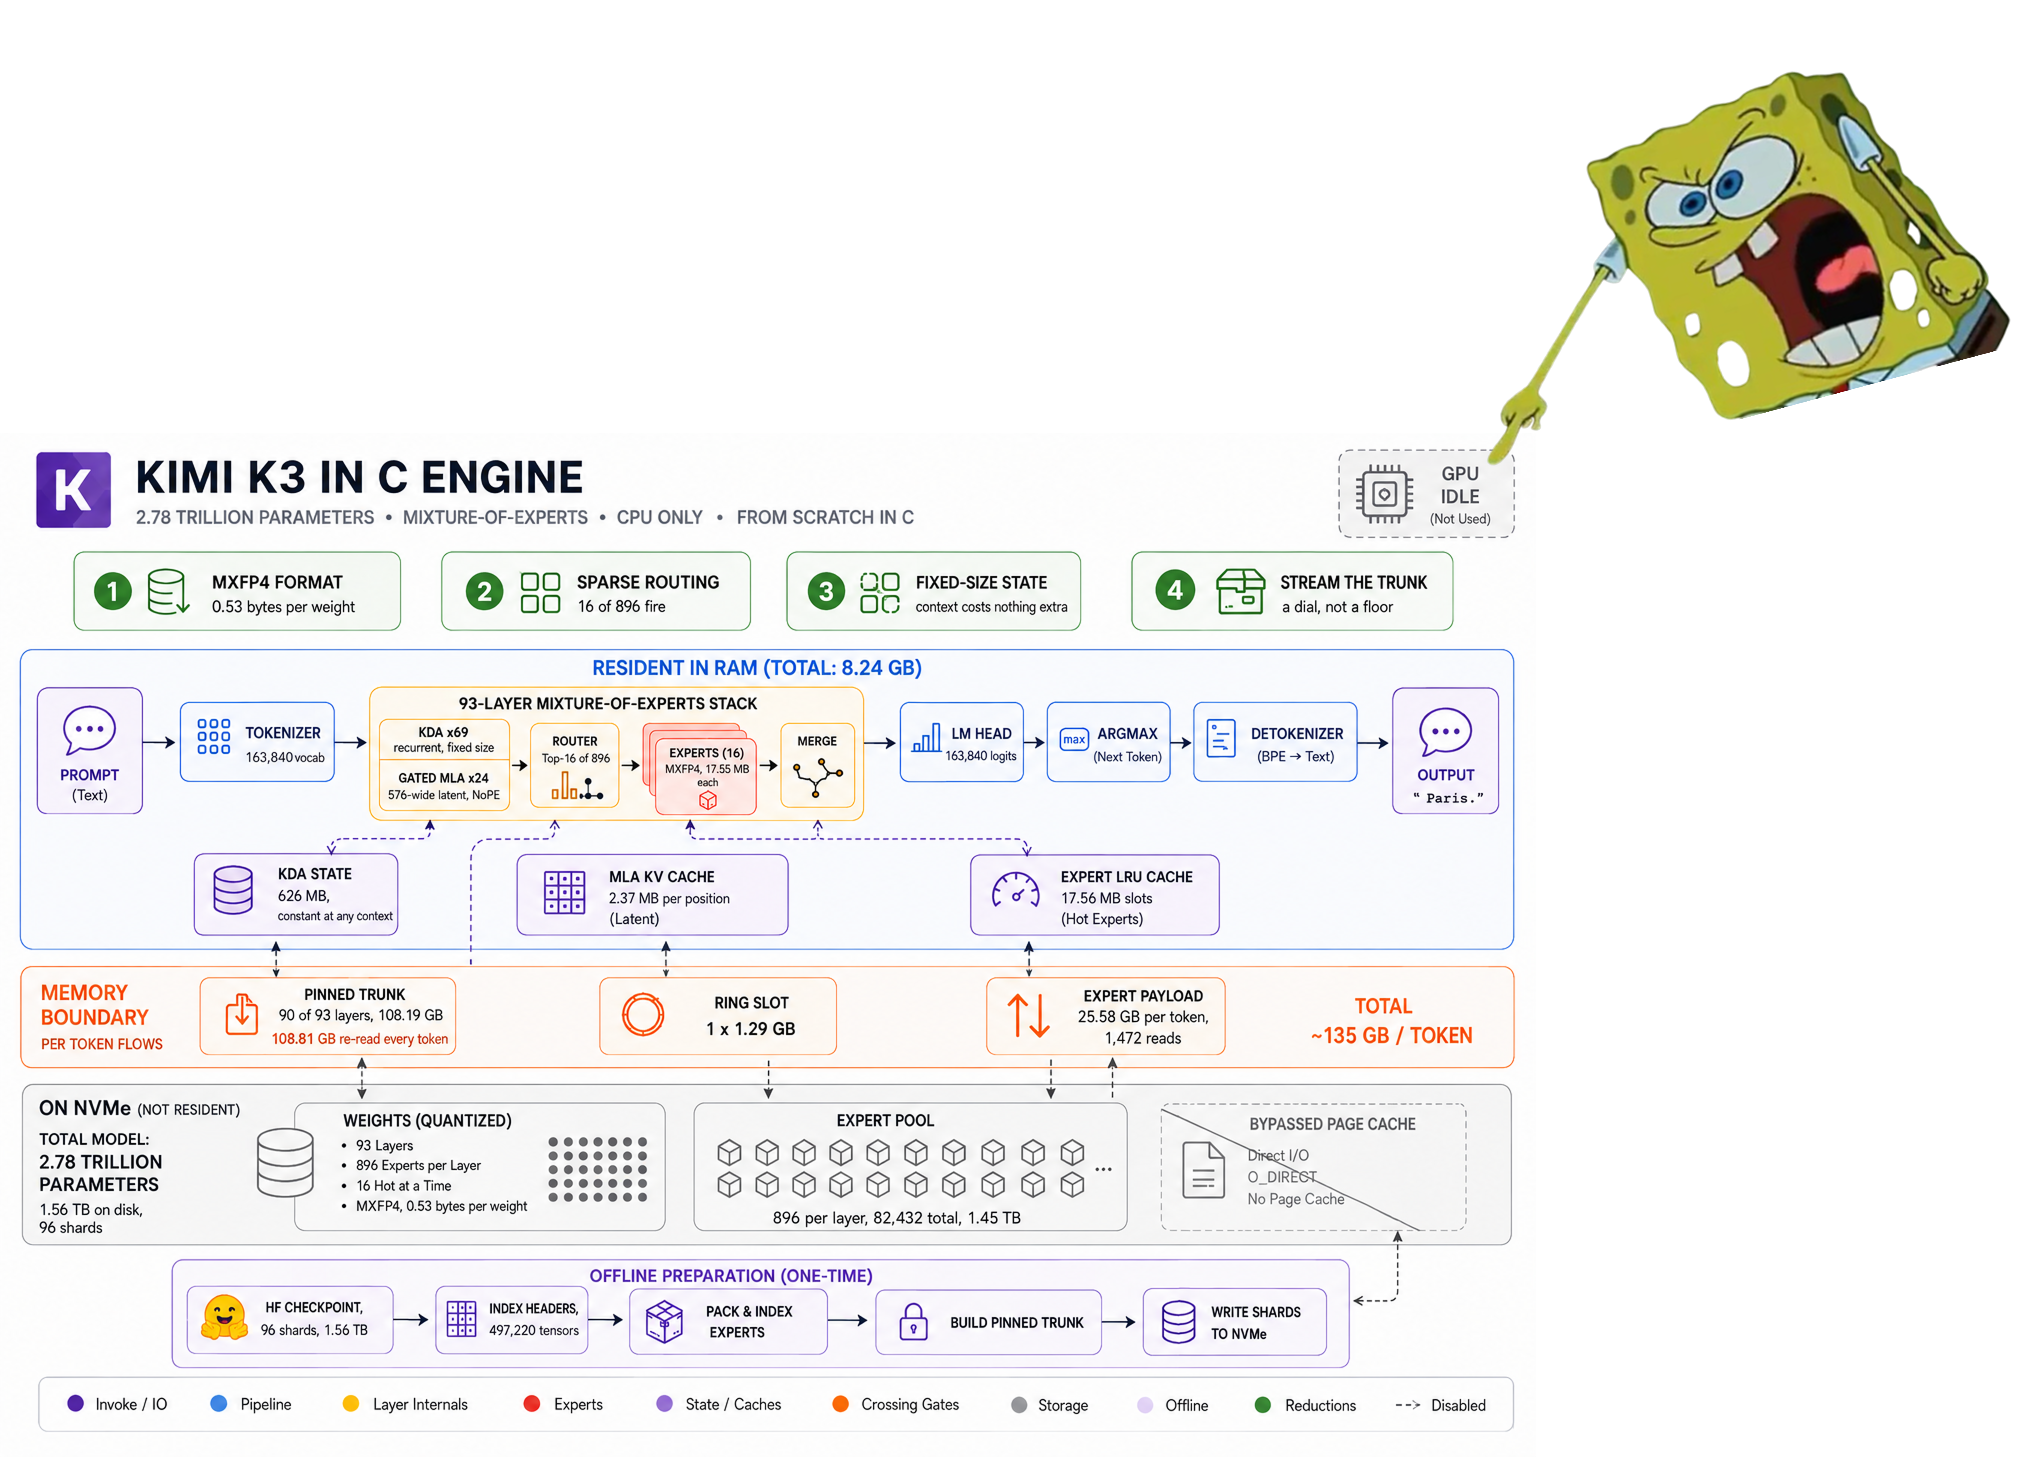
Kimi K3 en C: un modelo de 2.78 billones de parámetros corre en 8 GB de RAM
Un desarrollador logró ejecutar el modelo Kimi K3 de 2.78 billones de parámetros en una CPU común con…


Un desarrollador logró ejecutar el modelo Kimi K3 de 2.78 billones de parámetros en una CPU común con solo 8.24 GB de RAM, sin GPU, sin frameworks y sin BLAS. El proyecto se llama kimi-k3-in-c, está escrito en C99 portable, supera las 12 mil estrellas en GitHub y se distribuye bajo licencia Apache 2.0.
Lo más leído en Hardware
-
Comunicados de Prensa
Tecnología NVIDIA RTX llega con descuentos para jugar crear y explorar la IA en México
NVIDIA lanzó una campaña de descuentos en México con tarjetas gráficas GeForce RTX Serie 50 y laptops equipadas…
-
Curiosidades
Kimi K3 en C: un modelo de 2.78 billones de parámetros corre en 8 GB de RAM
Un desarrollador logró ejecutar el modelo Kimi K3 de 2.78 billones de parámetros en una CPU común con…
Comunicados de Prensa
Tecnología NVIDIA RTX llega con descuentos para jugar crear y explorar la IA en México
NVIDIA lanzó una campaña de descuentos en México con tarjetas gráficas GeForce RTX Serie 50 y laptops equipadas con estas GPU, pensadas para gamers, creadores de contenido y entusiastas de la inteligencia artificial. La promoción reúne equipos de marcas como MSI, ASUS, Gigabyte, HP y Lenovo disponibles en tiendas del país.
Lo más leído en Hardware
-
Comunicados de Prensa
Tecnología NVIDIA RTX llega con descuentos para jugar crear y explorar la IA en México
NVIDIA lanzó una campaña de descuentos en México con tarjetas gráficas GeForce RTX Serie 50 y laptops equipadas…
-
Curiosidades
Kimi K3 en C: un modelo de 2.78 billones de parámetros corre en 8 GB de RAM
Un desarrollador logró ejecutar el modelo Kimi K3 de 2.78 billones de parámetros en una CPU común con…

Strata es un motor de inferencia gratuito y de código abierto que permite chatear, programar y trabajar con imágenes ejecutando modelos de IA directamente en tu PC, sin cuenta y sin enviar datos a la nube. Funciona como aplicación de escritorio o desde la terminal en Windows, Linux y Mac.
Lo más leído en Hardware
-
Comunicados de Prensa
Tecnología NVIDIA RTX llega con descuentos para jugar crear y explorar la IA en México
NVIDIA lanzó una campaña de descuentos en México con tarjetas gráficas GeForce RTX Serie 50 y laptops equipadas…
-
Curiosidades
Kimi K3 en C: un modelo de 2.78 billones de parámetros corre en 8 GB de RAM
Un desarrollador logró ejecutar el modelo Kimi K3 de 2.78 billones de parámetros en una CPU común con…
Lo más leído
-
 Desarrolladores
Gemini 4 Carbon ya está disponible para desarrolladores empresas y usuarios de Google
-
 Audio
Podcast ONE: 13 de noviembre de 2026
-
 Buen Fin
LG Electronics celebra El Buen Fin 2026 con descuentos de hasta 60% en su tienda en línea
-
 Android
Waydroid llega a los repositorios oficiales de Ubuntu 26.04 LTS
-
Curiosidades
Kimi K3 en C: un modelo de 2.78 billones de parámetros corre en 8 GB de RAM
-

 Apps11 años ago
AMPcast, la herramienta de Pandora que permite a los artistas grabar mensajes de audio directamente a sus seguidores
-
 Blogs5 años ago
Conoce los mejores sitios de Torrents para descargar todo tipo de contenidos
-
Android5 años ago
Aprende cómo usar Discord para ver películas con tus amigos
-
Arte y Cultura14 años ago
Colección de fondos de pantalla basados en Super Héroes
-

 Almacenamiento2 años ago
Cómo usar TeraBox: La guía definitiva para aprovechar 1 TB de almacenamiento en la nube
-
Diseño13 años ago
css3ps: plugin que convierte archivos PSD a CSS3
-
Apps9 años ago
Picturethat, app que usa la Realidad Aumentada para visualizar cómo quedarían los cuadros antes de colgarlos
-
Eventos Especiales14 años ago
Especial Día de la Madres: fondos de pantalla especiales para Mamá