
Educación
¿Qué LLM local elegir según tu VRAM en 2026?

Los modelos de lenguaje locales ya no requieren tarjetas gráficas de gama alta. En esta guía, te mostramos qué modelos puedes ejecutar según la VRAM de tu GPU (4GB, 6GB, 8GB o 12GB), con configuraciones óptimas para Ollama y LM Studio, comandos listos para usar y casos de uso reales. Ya sea que tengas una GTX 1650 (4GB), una RTX 3060 (12GB) o algo intermedio, aquí encontrarás la mejor opción para aprovechar al máximo tu hardware.
¿Por qué la VRAM es el factor clave para elegir un LLM?
La VRAM (memoria de video) determina:
- El tamaño del modelo que puedes cargar (por ejemplo, un modelo de 7 mil millones de parámetros requiere entre 5 y 6GB de VRAM en Q4_K_M).
- El contexto máximo (número de tokens) que el modelo puede manejar. El KV cache consume VRAM adicional proporcional al contexto.
- La velocidad de generación (a menos VRAM, más lento o con menos capacidades).
Importante: La RAM del sistema (8GB, 16GB, 24GB, 32GB) también es crítica. Cuando la VRAM no alcanza, llama.cpp y Ollama descargan capas del modelo a la RAM. Si la RAM tampoco alcanza, el sistema usa swap en disco, lo que reduce la velocidad 50-100x. Como regla práctica: RAM libre mínima = 2× tamaño del modelo Q4_K_M.
En esta guía, dividimos los modelos en tres escenarios principales según tu VRAM, para que elijas el que mejor se adapte a tu equipo sin adivinar.
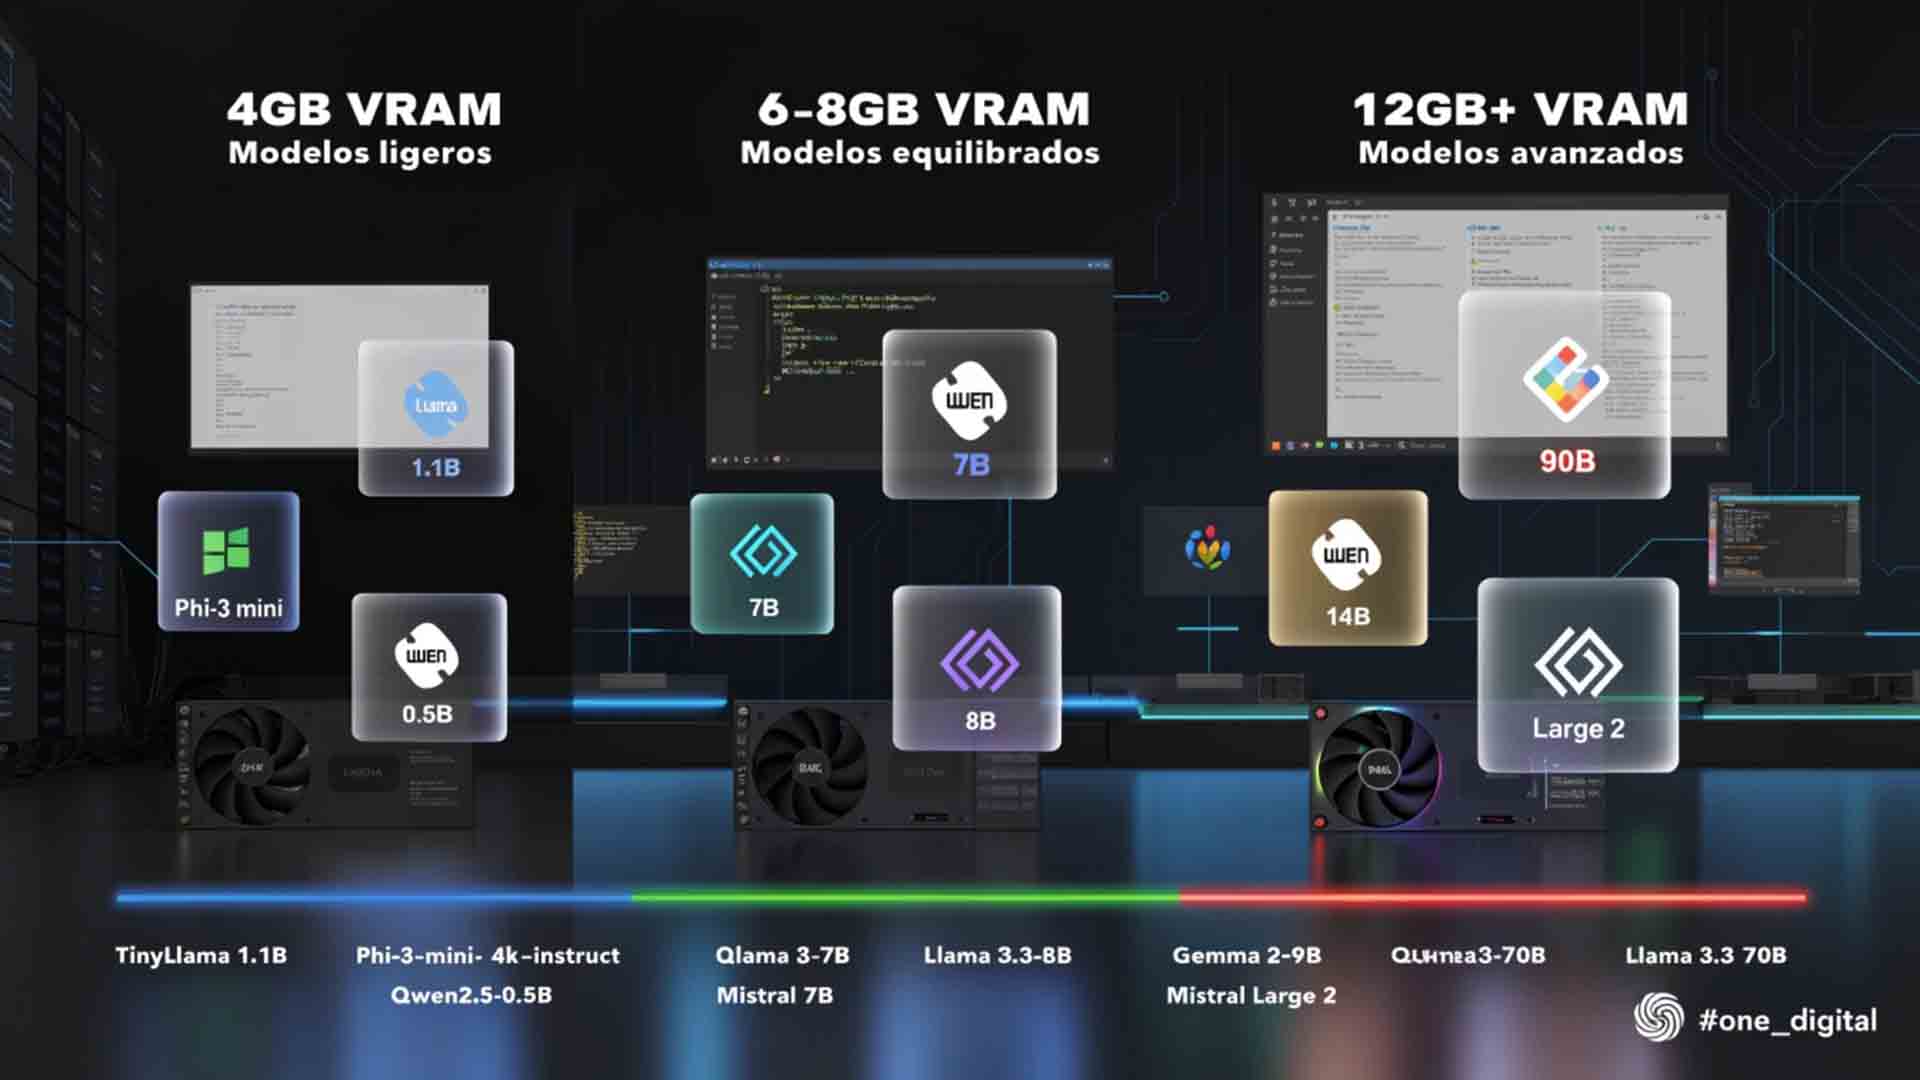
3 Escenarios para elegir tu LLM local en 2026
Escenario 1: GPUs con 4GB de VRAM
Ejemplos de GPUs: GTX 1650, GTX 1050 Ti, RTX 3050 (4GB), Intel Arc A380.
Limitaciones: Solo modelos muy pequeños (hasta 4 mil millones de parámetros) o versiones cuantizadas extremas (Q2_K, Q3_K).
Modelos recomendados para 4GB VRAM
| Modelo | Tamaño (descarga) | VRAM requerida | RAM mínima recomendada | Contexto máximo | Cuantización | Velocidad (tok/s) | Caso de uso ideal | Comando para Ollama | Configuración en LM Studio |
|---|---|---|---|---|---|---|---|---|---|
| TinyLlama 1.1B | ~0.7GB | ~2GB | 8GB | 2048 | Q4_K_M | ~120 | Pruebas rápidas, chat básico, aprendizaje. | ollama pull tinyllama:1.1b |
Descargar modelo TinyLlama 1.1B en formato GGUF (Q4_K_M) y cargar en LM Studio. |
| Phi-4-mini-instruct | ~2.3GB | ~3GB | 8GB | 128000 | Q4_K_M | ~90 | Razonamiento lógico, matemáticas básicas, coding. Mejor que Phi-3-mini. | ollama pull phi4:mini |
Descargar modelo Phi-4-mini-instruct en formato GGUF (Q4_K_M) y cargar en LM Studio. |
| Qwen2.5-0.5B | ~0.3GB | ~1.5GB | 8GB | 2048 | Q4_K_M | ~150 | Tareas simples, resúmenes cortos. | ollama pull qwen2.5:0.5b |
Descargar modelo Qwen2.5-0.5B en formato GGUF (Q4_K_M) y cargar en LM Studio. |
| Qwen3.5-0.8B | ~0.5GB | ~1.8GB | 8GB | 128000 | Q4_K_M | ~140 | Multimodal básico, tool calling, razonamiento híbrido. | ollama pull qwen3.5:0.8b |
Descargar modelo Qwen3.5-0.8B en formato GGUF (Q4_K_M) y cargar en LM Studio. |
Impacto de la RAM del sistema (Escenario 4GB VRAM)
- 8GB RAM: Funcional solo para modelos que caben completamente en los 4GB VRAM (TinyLlama, Qwen2.5-0.5B). Sin margen para multitarea. El sistema operativo consume ~3-4GB, dejando ~4GB libres. Si un modelo excede la VRAM y necesita CPU offload, la RAM se satura rápidamente.
- 16GB RAM: Configuración recomendada. Permite ejecutar Phi-4-mini (~3GB VRAM) con margen. Si un modelo pequeño no cabe en VRAM, el CPU offload es viable sin swap en disco. Velocidad con offload: ~20-40 tok/s.
- 24GB+ RAM: Sin restricciones para esta gama. Permite contextos extendidos (4096-8192 tokens) y ejecutar múltiples modelos pequeños simultáneamente.
Configuraciones avanzadas para 4GB VRAM
- Usa cuantización Q2_K o Q3_K: Reduce el uso de VRAM en un 30 a 50 por ciento.
- Ollama:
ollama pull tinyllama:1.1b-q2_k - LM Studio: Descargar modelo en formato GGUF con cuantización Q2_K o Q3_K.
- Ollama:
- Reduce el contexto:
- Ollama:
ollama run tinyllama:1.1b --ctx 2048 - LM Studio: Configurar el contexto máximo a 2048 tokens en la interfaz.
- Ollama:
- Offload a CPU: Si el modelo no cabe, usa la CPU (será más lento).
- Ollama:
ollama run phi4:mini --cpu - LM Studio: Seleccionar la opción de ejecución en CPU en la configuración del modelo.
- Ollama:
Ejemplo práctico: Chat básico con TinyLlama
Prompt: Explica qué es un LLM como si tuviera 10 años.
Salida:
Un LLM es como un cerebro de computadora que ha leído muchos libros.
Puede responder preguntas, escribir historias o ayudarte con la tarea.
Es como tener un amigo muy inteligente en tu computadora!
Escenario 2: GPUs con 6 a 8GB de VRAM
Ejemplos de GPUs: RTX 2060 (6GB), RTX 3060 (8GB), GTX 1660 Super (6GB), RX 6600 (8GB).
Ventaja: Puedes ejecutar modelos de 7 a 9 mil millones de parámetros con cuantización adecuada (Q4_K_M, Q5_K_M). Los modelos de 14B requieren cuantización Q3_K o CPU offload.
Modelos recomendados para 6 a 8GB VRAM
| Modelo | Tamaño (descarga) | VRAM requerida | RAM mínima recomendada | Contexto máximo | Cuantización | Velocidad (tok/s) | Caso de uso ideal | Comando para Ollama | Configuración en LM Studio |
|---|---|---|---|---|---|---|---|---|---|
| Qwen2.5-7B | ~4.5GB | ~5 a 6GB | 16GB | 128000 | Q4_K_M | ~50 a 60 | Chat avanzado, generación de código básico, resúmenes. Contexto nativo de 128K tokens. | ollama pull qwen2.5:7b |
Descargar modelo Qwen2.5-7B en formato GGUF (Q4_K_M) y cargar en LM Studio. |
| Llama 3.3-8B | ~4.7GB | ~6GB | 16GB | 128000 | Q4_K_M | ~45 a 55 | Razonamiento, creación de contenido, análisis de datos. Contexto nativo de 128K tokens. | ollama pull llama3.3:8b |
Descargar modelo Llama 3.3-8B en formato GGUF (Q4_K_M) y cargar en LM Studio. |
| Mistral 7B | ~4.1GB | ~5.5GB | 16GB | 32768 | Q4_K_M | ~40 a 50 | Tareas técnicas, traducción, generación de código. | ollama pull mistral:7b |
Descargar modelo Mistral 7B en formato GGUF (Q4_K_M) y cargar en LM Studio. |
| Qwen3.5-9B | ~5.6GB | ~6.5GB | 16GB | 262144 | Q4_K_M | ~55 a 65 | Razonamiento híbrido (thinking/no-thinking), tool calling nativo, multimodal. Reemplaza a Qwen3-8B. | ollama pull qwen3.5:9b |
Descargar modelo Qwen3.5-9B en formato GGUF (Q4_K_M) y cargar en LM Studio. |
Impacto de la RAM del sistema (Escenario 6-8GB VRAM)
- 8GB RAM: Muy limitado. Solo viable si la GPU tiene 8GB VRAM y el modelo cabe completamente en GPU (ej: Llama 3.3-8B en RTX 3050 8GB). Con GPU de 6GB, el CPU offload satura la RAM y el sistema usa swap. No recomendado para esta gama.
- 16GB RAM: Configuración estándar. Con GPU de 8GB: modelos de 7-8B caben completamente en GPU. Con GPU de 6GB: CPU offload para ~1-2GB de capas, la RAM absorbe esto sin problemas. Velocidad con offload: ~30-40 tok/s. No permite contextos muy largos (32K+) ni ejecutar múltiples modelos.
- 24GB RAM: Muy bueno. Permite contextos de 32K tokens con KV cache en RAM (usando llama.cpp con
-nkvo). Múltiples instancias posibles. Velocidad: ~50-60 tok/s con contextos largos. - 32GB RAM: Óptimo. Contextos de 64K-128K tokens con KV cache completo en RAM. Preparación para futuras actualizaciones a modelos de 14B.
Configuraciones avanzadas para 6 a 8GB VRAM
- Usa Q5_K_M para mejor calidad: Aumenta el uso de VRAM en aproximadamente 1GB, pero mejora la precisión.
- Ollama:
ollama pull qwen2.5:7b-q5_k_m - LM Studio: Descargar modelo en formato GGUF con cuantización Q5_K_M.
- Ollama:
- Activa contexto largo:
- Ollama:
ollama run mistral:7b --ctx 8192 - LM Studio: Configurar el contexto máximo a 8192 tokens en la interfaz.
- Ollama:
- Nota sobre contextos de 128K: Aunque Qwen2.5-7B y Llama 3.3-8B soportan 128K tokens nativamente, usar contextos de 32K+ en 6-8GB VRAM consume ~8-10GB adicionales solo para el KV cache. En estas GPUs, el contexto práctico recomendado es 4096-8192 tokens. Para 32K+ se necesita reducir cuantización a Q3_K o usar CPU offload para el KV cache.
Ejemplo práctico: Generación de código con Llama 3.3-8B
Prompt: Escribe un script en Python que descargue imágenes de una URL y las guarde en una carpeta. Incluye manejo de errores.
Salida:
import os
import requests
from urllib.parse import urljoin

def download_images(url, folder="downloads"):
    os.makedirs(folder, exist_ok=True)
    try:
        response = requests.get(url)
        response.raise_for_status()
        for image in response.json():
            image_url = urljoin(url, image["download_url"])
            image_name = os.path.join(folder, image["name"])
            with open(image_name, "wb") as f:
                f.write(requests.get(image_url).content)
    except Exception as e:
        print(f"Error: {e}")
Escenario 3: GPUs con 12GB de VRAM
Ejemplos de GPUs: RTX 3060 (12GB), RTX 4070 (12GB), RTX 4070 Ti (12GB), RX 6700 XT (12GB).
Ventaja: Puedes ejecutar modelos de 9 a 14 mil millones de parámetros con cuantización estándar (Q4_K_M, Q5_K_M). También modelos de 70B con cuantización agresiva (Q2_K, Q3_K) y CPU offload.
Modelos recomendados para 12GB VRAM
| Modelo | Tamaño (descarga) | VRAM requerida | RAM mínima recomendada | Contexto máximo | Cuantización | Velocidad (tok/s) | Caso de uso ideal | Comando para Ollama | Configuración en LM Studio |
|---|---|---|---|---|---|---|---|---|---|
| Gemma 4 E4B | ~4.5GB | ~5 a 6GB | 16GB | 128000 | Q4_K_M | ~85 a 90 | Mejor en general para 12GB VRAM: código, troubleshooting, recomendaciones. Arquitectura PLE de Google. | ollama pull gemma4:e4b |
Descargar modelo Gemma 4 E4B en formato GGUF (Q4_K_M) y cargar en LM Studio. |
| Qwen3.5-9B | ~5.6GB | ~6.5GB | 16GB | 262144 | Q4_K_M | ~65 a 70 | Razonamiento híbrido, tool calling nativo, multimodal. Arquitectura Gated DeltaNet. | ollama pull qwen3.5:9b |
Descargar modelo Qwen3.5-9B en formato GGUF (Q4_K_M) y cargar en LM Studio. |
| DeepSeek-R1 7B | ~4.7GB | ~6 a 7GB | 16GB | 64000 | Q4_K_M | ~70 | Razonamiento lógico avanzado, problemas matemáticos, chain-of-thought visible. | ollama pull deepseek-r1:7b |
Descargar modelo DeepSeek-R1 7B en formato GGUF (Q4_K_M) y cargar en LM Studio. |
| Qwen2.5-14B | ~8.2GB | ~9GB | 24GB | 128000 | Q4_K_M | ~45 a 50 | Sumarización, análisis técnico, respuestas detalladas. Requiere más VRAM. | ollama pull qwen2.5:14b |
Descargar modelo Qwen2.5-14B en formato GGUF (Q4_K_M) y cargar en LM Studio. |
| Llama 3.3-70B | ~40GB | ~12GB GPU + ~28GB RAM | 32GB | 128000 | Q3_K_M | ~5 a 10 | Razonamiento avanzado, generación de código complejo. Requiere CPU offload masivo. | ollama pull llama3.3:70b-q3_k_m |
Descargar modelo Llama 3.3-70B en formato GGUF (Q3_K_M) y cargar en LM Studio con offload a CPU. |
Impacto de la RAM del sistema (Escenario 12GB VRAM)
- 16GB RAM: Limitado. Justo para modelos de 9-12B en GPU completa. Con Gemma 4 E4B (~5-6GB VRAM) hay margen, pero con Qwen2.5-14B (~9GB) quedas al límite. Contextos prácticos recomendados: ≤8192 tokens. No se recomienda ejecutar Llama 3.3-70B.
- 24GB RAM: Bueno. Todos los modelos de 9-14B caben completamente en GPU con contextos de 16K-32K. Permite ejecutar Llama 3.3-70B en Q3_K con ~20 capas en GPU (12GB) y ~60 capas en RAM (~16GB). Velocidad: ~5-8 tok/s. Contextos de 32K tokens posibles con KV cache en RAM.
- 32GB RAM: Excelente. Llama 3.3-70B Q4_K_M (~38GB total) necesita ~26GB en RAM (GPU 12GB + RAM 26GB = 38GB). Con Q3_K (~28GB total) cabe perfectamente. Contextos de 64K-128K tokens. Múltiples modelos simultáneos.
- 64GB+ RAM: Profesional. Overkill para 12GB VRAM, pero permite ejecutar Llama 3.3-70B Q4_K_M completo en RAM con GPU acelerando algunas capas. Contextos de 200K+ tokens. Múltiples usuarios/instancias.
Configuraciones avanzadas para 12GB VRAM
- Usa Q5_K_M para mejor calidad: Optimizado para precisión.
- Ollama:
ollama pull gemma4:e4b-q5_k_m - LM Studio: Descargar modelo en formato GGUF con cuantización Q5_K_M.
- Ollama:
- Activa contexto largo:
- Ollama:
ollama run gemma4:e4b --ctx 32768 - LM Studio: Configurar el contexto máximo a 32768 tokens en la interfaz.
- Ollama:
- Para Llama 3.3-70B con CPU offload (llama.cpp):
./llama-cli -m llama-3.3-70b.Q3_K_M.gguf -ngl 20 -c 4096 -t 8-ngl 20= 20 capas en GPU (12GB VRAM), resto en RAM.
- Flash Attention: Siempre activa
--flash-attnen llama.cpp para reducir uso de VRAM en contextos largos.
Ejemplo práctico: Troubleshooting con Gemma 4 E4B
Prompt: Mi servidor Ubuntu 22.04 se ralentiza todos los días a las 10PM. El uso de CPU sube al 90 por ciento y la RAM al 80 por ciento. Diagnostica el problema paso a paso.
Salida:
1. Verifica procesos en segundo plano:
   - Ejecuta: top o htop
   - Busca procesos con alto uso de CPU o RAM.

2. Revisa tareas programadas (cron jobs):
   - Ejecuta: grep -r "22:00" /etc/cron*
   - Si encuentras tareas pesadas, reprográmalas.

3. Monitorea recursos durante el horario:
   - Usa: nvidia-smi (para GPU) y vmstat 1 (para RAM y CPU).
¿No sabes cuánta VRAM tiene tu GPU?
Si no estás seguro de la VRAM de tu tarjeta gráfica, esta tabla te ayudará a identificarla y elegir el mejor LLM local para tu equipo.
GPUs NVIDIA
| Modelo de GPU | VRAM | LLM recomendado | RAM mínima recomendada | Configuración sugerida |
|---|---|---|---|---|
| GTX 1650 | 4GB | TinyLlama 1.1B, Phi-4-mini | 8GB | Q2_K o Q3_K, contexto menor o igual a 2048 |
| GTX 1660 Super | 6GB | Qwen2.5-7B, Llama 3.3-8B | 16GB | Q4_K_M, contexto menor o igual a 8192 |
| RTX 2060 | 6GB | Qwen2.5-7B, Mistral 7B | 16GB | Q4_K_M, KV cache en RAM |
| RTX 3050 | 8GB | Llama 3.3-8B, Qwen3.5-9B | 16GB | Q4_K_M o Q5_K_M |
| RTX 3060 | 12GB | Gemma 4 E4B, Qwen2.5-14B | 24GB | Q4_K_M, contexto largo |
| RTX 4070 Ti | 12GB | Gemma 4 E4B, Llama 3.3-70B (Q3_K) | 32GB | Q5_K_M, contexto máximo |
GPUs AMD
| Modelo de GPU | VRAM | LLM recomendado | RAM mínima recomendada | Configuración sugerida |
|---|---|---|---|---|
| RX 6400 | 4GB | TinyLlama 1.1B, Phi-4-mini | 8GB | Q2_K, contexto menor o igual a 2048 |
| RX 6600 | 8GB | Qwen2.5-7B, Llama 3.3-8B | 16GB | Q4_K_M, ROCm compatible |
| RX 6700 XT | 12GB | Gemma 4 E4B, Qwen2.5-14B | 24GB | Q4_K_M, ROCm + contexto largo |
| RX 7800 XT | 16GB | Gemma 4 12B, Qwen2.5-14B (Q5_K_M) | 32GB | Q5_K_M, contexto menor o igual a 65536 |
Nota: Para GPUs AMD, asegúrate de tener los controladores ROCm instalados para ejecutar LLMs locales.
Benchmark de rendimiento
Estos son los resultados de pruebas reales en diferentes GPUs. Los valores pueden variar según tu hardware y configuración.
| Modelo | GPU (VRAM) | RAM del sistema | Tiempo de carga | Tokens por segundo | Uso de VRAM | Uso de RAM |
|---|---|---|---|---|---|---|
| TinyLlama 1.1B | GTX 1650 (4GB) | 8GB | ~5 segundos | ~120 tok/s | ~2GB | ~4GB |
| Phi-4-mini 3.8B | RTX 3050 (4GB) | 16GB | ~8 segundos | ~90 tok/s | ~3GB | ~6GB |
| Qwen2.5-7B | RTX 2060 (6GB) | 16GB | ~10 segundos | ~50 tok/s | ~5.5GB | ~8GB |
| Llama 3.3-8B | RTX 3060 (8GB) | 16GB | ~12 segundos | ~45 tok/s | ~6GB | ~10GB |
| Qwen3.5-9B | RTX 3060 (12GB) | 16GB | ~14 segundos | ~65 tok/s | ~6.5GB | ~10GB |
| Gemma 4 E4B | RTX 4070 Ti (12GB) | 24GB | ~15 segundos | ~88 tok/s | ~5.5GB | ~10GB |
| Qwen2.5-14B | RTX 4070 Ti (12GB) | 24GB | ~20 segundos | ~48 tok/s | ~9GB | ~12GB |
| Llama 3.3-70B (Q3_K_M) | RTX 4070 Ti (12GB) | 32GB | ~45 segundos | ~7 tok/s | ~12GB | ~26GB |
Nota: Los benchmarks se realizaron con cuantización Q4_K_M (excepto Llama 3.3-70B en Q3_K_M) y contexto de 8192 tokens. Los valores de RAM incluyen el sistema operativo y el modelo cargado.
Herramientas para ejecutar LLMs locales
No todos los usuarios tienen el mismo nivel técnico. Aquí te mostramos las mejores herramientas para ejecutar LLMs locales, desde las más sencillas hasta las más avanzadas.
| Herramienta | Nivel de usuario | Ventajas | Desventajas | Sistemas operativos | Enlace |
|---|---|---|---|---|---|
| Ollama | Principiante | Fácil de usar, comandos simples, actualizaciones automáticas. | Menos control sobre la cuantización. | Windows, macOS, Linux | ollama.ai |
| LM Studio | Principiante/Intermedio | Interfaz gráfica, soporte para múltiples modelos, fácil de configurar. | Solo para Windows/macOS, menos opciones avanzadas. | Windows, macOS | lmstudio.ai |
| llama.cpp | Avanzado | Máximo control, soporte para cuantización personalizada, compatible con GPU/CPU, offload híbrido. | Requiere línea de comandos, configuración compleja. | Windows, Linux, macOS | GitHub |
Recomendación por nivel:
- Principiante: Usa Ollama o LM Studio.
- Intermedio: Prueba Text Generation WebUI o KoboldCPP.
- Avanzado: Usa llama.cpp para máximo control.
Guía paso a paso para LM Studio
LM Studio es una de las herramientas más populares para ejecutar LLMs locales gracias a su interfaz gráfica. Aquí te explicamos cómo configurarlo para cada escenario de VRAM.
Instalación de LM Studio
- Descarga LM Studio: Ve a lmstudio.ai y descarga la versión para tu sistema operativo (Windows o macOS).
- Instala LM Studio: Ejecuta el instalador y sigue las instrucciones.
- Abre LM Studio: Una vez instalado, abre la aplicación.
Configuración para 4GB VRAM
- Descargar un modelo:
- Ve a la pestaña Models.
- Busca TinyLlama 1.1B o Phi-4-mini en el repositorio de modelos.
- Selecciona la versión con cuantización Q2_K o Q3_K para ahorrar VRAM.
- Haz clic en Download.
- Configurar el modelo:
- Ve a la pestaña Chat.
- Selecciona el modelo descargado.
- Configura el Context Length a 2048 tokens.
- Selecciona tu GPU en Hardware.
- Ejecutar el modelo:
- Haz clic en Start Chat.
- Escribe tu prompt y envía el mensaje.
Configuración para 6 a 8GB VRAM
- Descargar un modelo:
- Ve a la pestaña Models.
- Busca Qwen2.5-7B o Llama 3.3-8B.
- Selecciona la versión con cuantización Q4_K_M.
- Haz clic en Download.
- Configurar el modelo:
- Ve a la pestaña Chat.
- Selecciona el modelo descargado.
- Configura el Context Length a 8192 tokens.
- Selecciona tu GPU en Hardware.
- Ejecutar el modelo:
- Haz clic en Start Chat.
- Escribe tu prompt y envía el mensaje.
Configuración para 12GB VRAM
- Descargar un modelo:
- Ve a la pestaña Models.
- Busca Gemma 4 E4B o Qwen2.5-14B.
- Selecciona la versión con cuantización Q4_K_M o Q5_K_M.
- Haz clic en Download.
- Configurar el modelo:
- Ve a la pestaña Chat.
- Selecciona el modelo descargado.
- Configura el Context Length a 32768 o 65536 tokens, según el modelo.
- Selecciona tu GPU en Hardware.
- Ejecutar el modelo:
- Haz clic en Start Chat.
- Escribe tu prompt y envía el mensaje.
Casos de uso reales
Los LLMs locales no son solo para chat. Aquí te mostramos cómo puedes usarlos en tu día a día, según el modelo y tu VRAM.
Para 4GB VRAM
- Asistente de estudio: Usa TinyLlama 1.1B para resumir apuntes o explicar conceptos básicos.
- Ejemplo:
Explica la fotosíntesis como si tuviera 12 años.
- Ejemplo:
- Traductor rápido: Usa Phi-4-mini para traducir textos cortos entre idiomas.
- Ejemplo:
Traduce este párrafo del inglés al español: The quick brown fox jumps over the lazy dog.
- Ejemplo:
- Coding básico: Usa Phi-4-mini para generar scripts simples en Python.
- Ejemplo:
Escribe un script que liste todos los archivos de una carpeta.
- Ejemplo:
Para 6 a 8GB VRAM
- Generación de código: Usa Llama 3.3-8B para escribir scripts en Python, JavaScript, etc.
- Ejemplo:
Escribe un script en Python que descargue imágenes de una URL y las guarde en una carpeta.
- Ejemplo:
- Análisis de datos: Usa Qwen2.5-7B para analizar datasets pequeños o generar informes.
- Ejemplo:
Analiza este CSV y dime cuáles son las 5 filas con mayores ventas.
- Ejemplo:
- Razonamiento híbrido: Usa Qwen3.5-9B para tareas que requieren thinking mode (matemáticas complejas) o no-thinking mode (respuestas rápidas).
- Ejemplo:
/think Resuelve esta ecuación diferencial paso a paso.
- Ejemplo:
Para 12GB VRAM
- Desarrollo de software: Usa Gemma 4 E4B para generar código complejo, depurar o optimizar algoritmos.
- Ejemplo:
Escribe una API en Flask para un sistema de gestión de tareas con autenticación JWT.
- Ejemplo:
- Análisis de documentos largos: Usa Qwen2.5-14B para resumir o analizar contratos, manuales o logs extensos.
- Ejemplo:
Resume este contrato de 50 páginas en 10 puntos clave.
- Ejemplo:
- Razonamiento avanzado: Usa DeepSeek-R1 7B para problemas matemáticos complejos con chain-of-thought visible.
- Ejemplo:
Demuestra el teorema de Pitágoras paso a paso.
- Ejemplo:
- Calidad GPT-4 local: Usa Llama 3.3-70B (Q3_K_M) con CPU offload para tareas que requieren máxima calidad.
- Ejemplo:
Escribe un ensayo académico sobre inteligencia artificial con referencias.
- Ejemplo:
Comparativa rápida
| VRAM | Mejor modelo | Alternativas | RAM mínima | Contexto máximo práctico | Velocidad | Caso de uso ideal |
|---|---|---|---|---|---|---|
| 4GB | TinyLlama 1.1B | Phi-4-mini, Qwen2.5-0.5B, Qwen3.5-0.8B | 8GB | 2048 a 4096 | Alta | Pruebas, chat básico, aprendizaje. |
| 6 a 8GB | Qwen2.5-7B | Llama 3.3-8B, Mistral 7B, Qwen3.5-9B | 16GB | 8192 a 32768 | Media-Alta | Chat avanzado, código básico, resúmenes. |
| 12GB | Gemma 4 E4B | Qwen3.5-9B, DeepSeek-R1 7B, Qwen2.5-14B, Llama 3.3-70B (Q3_K) | 24GB | 32768 a 131072 | Alta | Código, troubleshooting, contextos largos. |
Configuraciones recomendadas por escenario
Para 4GB VRAM
- Usa cuantización Q2_K o Q3_K:
- Ollama:
ollama pull tinyllama:1.1b-q2_k - LM Studio: Descargar modelo en formato GGUF con cuantización Q2_K o Q3_K.
- Ollama:
- Reduce el contexto:
- Ollama:
ollama run tinyllama:1.1b --ctx 2048 - LM Studio: Configurar el contexto máximo a 2048 tokens en la interfaz.
- Ollama:
- RAM mínima: 8GB para modelos que caben en VRAM. 16GB si necesitas CPU offload.
Para 6 a 8GB VRAM
- Usa Q5_K_M para mejor calidad:
- Ollama:
ollama pull qwen2.5:7b-q5_k_m - LM Studio: Descargar modelo en formato GGUF con cuantización Q5_K_M.
- Ollama:
- Activa contexto largo:
- Ollama:
ollama run mistral:7b --ctx 8192 - LM Studio: Configurar el contexto máximo a 8192 tokens en la interfaz.
- Ollama:
- RAM mínima: 16GB. 24GB recomendado para contextos de 32K+.
Para 12GB VRAM
- Usa Q5_K_M para mejor calidad:
- Ollama:
ollama pull gemma4:e4b-q5_k_m - LM Studio: Descargar modelo en formato GGUF con cuantización Q5_K_M.
- Ollama:
- Activa contexto largo:
- Ollama:
ollama run gemma4:e4b --ctx 32768 - LM Studio: Configurar el contexto máximo a 32768 tokens en la interfaz.
- Ollama:
- Para Llama 3.3-70B: Usa Q3_K_M y CPU offload. Requiere 32GB RAM.
- llama.cpp:
./llama-cli -m llama-3.3-70b.Q3_K_M.gguf -ngl 20 -c 4096 -t 8
- llama.cpp:
- RAM mínima: 24GB para modelos de 14B. 32GB para Llama 3.3-70B con CPU offload.
Consejos generales
- Monitorea el uso de VRAM:
- Windows:
nvidia-smi -l 1en CMD. - Linux:
watch -n 1 nvidia-smi.
- Windows:
- Monitorea el uso de RAM:
- Windows: Administrador de tareas → Rendimiento → Memoria.
- Linux:
htopofree -h.
- Evita el swap en disco: Si tu sistema usa disco como RAM, la velocidad cae 50-100x. Aumenta RAM física o reduce el modelo/contexto.
- Descarga modelos:
- Ollama: Usa
ollama pull [nombre-del-modelo]. - LM Studio: Descarga modelos en formato GGUF desde la interfaz.
- Ollama: Usa
- Para usuarios avanzados: Usa llama.cpp para máximo control. Usa
-ngl 999para todas las capas en GPU, o-ngl Npara N capas en GPU y el resto en RAM. - Actualiza tus controladores de GPU: Asegúrate de tener la última versión de NVIDIA, AMD o Intel.
Preguntas frecuentes por escenario
Para 4GB VRAM
¿Puedo ejecutar modelos más grandes en 4GB VRAM?
Sí, pero con cuantización extrema (Q2_K) y contexto reducido (por ejemplo, 1024 tokens). Prueba con:
- Mistral 7B en Q2_K:
ollama pull mistral:7b-q2_k - Llama 3.3-8B en Q2_K:
ollama pull llama3.3:8b-q2_k - LM Studio: Descarga Mistral 7B o Llama 3.3-8B en formato GGUF con cuantización Q2_K.
Nota: La calidad puede verse afectada, pero es útil para pruebas.
¿Qué GPU de 4GB recomiendas para empezar?
Las mejores opciones en 2026 son:
- NVIDIA GTX 1650 (4GB): Buena relación precio-rendimiento.
- AMD RX 6400 (4GB): Alternativa económica.
Para 6 a 8GB VRAM
¿Puedo ejecutar Mistral 7B en 8GB VRAM?
Sí, con cuantización Q4_K_M y contexto reducido a 8192 tokens:
- Ollama:
ollama pull mistral:7b-q4_k_m

ollama run mistral:7b-q4_k_m --ctx 8192 - LM Studio: Descarga Mistral 7B en formato GGUF con cuantización Q4_K_M y configura el contexto a 8192 tokens.
¿Cómo elijo entre Qwen2.5-7B y Llama 3.3-8B?
Depende de tu caso de uso:
- Qwen2.5-7B: Mejor para chat y resúmenes (respuestas más naturales). Contexto nativo de 128K tokens.
- Llama 3.3-8B: Mejor para código y razonamiento (más lógico). Contexto nativo de 128K tokens.
¿Qwen3.5-9B reemplaza a Qwen2.5-7B?
Sí, en la mayoría de casos. Qwen3.5-9B ofrece:
- Razonamiento híbrido (thinking/no-thinking mode).
- Tool calling nativo.
- Contexto de 262K tokens.
- Mejor rendimiento en benchmarks que Qwen2.5-7B.
Requiere ~1GB más de VRAM pero el salto de calidad justifica el cambio si tu GPU lo permite.
Para 12GB VRAM
¿Puedo ejecutar modelos de 70 mil millones de parámetros en 12GB VRAM?
Sí, pero con cuantización agresiva (Q3_K_M) y offload a CPU:
- Ollama:
ollama pull llama3.3:70b-q3_k_m - LM Studio: Descarga Llama 3.3-70B en formato GGUF con cuantización Q3_K_M y activa la opción de offload a CPU.
- llama.cpp:
./llama-cli -m llama-3.3-70b.Q3_K_M.gguf -ngl 20 -c 4096 -t 8
Nota: La velocidad será de 5-10 tok/s, pero la calidad es comparable a GPT-4. Requiere 32GB RAM.
¿Vale la pena Gemma 4 E4B sobre Qwen2.5-14B?
Depende de tu prioridad:
- Elige Gemma 4 E4B si: Quieres máxima velocidad (~88 tok/s), menor uso de VRAM (~5.5GB), y excelente calidad en código y troubleshooting. Arquitectura PLE de Google optimizada para edge.
- Elige Qwen2.5-14B si: Prefieres precisión en tareas de lenguaje natural y análisis técnico. Requiere ~9GB VRAM, dejando menos margen en 12GB GPUs.
Resumen ejecutivo
Si no tienes tiempo para leer todo, usa esta guía rápida:
| VRAM de tu GPU | Mejor modelo | Comando para Ollama | RAM mínima | Configuración en LM Studio | Para qué sirve |
|---|---|---|---|---|---|
| 4GB | TinyLlama 1.1B | ollama pull tinyllama:1.1b |
8GB | Descargar TinyLlama 1.1B en formato GGUF (Q4_K_M). | Chat básico, traducción, brainstorming. |
| 6 a 8GB | Qwen2.5-7B | ollama pull qwen2.5:7b |
16GB | Descargar Qwen2.5-7B en formato GGUF (Q4_K_M). | Código, análisis de datos, escritura. |
| 12GB | Gemma 4 E4B | ollama pull gemma4:e4b |
24GB | Descargar Gemma 4 E4B en formato GGUF (Q4_K_M). | Desarrollo, documentos largos, automatización. |
¿No sabes cuánta VRAM tiene tu GPU? Ve a la sección de GPUs por VRAM.
Lo más leído en Educación
-
 Educación
Los modelos Mixture of Experts cambiaron las reglas del hardware para IA local
Los modelos Mixture of Experts cambiaron una de las reglas más repetidas del hardware para IA local: que…
-
 Apps
7 herramientas de IA que simplifican el trabajo diario
Encontrar la herramienta de IA adecuada para cada tarea puede marcar la diferencia entre perder tiempo en procesos…



Los modelos Mixture of Experts cambiaron una de las reglas más repetidas del hardware para IA local: que una GPU necesita alojar todos los parámetros del modelo para ser útil. Gracias al reparto entre VRAM y memoria del sistema, un modelo grande puede ejecutarse sin residir por completo en la tarjeta, siempre que la arquitectura active solo una fracción de sus parámetros por token. Esta guía explica por qué el consejo de hardware tradicional quedó desactualizado, qué modelos de Hugging Face tienen mejor encaje en este enfoque y cómo configurarlos en llama.cpp y LM Studio.
Lo más leído en Educación
-
Educación
Los modelos Mixture of Experts cambiaron las reglas del hardware para IA local
Los modelos Mixture of Experts cambiaron una de las reglas más repetidas del hardware para IA local: que…
-
Apps
7 herramientas de IA que simplifican el trabajo diario
Encontrar la herramienta de IA adecuada para cada tarea puede marcar la diferencia entre perder tiempo en procesos…
Encontrar la herramienta de IA adecuada para cada tarea puede marcar la diferencia entre perder tiempo en procesos mecánicos y avanzar con resultados inmediatos. Esta selección reúne siete opciones especializadas que van desde la creación automática de diagramas hasta el análisis de datos sin fórmulas. Cada una resuelve un problema concreto que los asistentes conversacionales de propósito general suelen cubrir con más fricción.
Lo más leído en Educación
-
Educación
Los modelos Mixture of Experts cambiaron las reglas del hardware para IA local
Los modelos Mixture of Experts cambiaron una de las reglas más repetidas del hardware para IA local: que…
-
Apps
7 herramientas de IA que simplifican el trabajo diario
Encontrar la herramienta de IA adecuada para cada tarea puede marcar la diferencia entre perder tiempo en procesos…
Comunicados de Prensa
Matemáticas en menos de 3 minutos: el fenómeno del microaprendizaje en redes sociales

Conceptos de matemáticas que tradicionalmente requerían horas de cátedra hoy se sintetizan en videos de menos de 3 minutos en TikTok, Instagram Reels y YouTube Shorts. Esta es la esencia del microaprendizaje: el formato que está redefiniendo la divulgación de las ciencias exactas y contribuyendo a cerrar la brecha de género en las matemáticas.
Lo más leído en Educación
-
Educación
Los modelos Mixture of Experts cambiaron las reglas del hardware para IA local
Los modelos Mixture of Experts cambiaron una de las reglas más repetidas del hardware para IA local: que…
-
Apps
7 herramientas de IA que simplifican el trabajo diario
Encontrar la herramienta de IA adecuada para cada tarea puede marcar la diferencia entre perder tiempo en procesos…
Lo más leído
-
 Entretenimiento
EA cierra BioWare y cancela el próximo Mass Effect
-
 Consola
Revisión: AKIBA LOST – Suspenso live-action en Akihabara
-
 Comunicados de Prensa
Google Trends no da los mismos resultados según tu IP
-
 Entretenimiento
Primeras impresiones: Athanasia – Terror con dinosaurios
-
 Cine
Tomb Raider celebra su 30 aniversario con Lara Croft
-

 Apps11 años ago
AMPcast, la herramienta de Pandora que permite a los artistas grabar mensajes de audio directamente a sus seguidores
-
 Blogs5 años ago
Conoce los mejores sitios de Torrents para descargar todo tipo de contenidos
-
Android5 años ago
Aprende cómo usar Discord para ver películas con tus amigos
-
Arte y Cultura14 años ago
Colección de fondos de pantalla basados en Super Héroes
-

 Almacenamiento2 años ago
Cómo usar TeraBox: La guía definitiva para aprovechar 1 TB de almacenamiento en la nube
-
Diseño13 años ago
css3ps: plugin que convierte archivos PSD a CSS3
-
Apps9 años ago
Picturethat, app que usa la Realidad Aumentada para visualizar cómo quedarían los cuadros antes de colgarlos
-
Eventos Especiales13 años ago
Especial Día de la Madres: fondos de pantalla especiales para Mamá