

Desarrolladores
NVIDIA Nemotron 3.5 Lightning: Velocidad y precisión para agentes de IA de larga duración

NVIDIA Nemotron 3.5 Lightning es un modelo abierto de tipo Mixture of Experts (MoE) de 30B parámetros, con solo 3B parámetros activos, diseñado para optimizar la ejecución de tareas especializadas en agentes de IA de larga duración. Este modelo destaca por su capacidad para reducir costos y latencia en procesos como llamadas a herramientas, validación de resultados y delegación a subagentes, sin sacrificar precisión.
Con innovaciones en inferencia y entrenamiento, Nemotron 3.5 Lightning se posiciona como una solución ideal para sistemas de modelos, donde los modelos frontier gestionan la orquestación y planificación compleja, mientras que modelos más pequeños y eficientes, como este, se encargan de la ejecución de alto volumen.
¿Por qué Nemotron 3.5 Lightning es ideal para agentes de IA de larga duración?
Nemotron 3.5 Lightning es un modelo MoE personalizable que ofrece ejecución de alto volumen con baja latencia para agentes autónomos. Su diseño permite que un enrutador envíe cada token a solo algunos de sus muchos expertos, lo que significa que solo una fracción de los parámetros del modelo se ejecuta por token. Esto proporciona la capacidad de un modelo denso más grande, pero con el costo computacional de uno pequeño.
El modelo Mixture of Experts (MoE) utiliza un enrutador para activar solo los expertos necesarios por token, reduciendo el costo computacional sin sacrificar capacidad. Además, este modelo incluye técnicas probadas en la familia Nemotron 3, como:
- Decodificación especulativa: Predicción de múltiples tokens durante el entrenamiento, lo que mejora la optimización de la inferencia en diversos escenarios de servicio. La decodificación especulativa permite generar múltiples tokens en paralelo, mejorando la velocidad de inferencia hasta en un 4x.
- Entrenamiento optimizado para harness: Diseñado para herramientas populares como OpenClaw y Hermes Agent, permitiendo a los agentes realizar llamadas más precisas y reducir la latencia en tareas de alto volumen.
El resultado es un modelo construido para la ejecución enfocada, con alto volumen de llamadas y baja latencia, todo en un tamaño que puede implementarse desde un NVIDIA DGX Spark hasta un centro de datos.
¿Cómo adaptar Nemotron 3.5 Lightning a tus necesidades?
Los modelos de la clase Lightning son altamente personalizables. Al ser más pequeños, se ajustan más rápido, con menor costo y en hardware más modesto en comparación con sus contrapartes más grandes. Nemotron 3.5 Lightning se lanza con pesos, datos de entrenamiento y recetas bajo la licencia OpenMDW-1.1, lo que permite:
- Ajuste fino con LoRA o SFT completo usando NeMo Automodel y NeMo Megatron Bridge.
- Ejecución de aprendizaje por refuerzo y evaluaciones basadas en entornos con NeMo RL y NeMo Gym.
Esta versión incluye el conjunto de datos Nemotron-RL Agentic Terminal Pivot, un dataset abierto de aprendizaje por refuerzo agente utilizado para entrenar algunas de las capacidades de codificación de agentes.
¿Cómo enrutar el trabajo al modelo adecuado con NeMo Switchyard?
La orquestación y el enrutamiento de modelos ayudan a hacer que esta división del trabajo sea más accesible. Ahora están disponibles a través de NVIDIA NeMo Switchyard. Switchyard puede exponer Nemotron 3.5 Lightning como un objetivo de enrutamiento junto con modelos abiertos y cerrados, asegurando que cada solicitud llegue al modelo más capaz y eficiente para manejarla.
Los planes de enrutamiento pueden dirigirse hacia modelos frontier para tareas complejas, mientras que las solicitudes de ejecución se enrutan a Lightning, garantizando que los tokens se utilicen de manera eficiente y efectiva.
¿Cómo se desempeña Nemotron 3.5 Lightning en la frontera de Pareto entre precisión y velocidad?
Nemotron 3.5 Lightning ofrece una precisión líder a la mayor velocidad de salida en su clase, ganando la frontera de Pareto entre precisión y velocidad en el Artificial Analysis Intelligence Index. Este índice combina nueve evaluaciones para medir el rendimiento del modelo en tareas de agentes, codificación, razonamiento científico e inteligencia general.
En PinchBench, Nemotron 3.5 Lightning alcanza un 86% de precisión mientras completa 10,000 tareas un 30% más rápido que Qwen3.6 35B con una precisión similar. A diferencia de Nemotron 3 Ultra, que está optimizado para razonamiento complejo, Nemotron 3.5 Lightning se enfoca en la ejecución eficiente de tareas repetitivas, lo que lo hace ideal para aplicaciones como chatbots autónomos, asistentes virtuales y sistemas de automatización industrial.
¿Cómo logra Nemotron 3.5 Lightning velocidad sin comprometer la precisión?
Nemotron 3.5 Lightning logra velocidad y personalización sin sacrificar la precisión gracias a la decodificación especulativa y la cuantización.
Decodificación especulativa
Nemotron 3.5 Lightning está construido para generar tokens rápidamente y tiene la capacidad de generar múltiples tokens a través de la decodificación especulativa. Este es un proceso en el que el modelo, o modelo de borrador, redacta un número de tokens que luego son revisados de manera eficiente. Nemotron 3.5 Lightning pasó por una etapa de pretrainamiento dedicada para incorporar la predicción de múltiples tokens (MTP) en el modelo, al igual que Nemotron 3 Super y Ultra.
Además de MTP, se proporcionan dos modelos de borrador con Nemotron 3.5 Lightning: DSpark, recomendado para cargas de trabajo de inferencia en DGX Spark y cargas de trabajo de centros de datos con baja concurrencia. MTP es más adecuado para concurrencia media a alta, con la longitud óptima del borrador disminuyendo a medida que aumenta la concurrencia.
Cuantización
Nemotron 3.5 Lightning se envía con un punto de control NVFP4 junto con BF16, utilizando los mismos núcleos especializados NVFP4 que impulsan Nemotron 3 Ultra en las GPU NVIDIA Blackwell, Hopper y Ampere. NVFP4 es un formato de cuantización de 4 bits que mantiene la precisión mientras reduce el uso de memoria y el ancho de banda. El mismo archivo funciona igual de bien en centros de datos como en un DGX Spark de escritorio.
¿Por qué Nemotron 3.5 Lightning es ideal para la IA local?
Nemotron 3.5 Lightning hace que la IA agente sea accesible en sistemas locales, incluyendo NVIDIA Jetson, GeForce RTX 5090 y DGX Spark. NVIDIA ha trabajado con varios equipos, como EXO Labs, para comprender cómo este modelo se desempeña en DGX Spark.
Además, puedes ejecutar Nemotron 3.5 Lightning en un conjunto estándar de herramientas de la industria, como LM Studio, llama.cpp, Ollama y Unsloth.

Ecosistema de socios
Nemotron 3.5 Lightning cuenta con el apoyo de un ecosistema creciente de socios en áreas como post-training, personalización, implementación e inferencia, incluyendo:
- Post-entrenamiento: AgileRL, Applied Compute, Deep Cogito, distil labs, Fastino Labs, Locai Labs, Prime Intellect, Reasonable, Thinking Machines Lab, Thoughtworks, Trajectory, Uniphore.
- Software de inferencia: Ollama, Exo, Canonical, LM Studio, Unsloth.
- Harness y frameworks de agentes: Aible, Cline, Factory AI, Hermes Agent, Kilo Code, LangChain, LM Studio Bionic, OpenClaw, OpenCode, OpenHands, Pi.
- Plataformas de proveedores de servicios en la nube: Google Cloud Gemini Enterprise Agent Platform, MSFT Foundry, OCI Enterprise AI.
¿Cómo empezar a construir con Nemotron 3.5 Lightning?
Nemotron 3.5 Lightning es completamente abierto (pesos, datos y recetas), por lo que puedes adaptarlo a tus flujos de trabajo e implementarlo en cualquier lugar. Para comenzar, pruébalo en build.nvidia.com o a través de OpenRouter. Descarga los pesos desde Hugging Face y ModelScope.
¿Quieres profundizar?
- Lee el libro de cocina de Nemotron 3.5 Lightning.
- Implementa con las guías de implementación de vLLM, SGLang y TensorRT-LLM.
- Configura el enrutamiento con la documentación de Switchyard.
Lo más leído en Desarrolladores
-
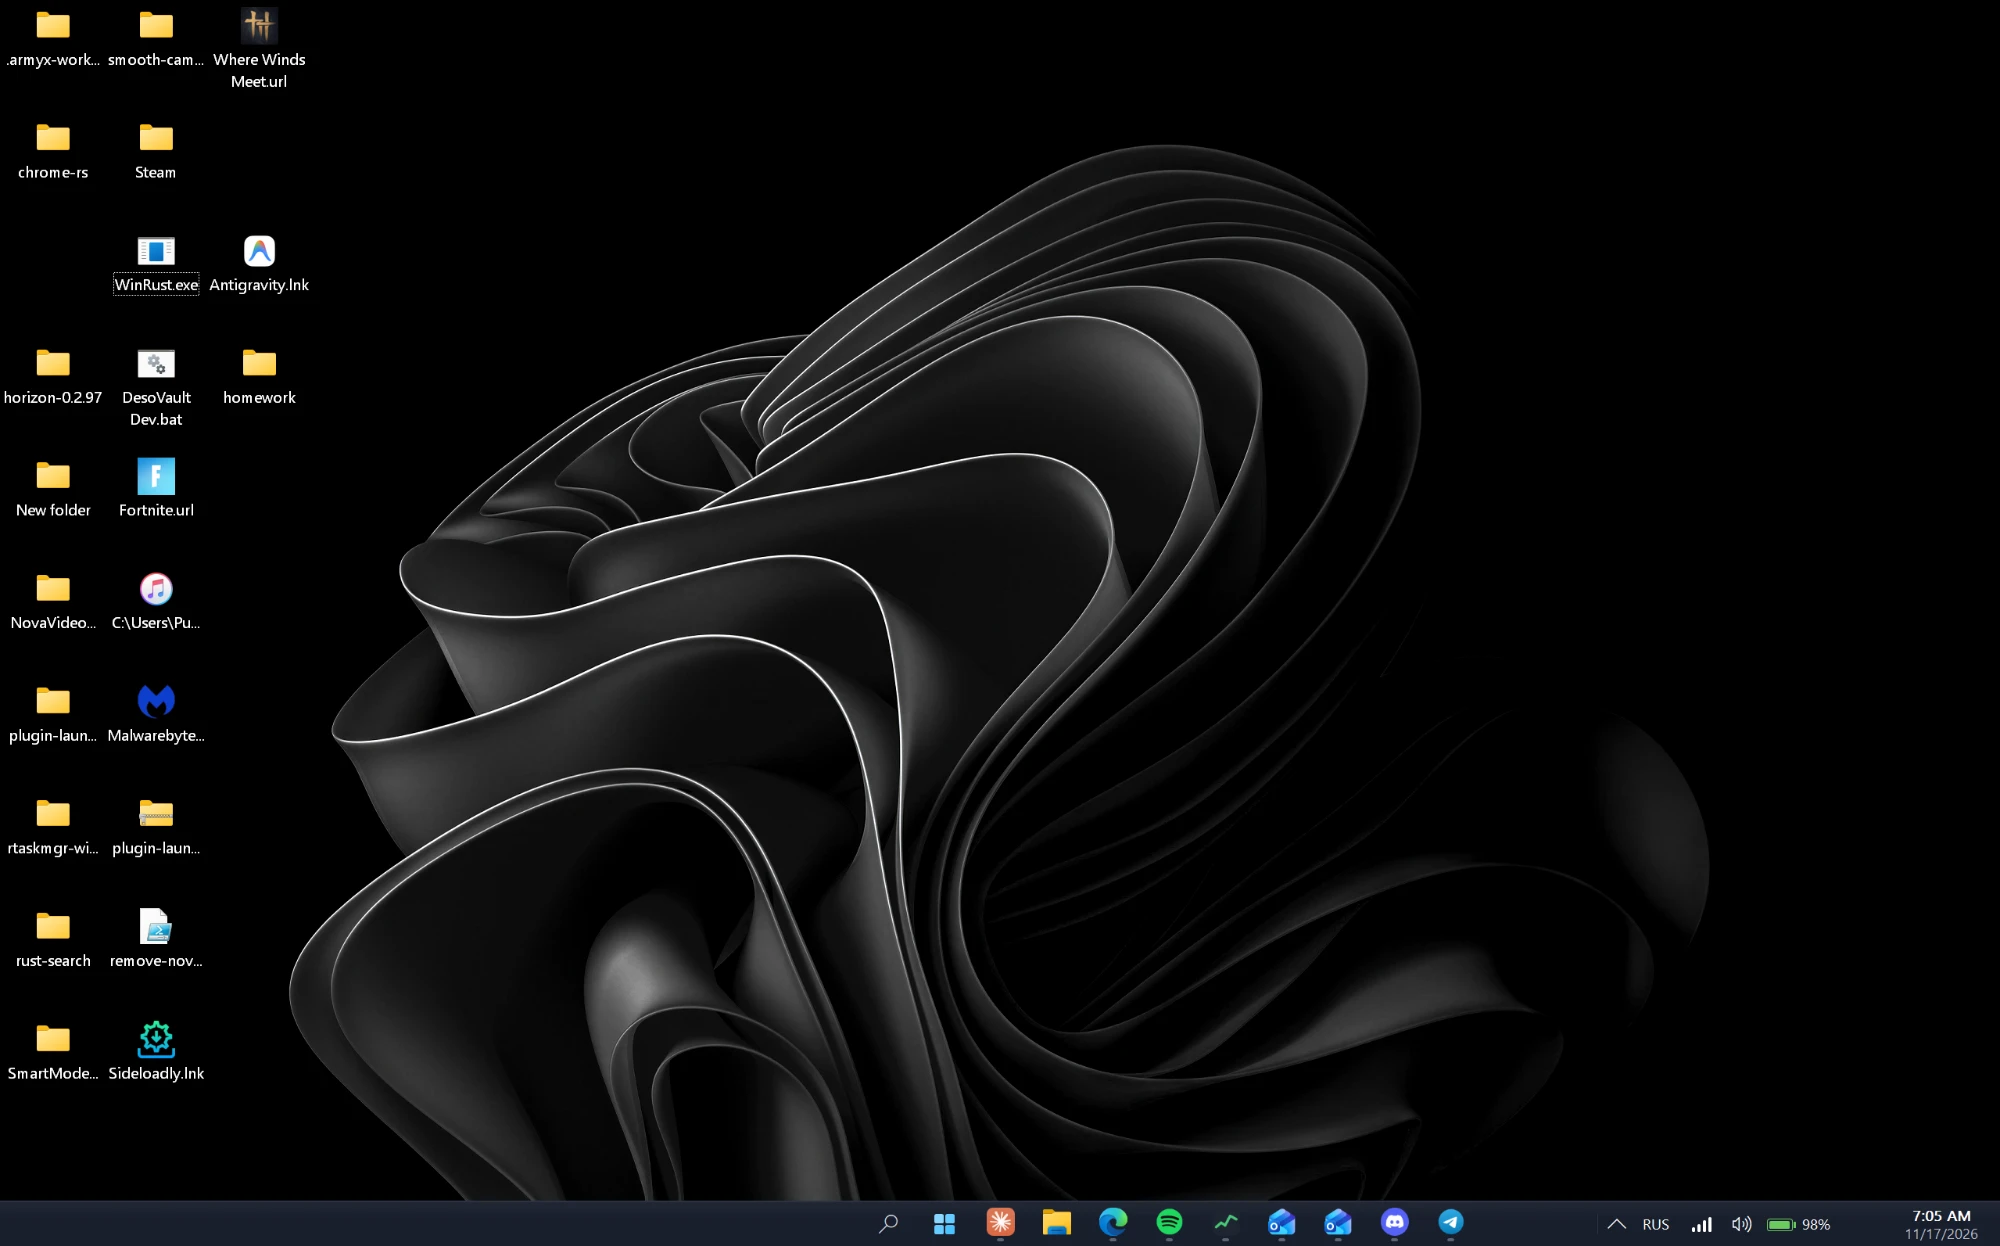 Actualización
WinRust quiere reemplazar partes de Windows con utilidades nativas en Rust
WinRust es un proyecto de código abierto que propone algo poco tímido: sustituir piezas centrales de Windows, como…
-
 Consola
GitCraft es un cliente visual de git ligero y multiplataforma escrito en Rust
GitCraft es un cliente visual de git de código abierto que busca simplificar la gestión de repositorios sin…





WinRust es un proyecto de código abierto que propone algo poco tímido: sustituir piezas centrales de Windows, como la barra de tareas, el Explorador de archivos, la búsqueda y el Administrador de tareas, por programas escritos en Rust. La promesa del repositorio es clara: menos peso, más velocidad y un entorno más controlable, aunque a cambio pide privilegios de administrador y toca funciones delicadas del sistema.
Lo más leído en Desarrolladores
-
Actualización
WinRust quiere reemplazar partes de Windows con utilidades nativas en Rust
WinRust es un proyecto de código abierto que propone algo poco tímido: sustituir piezas centrales de Windows, como…
-
Consola
GitCraft es un cliente visual de git ligero y multiplataforma escrito en Rust
GitCraft es un cliente visual de git de código abierto que busca simplificar la gestión de repositorios sin…
GitCraft es un cliente visual de git de código abierto que busca simplificar la gestión de repositorios sin renunciar a las funciones avanzadas. Está escrito en Rust con la biblioteca egui, funciona en Windows, Linux y macOS, y se apoya en la línea de comandos de git ya instalada. Su autor, el desarrollador Vancete, lo describe como ligero, rápido y libre de funciones de relleno.
Lo más leído en Desarrolladores
-
Actualización
WinRust quiere reemplazar partes de Windows con utilidades nativas en Rust
WinRust es un proyecto de código abierto que propone algo poco tímido: sustituir piezas centrales de Windows, como…
-
Consola
GitCraft es un cliente visual de git ligero y multiplataforma escrito en Rust
GitCraft es un cliente visual de git de código abierto que busca simplificar la gestión de repositorios sin…
Desarrolladores
Breakscale el simulador open source que rompe tu arquitectura de software en el navegador
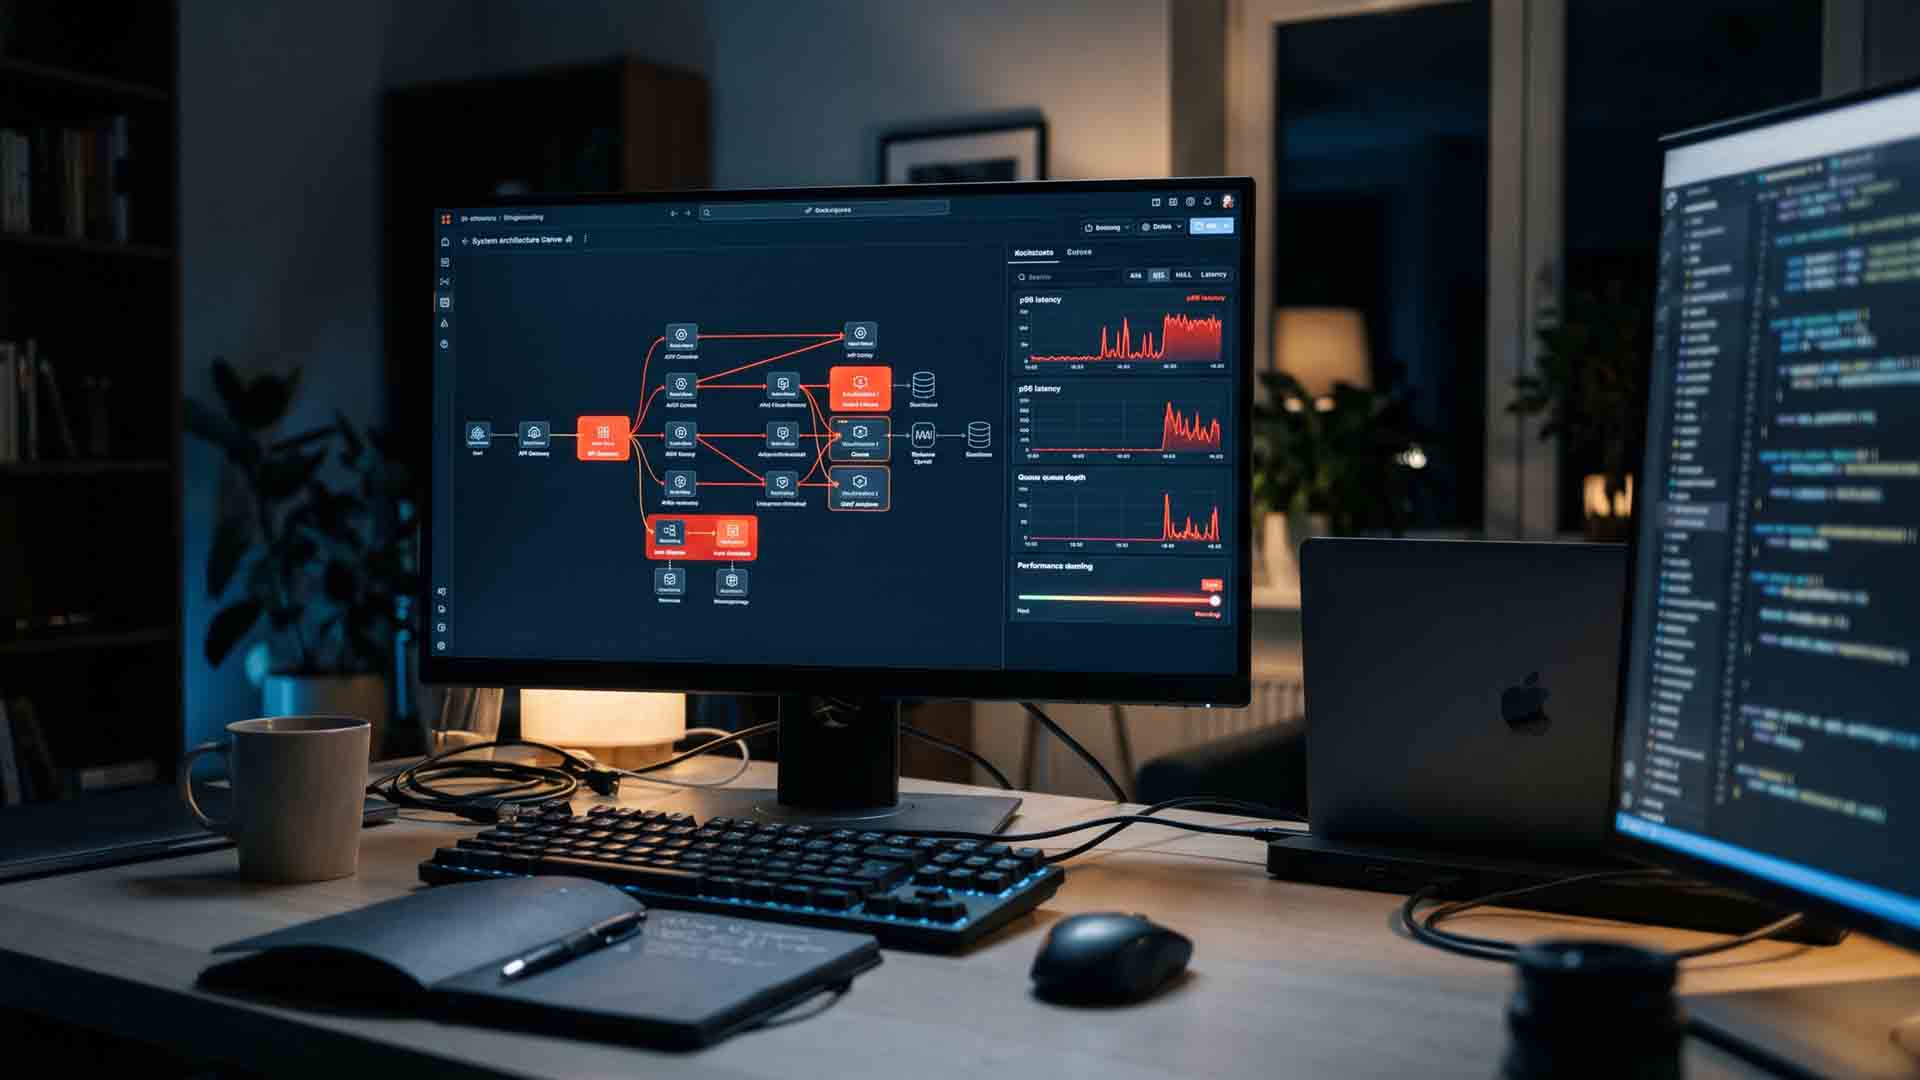
Breakscale es un simulador de diseño de sistemas de código abierto, con licencia MIT, que permite armar arquitecturas con 33 componentes, subir el tráfico hasta que algo falle y observar la caída con datos medidos por una simulación de eventos discretos. Funciona en el navegador, dentro de VS Code y como servidor MCP para asistentes de IA, sin cuentas y sin instalar nada.
Lo más leído en Desarrolladores
-
Actualización
WinRust quiere reemplazar partes de Windows con utilidades nativas en Rust
WinRust es un proyecto de código abierto que propone algo poco tímido: sustituir piezas centrales de Windows, como…
-
Consola
GitCraft es un cliente visual de git ligero y multiplataforma escrito en Rust
GitCraft es un cliente visual de git de código abierto que busca simplificar la gestión de repositorios sin…
Lo más leído
-
 Cine
Percy Jackson temporada 3: todo lo que hay que saber antes de verla
-
 Consola
GTA 6 corre a 260 fps con DLSS 5 gracias a un truco de PS5 Remote Play
-
 Comunicados de Prensa
Los juegos nuevos de Roblox que no te puedes perder este mes
-
 Herramientas
Tabstack Pilo: el agente de IA de Mozilla que automatiza tu navegador
-
 Consola
Podcast ONE: 20 de noviembre de 2026
-

 Apps11 años ago
AMPcast, la herramienta de Pandora que permite a los artistas grabar mensajes de audio directamente a sus seguidores
-
 Blogs5 años ago
Conoce los mejores sitios de Torrents para descargar todo tipo de contenidos
-
Android5 años ago
Aprende cómo usar Discord para ver películas con tus amigos
-
Arte y Cultura14 años ago
Colección de fondos de pantalla basados en Super Héroes
-

 Almacenamiento2 años ago
Cómo usar TeraBox: La guía definitiva para aprovechar 1 TB de almacenamiento en la nube
-
Diseño13 años ago
css3ps: plugin que convierte archivos PSD a CSS3
-
Apps9 años ago
Picturethat, app que usa la Realidad Aumentada para visualizar cómo quedarían los cuadros antes de colgarlos
-
Eventos Especiales14 años ago
Especial Día de la Madres: fondos de pantalla especiales para Mamá