
Herramientas
vLLM hace la inferencia de LLMs hasta 24 veces más rápida

Ingenieros e investigadores vinculados a la Universidad de California en Berkeley crearon vLLM, un motor de inferencia de código abierto capaz de multiplicar por 24 el rendimiento frente a Hugging Face Transformers. Su secreto no es un modelo nuevo, sino una idea tomada de los sistemas operativos: gestionar la memoria de la caché KV como si fuera memoria virtual. El proyecto ya supera las 95.000 estrellas en GitHub y reúne a más de 2.000 colaboradores.
La historia de vLLM resulta particularmente interesante porque no nació de un laboratorio privado, sino del Sky Computing Lab de UC Berkeley. Hoy es uno de los proyectos de inteligencia artificial open source más activos del mundo, mantenido por una comunidad que incluye a decenas de instituciones académicas y empresas. Y todo empezó con una pregunta incómoda: ¿por qué desperdiciamos tanta memoria de la GPU?
¿Qué es vLLM y por qué importa?
vLLM es un motor de inferencia y servicio de modelos de lenguaje de gran escala (LLM serving engine, es decir, la capa que ejecuta el modelo y responde solicitudes). Está diseñado para ofrecer alto rendimiento y una gestión eficiente de la memoria en GPU, compatible con cientos de arquitecturas publicadas en Hugging Face. Su desarrollo original se documentó en el paper Efficient Memory Management for Large Language Model Serving with PagedAttention, presentado en el Symposium on Operating Systems Principles (SOSP) de 2023 por Woosuk Kwon y colegas de Berkeley, y se distribuye bajo licencia Apache 2.0 (repositorio oficial en GitHub).
Para quienes ya exploraron alternativas a Ollama para ejecutar LLMs locales, vLLM es el nombre que aparece cuando el requisito deja de ser la comodidad y pasa a ser la concurrencia: miles de solicitudes simultáneas servidas con una API compatible con OpenAI.
¿Qué problema resuelve PagedAttention?
Para entender el avance hay que mirar el cuello de botella. Durante la generación de texto, los modelos de lenguaje mantienen una caché KV (KV Cache): un almacén de estados de atención que crece con cada token generado. Los sistemas de ejecución tradicionales reservan memoria contigua por adelantado y la fragmentan a medida que avanzan las solicitudes. Según el paper de SOSP 2023 y el blog oficial del proyecto, esos sistemas desperdician entre el 60 % y el 80 % de la memoria de la caché KV por fragmentación y sobre-reserva.
La solución, bautizada como PagedAttention, aplica un concepto clásico de los sistemas operativos: la memoria virtual paginada. En lugar de exigir bloques contiguos, la caché KV se divide en bloques de tamaño fijo que pueden estar dispersos por la memoria de la GPU. La asignación ocurre bajo demanda, conforme llegan nuevos tokens, igual que un sistema operativo asigna páginas a un proceso.
¿Qué ventajas concretas aporta este enfoque?
La evaluación original del proyecto reportó menos del 4 % de desperdicio de memoria en la caché KV, frente a la enorme merma de los sistemas tradicionales. Pero el impacto va más allá del ahorro. Vale la pena señalar que casi todo el ecosistema moderno de servicio de modelos adoptó estas ideas después.
- Continuous batching: las solicitudes nuevas se integran al lote en ejecución sin esperar a que terminen las anteriores, lo que mantiene la GPU ocupada de forma constante.
- Uso compartido de estados de atención: prefijos idénticos entre solicitudes pueden compartir bloques de la caché, evitando cálculo y memoria duplicados.
- Grafos CUDA/HIP y kernels optimizados: ejecución rápida y flexible del modelo en hardware de NVIDIA y AMD.
- Funciones de producción: cuantización, decodificación especulativa e inferencia distribuida están integradas en el motor.
¿Qué tan rápido es vLLM en la práctica?
En los benchmarks originales del proyecto, vLLM alcanzó hasta 24 veces más rendimiento que la biblioteca Transformers de Hugging Face y entre 2 y 4 veces más que otros sistemas de ejecución optimizados de su generación. Lo notable es que lo consigue sin modificar la arquitectura del modelo: el mismo modelo, simplemente mejor servido.
| Comparación | Rendimiento reportado | Fuente |
|---|---|---|
| vLLM frente a Hugging Face Transformers | Hasta 24x más rendimiento | Benchmarks originales del proyecto |
| vLLM frente a otros sistemas optimizados | Entre 2x y 4x más rendimiento | Benchmarks originales del proyecto |
| Desperdicio de memoria de la caché KV | Menos del 4 % | Evaluación original del proyecto |
| Sistemas tradicionales (antes de PagedAttention) | Entre 60 % y 80 % de memoria desperdiciada | Paper SOSP 2023 y blog oficial de vLLM |
Lo cierto es que las cifras exactas dependen del modelo, el hardware y el patrón de carga, como ocurre con cualquier motor de inferencia. La recomendación práctica es medir en tu propia GPU antes de comprometer un despliegue. La documentación oficial de vLLM incluye guías de instalación y referencias de rendimiento por plataforma.
¿Cuáles son los casos de uso reales de vLLM?
vLLM brilla donde hay tráfico o volumen de trabajo que justifique un motor de servicio dedicado. Estos son los escenarios donde es la herramienta correcta:
| Caso de uso | Cómo ayuda vLLM |
|---|---|
| Chatbot o asistente de empresa con muchos usuarios | El continuous batching mantiene cientos de conversaciones simultáneas sin que la GPU quede subutilizada |
| API privada compatible con OpenAI | Funciona como reemplazo directo del endpoint de OpenAI: solo cambias la URL base y la clave de API en tu código |
| Procesamiento por lotes de documentos | La inferencia offline con la clase LLM genera respuestas para listas completas de prompts en un solo flujo |
| Backend para aplicaciones RAG | El alto rendimiento reduce la latencia percibida en sistemas de consulta aumentada con bases vectoriales |
| Agentes de IA que hacen muchas llamadas al modelo | La concurrencia permite que varios agentes consulten el mismo endpoint sin cuellos de botella |
| Servicio de modelos en un clúster con varias GPU | La inferencia distribuida integrada reparte el modelo entre varias tarjetas |
En la misma línea de optimizar memoria de inferencia, la industria sigue produciendo avances comparables, como métodos de compresión que reducen la memoria de trabajo de los modelos sin reentrenamiento. Juntos, estos esfuerzos apuntan a lo mismo: que servir modelos masivos deje de requerir clústeres prohibitivos.
¿Cuándo conviene usar vLLM y cuándo no?
Conviene aclararlo: vLLM no es una app de escritorio para conversar con un modelo, sino infraestructura para servirlo mediante API. La elección depende del caso de uso.
| Caso de uso | Herramienta adecuada | Por qué |
|---|---|---|
| Chatear con un modelo local | LM Studio u Ollama | Interfaz gráfica, configuración mínima, sin conocimientos de redes |
| Servir una API propia con cientos de usuarios concurrentes | vLLM | Concurrencia, continuous batching y API compatible con OpenAI |
| Desplegar modelos en producción a escala | vLLM | Cuantización, inferencia distribuida y grafos CUDA/HIP integrados |
| Probar modelos en un equipo modesto | llama.cpp u Ollama | Consumo reducido y soporte para GPU de poca VRAM |
¿Cómo se relaciona con otras técnicas de optimización?
PagedAttention no es la única estrategia para acelerar la inferencia. La decodificación especulativa, por ejemplo, ataca el problema desde otro ángulo: un modelo pequeño propone tokens que el modelo grande verifica. Quien ya haya configurado esta técnica puede profundizar en la guía de decodificación especulativa en LM Studio publicada en este mismo sitio. vLLM, de hecho, integra ambas aproximaciones: su gestor de memoria paginada libera GPU para que técnicas como la decodificación especulativa o la cuantización rindan aún más.
¿Cómo instalar vLLM paso a paso y evitar los errores más comunes?
Antes de escribir un solo comando hay tres requisitos que la documentación oficial deja claros y que causan la mayoría de los fracasos de instalación:
- Sistema operativo: vLLM no soporta Windows de forma nativa. Si usas Windows, debes instalarlo dentro de WSL (Windows Subsystem for Linux) con una distribución compatible, o usar una máquina Linux. Intentarlo directo en PowerShell lleva a errores de instalación.
- Versión de Python: vLLM soporta Python 3.10 a 3.13. Si tu entorno usa una versión más nueva (por ejemplo, 3.14), no existen binarios compilados y la instalación fallará. Hay que fijar la versión explícitamente.
- GPU: en NVIDIA se requiere una tarjeta con compute capability 7.0 o superior (V100, T4, series RTX 20xx en adelante, A100, L4, H100, entre otras).
El quickstart oficial recomienda usar uv, un gestor de entornos de Python muy rápido. La secuencia correcta, dentro de Linux o WSL, es:
uv venv –python 3.12 –seed
source .venv/bin/activate
uv pip install vllm –torch-backend=auto
Detalles que evitan dolores de cabeza: el primer comando crea el entorno virtual con Python 3.12 explícito, así evitas que uv tome la versión más nueva de tu sistema; el segundo lo activa (por eso no verás el error “No virtual environment found”); y el tercente descarga automáticamente la variante de PyTorch adecuada según tu driver de CUDA. Si prefieres no crear entorno virtual, la alternativa es añadir –system al comando de instalación, aunque no es lo recomendado para despliegues serios. También existe la imagen oficial de Docker, útil cuando no quieres pelear dependencias.
¿Dónde se obtienen los modelos para vLLM?
Los modelos se obtienen principalmente de Hugging Face, el repositorio estándar del ecosistema. No hace falta descargar nada a mano: cuando le indicas un modelo a vLLM, este se descarga automáticamente desde Hugging Face en el primer arranque. Basta con usar el identificador del repositorio, por ejemplo el nombre de un modelo instruct de la familia Qwen o Llama publicado en la plataforma.
Para lanzar el servidor se usa el comando vllm serve seguido del identificador del modelo. Por defecto, el servidor queda disponible en http://localhost:8000 con una API compatible con OpenAI, lo que significa que tu código existente puede seguir usando la biblioteca oficial de OpenAI con dos cambios: la URL base y la clave de API. Puedes verificar que el servidor responde consultando el endpoint /v1/models con cualquier cliente HTTP.
¿Necesita vLLM que modifiques tu modelo?
No. Esa es una de sus ventajas más citadas: los benchmarks originales se lograron sin cambios en la arquitectura del modelo. PagedAttention actúa en la capa de gestión de memoria del motor de inferencia, no en los pesos ni en el diseño del transformer. En términos prácticos, esto significa que puedes adoptarlo sobre modelos ya existentes sin reentrenar ni ajustar nada.
¿Es vLLM gratis?
El software es gratuito y de código abierto bajo Apache 2.0. El costo real está en el hardware: vLLM está pensado para GPU de NVIDIA o AMD con soporte CUDA/HIP, y su valor se nota cuando hay tráfico concurrente que justifique esa infraestructura.
Lo más leído en Herramientas
-
3D
Img2threejs reconstruye imágenes en modelos 3D con Three.js puro
Img2threejs es un proyecto open source que convierte una única imagen de referencia en un modelo 3D generado…
-
 Audio
VibeVoice la familia open source de voz con IA que impulsa Microsoft
VibeVoice es la familia de modelos de voz con inteligencia artificial publicada como código abierto por Microsoft en…





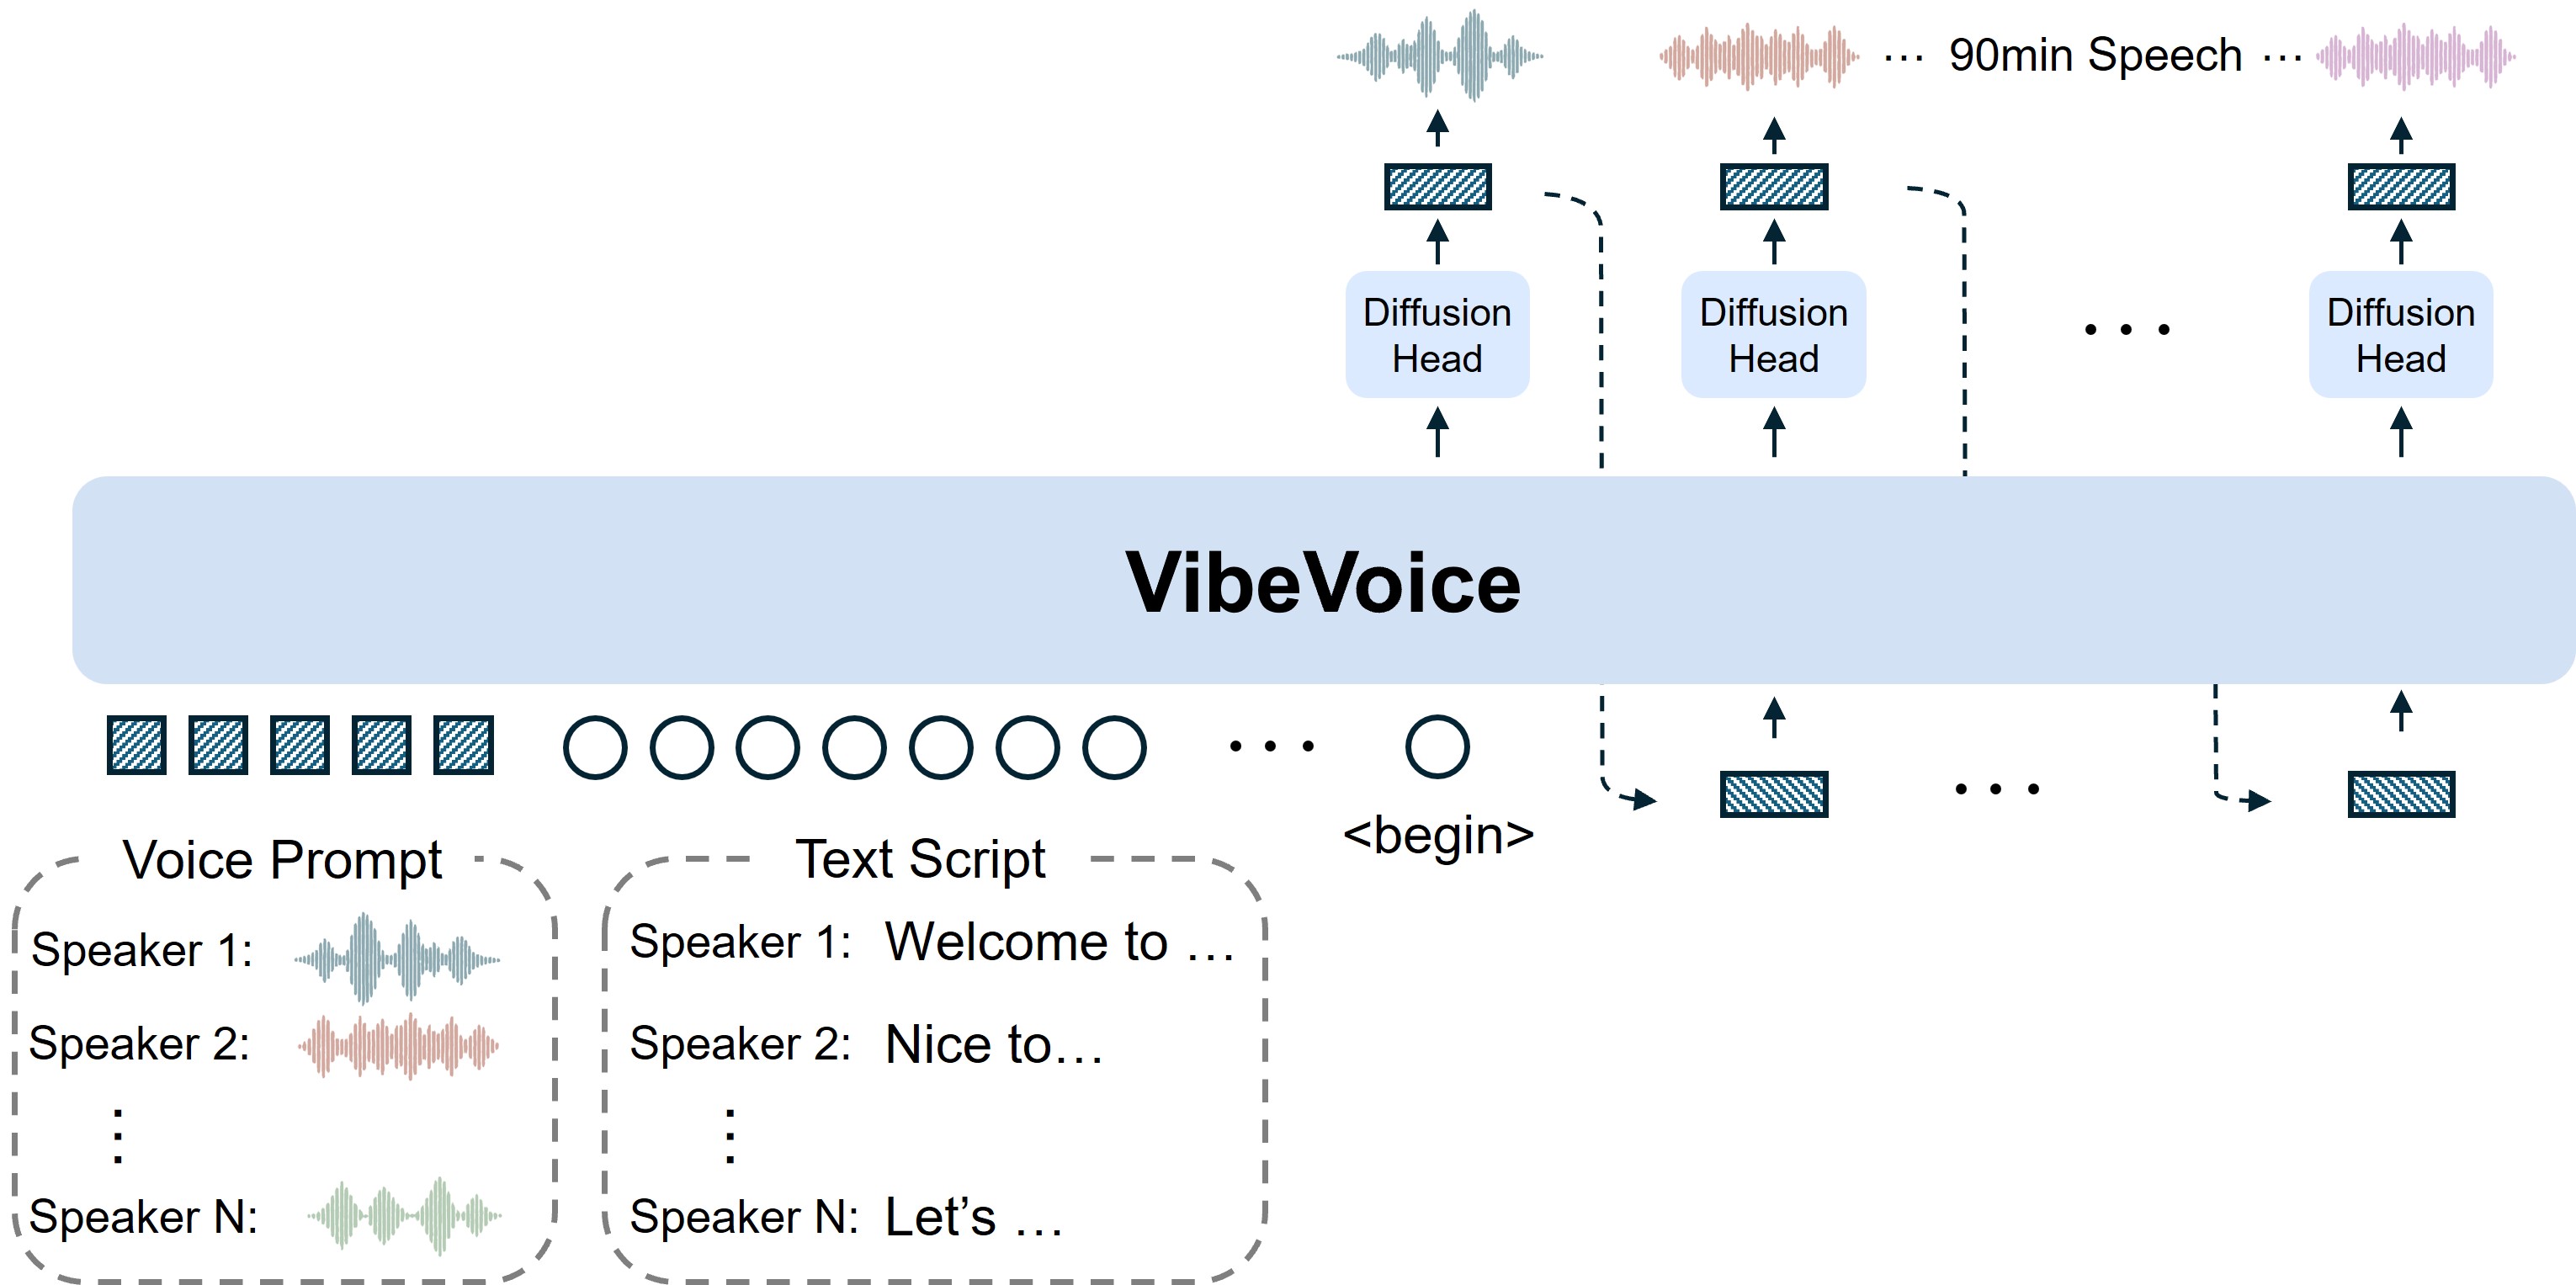
VibeVoice es la familia de modelos de voz con inteligencia artificial publicada como código abierto por Microsoft en GitHub. Combina reconocimiento de voz capaz de transcribir 60 minutos de audio en una sola pasada con síntesis de voz experimental en tiempo real, usando tokenizadores de voz a 7.5 Hz y un marco de difusión de siguiente token.
Lo más leído en Herramientas
-
3D
Img2threejs reconstruye imágenes en modelos 3D con Three.js puro
Img2threejs es un proyecto open source que convierte una única imagen de referencia en un modelo 3D generado…
-
Audio
VibeVoice la familia open source de voz con IA que impulsa Microsoft
VibeVoice es la familia de modelos de voz con inteligencia artificial publicada como código abierto por Microsoft en…
Img2threejs es un proyecto open source que convierte una única imagen de referencia en un modelo 3D generado enteramente en código TypeScript sobre Three.js. La herramienta, disponible en GitHub bajo licencia Apache-2.0, produce modelos listos para animar mediante una tubería de escultura por etapas con puertas de calidad automáticas.
Lo más leído en Herramientas
-
3D
Img2threejs reconstruye imágenes en modelos 3D con Three.js puro
Img2threejs es un proyecto open source que convierte una única imagen de referencia en un modelo 3D generado…
-
Audio
VibeVoice la familia open source de voz con IA que impulsa Microsoft
VibeVoice es la familia de modelos de voz con inteligencia artificial publicada como código abierto por Microsoft en…

Podcast ONE: 6 de noviembre de 2026
(más…)
Podcast: Play in new window | Download
Lo más leído en Herramientas
-
3D
Img2threejs reconstruye imágenes en modelos 3D con Three.js puro
Img2threejs es un proyecto open source que convierte una única imagen de referencia en un modelo 3D generado…
-
Audio
VibeVoice la familia open source de voz con IA que impulsa Microsoft
VibeVoice es la familia de modelos de voz con inteligencia artificial publicada como código abierto por Microsoft en…
Lo más leído
-
3D
Img2threejs reconstruye imágenes en modelos 3D con Three.js puro
-
 Consola
Guía para jugar Zelda Ocarina of Time en PC con Lichii
-
 Arte y Cultura
Cirque du Soleil ECHO llega oficialmente a Ciudad de México tras el izamiento de su icónica Gran Carpa para el estreno de su más reciente producción
-
 Comunicados de Prensa
Etheria: Restart estrena SS6.4 Eidolon Scourge y anticipa colaboración con Guilty Gear
-
Audio
VibeVoice la familia open source de voz con IA que impulsa Microsoft
-

 Apps11 años ago
AMPcast, la herramienta de Pandora que permite a los artistas grabar mensajes de audio directamente a sus seguidores
-
 Blogs5 años ago
Conoce los mejores sitios de Torrents para descargar todo tipo de contenidos
-
Android5 años ago
Aprende cómo usar Discord para ver películas con tus amigos
-
Arte y Cultura14 años ago
Colección de fondos de pantalla basados en Super Héroes
-

 Almacenamiento2 años ago
Cómo usar TeraBox: La guía definitiva para aprovechar 1 TB de almacenamiento en la nube
-
Diseño13 años ago
css3ps: plugin que convierte archivos PSD a CSS3
-
Apps9 años ago
Picturethat, app que usa la Realidad Aumentada para visualizar cómo quedarían los cuadros antes de colgarlos
-
Eventos Especiales14 años ago
Especial Día de la Madres: fondos de pantalla especiales para Mamá