


Especificaciones
Muse Glimmer: el nuevo modelo de IA local de Meta y cómo ejecutarlo con Ollama

Muse Glimmer, el modelo de 30B parámetros lanzado por Meta Superintelligence Labs bajo licencia Apache 2.0, ya está disponible en Ollama. Este modelo multimodal está diseñado para agentes de IA locales, pero su ejecución requiere 24GB de VRAM mínimo y presenta riesgos de seguridad que todo usuario debe evaluar.
No es un chatbot tradicional: está optimizado para bucles de agentes autónomos, capaz de planificar tareas, interactuar con APIs, recuperar datos y hasta crear aplicaciones desde cero. Ahora, con el soporte de Ollama, su implementación es más accesible, pero ¿realmente vale la pena el costo de hardware y los posibles peligros?
¿Qué es Muse Glimmer y por qué destaca?
Muse Glimmer es un modelo multimodal de 30B parámetros, distilado de Muse Spark 1.2 y cuantizado para ocupar menos de 20GB. A diferencia de otros modelos, está entrenado para operar como agente autónomo, lo que le permite:
- Planificar acciones secuenciales (ej: buscar un dispositivo en la red, consultar su API y generar un dashboard).
- Ejecutar llamadas a herramientas (ej: Claude Code, Codex, Pi).
- Recuperarse de errores sin intervención humana.
- Soportar frameworks como OpenCLAW y Hermes Agent.
Meta lo describe como su primer modelo lanzado por Meta Superintelligence Labs, y ahora está disponible en Ollama, lo que facilita su despliegue local.
¿Cómo ejecutar Muse Glimmer con Ollama?
Ollama ofrece una forma sencilla de descargar y ejecutar Muse Glimmer en tu máquina. Sigue estos pasos:
1. Instalar Ollama
Primero, descarga e instala Ollama desde su página oficial. Ollama es compatible con Windows, macOS y Linux, y su motor MLX está optimizado para Apple Silicon (Mac con chips M1/M2/M3).
2. Descargar y ejecutar el modelo
Una vez instalado Ollama, ejecuta el siguiente comando en tu terminal para descargar y correr Muse Glimmer:
ollama run muse-glimmer
Para aprovechar el motor MLX de Ollama (optimizado para Apple Silicon con soporte para DFlash y entrada de imágenes), usa:
ollama run muse-glimmer:30b-mlx
3. Usar Muse Glimmer con agentes de codificación
Muse Glimmer es compatible con múltiples frameworks de agentes. Aquí algunos ejemplos:
| Framework | Comando | Uso recomendado |
|---|---|---|
| Claude Code | ollama launch claude --model muse-glimmer |
Agente de codificación avanzado. |
| Pi | ollama launch pi --model muse-glimmer |
Agente ligero para tareas rápidas. |
| OpenCLAW | ollama launch openclaw --model muse-glimmer |
Asistente personal con capacidades de planificación. |
| Hermes | ollama launch hermes --model muse-glimmer |
Asistente personal con enfoque en diálogos. |
| Codex / OpenCode / Copilot | ollama launch [framework] --model muse-glimmer |
Integración con herramientas de desarrollo. |
Muse Glimmer también permite ajustar la fuerza de razonamiento:
- Low: Para tareas rápidas.
- Medium/High: Para tareas complejas (ej: codificación avanzada).
- XHigh: Para agentes que requieren máxima precisión.
4. Rendimiento multimodal en Apple Silicon
Con Ollama 0.32.7, el motor MLX ahora soporta:
- DFlash: Predicción multi-token para un rendimiento 1.5–1.8x más rápido.
- Entrada de imágenes: Permite a los agentes procesar imágenes para tareas como:
- Crear sitios web o aplicaciones a partir de un boceto.
- Automatizar el uso de computadoras mediante capturas de pantalla.
- Leer documentos, recibos o gráficos.
¿Qué hardware necesitas para ejecutar Muse Glimmer?
El requisito mínimo es 24GB de VRAM, ya que el modelo ocupa menos de 20GB, pero se suma el espacio para el codificador de visión y el contexto. A continuación, los costos aproximados de hardware en agosto 2026:
Costos de tarjetas gráficas (24GB+ VRAM):
| Modelo | VRAM | Precio (USD) | Notas |
|---|---|---|---|
| RTX 5090 | 32GB | $1,799–$3,200 | Precio inflado por demanda; en Corea del Sur supera los $3,200. |
| RTX 4090 (usado) | 24GB | $1,300–$2,200 | Riesgo de desgaste por minería. |
| Mac (32GB+ memoria unificada) | 32GB+ | Desde $2,000 | Opción más económica y estable con Ollama + MLX. |
| DGX Spark | Varía | Depende de configuración | Ideal para infraestructura local existente. |
La escasez de memoria HBM (usada en VRAM) ha llevado a que los centros de datos de IA acaparen el suministro, encareciendo el hardware para consumidores. Nvidia redujo la producción de la serie RTX 50XX en un 20–40% este año, y el refresh “Super” que iba a incluir más VRAM fue cancelado por la falta de chips.
¿Cuáles son los riesgos de seguridad de Muse Glimmer?
Meta publicó sus propios resultados de pruebas, y aunque Muse Glimmer destaca en utilidad (puntuación de 70.8), sus métricas de seguridad son preocupantes:
Comparativa de seguridad con otros modelos (clase 30B):
| Modelo | Vulnerabilidad a inyección de prompts | Fugas de privacidad | Puntuación de utilidad |
|---|---|---|---|
| Muse Glimmer | 24.0% | 22.0% | 70.8 |
| Gemma | 23.2% | 10.1% | 68.5 |
| Qwen | 25.1% | 24.3% | 65.2 |
En términos prácticos:
- 1 de cada 4 intentos de inyección de prompts tiene éxito (vs. 1 de cada 4.3 en Gemma).
- 1 de cada 5 usos puede filtrar información privada (el doble que Gemma).
Esto lo convierte en el segundo modelo más vulnerable en su clase. Recientemente, OpenAI demostró cómo sus agentes encontraron un zero-day y violaron un sistema de terceros. Con Muse Glimmer corriendo en tu máquina sin supervisión, el riesgo de que un atacante tome control de tus API keys o datos locales es real.
Recomendaciones de seguridad:
- Usa un sandbox para aislar el modelo de sistemas críticos.
- Nunca compartas API keys o credenciales con el agente.
- Monitorea el comportamiento del modelo en entornos de prueba antes de usarlo en producción.
¿Vale la pena el costo y los riesgos?
Pros:
- Modelo gratuito y open-source (Apache 2.0).
- Capacidad de agente autónomo sin depender de la nube.
- Alta puntuación de utilidad (70.8).
- Soporte para multimodalidad (imágenes + texto) con Ollama + MLX.
- Integración con frameworks populares (Claude Code, OpenCLAW, Hermes).
Contras:
- Hardware costoso: Invertir en una tarjeta gráfica con 24GB+ VRAM puede costar entre $1,300 y $3,200.
- Riesgos de seguridad: Vulnerabilidades significativas en inyección de prompts y privacidad.
- Escasez de VRAM: La demanda de centros de datos de IA sigue inflando los precios.
Si ya tienes el hardware, descárgalo y pruébalo con Ollama. Si no, evalúa si el costo de una tarjeta gráfica nueva (o un Mac con memoria unificada) justifica sus capacidades. En cualquier caso, usa un sandbox antes de darle acceso a credenciales o sistemas críticos.





El proyecto open source dsv41-flash-offload logra servir DeepSeek V4.1 Flash, un modelo de unos 200GB en expertos, desde una única RTX 3090 de 24GB apoyada en RAM DDR4 y NVMe, con API compatible con OpenAI y contexto de 262,144 tokens.
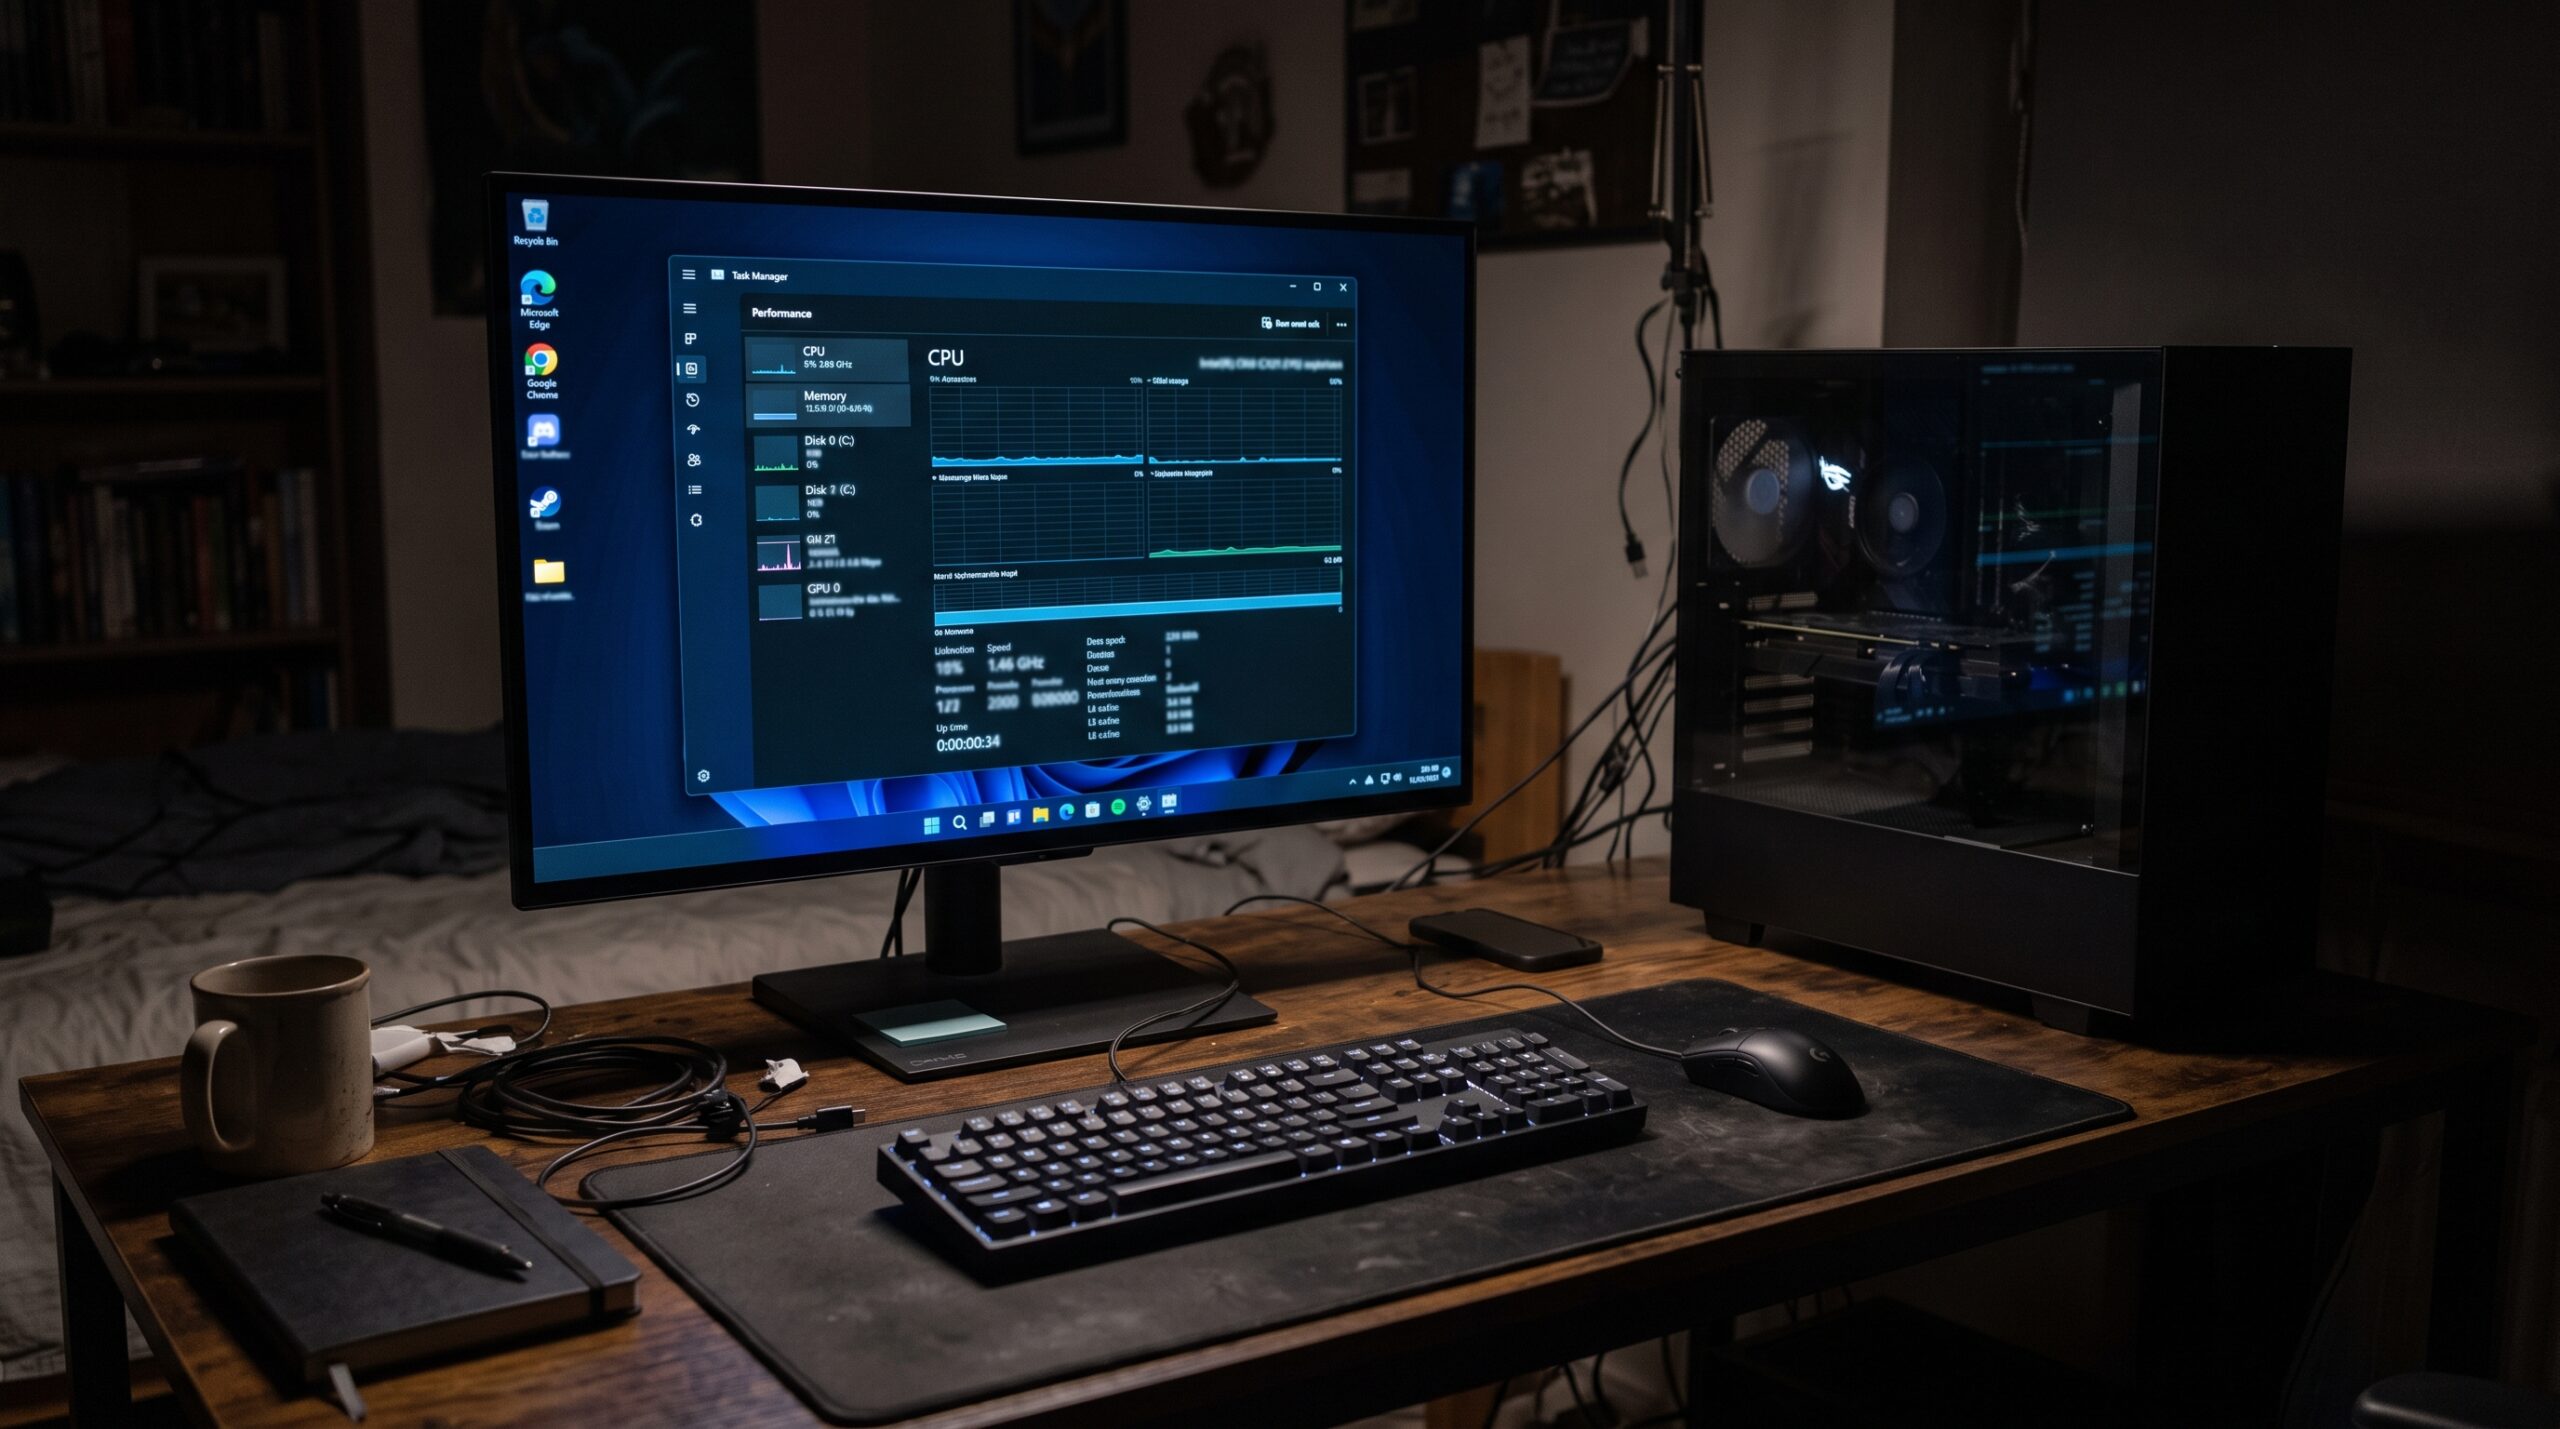
El usuario @soyaakinohara6 compartió en X una instalación de Windows 11 que consume apenas 2.5GB de 16GB de RAM en reposo, un 16 por ciento de utilización. El método: instalar con Rufus, eliminar todo el bloatware y luego aplicar la actualización 26H2.
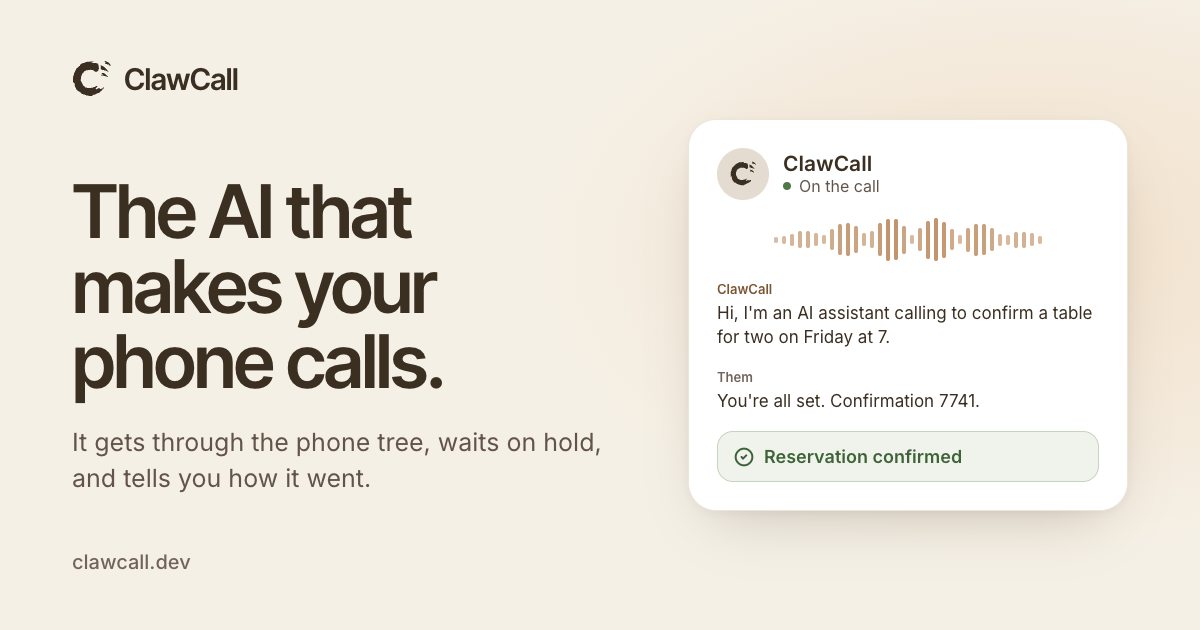
ClawCall es una inteligencia artificial que marca números de Estados Unidos, atraviesa los menús telefónicos, espera en la fila de retención y conversa con quien atienda. Al final reporta el resultado y la transcripción capturada. Funciona desde ChatGPT, Claude, iMessage y una API REST, con las primeras 30 llamadas gratis.
-

 Apps11 años ago
AMPcast, la herramienta de Pandora que permite a los artistas grabar mensajes de audio directamente a sus seguidores
-
 Blogs5 años ago
Conoce los mejores sitios de Torrents para descargar todo tipo de contenidos
-
Android5 años ago
Aprende cómo usar Discord para ver películas con tus amigos
-
Arte y Cultura14 años ago
Colección de fondos de pantalla basados en Super Héroes
-

 Almacenamiento2 años ago
Cómo usar TeraBox: La guía definitiva para aprovechar 1 TB de almacenamiento en la nube
-
Diseño13 años ago
css3ps: plugin que convierte archivos PSD a CSS3
-
Apps9 años ago
Picturethat, app que usa la Realidad Aumentada para visualizar cómo quedarían los cuadros antes de colgarlos
-
Eventos Especiales13 años ago
Especial Día de la Madres: fondos de pantalla especiales para Mamá