
Educación
Los modelos Mixture of Experts cambiaron las reglas del hardware para IA local

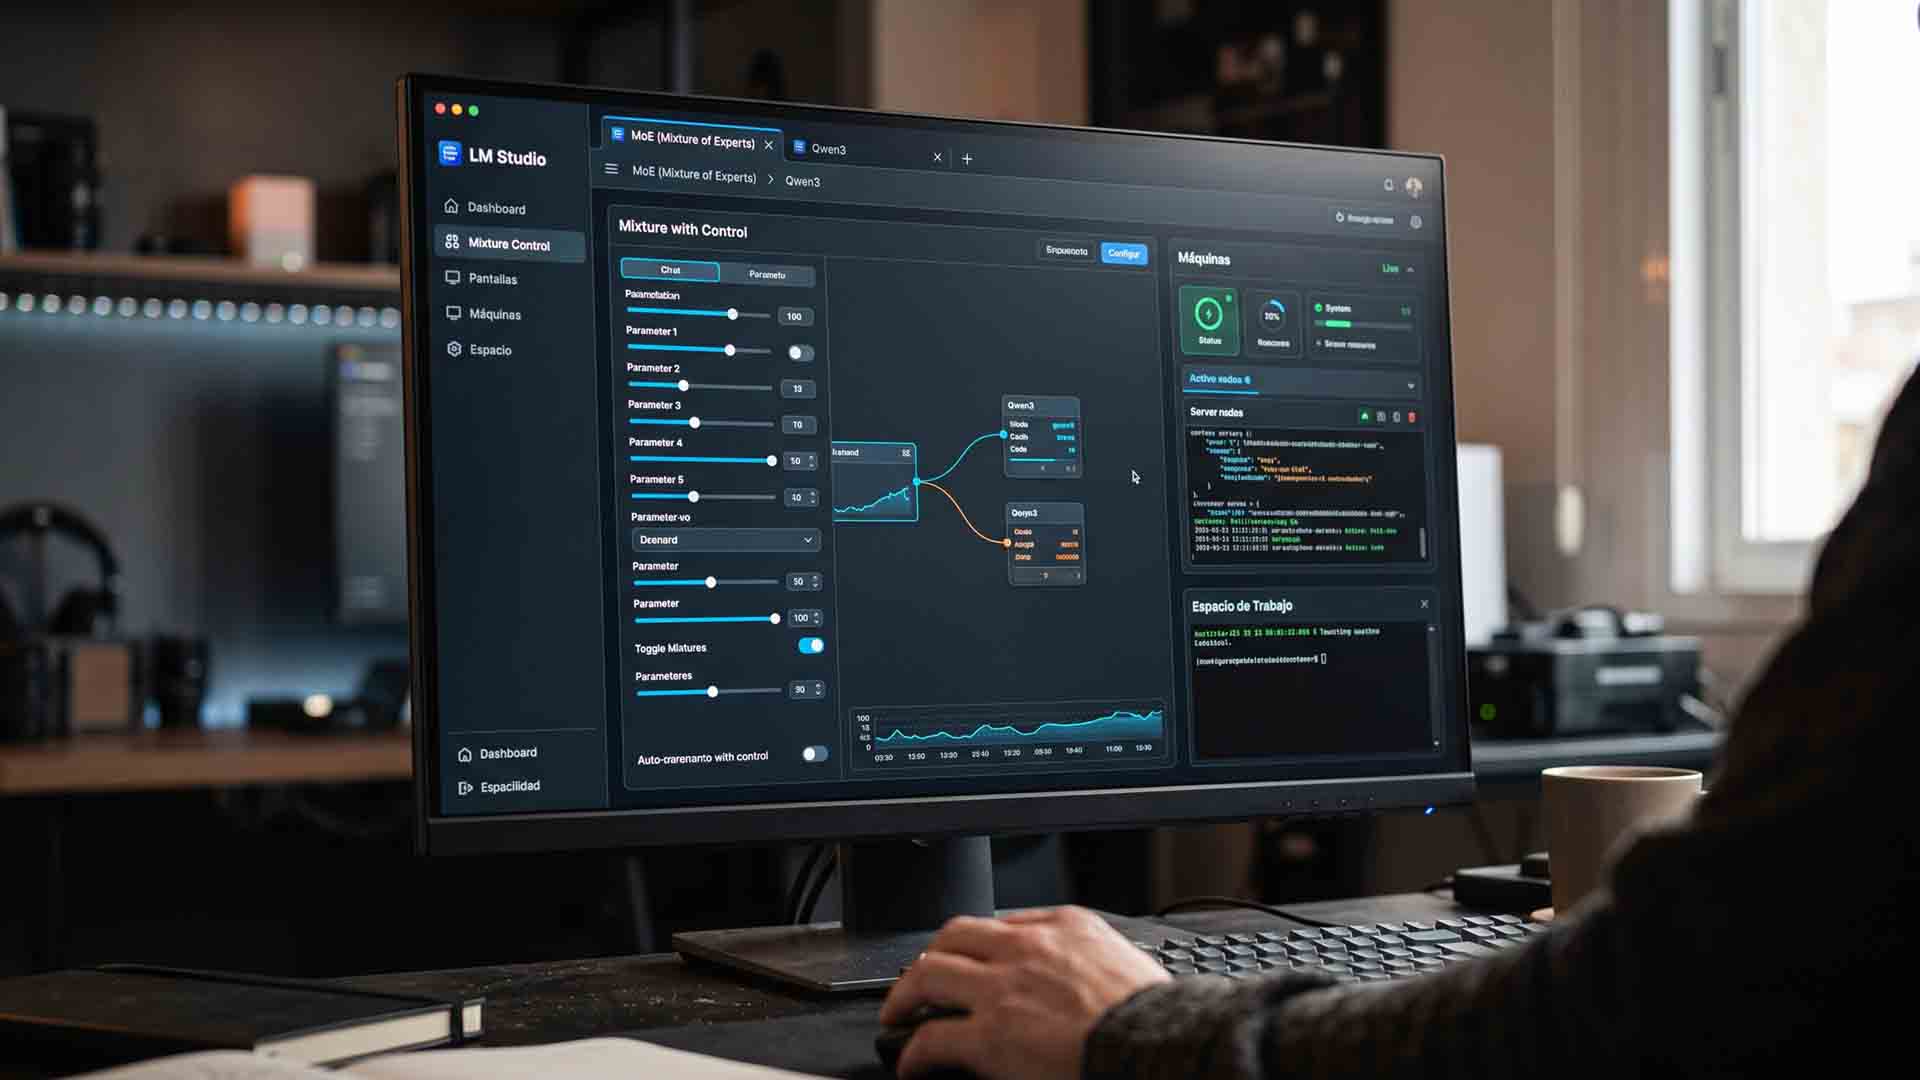
Los modelos Mixture of Experts cambiaron una de las reglas más repetidas del hardware para IA local: que una GPU necesita alojar todos los parámetros del modelo para ser útil. Gracias al reparto entre VRAM y memoria del sistema, un modelo grande puede ejecutarse sin residir por completo en la tarjeta, siempre que la arquitectura active solo una fracción de sus parámetros por token. Esta guía explica por qué el consejo de hardware tradicional quedó desactualizado, qué modelos de Hugging Face tienen mejor encaje en este enfoque y cómo configurarlos en llama.cpp y LM Studio.
El criterio habitual en foros y guías sigue siendo medir una tarjeta por su VRAM total y descartar cualquier modelo que la exceda. Esa lógica nació con los modelos densos. Para contextualizar las opciones por cantidad de memoria conviene partir de la guía de LLM locales según tu VRAM, aunque este artículo persigue otro objetivo: no elegir un modelo para una sola GPU, sino repartir un modelo grande entre la GPU y la RAM.
¿Por qué los modelos densos exigen tanta VRAM?
Un modelo denso activa todos sus parámetros al procesar cada token. Por eso la tarjeta necesita espacio para alojar la red completa, además del contexto, la caché KV y los buffers de trabajo. Cuando el modelo deja de caber, la alternativa clásica es descargar parte de sus capas a la memoria del sistema. En ese escenario el bus PCIe se vuelve un cuello de botella y la velocidad de generación cae con fuerza.
La cuantización alivia parte de la presión de memoria, pero no cambia el principio básico del modelo denso: toda la red participa en cada paso. Esa es la razón por la que el salto entre 7B, 13B, 27B o 30B suele sentirse abrupto en GPUs modestas.
¿Qué hace diferente a un Mixture of Experts?
Un modelo Mixture of Experts sustituye parte de la red por varios expertos paralelos. Un mecanismo de enrutamiento decide cuáles se activan para cada token, mientras el resto permanece inactivo. El conocimiento total sigue almacenado en memoria, pero el costo de cómputo por token depende de los expertos activos y no del tamaño total del modelo.
Eso permite que la atención, el enrutamiento, los embeddings y parte de los expertos activos residan en la VRAM, mientras otros pesos permanecen en la RAM del sistema. El requisito de memoria total no desaparece, pero el reparto entre memorias penaliza mucho menos que en un modelo denso con offload tradicional.
¿Qué diferencia hay entre parámetros totales y parámetros activos?
La cifra más repetida en los nombres de modelos suele ser la de parámetros totales. En un MoE también importa la cifra de parámetros activos, es decir, la fracción del modelo que realmente participa al procesar cada token.
Gemma 4 26B A4B, por ejemplo, tiene 25.2B parámetros totales y 3.8B parámetros activos. Qwen3.5-35B-A3B y Qwen3.6-35B-A3B tienen 35B parámetros totales y 3B parámetros activos. Ese dato cambia por completo la lectura del hardware: el archivo sigue ocupando decenas de gigabytes, pero el costo de inferencia por token se parece más al de un modelo mucho menor.
¿Qué modelos MoE de Hugging Face conviene mirar si se tiene hasta 12 GB de VRAM?
La familia con desglose más claro de arquitectura y tamaños GGUF es Gemma 4 26B A4B. Su ficha oficial está en google/gemma-4-26B-A4B-it y sus variantes GGUF con tamaños exactos están publicadas en bartowski/google_gemma-4-26B-A4B-it-GGUF.
Las variantes GGUF de Gemma 4 26B A4B que entran nominalmente dentro de 12 GB son estas:
- IQ2_XXS — 9.66 GB
- IQ2_XS — 10.13 GB
- IQ2_S — 10.23 GB
- IQ2_M — 10.70 GB
- Q2_K — 10.95 GB
- Q2_K_L — 11.13 GB
Las variantes de mejor equilibrio entre tamaño y calidad ya pasan a depender de un reparto entre VRAM y RAM:
- IQ4_XS — 14.21 GB
- Q4_K_S — 15.84 GB
- Q4_K_M — 17.04 GB
Para quien busque una familia MoE más orientada a código y agentes, las referencias principales en GGUF son unsloth/Qwen3.5-35B-A3B-GGUF y unsloth/Qwen3.6-35B-A3B-GGUF. La variante comunitaria preparada para LM Studio está en lmstudio-community/Qwen3.6-35B-A3B-GGUF. En ambos casos, la arquitectura publicada es de 35B totales y 3B activos por token.
¿Qué cuantizaciones conviene elegir primero?
Si la prioridad es cargar por completo dentro de 12 GB, las únicas opciones claramente publicadas dentro de ese límite pertenecen a Gemma 4 26B A4B en cuantizaciones de 2 bits e IQ2. Si la prioridad es un equilibrio mejor entre calidad y tamaño, el salto natural está en IQ4_XS, Q4_K_S o Q4_K_M, ya con reparto entre VRAM y RAM.
LM Studio recomienda elegir una opción de 4 bits o superior cuando el equipo puede sostenerla. Ese consejo aparece en su documentación general de descarga de modelos y encaja bien con el uso práctico de MoE: primero se busca la cuantización que el sistema pueda cargar con margen real, y después se ajustan contexto, expertos y offload.
¿Cómo se selecciona una cuantización en LM Studio?
LM Studio no documenta un flujo nativo para cuantizar un modelo dentro de la aplicación. Lo que sí documenta es la selección y descarga de variantes ya cuantizadas desde Hugging Face. El comando lms get permite elegir una cuantización concreta con la sintaxis @quant. El ejemplo oficial es:
lms get llama-3.1-8b@q4_k_m
La misma lógica se aplica a cualquier modelo con varias variantes publicadas. También se puede descargar a partir de la URL completa del repositorio. La cuantización, por tanto, no se “crea” dentro de LM Studio: se elige entre archivos GGUF ya cuantizados.
¿Qué ajustes de LM Studio importan más para MoE?
LM Studio documenta varios parámetros de carga que afectan directamente a los modelos MoE cargados con su runtime basado en llama.cpp. Entre ellos están:
- context_length
- flash_attention
- num_experts
- offload_kv_cache_to_gpu
- eval_batch_size
La documentación de su endpoint de carga de modelos muestra además que esos valores forman parte de la configuración efectiva del modelo cargado. Eso significa que LM Studio ya trata a los MoE como modelos con controles propios de reparto y no solo como una variante más del catálogo.
¿Cuál es la opción clave que añadió LM Studio para máquinas con poca VRAM?
LM Studio 0.3.23 añadió un ajuste avanzado para forzar los pesos de expertos MoE a CPU. La propia nota de lanzamiento lo describe como una opción útil cuando no hay suficiente VRAM para mantener el modelo entero dentro de la memoria dedicada de la GPU. Esa función utiliza la misma lógica subyacente que –n-cpu-moe en llama.cpp.
La línea 0.4.0 añadió además un control específico para ajustar ese comportamiento de forma más granular. Eso es relevante para GPUs de 8 a 12 GB, porque el reparto de expertos suele ser la diferencia entre un arranque estable y un fallo de carga.
¿Qué configuración base conviene usar en LM Studio para MoE con 8 a 12 GB de VRAM?
Una configuración conservadora y reproducible para arrancar un MoE en una GPU modesta es esta:
- Elegir una variante GGUF ya cuantizada.
- Fijar el contexto en 2048 o 4096 tokens.
- Activar Flash Attention si el runtime y la GPU lo soportan.
- Mover los expert weights a CPU en la fase inicial.
- Dejar el GPU Offload en un punto intermedio al principio.
- Subir offload o devolver parte de los expertos a GPU solo después de confirmar que el modelo carga sin errores.
Ese orden responde al comportamiento de LM Studio al cargar modelos grandes: el contexto se preasigna completo desde el arranque, así que un valor demasiado alto puede romper la carga aunque todavía no exista un prompt en pantalla.
¿Cómo arrancar un MoE en llama.cpp?
En llama.cpp el flujo es directo: se descarga una variante GGUF, se decide cuántas capas se envían a GPU y, en modelos MoE, se ajusta el reparto de expertos cuando la VRAM no alcanza. Los repositorios revisados de Qwen3.5-35B-A3B y Qwen3.6-35B-A3B incluyen ejemplos de uso con llama.cpp mediante identificadores de variante específicos, lo que confirma su integración con este entorno local.
En despliegues ajustados, el principio es el mismo que en LM Studio: contexto corto, expertos fuera de la GPU al inicio y aumento progresivo del offload solo después de confirmar estabilidad.
¿Qué rendimientos reales logran las GPUs antiguas con MoE?
Una RTX 3080 Ti de 12 GB, acompañada de 32 GB de RAM, puede ejecutar Qwen3.6-35B-A3B alrededor de 24 tokens por segundo con una configuración de llama.cpp que utiliza 25 capas en GPU y evita que los expertos activos recaigan en CPU. Ese comportamiento es consistente con una arquitectura de 35B totales y 3B activos por token.
Una GTX 1080 de 8 GB con 32 GB de DDR4 puede ejecutar Gemma 4 26B A4B alrededor de 14 tokens por segundo. El punto decisivo no es la cifra aislada, sino que el modelo tiene 25.2B totales y 3.8B activos por token, lo que hace viable el reparto entre memorias en hardware que con modelos densos quedaría descartado.
¿Cómo conviene leer esos benchmarks?
La cifra exacta cambia según el runtime, la cuantización, el contexto, la caché KV, el backend de GPU y el sistema operativo. Lo importante es el patrón: modelos grandes, pocos parámetros activos por token y un reparto intencional entre VRAM y RAM. Cuando esas tres condiciones se cumplen, GPUs antiguas o modestas vuelven a ser útiles en inferencia local.
¿Qué significa el error “Failed to start the model” en LM Studio?
Ese error significa que el motor de inferencia murió antes de terminar de arrancar. LM Studio muestra el mensaje genérico, pero la causa real suele estar en el modelo, la memoria o el runtime.
¿Cuál es la causa más común de ese error?
En modelos MoE con VRAM justa, el motivo más frecuente es que el archivo del modelo cabe, pero la combinación de pesos, contexto, caché y buffers rebasa la memoria utilizable durante el arranque. La secuencia de arreglo más efectiva es esta:
- Subir al máximo el control de expertos forzados a CPU.
- Bajar el contexto a 2048 o 4096.
- Reducir el GPU Offload y aumentarlo después poco a poco.
LM Studio también documenta que Flash Attention puede reducir uso de memoria y mejorar velocidad en runtimes compatibles, así que mantenerlo activo suele ayudar cuando la GPU lo soporta.
¿Puede fallar por controles MoE mal ajustados?
Sí. Si LM Studio conserva un valor heredado de otro modelo o de otro preset, el arranque puede abortar porque la configuración ya no coincide con la arquitectura cargada. En MoE esto importa más que en modelos densos, porque los controles de expertos sí alteran el reparto real de memoria y ejecución.
La verificación más útil es revisar que los valores avanzados correspondan al modelo actual y, si hay duda, restaurar los ajustes por defecto del modelo antes de volver a intentar la carga.
¿Puede fallar por usar un runtime incorrecto o desactualizado?
Sí. LM Studio actualiza sus runtimes por separado del resto de la aplicación y su changelog muestra correcciones frecuentes relacionadas con carga de modelos, nuevos backends y soporte para familias nuevas. Cuando el log menciona mensajes como unknown model architecture o Model type not supported, el problema suele estar en el runtime, no en la VRAM.
La secuencia correcta es abrir el panel de runtime, verificar si el backend activo es CUDA, Vulkan, ROCm, Metal o MLX según la máquina, y probar la versión más reciente o, si el fallo apareció justo después de actualizar, la versión anterior.
¿Qué conviene revisar en los logs antes de tocar más ajustes?
El diagnóstico rápido pasa por abrir el panel Developer → logs y leer la línea anterior al aborto:
- failed to allocate compute buffers apunta a memoria insuficiente.
- unknown model architecture o Model type not supported apuntan al runtime.
- wrong number of tensors apunta al archivo GGUF descargado o a incompatibilidad de versión.
Si el problema está en el archivo, la solución es borrar el GGUF y volver a descargarlo desde el repositorio original del publicador.
¿Cuándo no conviene usar un MoE?
Los MoE no sustituyen cualquier otro enfoque. Si el equipo tiene poca RAM, si el bus PCIe es demasiado limitado o si la prioridad es latencia mínima con contextos largos, un modelo denso más pequeño completamente residente en VRAM puede comportarse mejor. También sigue siendo válido mantener un modelo menor cuando lo importante es simplicidad operativa y no tamaño total de conocimiento.
¿Cómo se integran estos modelos en un homelab real?
El uso natural de esta arquitectura es jerárquico. Un modelo más grande puede reservarse para la tarea de mayor valor, como asistencia de código o trabajo agente, mientras otro modelo sirve de motor de fondo para notas, búsqueda documental o automatizaciones internas. Ese patrón complementa lo ya cubierto en la implementación de Mixture of Experts con Ollama por dominio, donde el interés es la especialización por tarea y no tanto el aprovechamiento de hardware veterano.
¿Qué regla de hardware conviene olvidar?
La métrica útil ya no es solo cuántos parámetros caben en la VRAM. También importa cuánta memoria total puede movilizar el equipo y qué fracción del modelo se activa por token. Una tarjeta modesta acompañada de suficiente RAM puede ejecutar tareas que antes se asociaban de manera automática a hardware mucho más costoso.
La arquitectura del modelo se volvió tan determinante como el silicio. Si una GPU antigua ya no alcanza para modelos densos útiles, un MoE bien repartido entre VRAM y RAM puede devolverle valor real.
Lo más leído en Educación
-
 Consola
Juega gratis en el navegador más de 240 títulos sin instalar nada
Ported2Browser es un sitio que reúne más de 240 juegos que corren gratis en el navegador, sin instalar…
-
 Android
Concat es la alternativa gratuita y open source a CapCut que edita video sin marca de agua
Concat es un editor de video gratuito y de código abierto para Windows, macOS, Linux y Android que…




Encontrar la herramienta de IA adecuada para cada tarea puede marcar la diferencia entre perder tiempo en procesos mecánicos y avanzar con resultados inmediatos. Esta selección reúne siete opciones especializadas que van desde la creación automática de diagramas hasta el análisis de datos sin fórmulas. Cada una resuelve un problema concreto que los asistentes conversacionales de propósito general suelen cubrir con más fricción.
Lo más leído en Educación
-
Consola
Juega gratis en el navegador más de 240 títulos sin instalar nada
Ported2Browser es un sitio que reúne más de 240 juegos que corren gratis en el navegador, sin instalar…
-
Android
Concat es la alternativa gratuita y open source a CapCut que edita video sin marca de agua
Concat es un editor de video gratuito y de código abierto para Windows, macOS, Linux y Android que…
Comunicados de Prensa
Matemáticas en menos de 3 minutos: el fenómeno del microaprendizaje en redes sociales

Conceptos de matemáticas que tradicionalmente requerían horas de cátedra hoy se sintetizan en videos de menos de 3 minutos en TikTok, Instagram Reels y YouTube Shorts. Esta es la esencia del microaprendizaje: el formato que está redefiniendo la divulgación de las ciencias exactas y contribuyendo a cerrar la brecha de género en las matemáticas.
Lo más leído en Educación
-
Consola
Juega gratis en el navegador más de 240 títulos sin instalar nada
Ported2Browser es un sitio que reúne más de 240 juegos que corren gratis en el navegador, sin instalar…
-
Android
Concat es la alternativa gratuita y open source a CapCut que edita video sin marca de agua
Concat es un editor de video gratuito y de código abierto para Windows, macOS, Linux y Android que…
Usar un asistente de inteligencia artificial como si fuera un buscador es uno de los errores más comunes. Se escribe una pregunta, se recibe una respuesta genérica y se da por bueno el resultado. El problema, muchas veces, no está en el modelo, sino en la forma de redactar el prompt. Estas cinco técnicas de prompting pueden mejorar de forma notable los resultados en ChatGPT, Claude, Gemini, Copilot o Mistral, porque no dependen de palabras mágicas, sino de pedirle a la IA diagnóstico, criterio y refinamiento en lugar de información suelta.
Lo más leído en Educación
-
Consola
Juega gratis en el navegador más de 240 títulos sin instalar nada
Ported2Browser es un sitio que reúne más de 240 juegos que corren gratis en el navegador, sin instalar…
-
Android
Concat es la alternativa gratuita y open source a CapCut que edita video sin marca de agua
Concat es un editor de video gratuito y de código abierto para Windows, macOS, Linux y Android que…
Lo más leído
-
 Entretenimiento
Revisión: Colección Warcraft Forever – Azeroth renace con los cielonato
-
 Animación
Revisión: Angel Guardian – Shooter sci-fi con caos de Twitch
-
 Entretenimiento
Revisión: Lucky Punk – Deckbuilder roguelike de azar transparente
-
 Consola
Revisión: Overwatch – Mega Lote Protocolo EVE y Aspecto Mítico de Roadhog
-
 Digitalización
MachineMail la API de correo que da buzones reales a tus agentes de IA
-

 Apps11 años ago
AMPcast, la herramienta de Pandora que permite a los artistas grabar mensajes de audio directamente a sus seguidores
-
 Blogs5 años ago
Conoce los mejores sitios de Torrents para descargar todo tipo de contenidos
-
Android5 años ago
Aprende cómo usar Discord para ver películas con tus amigos
-
Arte y Cultura14 años ago
Colección de fondos de pantalla basados en Super Héroes
-

 Almacenamiento2 años ago
Cómo usar TeraBox: La guía definitiva para aprovechar 1 TB de almacenamiento en la nube
-
Diseño13 años ago
css3ps: plugin que convierte archivos PSD a CSS3
-
Apps9 años ago
Picturethat, app que usa la Realidad Aumentada para visualizar cómo quedarían los cuadros antes de colgarlos
-
Eventos Especiales14 años ago
Especial Día de la Madres: fondos de pantalla especiales para Mamá