
Los modelos Mixture of Experts cambiaron una de las reglas más repetidas del hardware para IA local: que una GPU necesita alojar todos los parámetros del...

La conversación sobre IA local suele empezar mal planteada. Se pregunta cuál herramienta es mejor antes de definir para qué se usará, con qué hardware y...

Un experimento viral de Reddit convierte el iPhone en una GPU auxiliar para ejecutar un modelo de 27 mil millones de parámetros en una MacBook de...

Una GPU vieja no tiene por qué terminar relegada a un cajón. En 2026, una tarjeta como la GeForce GTX 1080, lanzada en 2016 con 8...

En hardware modesto, la discusión no debería comenzar con el modelo más grande disponible, sino con una pregunta más útil: cuánto margen real deja la GPU...


Los modelos de LLM (lenguaje local) ya no son una curiosidad para entusiastas. Hoy permiten resolver tareas cotidianas con un nivel de privacidad, control y ahorro...


Con una cantidad razonable de VRAM, ya es posible montar un entorno local serio para modelos de lenguaje, navegación web, extracción de contenido y memoria persistente....

Ejecutar modelos de IA de forma local se ha vuelto mucho más accesible en el último año. Ya sea por privacidad, menor dependencia de servicios externos,...

La Terminal Inteligente de Microsoft permite usar modelos locales de IA (como Qwen 3.6) en lugar de Copilot, con una configuración en solo 5 minutos. Descubre...
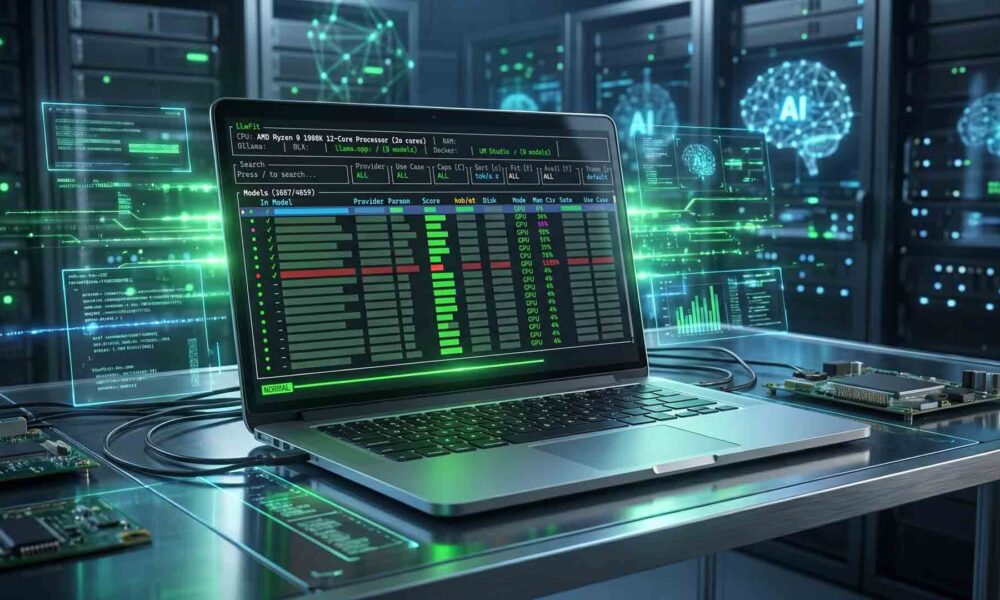


Si has descargado modelos de IA local que no funcionan en tu PC, LLMFit es la solución: analiza tu hardware en segundos y te recomienda los...


Instala llama.cpp en Windows y Mac sin compilar, compara con Ollama y LM Studio, y aprende a compartir modelos GGUF entre las tres herramientas sin duplicar...


Gemma 4 permite ejecutar inteligencia artificial avanzada directamente en tus dispositivos sin depender de servicios en la nube.


Ejecutar un modelo de lenguaje local en tu propio equipo es posible en casi cualquier hardware moderno: desde una laptop con procesador Snapdragon X Elite hasta...