

Curiosidades
Un flag de llama.cpp permite correr un modelo 35B en 8GB de VRAM

Una prueba documentada muestra cómo el flag –n-cpu-moe de llama.cpp descarga los expertos de un modelo Mixture-of-Experts a la RAM del sistema y multiplica por ocho la velocidad de generación en una GPU de laptop de 8GB. Aquí la guía completa paso a paso para Windows.
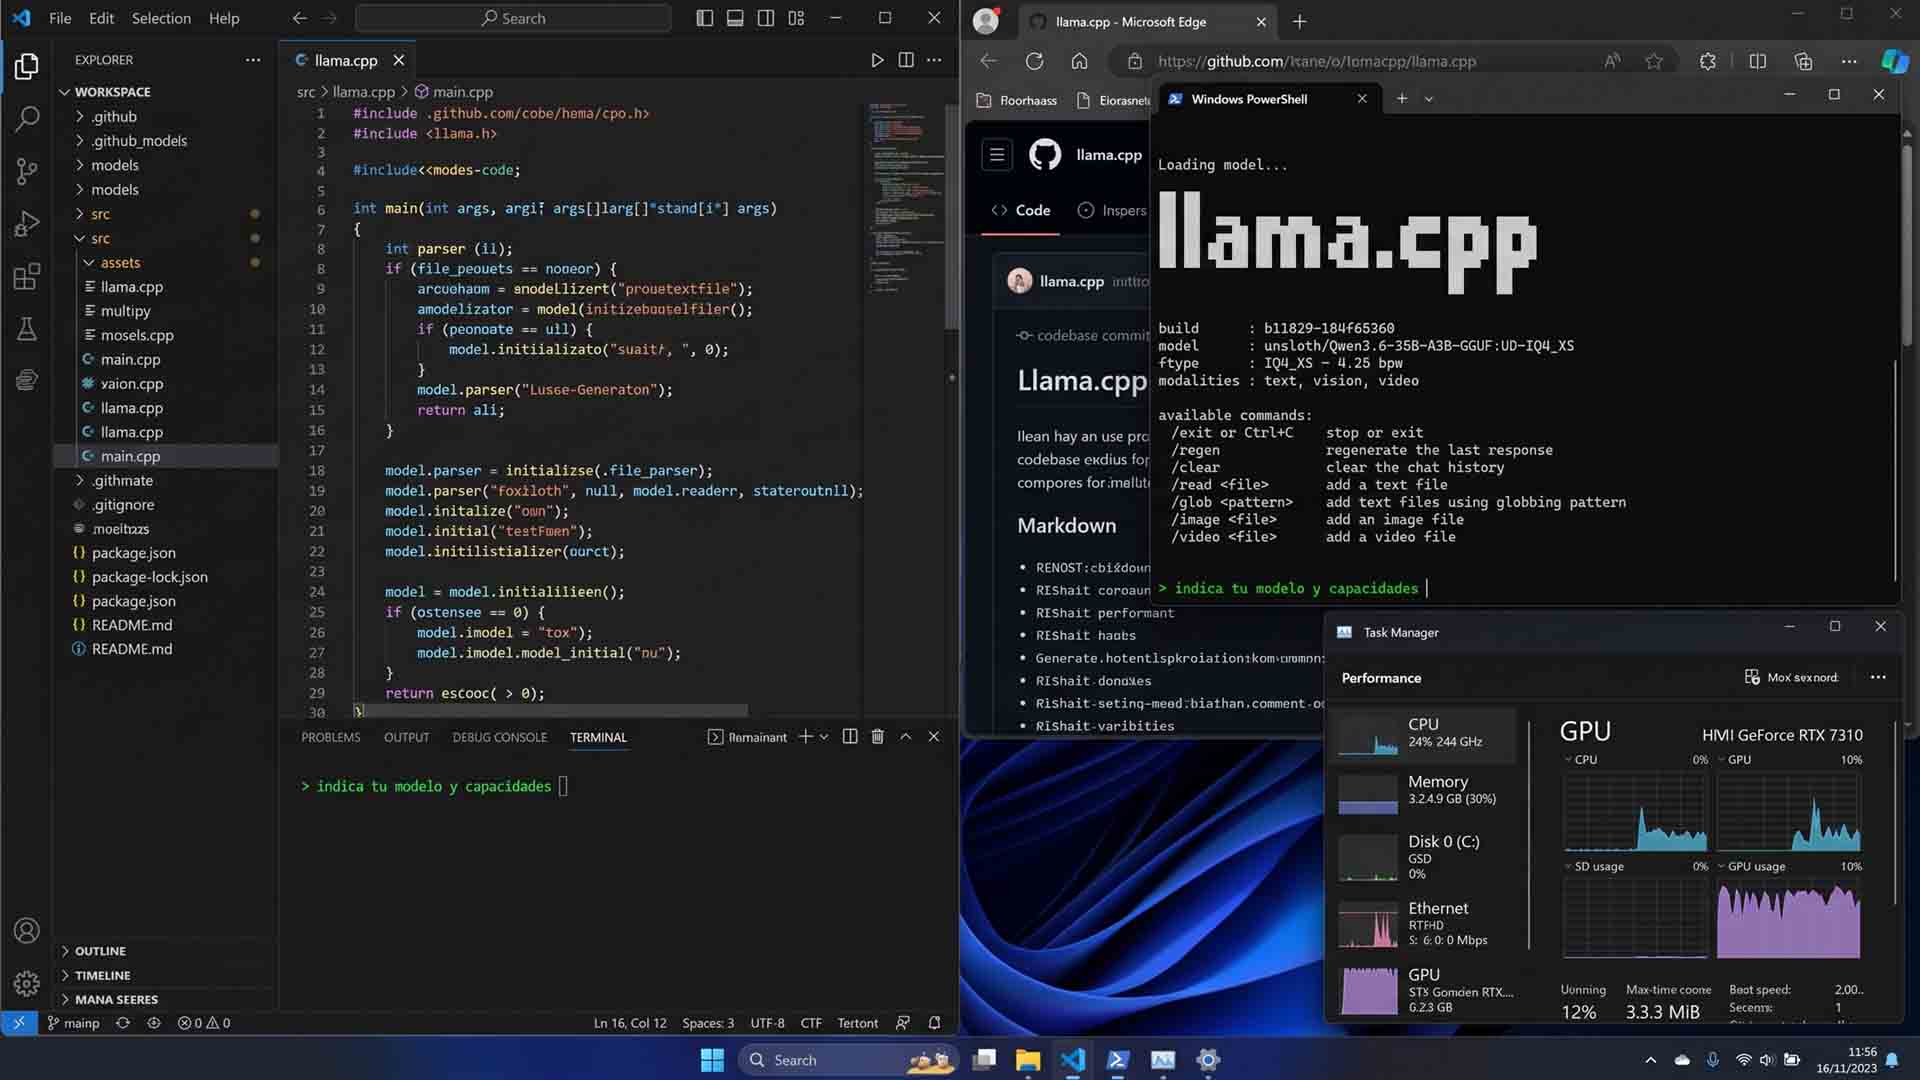
La VRAM de la GPU dicta mucho de lo que un equipo puede hacer: la resolución de los juegos, el tamaño de un proyecto de video y, cada vez más, qué modelos de IA local se pueden ejecutar. La mayoría de esos límites parecen absolutos, pero casi todos tienen alternativas. Una prueba documentada con una Lenovo Legion 5 con RTX 3070 Mobile de 8GB demuestra que la excepción más simple está en la inferencia local: con un solo flag de llama.cpp, el motor de inferencia de código abierto, esa laptop ejecutó un modelo de 35 mil millones de parámetros a una velocidad que el autor de la prueba describe como superior a la de su propia lectura.
¿Qué hace exactamente el flag –n-cpu-moe?
La clave está en la arquitectura del modelo. Qwen3.6-35B-A3B es un modelo Mixture-of-Experts (MoE): de sus 35 mil millones de parámetros, solo alrededor de 3 mil millones se activan en cada inferencia y el resto queda inactivo. Esa matemática cambia todo, porque las partes dormidas del modelo pueden vivir fuera de la GPU sin frenar el trabajo activo.
El flag -ncmoe, –n-cpu-moe N está documentado en la referencia oficial de llama.cpp con valor por defecto 0. Su función es instruir al motor a mantener en la RAM del sistema los tensores de expertos de las primeras N capas del modelo. Al combinarlo con -ngl 99, todas las capas se cargan en la GPU y luego el flag devuelve los expertos seleccionados a la memoria del sistema. El resultado es que las capas de atención, los embeddings, los pesos compartidos y el caché KV permanecen en la VRAM, que son precisamente los elementos que determinan la velocidad de generación de tokens. Los expertos, que solo se tocan cuando el enrutador los elige, residen en la RAM y se copian bajo demanda. Existe además la variante -cmoe, –cpu-moe, que equivale a mover todos los expertos a la CPU de una sola vez.
Resultados antes y después del offload
La medición de la prueba se hizo con llama-bench sobre dos modelos: Qwen3.6-27B denso en cuantización IQ4_XS como referencia, y Qwen3.6-35B-A3B en UD-IQ4_XS, un archivo de 16.50 GiB que supera con holgura los 8GB de VRAM. La diferencia entre configuraciones es contundente:
| Modelo | Expertos en RAM | Procesamiento de prompt (tokens/seg) | Generación (tokens/seg) |
|---|---|---|---|
| Qwen3.6-27B denso (IQ4_XS, 14.37 GiB) | No aplica (modelo denso) | 38.83 | 0.75 |
| Qwen3.6-35B-A3B MoE (UD-IQ4_XS, 16.50 GiB) | 0 capas (sin offload) | 109.66 | 4.02 |
| Qwen3.6-35B-A3B MoE (UD-IQ4_XS, 16.50 GiB) | 28 capas | 341.37 | 32.82 |
Resulta destacable que el mismo hardware pase de 4 a casi 33 tokens por segundo solo con la configuración correcta. El modelo denso de 27B, incapaz de descargar expertos porque no los tiene, apenas se sostiene en la laptop. La explicación de fondo está en cómo los modelos Mixture of Experts cambiaron las reglas del hardware para IA local: ya no hace falta que la GPU aloje todos los parámetros para ser útil.
¿Qué se necesita antes de empezar en Windows?
Replicar la experiencia exige un equipo y un entorno mínimos. Estos son los requisitos prácticos para seguir la ruta de la prueba documentada:
| Requisito | Detalle recomendado |
|---|---|
| Sistema operativo | Windows 10 u 11 con PowerShell actualizado |
| GPU con backend CUDA | NVIDIA con 8GB de VRAM, como la RTX 3070 Mobile de la prueba |
| RAM del sistema | 16GB como mínimo absoluto, 32GB como piso cómodo para alojar los expertos descargados |
| Espacio en disco | Aproximadamente 17GB libres para el archivo GGUF del modelo de 16.50 GiB |
| Controladores | Drivers de GPU actualizados y kit de desarrollo CUDA solo si se compila desde fuente |
Quien quiera entender primero qué modelo conviene según su hardware, la guía de LLM locales según tu VRAM en 2026 repasa las opciones por rango de memoria.
¿Cómo instalar llama.cpp en Windows?
El README oficial del proyecto contempla tres rutas de instalación. La primera es la más rápida y se ejecuta desde PowerShell con un único comando:
irm https://llama.app/install.ps1 | iex
Ese comando es la instalación rápida que el propio README documenta para Windows: descarga e instala el CLI y la app de escritorio de llama.app, el sitio oficial del proyecto. El equivalente en Linux o macOS sería curl -LsSf https://llama.app/install.sh | sh.
La segunda ruta, la práctica para replicar la prueba con exactitud, son los binarios precompilados de la página de releases oficial. El proceso en Windows es el siguiente:
- Abrir la página de releases del repositorio ggml-org/llama.cpp.
- Descargar el paquete de Windows con backend CUDA, identificable por incluir CUDA en el nombre del archivo comprimido.
- Descomprimir el paquete en una carpeta de trabajo, por ejemplo D:\llamacpp.
- Verificar que la carpeta contiene los ejecutables llama-cli.exe, llama-server.exe y llama-bench.exe.
- Abrir PowerShell en esa carpeta, manteniendo pulsada la tecla Shift y haciendo clic derecho dentro de la carpeta para seleccionar la opción de abrir la ventana de terminal en la ubicación.
La tercera ruta es la compilación desde el código fuente, para quien necesita un backend específico o la última versión en desarrollo. Consiste en clonar el repositorio y seguir la guía oficial de compilación, que documenta cada backend disponible: CUDA para GPUs NVIDIA, HIP para AMD, Vulkan, SYCL y MUSA. Para la mayoría de los usuarios de Windows con GPU NVIDIA, los binarios precompilados con CUDA hacen innecesario compilar. La guía de llama.cpp con 16GB de RAM y 8GB de VRAM amplía la instalación en Windows y Mac.
¿Cómo se descarga el modelo GGUF correcto?
Aquí está el detalle que más confusiones genera, así que conviene entenderlo bien. En Hugging Face hay varios repositorios con el modelo, pero no todos contienen la misma cuantización:
- Qwen/Qwen3.6-35B-A3B es el repositorio oficial del equipo Qwen, con los pesos originales en formato safetensors, no en GGUF.
- ggml-org/Qwen3.6-35B-A3B-GGUF es el repositorio de la organización que mantiene llama.cpp, con un catálogo limitado de cuantizaciones que incluye Q4_K_M de 20.4 GB, Q8_0 y variantes MTP y DFlash, pero no la UD-IQ4_XS de la prueba.
- unsloth/Qwen3.6-35B-A3B-GGUF contiene la serie de cuantizaciones dinámicas Unsloth Dynamic, identificadas con el prefijo UD-, y es donde vive el archivo Qwen3.6-35B-A3B-UD-IQ4_XS.gguf usado en la prueba. Su propia tarjeta de modelo documenta el uso directo con llama.cpp mediante el patrón -hf.
La descarga automática desde PowerShell con la cuantización exacta de la prueba es este comando:
.\llama-cli.exe -hf unsloth/Qwen3.6-35B-A3B-GGUF:UD-IQ4_XS
Según la documentación oficial de llama-bench, si la cuantización tras los dos puntos no existe en el repositorio se intenta Q4_K_M por defecto o el primer archivo disponible, así que conviene indicarla explícitamente. El parámetro –hf-file existe además para elegir un archivo concreto que anule la cuantización indicada. Quien use el repositorio de ggml-org debe saber que su catálogo de archivos es distinto y que por eso la búsqueda de la cuantización UD-IQ4_XS falla en ese repositorio.
La alternativa manual es abrir en el navegador el repositorio unsloth/Qwen3.6-35B-A3B-GGUF en Hugging Face, descargar el archivo UD-IQ4_XS y guardarlo en la carpeta de trabajo junto a los ejecutables.
¿Dónde queda guardado el modelo descargado con -hf?
Cuando llama.cpp descarga un modelo con -hf, lo guarda siguiendo la estructura de caché de Hugging Face, dentro de una carpeta que sigue el patrón models–organizacion–modelo. Para el repositorio de Unsloth, la ruta queda así:
D:\llamacpp\models–unsloth–Qwen3.6-35B-A3B-GGUF\snapshots\<hash>\
Dentro de la carpeta snapshots, cada descarga tiene su propio subdirectorio identificado con un hash largo, y dentro de ese subdirectorio está el archivo GGUF del modelo. El hash puede variar según la versión del repositorio, así que conviene localizar el archivo con un comando de búsqueda en PowerShell ejecutado desde la carpeta de trabajo:
Get-ChildItem -Recurse -Filter *.gguf | Select-Object FullName
Ese comando lista la ruta completa de todos los archivos GGUF descargados en la caché, que es justo lo que se necesita para el parámetro -m del siguiente paso. La ventaja de esta estructura es que el modelo queda versionado y no se descarga de nuevo en usos posteriores con -hf.
¿Cómo se ejecuta el modelo con el flag en Windows?
Con el modelo ya en disco hay dos rutas de ejecución equivalentes, y conviene conocer ambas porque una evita manejar rutas y la otra da control total sobre el archivo exacto.
La primera es ejecutar directamente desde Hugging Face, con lo que la herramienta localiza el modelo en la caché automáticamente:
.\llama-cli.exe -hf unsloth/Qwen3.6-35B-A3B-GGUF:UD-IQ4_XS -ngl 99 -ncmoe 28 -ctk q8_0 -ctv q8_0 -fa on -c 4096
La segunda es apuntar al archivo GGUF concreto con -m usando la ruta completa encontrada en el paso anterior, escrita entre comillas dobles para que PowerShell la interprete como una sola cadena:
.\llama-cli.exe -m “D:\llamacpp\models–unsloth–Qwen3.6-35B-A3B-GGUF\snapshots\hash\Qwen3.6-35B-A3B-UD-IQ4_XS.gguf” -ngl 99 -ncmoe 28 -ctk q8_0 -ctv q8_0 -fa on -c 4096
Un detalle de PowerShell que ahorra el error más común de este paso: Windows PowerShell no ejecuta programas ubicados en la carpeta actual a menos que el comando incluya el prefijo .\ delante del nombre del ejecutable. Escribir solo llama-cli.exe produce el mensaje de que el término no se reconoce como comando, aunque el archivo esté presente en la carpeta. Las dos alternativas válidas son agregar la carpeta al PATH del sistema con setx PATH “$env:PATH;D:\llamacpp” y reabrir la terminal, o usar el símbolo del sistema cmd en lugar de PowerShell, que sí ejecuta binarios de la carpeta actual sin prefijo.
Cada parámetro del comando corresponde a la referencia oficial de llama-cli y tiene un propósito concreto:
| Parámetro | Qué hace según la documentación oficial |
|---|---|
| -hf o -m | Descarga y usa el modelo desde Hugging Face, o carga el archivo GGUF local indicado |
| -ngl 99 | Carga las capas del modelo en la GPU; 99 cubre todas |
| -ncmoe 28 | Mantiene en la RAM del sistema los expertos de las primeras 28 capas; su valor por defecto es 0 |
| -ctk q8_0 -ctv q8_0 | Establece el tipo de datos del caché KV para K y V; el valor por defecto es f16 y los valores permitidos incluyen f32, f16, bf16, q8_0, q4_0, q4_1, iq4_nl, q5_0 y q5_1 |
| -fa on | Activa Flash Attention; su valor por defecto es auto |
| -c 4096 | Define el tamaño del contexto de la sesión; el valor 0 significa que se usa el del modelo |
Al ejecutar el comando, el modelo carga mostrando en pantalla el reparto de capas entre GPU y CPU, y abre el chat interactivo en la misma terminal. Quien prefiera exponer el modelo como servicio local con una API compatible con OpenAI puede usar el mismo conjunto de flags con .\llama-server.exe en lugar de llama-cli.exe, tras lo cual cualquier aplicación local puede conectarse al endpoint.
¿Cómo verificar la mejora con llama-bench?
La medición replicable es la parte más valiosa del proceso, porque permite comparar el antes y el después en el propio equipo. Según la documentación oficial, llama-bench es la herramienta de pruebas de rendimiento de llama.cpp y puede ejecutar tres tipos de prueba: el procesamiento de prompt con -p, la generación de texto con -n y la combinación de ambas con -pg. Cada prueba se repite el número de veces indicado por -r, cuyo valor por defecto es 5, y los resultados se entregan como promedio de tokens por segundo con su desviación estándar. La documentación aclara además que las mediciones no incluyen los tiempos de tokenización ni de muestreo.
Este fue el comando completo de la prueba en Windows, con la variante -m apuntando a los archivos locales:
.\llama-bench.exe -m Qwen3.6-27B-IQ4_XS.gguf -m Qwen3.6-35B-A3B-UD-IQ4_XS.gguf -ngl 99 -ncmoe 0,28 -p 512 -n 128 -r 3 -ctk q8_0 -ctv q8_0
Un detalle de sintaxis que la documentación oficial explica y que hace poderoso a llama-bench: casi todos los parámetros aceptan múltiples valores separados por comas, y la herramienta ejecuta una prueba por cada combinación posible. Por eso -ncmoe 0,28 genera dos configuraciones en una sola corrida: una sin offload y otra con los expertos de 28 capas en la RAM. Los valores por defecto de -p 512 y -n 128 son exactamente los que la prueba usó, y el valor -r 3 baja las repeticiones de 5 a 3 por corrida para acortar la medición. Con -hf también funciona la descarga directa del repositorio unsloth/Qwen3.6-35B-A3B-GGUF, con la misma sintaxis de cuantización tras los dos puntos.
| Flag | Qué hace según el README oficial |
|---|---|
| -m o -hf | Especifica el modelo a probar; puede repetirse para comparar varios archivos GGUF o repositorios |
| -ngl 99 | Número de capas cargadas en la GPU; su valor por defecto es -1 |
| -ncmoe 0,28 | Número de capas MoE cuyos expertos se mantienen en la CPU; acepta múltiples valores separados por comas para probar varias configuraciones a la vez |
| -p 512 | Tokens del prompt para la prueba de procesamiento; su valor por defecto es 512 |
| -n 128 | Tokens a generar en la prueba de generación; su valor por defecto es 128 |
| -r 3 | Repeticiones por prueba, cuyo promedio se reporta; su valor por defecto es 5 |
| -ctk q8_0 -ctv q8_0 | Tipo de datos del caché KV para K y V; su valor por defecto es f16 |
Al terminar, llama-bench imprime la tabla de resultados con las velocidades de procesamiento de prompt y de generación para cada configuración, exactamente el formato con el que se construyó la tabla de resultados de la prueba original. La herramienta también puede exportar los resultados en formato CSV, JSON, JSONL, Markdown o SQL con el parámetro -o, útil para guardar un historial de mediciones del propio equipo. Antes de cualquier medición conviene ejecutar .\llama-bench.exe –list-devices para confirmar que la GPU aparece correctamente detectada con su backend CUDA.
¿Qué errores comunes aparecen en Windows y cómo se resuelven?
El flujo completo suele toparse con unos pocos mensajes de error conocidos. Esta tabla reúne los más frecuentes y su solución directa:
| Error | Causa | Solución |
|---|---|---|
| El término llama-cli.exe no se reconoce como nombre de un cmdlet | PowerShell no ejecuta binarios de la carpeta actual sin prefijo | Escribir el comando con el prefijo .\ delante del ejecutable, o agregar la carpeta al PATH con setx y reabrir la terminal |
| common_download_get_hf_plan: no GGUF files found in repository | El repositorio indicado no contiene la cuantización solicitada; el repositorio de ggml-org no incluye la UD-IQ4_XS de la prueba | Usar el repositorio correcto con la cuantización existente: -hf unsloth/Qwen3.6-35B-A3B-GGUF:UD-IQ4_XS, o descargar el archivo manualmente desde el repositorio de Unsloth |
| El modelo no se encuentra con -m | La ruta apunta a la carpeta de caché y no al archivo GGUF concreto, o el hash del snapshot cambió | Localizar el archivo con Get-ChildItem -Recurse -Filter *.gguf y usar la ruta completa entre comillas dobles, o ejecutar con -hf para que la caché se resuelva sola |
| Error al iniciar porque falta una DLL, como cudart o vcomp | Se descargó un paquete de release incompleto o sin las DLL del backend | Descargar de nuevo el paquete completo de Windows con CUDA desde la página de releases oficial y verificar que las DLL acompañan a los ejecutables |
| Fallo de carga del modelo por memoria insuficiente en GPU | El valor de N en -ncmoe no descarga suficientes capas de expertos | Subir N de forma gradual hasta que la carga quepa, o cuantizar el caché KV con -ctk q8_0 -ctv q8_0 para liberar VRAM |
| La carga se queda lenta o se detiene en un porcentaje | El archivo GGUF está en un disco lento o el sistema está paginando memoria | Mover el modelo a un SSD y verificar que la RAM libre supera el tamaño de los expertos descargados |
¿Cómo elegir el valor correcto de N?
El ajuste de N es un balance entre memoria y velocidad, y conviene hacerlo de forma incremental. Cada capa de expertos movida a la RAM libera VRAM, pero cada token que toca un experto descargado paga el costo de transferencia por el bus PCIe hacia la GPU:
- Empezar en valores bajos: si el modelo no cabe, subir N de forma gradual hasta que la carga quepa sin errores de memoria.
- Detenerse apenas quepa: un N mayor del necesario reduce velocidad sin beneficio adicional.
- Combinar con cuantización del caché KV: usar -ctk y -ctv en q8_0 puede ahorrar la VRAM suficiente para bajar N y ganar velocidad.
- Vigilar la RAM libre: los expertos descargados viven en memoria del sistema junto al resto de los procesos, así que el margen disponible marca el techo real de N.
La técnica tiene condiciones claras y solo funciona con modelos MoE, no con modelos densos como el Qwen3.6-27B usado como referencia en la prueba. Quien quiera descartar lecturas contaminadas por la paginación de disco puede consultar el parámetro -lm, –load-mode de la referencia oficial, que controla cómo se carga el modelo en memoria e incluye un modo mlock para forzar al sistema a mantenerlo en RAM sin intercambio.
¿Por qué importa para la IA local en laptop?
Lo más valioso del hallazgo no es el número, sino el acceso que habilita. Durante años, el modelo mental dominante fue que solo una estación de trabajo podía ejecutar modelos serios y que la laptop debía conformarse con variantes pequeñas. Esta prueba subvierte esa expectativa: con los flags correctos, un modelo de 35B puede viajar en la laptop, útil en un vuelo, en un hotel o en un lugar sin red, sin depender de ninguna nube.
La conclusión práctica es directa. Antes de descartar un modelo por su tamaño de archivo, conviene revisar su arquitectura: si es MoE y activa pocos parámetros por token, la VRAM de la etiqueta del equipo dejó de ser el límite que parecía. Con una instalación oficial de llama.cpp, el archivo GGUF correcto y un solo flag, una GPU modesta puede convertirse en una máquina de inferencia de una categoría totalmente distinta.
Lo más leído en Curiosidades
-
 Curiosidades
Sistema de pivote de carrera con IA: 6 prompts para reinventar tu camino profesional
Muchos profesionales se postulan solo a los puestos que ya conocen, cuando su experiencia real los califica para…
-
 Curiosidades
Kimi K3 en C: un modelo de 2.78 billones de parámetros corre en 8 GB de RAM
Un desarrollador logró ejecutar el modelo Kimi K3 de 2.78 billones de parámetros en una CPU común con…




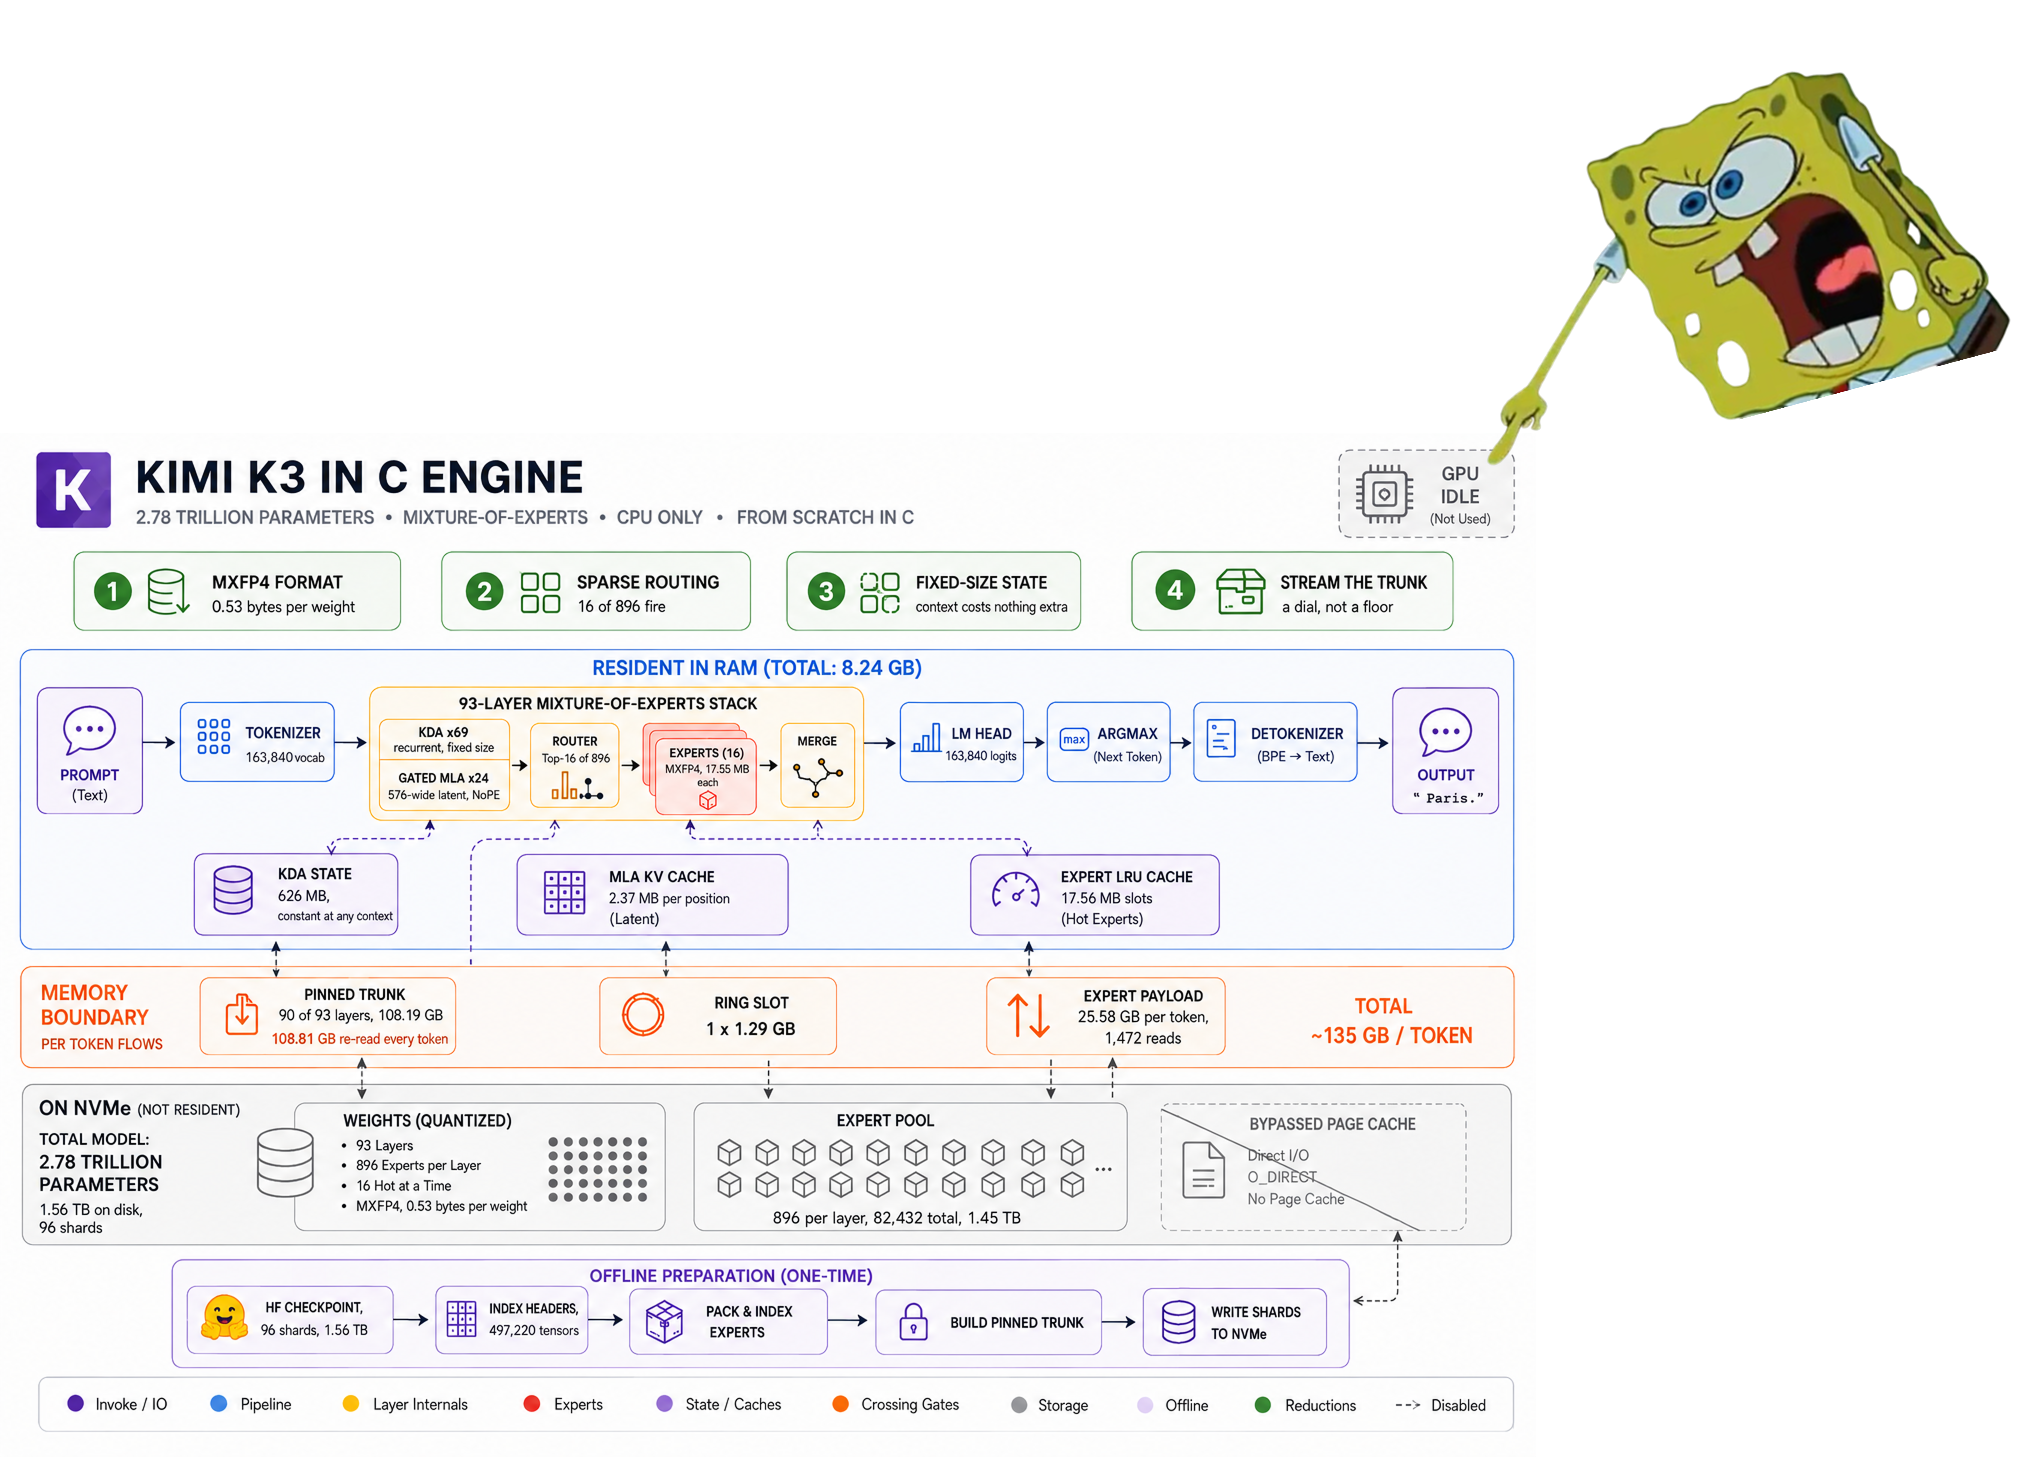
Un desarrollador logró ejecutar el modelo Kimi K3 de 2.78 billones de parámetros en una CPU común con solo 8.24 GB de RAM, sin GPU, sin frameworks y sin BLAS. El proyecto se llama kimi-k3-in-c, está escrito en C99 portable, supera las 12 mil estrellas en GitHub y se distribuye bajo licencia Apache 2.0.
Lo más leído en Curiosidades
-
Curiosidades
Sistema de pivote de carrera con IA: 6 prompts para reinventar tu camino profesional
Muchos profesionales se postulan solo a los puestos que ya conocen, cuando su experiencia real los califica para…
-
Curiosidades
Kimi K3 en C: un modelo de 2.78 billones de parámetros corre en 8 GB de RAM
Un desarrollador logró ejecutar el modelo Kimi K3 de 2.78 billones de parámetros en una CPU común con…

Muchos profesionales se postulan solo a los puestos que ya conocen, cuando su experiencia real los califica para mucho más. Este sistema de seis prompts convierte la inteligencia artificial en un consultor de carrera que descubre roles ocultos, traduce tus habilidades a nuevas industrias y construye un plan de transición de 30 días. Todo el proceso cabe en una tarde de trabajo bien aprovechada.
Lo más leído en Curiosidades
-
Curiosidades
Sistema de pivote de carrera con IA: 6 prompts para reinventar tu camino profesional
Muchos profesionales se postulan solo a los puestos que ya conocen, cuando su experiencia real los califica para…
-
Curiosidades
Kimi K3 en C: un modelo de 2.78 billones de parámetros corre en 8 GB de RAM
Un desarrollador logró ejecutar el modelo Kimi K3 de 2.78 billones de parámetros en una CPU común con…
Presionar Comando + barra espaciadora abre Spotlight y, dentro de ese campo de búsqueda, Comando + 4 activa la búsqueda en el portapapeles de la Mac. Es un tip documentado por Apple que permite localizar y actuar sobre el texto copiado sin abrir ninguna app.
Lo más leído en Curiosidades
-
Curiosidades
Sistema de pivote de carrera con IA: 6 prompts para reinventar tu camino profesional
Muchos profesionales se postulan solo a los puestos que ya conocen, cuando su experiencia real los califica para…
-
Curiosidades
Kimi K3 en C: un modelo de 2.78 billones de parámetros corre en 8 GB de RAM
Un desarrollador logró ejecutar el modelo Kimi K3 de 2.78 billones de parámetros en una CPU común con…
Lo más leído
-
 Desarrolladores
Gemini 4 Carbon ya está disponible para desarrolladores empresas y usuarios de Google
-
 Audio
Podcast ONE: 13 de noviembre de 2026
-
 Buen Fin
LG Electronics celebra El Buen Fin 2026 con descuentos de hasta 60% en su tienda en línea
-
 Android
Waydroid llega a los repositorios oficiales de Ubuntu 26.04 LTS
-
Curiosidades
Kimi K3 en C: un modelo de 2.78 billones de parámetros corre en 8 GB de RAM
-

 Apps11 años ago
AMPcast, la herramienta de Pandora que permite a los artistas grabar mensajes de audio directamente a sus seguidores
-
 Blogs5 años ago
Conoce los mejores sitios de Torrents para descargar todo tipo de contenidos
-
Android5 años ago
Aprende cómo usar Discord para ver películas con tus amigos
-
Arte y Cultura14 años ago
Colección de fondos de pantalla basados en Super Héroes
-

 Almacenamiento2 años ago
Cómo usar TeraBox: La guía definitiva para aprovechar 1 TB de almacenamiento en la nube
-
Diseño13 años ago
css3ps: plugin que convierte archivos PSD a CSS3
-
Apps9 años ago
Picturethat, app que usa la Realidad Aumentada para visualizar cómo quedarían los cuadros antes de colgarlos
-
Eventos Especiales14 años ago
Especial Día de la Madres: fondos de pantalla especiales para Mamá