

Curiosidades
¿Vale la pena usar Bonsai 27B en equipos con 8 GB de VRAM?

La respuesta corta es sí, pero con matices importantes. Bonsai 27B permite correr en una GPU de 8 GB un modelo derivado de Qwen3.6 27B gracias a una compresión extrema de 1 bit y a un build de apenas 4.4 GB. Eso, por sí solo, ya lo convierte en una rareza valiosa dentro del ecosistema local. La pregunta real no es si cabe, sino qué conserva, qué pierde y para qué tareas sigue siendo una buena decisión.
Durante años, el criterio práctico para elegir un LLM local en una tarjeta de 8 GB fue resignarse a modelos pequeños. En ese rango, la conversación giraba alrededor de variantes de 4B a 9B, porque cualquier modelo denso serio simplemente quedaba fuera por tamaño. Un 27B en 4 bits rebasa con claridad lo que una GPU de 8 GB puede absorber con comodidad, y descargar parte del modelo a la RAM del sistema suele degradar tanto la velocidad que deja de compensar. Bonsai entra en escena precisamente para romper ese límite desde otro ángulo: no mediante más memoria, sino mediante una compresión muchísimo más agresiva.
Para entender por qué eso importa conviene partir de la guía de LLM locales según tu VRAM. Ese mapa sigue siendo válido como punto de partida. Lo que Bonsai introduce es una excepción interesante: en vez de conformarse con un modelo pequeño, intenta conservar una base de conocimiento mucho mayor dentro de una tarjeta modesta.
¿Qué es Bonsai 27B?
Bonsai 27B es una versión comprimida de Qwen3.6 27B creada por PrismML. No es un modelo nuevo en el sentido arquitectónico, sino una reinterpretación extrema de sus pesos para reducir drásticamente su tamaño final. El modelo base sigue siendo Qwen3.6 27B; lo que cambia es la forma en que esos pesos se representan y almacenan.
La propuesta de PrismML consiste en llevar la compresión hasta el terreno binario. En vez de usar varios bits por parámetro, cada peso queda representado como uno de dos valores posibles, +1 o -1, acompañado de un factor de escala compartido por grupos de 128 pesos. Por eso el resultado efectivo ronda los 1.125 bits por peso y no un bit exacto sin sobrecostes.
Ese detalle técnico importa porque explica el verdadero atractivo de Bonsai: mantener un modelo de 27B en un tamaño que normalmente se asocia a familias muchísimo más pequeñas.
¿Por qué Bonsai 27B llama tanto la atención en una GPU de 8 GB?
Porque un modelo de 27B a plena precisión suele superar los 50 GB, y su equivalente en 4 bits sigue quedando muy lejos del margen realista de una GPU de 8 GB. Bonsai, en cambio, aparece en un build Q1_0 Staff Pick de 4.4 GB, con los archivos de visión incluidos. En otras palabras, el tamaño bruto del archivo deja de ser una barrera inmediata.
Eso no significa que toda la experiencia de inferencia pase a ser trivial. El modelo cabe, sí, pero el contexto, la caché y los buffers también consumen memoria. El gran mérito de Bonsai no es convertir una tarjeta pequeña en una estación de trabajo, sino permitir que un modelo de este tamaño entre por fin en la conversación local con hardware doméstico.
¿Qué significa realmente “cabe” en una tarjeta de 8 GB?
Significa que el archivo del modelo puede residir en la VRAM sin exigir, de entrada, una tarjeta mayor. No significa que cualquier longitud de contexto, cualquier carga multimodal o cualquier sesión larga vaya a desarrollarse sin tensiones.
Bonsai hereda de Qwen3.6 una ventana de contexto de 262K tokens y una atención en buena parte lineal, más ligera que la de muchos modelos tradicionales. Aun así, el contexto completo ronda los 10 GB incluso con la caché comprimida. Por eso, en una GPU de 8 GB, el rango práctico se sitúa entre 30K y 50K tokens si se deja margen al sistema y al resto de aplicaciones.
Ese dato cambia bastante la conversación. Bonsai no elimina las restricciones de una tarjeta de 8 GB: las reorganiza. El modelo entra; la sesión debe seguir siendo administrada con criterio.
¿Qué se gana a cambio de tanta compresión?
Se gana, sobre todo, tamaño de conocimiento dentro de un hardware donde normalmente no cabría nada parecido. Bonsai no intenta ser el modelo más rápido ni el más estable en todas las tareas. Su apuesta consiste en ofrecer un volumen de parámetros y una profundidad conceptual que una GPU de 8 GB normalmente no puede alojar.
Eso se nota especialmente en tres áreas: razonamiento lógico, matemáticas y seguimiento de instrucciones. Según las cifras publicadas por PrismML, la caída frente a Qwen3.6 completo en esos terrenos es más contenida de lo que cabría esperar para una compresión de 1 bit.
| Prueba | Bonsai 27B (1 bit) | Qwen3.6 27B plena precisión |
|---|---|---|
| Matemáticas | 91.7 | 95.3 |
| Código (HumanEval+) | 89.6 | 95.1 |
| Tool calling y tareas agénticas | 66.0 | 80.0 |
La tabla deja algo muy claro: donde Bonsai justifica su existencia no es en una imitación perfecta del modelo base, sino en la capacidad de conservar bastante competencia en tareas de razonamiento y texto estructurado dentro de un presupuesto de memoria radicalmente menor.
¿Dónde se comporta mejor Bonsai 27B?
El patrón más convincente aparece en la lógica. Ante un problema de precios con varias combinaciones posibles, Bonsai recorrió todas las opciones válidas antes de elegir la más barata. Ese tipo de comportamiento es importante porque la lógica combinatoria suele degradarse pronto cuando una cuantización empuja demasiado la pérdida.
También sale bien parado en seguimiento de instrucciones. Con una descripción de producto y varias reglas simultáneas, incluidas palabras prohibidas, formato concreto de precio y estructura obligatoria, el modelo mantuvo el control y respetó las restricciones. En resúmenes de documentos largos, la salida se mantuvo sobria, clara y estable sin necesidad de fragmentar el texto.
Ese es el terreno donde Bonsai cobra sentido: tareas donde importa más la estructura del pensamiento y la obediencia formal al prompt que la interacción con herramientas o la visión detallada.
¿Dónde empieza a sentirse el recorte?
La compresión se nota más en dos frentes: tool calling y trabajo visual. En tareas agénticas con herramientas, la caída de 80.0 a 66.0 es demasiado grande para tratarla como un detalle menor. Eso no convierte a Bonsai en inutilizable, pero sí lo saca del primer lugar cuando la tarea depende de invocar funciones, encadenar herramientas o mantener flujos complejos con componentes externos.
En visión ocurre algo parecido. Ante una captura de una app de diseño, Bonsai acertó con dimensiones y colores hexadecimales, pero repitió listas varias veces y confundió algunos nombres con ajustes. Es decir, puede extraer señales útiles de una imagen, aunque no con la consistencia que conviene esperar de un modelo más asentado en multimodalidad.
En código, la pérdida es más sutil. No necesariamente rompe la forma del programa, pero sí puede erosionar su solidez. El ejemplo citado describe un script para vigilar carpetas que parecía terminado, pero no registraba los archivos ya procesados y habría releído continuamente los mismos elementos. En términos prácticos, eso significa que Bonsai puede escribir código convincente sin garantizar el mismo nivel de fiabilidad que el modelo base.
¿Qué tan rápido es frente a otras opciones de 8 GB?
En la comparación directa citada, Bonsai rindió a 27 tokens por segundo frente a los 35 tokens por segundo de Gemma 4 E4B con ajustes equivalentes. La diferencia no lo vuelve lento en términos absolutos, pero sí deja claro que no está optimizado para liderar en velocidad dentro de esta franja.
Su propuesta es otra: ofrecer más tamaño de modelo del que una tarjeta de 8 GB suele admitir. Por eso su comparación justa no pasa solo por tokens por segundo, sino por la relación entre volumen de conocimiento, compresión y utilidad real.
¿Qué modelos siguen siendo mejores según el tipo de tarea?
La mejor lectura de Bonsai no es preguntarse si reemplaza todo, sino en qué conviene usarlo y en qué no. La comparación práctica queda así:
| Modelo | Tamaño del build | GPU de 8GB | Punto fuerte | Punto débil |
|---|---|---|---|---|
| Bonsai 27B (Q1_0) | 4.4 GB | Cabe con margen | Lógica, matemáticas y seguimiento de instrucciones | Tool calling e imágenes |
| Qwen 3.5 9B | Rango pequeño | Cabe con margen | Tool calling probado | Menor base de conocimiento |
| Gemma 4 E4B | Rango pequeño | Cabe con margen | Imágenes vía proyecciones ligeras | Menor base de conocimiento |
| Qwen3.6-35B-A3B | Build de 4 bits | Requiere más VRAM o reparto con RAM | Rendimiento general superior | Fuera del alcance directo de 8 GB |
Eso sitúa a Bonsai como una tercera vía entre los modelos pequeños tradicionales y las familias mayores que ya piden más memoria. Para ampliar esa comparación conviene revisar también la comparativa de uno o dos modelos pequeños con poca VRAM. Bonsai ocupa precisamente el hueco que esa disyuntiva dejaba abierto.
¿Qué configuración conviene usar?
PrismML publica recomendaciones de muestreo específicas para Bonsai, y conviene respetarlas. El modelo fue evaluado con esos valores, así que aplicar presets de otras familias puede degradar el resultado sin necesidad. La configuración base queda así:
| Parámetro | Valor recomendado | Motivo |
|---|---|---|
| Temperatura | 0.7 | Recomendación oficial de PrismML |
| Top-p | 0.95 | Recomendación oficial de PrismML |
| Top-k | 20 | Recomendación oficial de PrismML |
| Penalización de repetición | Desactivada | Recomendación oficial de PrismML |
| Penalización de presencia | Desactivada | Recomendación oficial de PrismML |
| Contexto | 30K a 50K tokens | Techo práctico en 8 GB de VRAM con margen para otros programas |
Guardar estos valores como preset en LM Studio es una buena idea. Un cambio pequeño en temperatura o penalizaciones puede alterar el comportamiento lo bastante como para que parezca que el modelo falló, cuando en realidad lo hizo la configuración.
¿Cómo se prueba correctamente en LM Studio?
El flujo práctico conviene seguirlo sin improvisaciones:
- Descargar el build Q1_0 Staff Pick de 4.4 GB con visión incluida.
- Cargarlo como un GGUF estándar en LM Studio.
- Aplicar el preset de muestreo con temperatura 0.7, top-p 0.95 y top-k 20.
- Fijar el contexto en el rango práctico de 30K a 50K tokens.
- Probar primero tareas textuales: razonamiento, resúmenes, instrucciones complejas y problemas lógicos.
La versión ternaria de Bonsai 2 queda fuera de este flujo porque no es la variante utilizada en la configuración descrita. El punto de partida verificable dentro de LM Studio es el build binario Q1_0.
¿Cuándo no conviene usar Bonsai 27B?
No conviene elegirlo como primera opción si la prioridad es tool calling fiable, trabajo visual preciso o máxima velocidad por token dentro de una tarjeta de 8 GB. Tampoco es la mejor apuesta si el objetivo es una experiencia simple y universal: Bonsai necesita entenderse como un modelo especializado, no como un sustituto automático de cualquier otro LLM local.
Tampoco conviene confundir el tamaño del archivo con una experiencia garantizada sin fricción. El modelo pesa 4.4 GB, pero el trabajo real también incluye contexto, caché y buffers. Bonsai resuelve el problema del peso del modelo, no el de toda la memoria asociada a sesiones largas.
¿Qué sí conviene esperar de Bonsai 27B?
Conviene verlo como un especialista en compresión extrema que preserva sorprendentemente bien lógica, matemáticas, instrucciones y trabajo textual largo. Su valor no está en superar a todos los modelos pequeños de 8 GB en todo, sino en permitir una clase de razonamiento y una profundidad de conocimiento que normalmente no caben en esa tarjeta.
Esa es su verdadera promesa: no convertir una GPU de 8 GB en hardware de gama alta, sino ampliar de forma tangible el tamaño de modelo que esa tarjeta puede ejecutar con utilidad real.
¿Con qué otros modelos conviene combinarlo?
La combinación práctica más clara es esta:
- Bonsai 27B para lógica, matemáticas, resúmenes y seguimiento estricto de instrucciones.
- Gemma 4 E4B para imagen y tareas multimodales ligeras.
- Qwen 3.5 9B o un Qwen pequeño equivalente para tool calling y tareas agénticas más previsibles.
Ese reparto evita exigirle a Bonsai lo que la compresión penaliza más y permite aprovechar justo aquello que lo vuelve singular.
¿Vale la pena usar Bonsai 27B en equipos con 8 GB de VRAM?
Sí, siempre que se entienda bien qué se está comprando. Vale la pena si el objetivo es llevar a una GPU pequeña un volumen de conocimiento muy superior al que normalmente cabe en ella. Vale la pena si se priorizan lógica, matemáticas, instrucciones y resúmenes. Vale la pena si el usuario acepta complementar ese modelo con otros más adecuados para herramientas o visión.
No es la elección ideal para todo. No sustituye a Qwen completo, ni convierte una tarjeta de 8 GB en una estación de trabajo de gama alta. Lo que sí hace es abrir una puerta que, hasta hace poco, estaba cerrada: devolver relevancia práctica a una GPU modesta frente a modelos de tamaño grande. Y eso, en hardware local, ya es una ganancia importante.






El desarrollador Troygentic lanzó DamnationX, una versión especial de DevilutionX que funciona como remake fan de Diablo 1 con gráficos modernizados. El proyecto, gratuito y no oficial, incorpora texturas en alta definición, iluminación con ray tracing y cooperación en línea, y se puede jugar tanto en el navegador como en escritorio.
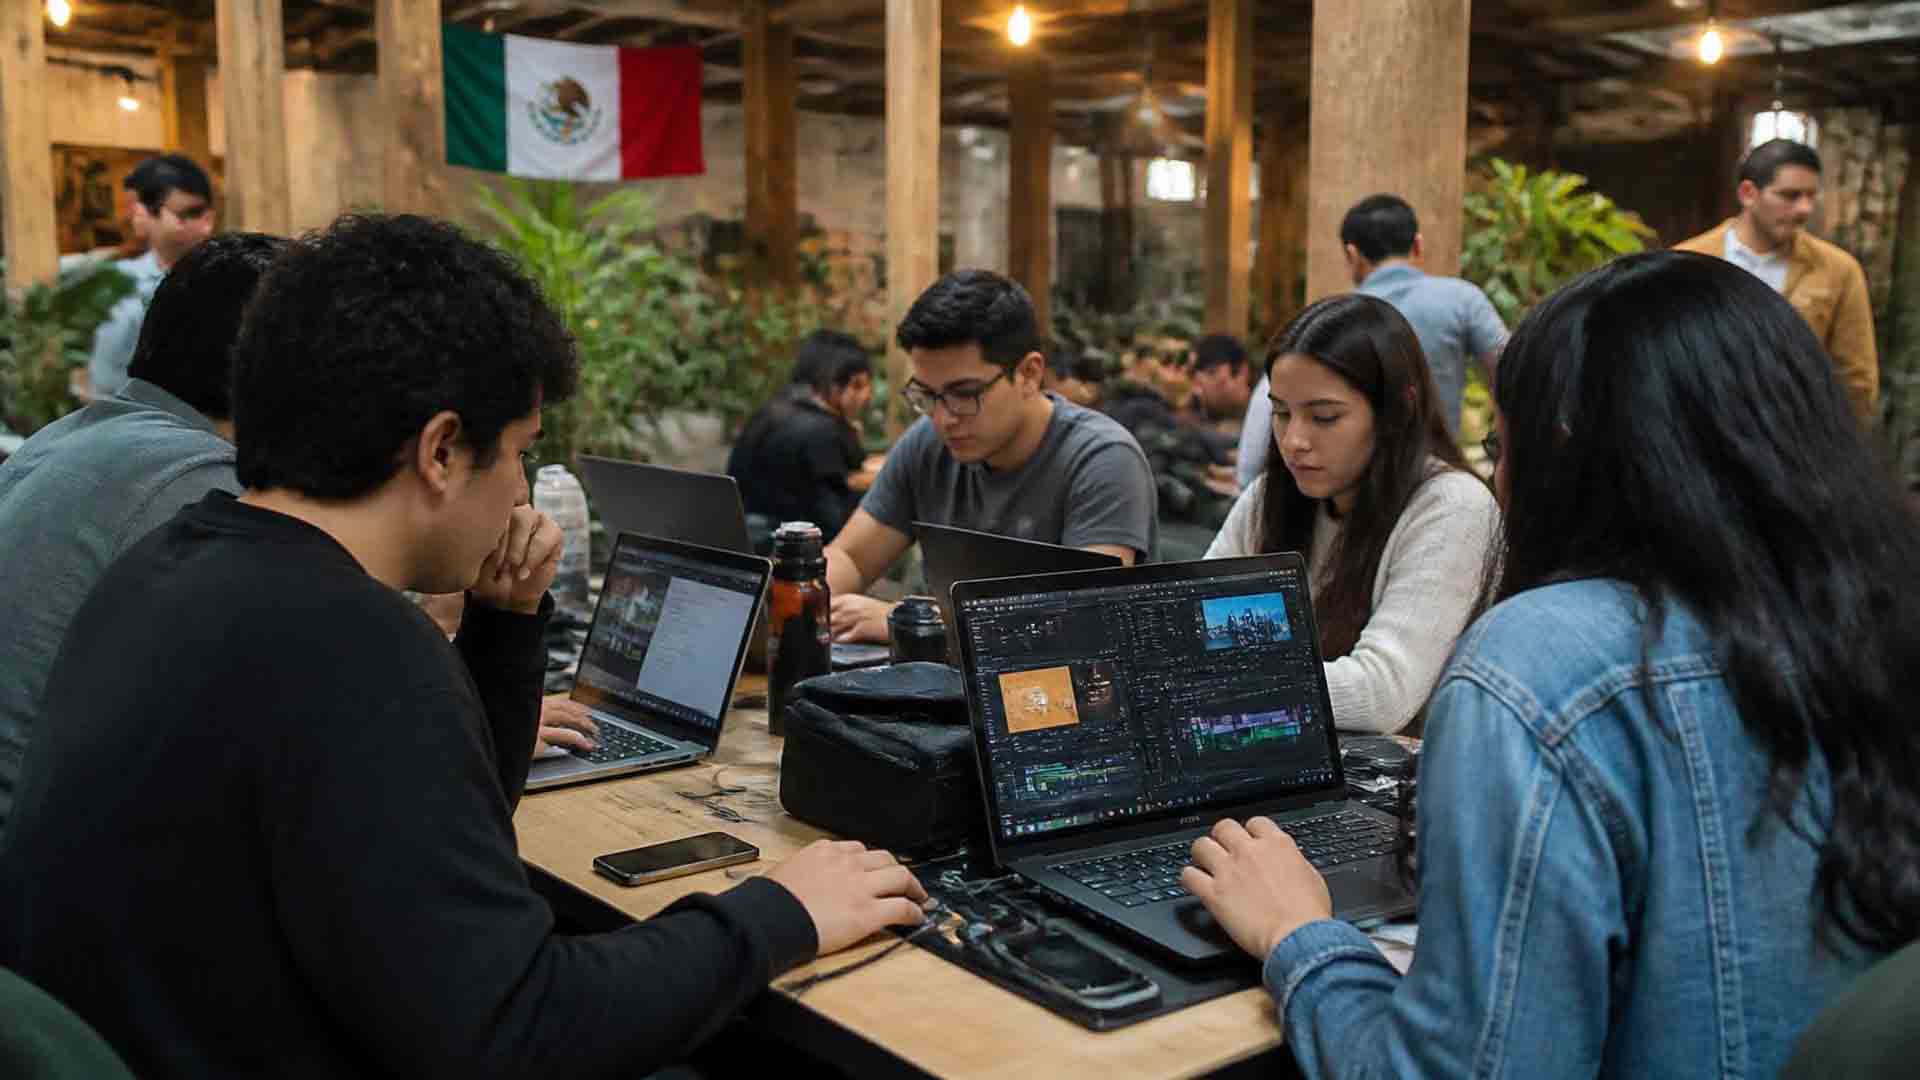
CapCut participará en México Tech Week 2026 con el CapCut Design Studio: Speed-to-Scale Hackathon, una activación gratuita para crear en cuatro horas una pieza lista para mostrar usando herramientas de IA. El cupo es de 30 lugares con registro previo.
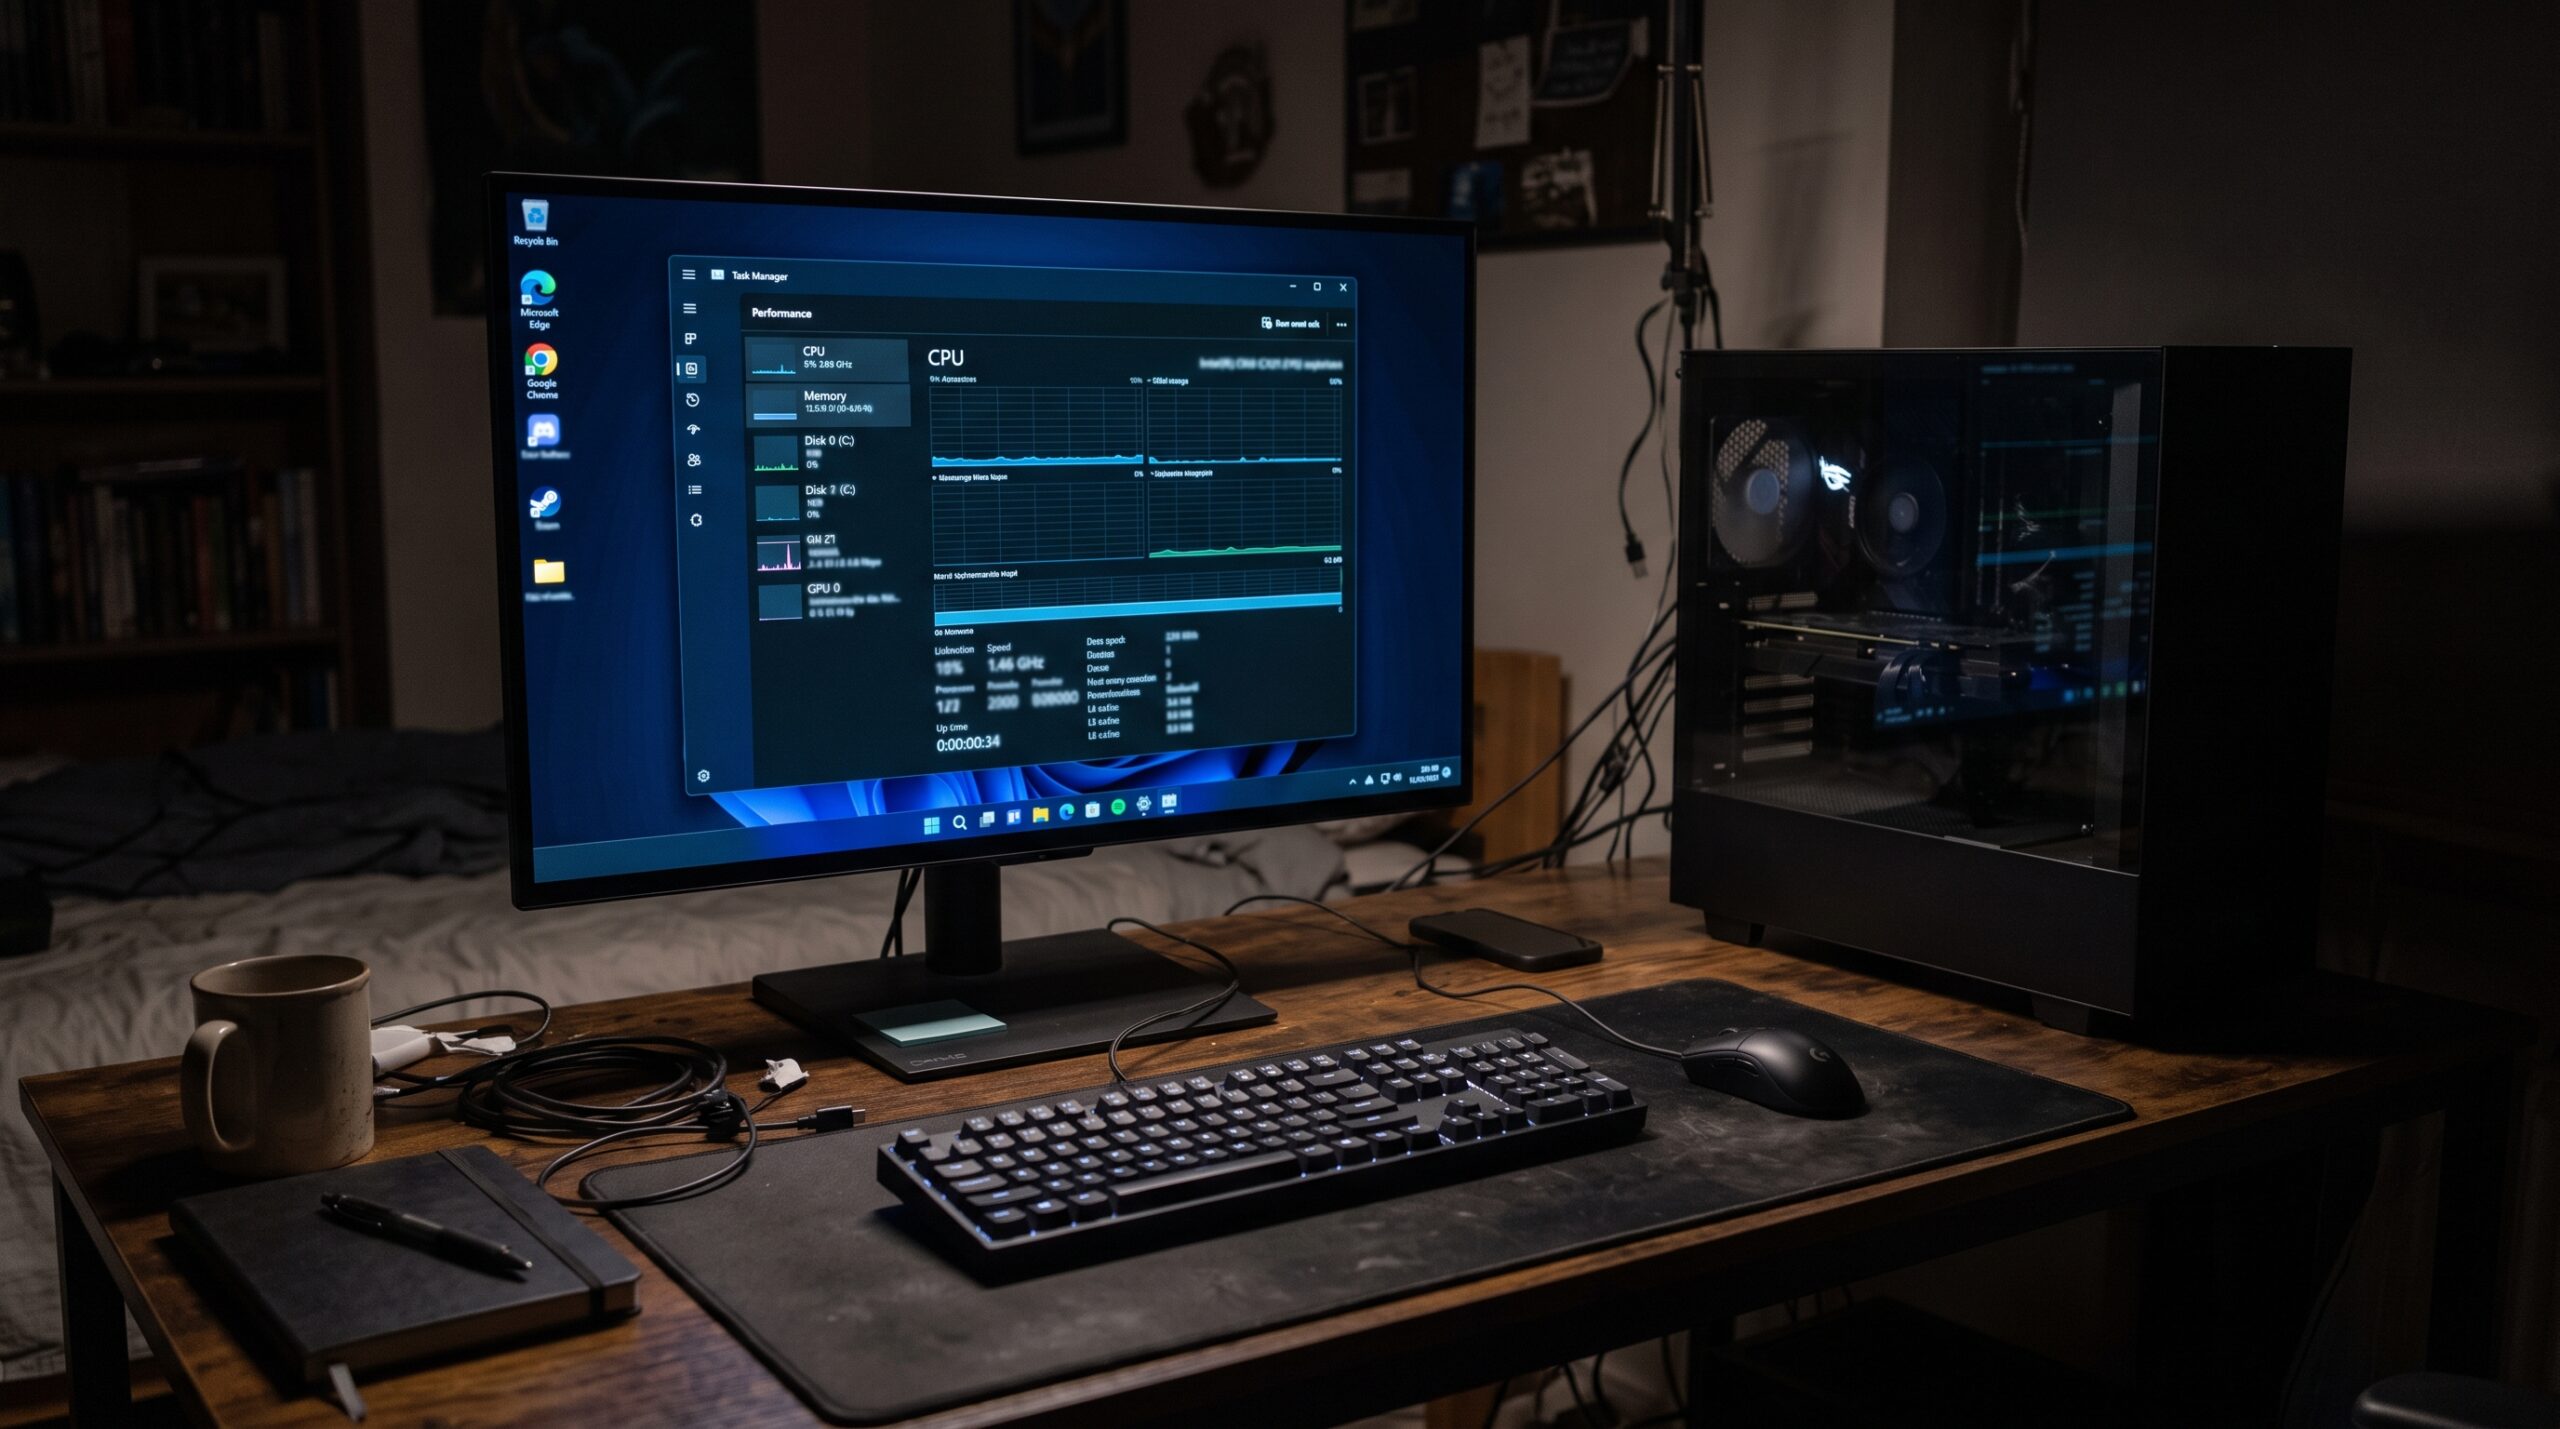
El usuario @soyaakinohara6 compartió en X una instalación de Windows 11 que consume apenas 2.5GB de 16GB de RAM en reposo, un 16 por ciento de utilización. El método: instalar con Rufus, eliminar todo el bloatware y luego aplicar la actualización 26H2.
-

 Apps11 años ago
AMPcast, la herramienta de Pandora que permite a los artistas grabar mensajes de audio directamente a sus seguidores
-
 Blogs5 años ago
Conoce los mejores sitios de Torrents para descargar todo tipo de contenidos
-
Android5 años ago
Aprende cómo usar Discord para ver películas con tus amigos
-
Arte y Cultura14 años ago
Colección de fondos de pantalla basados en Super Héroes
-

 Almacenamiento2 años ago
Cómo usar TeraBox: La guía definitiva para aprovechar 1 TB de almacenamiento en la nube
-
Diseño13 años ago
css3ps: plugin que convierte archivos PSD a CSS3
-
Apps9 años ago
Picturethat, app que usa la Realidad Aumentada para visualizar cómo quedarían los cuadros antes de colgarlos
-
Eventos Especiales13 años ago
Especial Día de la Madres: fondos de pantalla especiales para Mamá