
Especificaciones
Guía 2026: modelos de lenguaje locales para equipos domésticos con 8 GB de memoria

¿Quieres ejecutar inteligencia artificial avanzada en tu computadora personal sin gastar en hardware costoso? Esta guía te muestra cómo aprovechar modelos de lenguaje locales como Gemma 4 y Qwen 3 en equipos con solo 8 GB de memoria de video o RAM. Aprenderás a instalar, configurar y optimizar estos modelos para obtener el mejor rendimiento, incluso con el poderoso Qwen 3.6 MoE (35 mil millones de parámetros) mediante técnicas de cuantización y trasvase a la CPU. Ideal para quienes buscan privacidad y eficiencia sin invertir en equipos de alta gama.
El ecosistema explicado: ¿qué es Ollama?
Piensa en Ollama como el “motor” que permite ejecutar estos complejos modelos de inteligencia artificial directamente en tu computadora. Se encarga de toda la configuración complicada, permitiéndote descargar y conversar con diferentes modelos mediante comandos muy sencillos. Es la pieza clave que hace que todo esto sea accesible.
Tu primera IA funcional en cinco minutos
Si buscas una solución rápida, sigue estos tres pasos para tener un asistente funcional en menos de lo que tardas en prepararte un café.
- Instala Ollama.
- En Linux o macOS: Abre una terminal y ejecuta:
curl -fsSL [https://ollama.com/install.sh](https://ollama.com/install.sh) | sh - En Windows: Descarga el instalador desde su sitio web oficial y ejecútalo.
- En Linux o macOS: Abre una terminal y ejecuta:
- Abre una terminal (o PowerShell en Windows) y ejecuta el siguiente comando:
ollama run gemma4:e4b - Espera a que descargue el modelo (unos 9.6 GB) y comienza a interactuar directamente en la terminal.
¡Listo! Ya tienes un asistente de IA multimodal funcionando localmente.
Cómo elegir el modelo de lenguaje adecuado
Esta tabla comparativa te ayudará a elegir el modelo correcto según tus necesidades y los recursos de tu equipo. Los datos han sido validados para reflejar los modelos disponibles y funcionales en abril de 2026.
| Modelo | Parámetros | Contexto máximo | Memoria de video requerida (Q4_K_M) | Memoria RAM requerida (sin GPU) | Comando de descarga | Casos de uso destacados | Licencia |
|---|---|---|---|---|---|---|---|
| Gemma 4 E4B | ~8.000 millones (~4.5B efectivos) | 128.000 tokens | 6-7 GB | 10-12 GB | ollama pull gemma4:e4b |
Conversación, resúmenes, análisis de imágenes y audio | Gemma Terms of Use |
| Qwen 3 8B | 8.000 millones | 32.000 tokens | 6-7 GB | 10-12 GB | ollama pull qwen3:8b |
Análisis de documentos, generación de texto, español nativo | Apache 2.0 |
| Nemotron-3 Nano 4B | 4.000 millones | Variable (alto) | 4-5 GB | 6-8 GB | ollama pull nemotron-3-nano:4b |
Agentes simples, generación aumentada por recuperación | NVIDIA Open Model License |
| DeepSeek-Coder 6.7B | 6.700 millones | 32.000 tokens | 6-7 GB | 12-14 GB | ollama pull deepseek-coder:6.7b |
Generación y análisis de código (Python, JavaScript, etc.) | MIT |
| Qwen3-VL 2B | 2.000 millones | 16.000 tokens | 4-5 GB | 8-10 GB | ollama pull qwen3-vl:2b |
Análisis básico de imágenes, descripción de diagramas | Apache 2.0 |
| Llama 3.1 8B | 8.000 millones | 32.000 tokens | 6-7 GB | 12-14 GB | ollama pull llama3.1:8b |
Conversación, razonamiento básico, generación de texto | Llama 3.1 Community |
| Phi-4-mini | 3.800 millones | 128.000 tokens | 4-5 GB | 8-10 GB | ollama pull phi-4-mini |
Razonamiento lógico, matemáticas, alta eficiencia | MIT |
Nota: Todos los requisitos son para cuantización Q4_K_M. Para hardware más limitado, usa Q3_K_M o Q2_K (con pérdida de calidad). Los modelos listados representan un equilibrio adecuado entre rendimiento y recursos.
Modelos en acción: una receta para cada necesidad
A continuación, te presentamos perfiles de usuario para que elijas el modelo perfecto para tu tarea.
Para el escritor, estudiante o conversador
Necesitas resumir textos, traducir, obtener ayuda creativa o simplemente conversar. Tu mejor opción es Gemma 4 E4B por su excelente equilibrio y capacidad multimodal.
Ejemplo práctico:
- Instala el modelo:
ollama pull gemma4:e4b - Ejecuta la tarea:
ollama run gemma4:e4b "Resume el siguiente texto en 5 puntos clave: [pegar aquí el contenido del documento]"
Para el analista de datos, legal o de documentos
Necesitas procesar documentos largos y extraer información precisa en español. Tu elección es Qwen 3 8B, que destaca por su soporte nativo para nuestro idioma y su capacidad para manejar contextos amplios.
Ejemplo práctico:
ollama run qwen3:8b "Analiza este contrato y extrae:
1. Plazos de confidencialidad
2. Penalizaciones por incumplimiento
3. Jurisdicción aplicable
[pegar aquí el texto del contrato]"
Para el programador
Quieres generar código, depurar errores y crear pruebas unitarias. Tu herramienta ideal es DeepSeek-Coder 6.7B, un especialista optimizado para tareas de programación.
Ejemplo práctico:
ollama run deepseek-coder:6.7b "Encuentra y corrige los errores en este código Python:
def calcular_promedio(lista):
    suma = 0
    for i in range(len(lista)):
        suma += lista[i]
    promedio = suma / len(lista)
    return promedio

print(calcular_promedio([1, 2, 3, 'cuatro', 5]))"
Nivel avanzado: cómo optimizar tu equipo
Una vez que te sientas cómodo, puedes aplicar estas técnicas para exprimir al máximo tu hardware.
1. Cuantización avanzada: el arte de la compresión
Imagina que un modelo es una fotografía en altísima resolución. La cuantización es como guardarla en un formato más ligero, como JPG. La imagen se sigue viendo genial, pero el archivo es mucho más pequeño. Esto permite que modelos grandes quepan en memorias limitadas. Para usar una cuantización más agresiva (y ligera), añade la etiqueta correspondiente al comando.
- Q4_K_M (recomendado): Es el equilibrio por defecto.
ollama pull gemma4:e4bya suele usarlo. - Q3_K_M (más ligero): Para equipos muy justos de memoria.
ollama pull qwen3:8b-q3_K_M - Q2_K (extremo): Calidad reducida, pero tamaño mínimo.
ollama pull deepseek-coder:6.7b-q2_K
2. Limitar el contexto para ahorrar memoria
Cada 1.000 tokens de contexto (la “memoria” a corto plazo del modelo) consumen memoria de video. Para conversaciones generales, 8.000 tokens suelen ser suficientes. Para configurar esto de forma persistente para un modelo, puedes crear un archivo llamado Modelfile (sin extensión) con el siguiente contenido:
FROM gemma4:e4b
PARAMETER num_ctx 8192
Luego, crea tu propia versión del modelo con el comando: ollama create mi-gemma-corta -f Modelfile. Ahora podrás ejecutar ollama run mi-gemma-corta y usará siempre ese límite de contexto.
3. El experimento del MoE: Qwen 3.6 de 35B en 8 GB
La arquitectura MoE (Mezcla de Expertos) es como una biblioteca con muchos bibliotecarios especialistas. En lugar de que uno solo lea todos los libros para tu consulta, se activa únicamente el especialista en ese tema. El modelo Qwen 3.6 de 35B activa solo unos 3.000 millones de parámetros a la vez.
Para ejecutarlo en un equipo de 8 GB de video, el sistema hace “trasvase” (offloading): usa la memoria de video como un escritorio de trabajo rápido y la memoria RAM del sistema como una estantería más lenta. Es funcional, pero con un cuello de botella.
Métricas de rendimiento esperadas:
| Configuración | Tokens por segundo (aproximado) | Memoria de video usada | Memoria RAM usada |
|---|---|---|---|
| Qwen 3.6 35B, con trasvase a CPU (RTX 3050 de 8GB + 16GB RAM) | ~1.5 a 3 | ~7.8 GB | ~13.5 GB |
| Qwen 3 8B (Q4_K_M, mismo equipo, sin trasvase) | ~15-18 | ~6.5 GB | ~3.0 GB |
Conclusión: Un modelo MoE de 35B es funcional para tareas en segundo plano que no requieren inmediatez, pero no para una conversación interactiva fluida. Para ello, los modelos densos de 4B a 8B son la mejor opción.
Preguntas frecuentes para usuarios domésticos
¿Puedo ejecutar estos modelos en una portátil sin tarjeta gráfica dedicada?
Sí, pero solo los más pequeños (como TinyLlama 1.1B o Qwen 3 0.5B). El rendimiento será muy bajo (0.5 a 2 tokens por segundo). Las portátiles con procesadores Apple de la serie M tienen una ventaja notable, ya que su memoria unificada permite ejecutar modelos de 7B con mucha mayor fluidez.
¿Por qué me da el error “file does not exist”?
Este error ocurre casi siempre porque la etiqueta del modelo está mal escrita. Verifica siempre los nombres exactos en la librería oficial de Ollama. Por ejemplo, es `gemma4:e4b`, no `gemma4:4b`.
¿Cómo soluciono errores de memoria agotada?
- Usa una cuantización más agresiva (por ejemplo, cambia a una versión `-q3_K_M`).
- Limita la ventana de contexto usando un
Modelfilecomo se explicó anteriormente. - Cierra otras aplicaciones que consuman mucha memoria, especialmente el navegador web.
Conclusión y recomendaciones finales
Ejecutar modelos de lenguaje en equipos domésticos en 2026 es una tarea accesible si se respetan las limitaciones del hardware. Para equipos con 4 a 8 GB de memoria de video, los modelos de 4B a 8B en formato Q4_K_M ofrecen la mejor experiencia conversacional. Intentar cargar modelos MoE gigantes como el de 35B es un experimento interesante que demuestra la viabilidad del trasvase de memoria, pero su lentitud lo relega a tareas en segundo plano. La combinación de Ollama con una gestión adecuada de los recursos garantiza un funcionamiento estable y abre la puerta a un mundo de posibilidades sin ceder nuestros datos.
Lo más leído en Especificaciones
-
Apps
Guía para derrotar a Mega Chandelure en Pokémon GO
Mega Chandelure debuta en Pokémon GO el sábado 31 de octubre de 2026, de 14:00 a 17:00 (hora…
-
 Curiosidades
Cómo crear con IA un script de respaldo automático para Windows
Un asistente de inteligencia artificial puede ayudar a escribir y adaptar un script de PowerShell para copiar archivos…






Lo más leído en Especificaciones
-
Apps
Guía para derrotar a Mega Chandelure en Pokémon GO
Mega Chandelure debuta en Pokémon GO el sábado 31 de octubre de 2026, de 14:00 a 17:00 (hora…
-
Curiosidades
Cómo crear con IA un script de respaldo automático para Windows
Un asistente de inteligencia artificial puede ayudar a escribir y adaptar un script de PowerShell para copiar archivos…

Mega Chandelure debuta en Pokémon GO el sábado 31 de octubre de 2026, de 14:00 a 17:00 (hora local), durante su Día de supermegaincursiones. El jefe es de tipo Fantasma y Fuego, así que sus contrincantes ideales usan ataques de tipo Siniestro, Fantasma, Tierra, Roca y Agua. En esta guía te contamos qué equipo armar, cómo funcionan los escudos, qué bonos ofrece el evento y qué hacer para llevarte la captura, incluida la forma variocolor.
Lo más leído en Especificaciones
-
Apps
Guía para derrotar a Mega Chandelure en Pokémon GO
Mega Chandelure debuta en Pokémon GO el sábado 31 de octubre de 2026, de 14:00 a 17:00 (hora…
-
Curiosidades
Cómo crear con IA un script de respaldo automático para Windows
Un asistente de inteligencia artificial puede ayudar a escribir y adaptar un script de PowerShell para copiar archivos…
Comunicados de Prensa
LG presenta en México W6 Wallpaper: el televisor OLED inalámbrico de menos de un centímetro de grosor

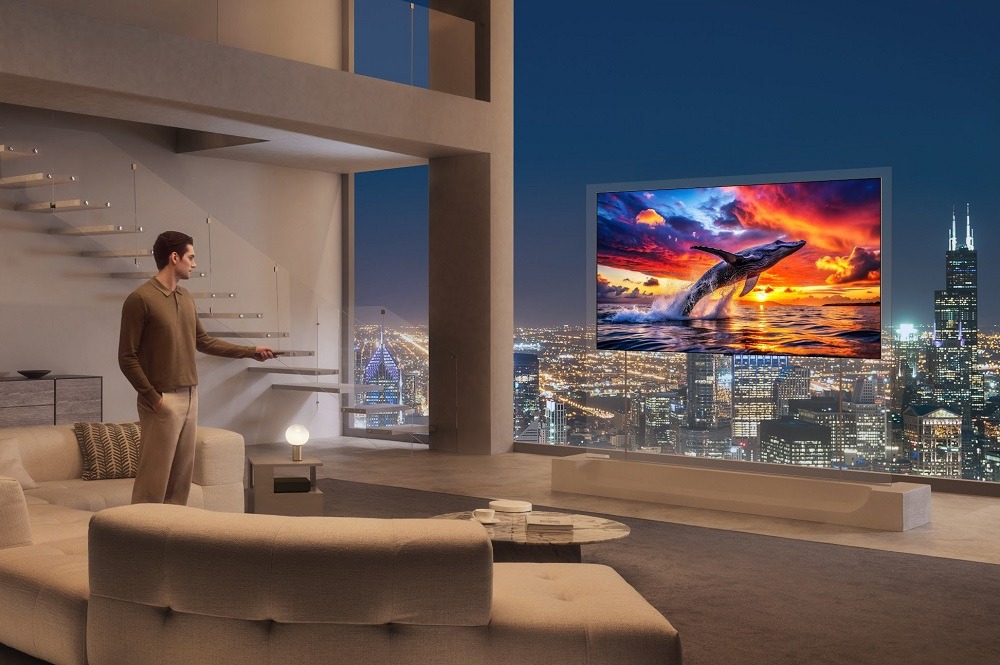
El nuevo LG OLED evo W6 Wallpaper lleva el diseño minimalista a otro nivel, al integrar tecnología de imagen de última generación en un televisor que se convierte en parte de la arquitectura del hogar.
Lo más leído en Especificaciones
-
Apps
Guía para derrotar a Mega Chandelure en Pokémon GO
Mega Chandelure debuta en Pokémon GO el sábado 31 de octubre de 2026, de 14:00 a 17:00 (hora…
-
Curiosidades
Cómo crear con IA un script de respaldo automático para Windows
Un asistente de inteligencia artificial puede ayudar a escribir y adaptar un script de PowerShell para copiar archivos…
Lo más leído
-
 Comunicados de Prensa
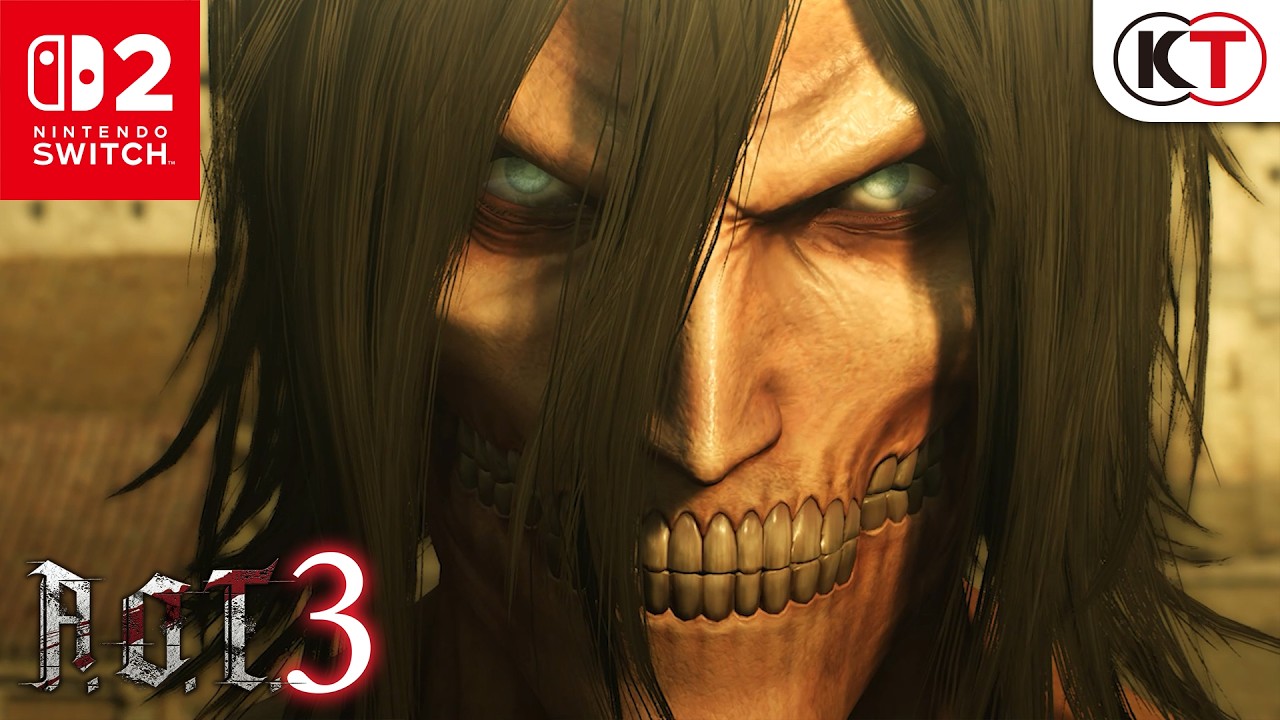
Attack on Titan 3 abre preventas para Nintendo Switch 2 con tráiler exclusivo
-
Curiosidades
Cómo crear con IA un script de respaldo automático para Windows
-
 Actualización
Relatos: el nuevo modo de juego de WoW Midnight ya está disponible
-
 Comunicados de Prensa
Qué significa la IA para inversionistas asesoría y regulación según Vanguard
-
 Comunicados de Prensa
Entre ofrendas y disfraces: cómo celebran los mexicanos Halloween y Día de Muertos en 2026
-

 Apps11 años ago
AMPcast, la herramienta de Pandora que permite a los artistas grabar mensajes de audio directamente a sus seguidores
-
 Blogs5 años ago
Conoce los mejores sitios de Torrents para descargar todo tipo de contenidos
-
Android5 años ago
Aprende cómo usar Discord para ver películas con tus amigos
-
Arte y Cultura14 años ago
Colección de fondos de pantalla basados en Super Héroes
-

 Almacenamiento2 años ago
Cómo usar TeraBox: La guía definitiva para aprovechar 1 TB de almacenamiento en la nube
-
Diseño13 años ago
css3ps: plugin que convierte archivos PSD a CSS3
-
Apps9 años ago
Picturethat, app que usa la Realidad Aumentada para visualizar cómo quedarían los cuadros antes de colgarlos
-
Eventos Especiales13 años ago
Especial Día de la Madres: fondos de pantalla especiales para Mamá