

Especificaciones
BigBang-V1 el modelo de 35B que supera a gigantes de IA en exámenes científicos

BigBang-V1 es un modelo de lenguaje abierto publicado en Hugging Face por el equipo endless-frontier, evolucionado a partir de Qwen 3.6 35B-A3B mediante un marco de datos sintéticos autoevolutivo. Con solo 36 mil millones de parámetros, alcanza un rendimiento agregado situado entre DeepSeek V4 Flash y DeepSeek V4 Pro, modelos mucho más grandes.
La carrera de los modelos de lenguaje suele leerse como una competencia de tamaño: más parámetros, mejor resultado. El equipo endless-frontier propone la lectura contraria con BigBang-V1, disponible en Hugging Face. Su tesis es simple: cuando los modelos se acercan al desempeño experto humano, el freno no está en la capacidad sino en las tareas de entrenamiento, concebidas dentro de los límites del conocimiento humano.
¿Qué es BigBang-V1 y cómo fue entrenado?
BigBang-V1 es un LLM de propósito general que evoluciona a partir de Qwen 3.6 35B-A3B, la arquitectura de expertos de Alibaba, mediante un post-entrenamiento eficiente con un marco adversarial de datos sintéticos que se autoevoluciona. El modelo pesa 36 mil millones de parámetros en formato BF16.
La innovación está en el marco de entrenamiento, compuesto por dos piezas que compiten entre sí:
- Agentes generadores: proponen y resuelven de forma continua problemas científicos y técnicos cada vez más difíciles.
- Agentes críticos: evalúan la corrección, dificultad, escalabilidad y diversidad de cada solución, usando tareas de investigación real reservadas para calibrar la distribución de datos sintéticos.
De esta interacción iterativa entre generador y crítico surgen aproximadamente 10,000 ejemplos de alta dificultad para el post-entrenamiento. Una cifra modesta si se le compara con los corpus masivos habituales, pero diseñada con un criterio distinto: tareas frontera verificables, es decir, problemas en el límite del conocimiento actual cuyas soluciones pueden evaluarse objetivamente mediante métodos formales, cómputo, simulación o herramientas específicas de cada dominio.
El enfoque de partir de la base de Qwen conecta con la tradición abierta de Alibaba, cuyo modelo ya analizamos en el sitio al revisar la guía para ejecutar Qwen3.5 en local.
¿Qué resultados obtiene frente a los gigantes?
Aquí viene lo que resulta particularmente interesante del anuncio. BigBang-V1 obtiene la puntuación más alta reportada entre los modelos de 35B seleccionados en los ocho benchmarks evaluados, que cubren búsqueda de largo horizonte, ingeniería de software, investigación científica y investigación de IA.
Y en cuatro de ellos supera directamente a DeepSeek V4 Pro Preview (1.6 billones de parámetros), un modelo casi 45 veces más grande:
- FrontierScience Research: 46.2 contra 40.7 del gigante.
- Humanity’s Last Exam: 50.3 frente a 48.2, uno de los exámenes más exigentes del campo.
- PaperBench (Code-Dev): 53.6 contra 50.4.
- BioMysteryBench-HD: 15.7 frente a 13.7, el benchmark más difícil de la tabla.
En el resto de pruebas tampoco se queda corto: 76.5 en BrowseComp, 54.2 en SWE-Bench Pro, 59.1 en MLE-Bench Lite y 50.3 en HLE. El rendimiento agregado del modelo se sitúa entre DeepSeek V4 Flash (284B) y DeepSeek V4 Pro (1.6T), lo cual dice mucho sobre la eficiencia del método de entrenamiento. Vale la pena señalar que DeepSeek también apostó por la economía de parámetros, como vimos al cubrir el lanzamiento de V4.1-Flash su modelo más económico.
¿Cómo ejecutar BigBang-V1 en la práctica?
El modelo recomienda servirse mediante APIs compatibles con OpenAI y tiene una ventana de contexto predeterminada de 262,144 tokens. El equipo aconseja mantener al menos 128K tokens de contexto para no degradar las capacidades de razonamiento del modelo.
Los marcos de inferencia recomendados, con sus versiones mínimas, son:
- SGLang (0.5.10 o superior): recomendado para despliegue con paralelismo de tensores en 8 GPUs, con soporte para uso de herramientas y Multi-Token Prediction especulativa.
- vLLM (0.19.0 o superior): motor de alta capacidad con opciones de modo solo texto que libera memoria para caché KV adicional.
- KTransformers: para cómputo heterogéneo CPU-GPU.
- Hugging Face Transformers: servidor ligero para pruebas rápidas y carga moderada.
La existencia de 36 versiones cuantizadas y casi 400 modelos derivados en la plataforma confirma que la comunidad ya está trabajando sobre esta base, igual que hace con otros pesos abiertos, un fenómeno que también explicamos al analizar cómo usar varios modelos de IA sin suscripciones extra.
¿Por qué importa la síntesis de tareas frontera?
Más allá de los benchmarks, la propuesta conceptual de BigBang tiene una implicación seria para el futuro de la IA. Si el crecimiento de capacidades depende de tareas verificables en la frontera del conocimiento, entonces los modelos necesitan aprender de problemas que ningún humano ha etiquetado antes. Los agentes generadores y críticos son una respuesta a esa limitación.
Con 2,223 descargas en el último mes, el modelo está aún en etapa temprana de adopción. Pero la demostración es contundente: un modelo de 35B con 10,000 ejemplos de entrenamiento bien elegidos puede competir con sistemas de 1.6 billones de parámetros en tareas científicas reales. Ese es, quizás, el dato que más debería incomodar a los laboratorios que apuestan todo a la escala.
Lo más leído en Especificaciones
-
 Entrevista
10 prompts de Gemini para encontrar empleo: del currículum a la entrevista
Cada vacante te pide un currículum distinto, una carta nueva y un mensaje original para el reclutador. Personalizar…
-
 Apps
Este ajuste oculto de Gemini mejora tus respuestas al instante
Activar la integración de Google Workspace en Gemini puede cambiar por completo la experiencia de uso. Cuando el…






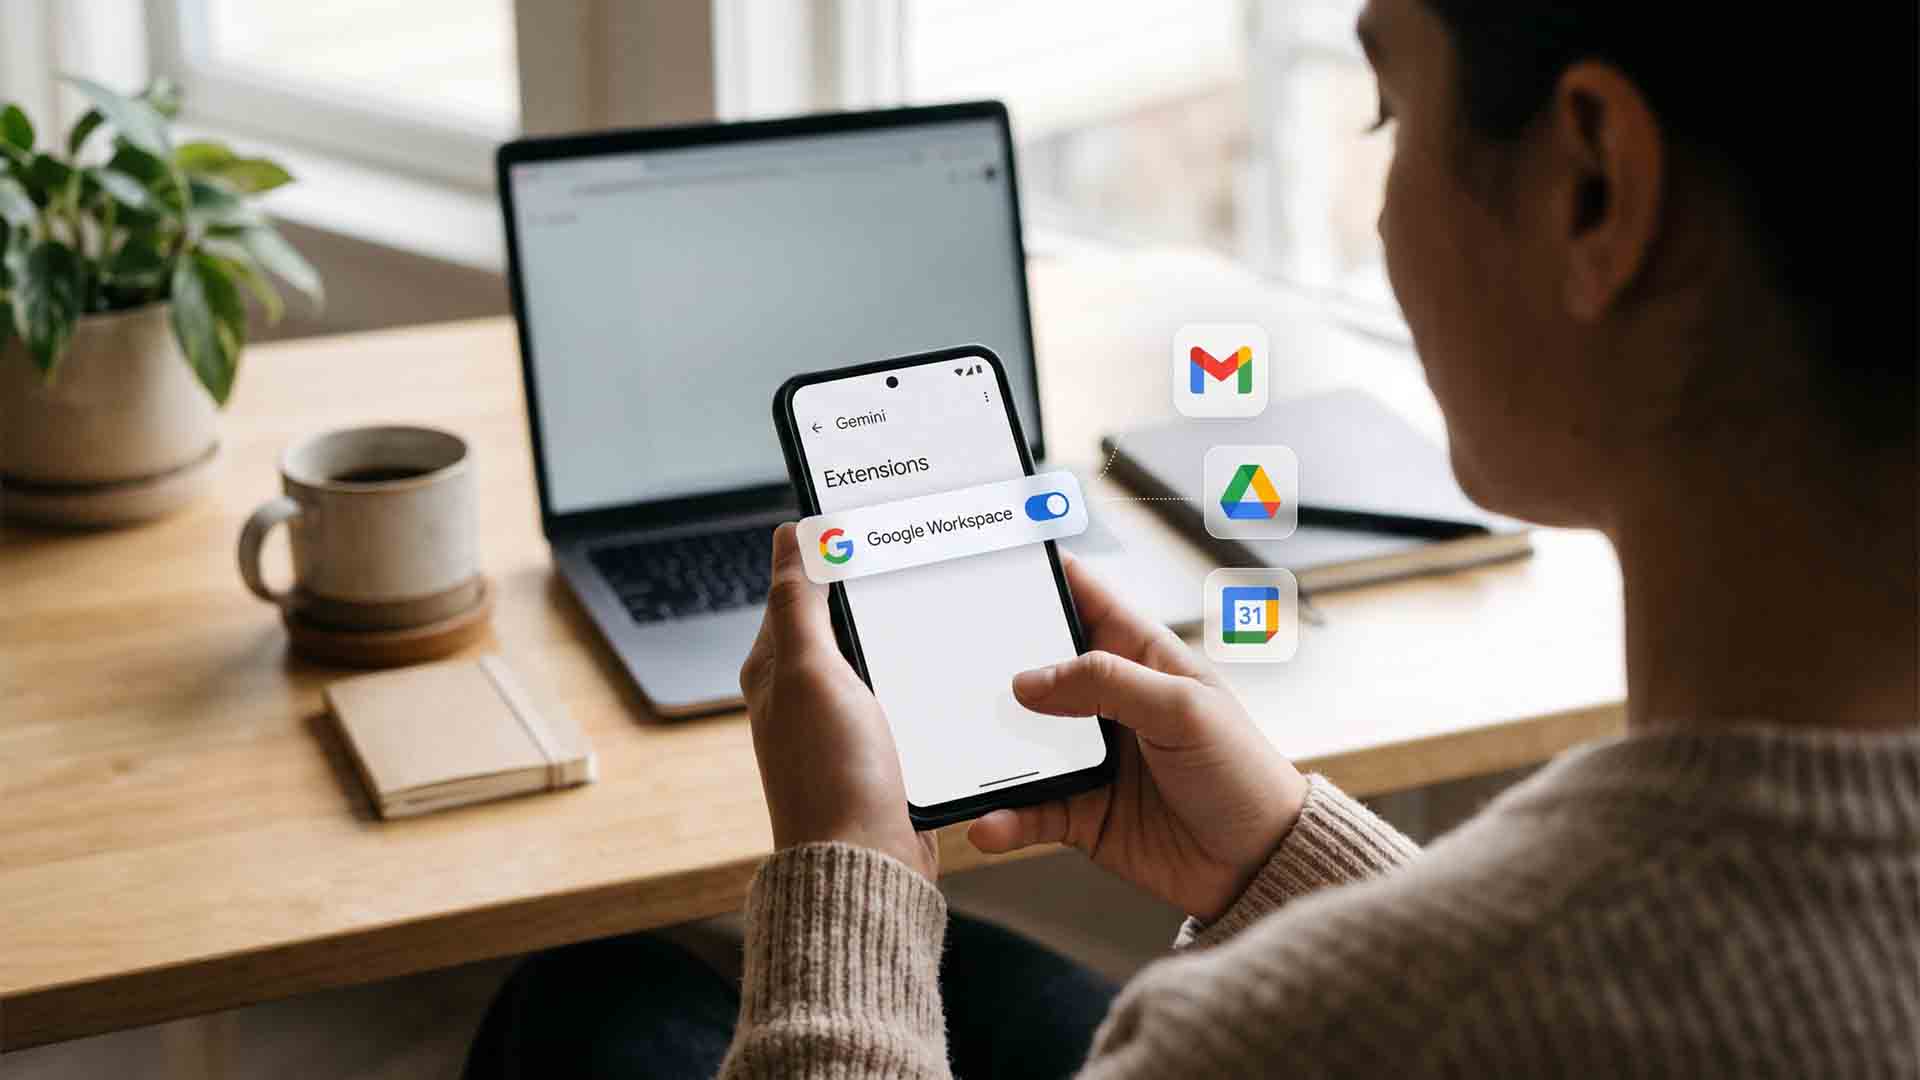
Activar la integración de Google Workspace en Gemini puede cambiar por completo la experiencia de uso. Cuando el asistente tiene permiso para consultar servicios como Gmail, Drive, Calendar o Keep, deja de responder desde cero y empieza a trabajar con tu contexto. En pocos minutos, puede pasar de respuestas genéricas a búsquedas, resúmenes y respuestas mucho más útiles dentro de tu propio ecosistema.
Lo más leído en Especificaciones
-
Entrevista
10 prompts de Gemini para encontrar empleo: del currículum a la entrevista
Cada vacante te pide un currículum distinto, una carta nueva y un mensaje original para el reclutador. Personalizar…
-
Apps
Este ajuste oculto de Gemini mejora tus respuestas al instante
Activar la integración de Google Workspace en Gemini puede cambiar por completo la experiencia de uso. Cuando el…
Cada vacante te pide un currículum distinto, una carta nueva y un mensaje original para el reclutador. Personalizar todo a mano puede robarte horas por cada postulación. Estos 10 prompts para Gemini automatizan la parte mecánica: de conectar en LinkedIn a ensayar la entrevista final, cada plantilla solo requiere rellenar los campos entre corchetes con tu información.
Lo más leído en Especificaciones
-
Entrevista
10 prompts de Gemini para encontrar empleo: del currículum a la entrevista
Cada vacante te pide un currículum distinto, una carta nueva y un mensaje original para el reclutador. Personalizar…
-
Apps
Este ajuste oculto de Gemini mejora tus respuestas al instante
Activar la integración de Google Workspace en Gemini puede cambiar por completo la experiencia de uso. Cuando el…
Digitalización
DeepSeek-V4.1-Flash en GGUF: cuantización que corre un modelo de 763B en 12 GB de VRAM

Investigadores del Institute of Science and Technology Austria (ISTA) publicaron versiones GGUF cuantizadas de DeepSeek-V4.1-Flash-1017, un modelo sparse mixture-of-experts de 763.2 mil millones de parámetros con 384 expertos enrutados por capa. Gracias a un método de cuantización no uniforme, las tres builds disponibles corren en una GPU de 12 GB de VRAM con Strata. La versión recomendada retiene el 100% del desempeño del modelo base.
Lo más leído en Especificaciones
-
Entrevista
10 prompts de Gemini para encontrar empleo: del currículum a la entrevista
Cada vacante te pide un currículum distinto, una carta nueva y un mensaje original para el reclutador. Personalizar…
-
Apps
Este ajuste oculto de Gemini mejora tus respuestas al instante
Activar la integración de Google Workspace en Gemini puede cambiar por completo la experiencia de uso. Cuando el…
Lo más leído
-
 Herramientas
Higgsfield AI Skills: 8 habilidades de IA para generar imágenes y video
-
 Digitalización
Automatización con PhotoCraft: guía práctica para editar imágenes por lotes con CLI y MCP
-
Entrevista
10 prompts de Gemini para encontrar empleo: del currículum a la entrevista
-
Digitalización
DeepSeek-V4.1-Flash en GGUF: cuantización que corre un modelo de 763B en 12 GB de VRAM
-
Apps
Este ajuste oculto de Gemini mejora tus respuestas al instante
-

 Apps11 años ago
AMPcast, la herramienta de Pandora que permite a los artistas grabar mensajes de audio directamente a sus seguidores
-
 Blogs5 años ago
Conoce los mejores sitios de Torrents para descargar todo tipo de contenidos
-
Android5 años ago
Aprende cómo usar Discord para ver películas con tus amigos
-
Arte y Cultura14 años ago
Colección de fondos de pantalla basados en Super Héroes
-

 Almacenamiento2 años ago
Cómo usar TeraBox: La guía definitiva para aprovechar 1 TB de almacenamiento en la nube
-
Diseño13 años ago
css3ps: plugin que convierte archivos PSD a CSS3
-
Apps9 años ago
Picturethat, app que usa la Realidad Aumentada para visualizar cómo quedarían los cuadros antes de colgarlos
-
Eventos Especiales13 años ago
Especial Día de la Madres: fondos de pantalla especiales para Mamá