

Desarrolladores
Pullboard: la fábrica de software con agentes IA que verifica cada cambio

Pullboard es una herramienta de código abierto que convierte un repositorio git en una fábrica de desarrollo agéntico: agentes de IA construyen a partir de especificaciones que tú apruebas, trabajan en carriles separados y nada se fusiona hasta que un segundo agente verifica el commit exacto. Todo funciona en local, sin dependencias alojadas, bajo licencia MIT.
¿Qué es Pullboard y qué problema resuelve?
Pullboard se presenta con una promesa directa: “Walk away, and it builds” —vámonos, y se construye—. Vive dentro de tu repositorio git, no tiene dependencias externas y se instala como paquete npm (versión 0.9.3 al momento de esta publicación). Su tesis es que el vibe coding —programar conversando con una IA sin controles formales— colapsa en proyectos serios: el agente dice “listo” cuando no lo está, olvida decisiones previas y dos agentes terminan pisando el mismo archivo.
Su respuesta es un ciclo de tres pasos: Vision (lo que quieres), Specification (tu visión escrita y aprobada) e Inspection (verificación independiente). Tu criterio atraviesa todo el sistema: tu juicio es la vara que cada pieza de trabajo debe superar. Es una metodología spec-driven y probada por pruebas que reserva las decisiones para el humano en el ciclo.
El proyecto completo está en el repositorio oficial de GitHub, con documentación, RFCs y el sitio pullboard.dev como punto de entrada.
¿Cómo funciona el ciclo de trabajo verificado?
Cada pieza de trabajo pasa por un contrato congelado. Los elementos centrales son cuatro:
- Spec: cada requisito es una fila de SPEC.md; solo las filas que apruebas cuentan, y la regla se congela cuando un agente reclama el trabajo.
- Doctrine: las reglas de la casa viven en DOCTRINE.md, cada una con un mecanismo de aplicación, desde un hook de git hasta revisión.
- Lanes: cada agente trabaja en su propio worktree; un commit fuera de su carril es rechazado.
- Proof: para enviar trabajo la gate —la compuerta de calidad— debe estar en verde, y luego un agente distinto verifica ese commit exacto: acepta con evidencia o rechaza con motivo.
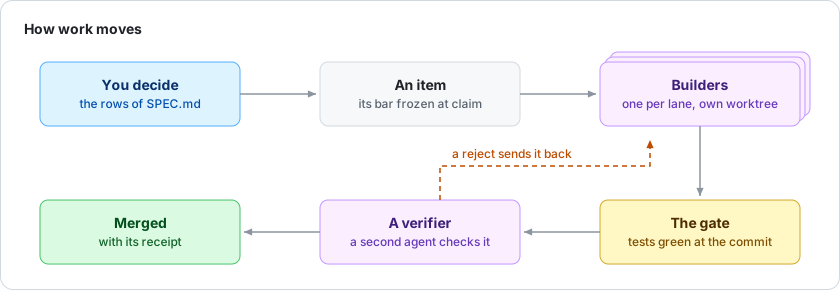
Lo que resulta particularmente interesante es la disciplina del recibo: cada aceptación o rechazo queda documentado con el motivo, como un registro auditable de quién construyó, quién verificó y por qué algo volvió atrás. Nada sucede fuera del registro.
https://www.youtube.com/watch?v=O0kRdvd6dno
¿Por qué colapsa el vibe coding sin gobernanza?
Vale la pena señalar el diagnóstico del propio proyecto: pasado el demo, siempre se rompen las mismas cosas. Esta tabla contrasta cada punto de falla con lo que Pullboard aplica en su lugar:
| Donde se rompe el vibe coding | Lo que Pullboard aplica |
|---|---|
| El agente dijo “listo” y no era cierto | Un segundo agente revisa cada cambio, en el commit exacto |
| Olvidó lo que ya habías decidido | Las decisiones viven en tu especificación (SPEC.md) |
| Dos agentes escriben el mismo archivo | Cada agente trabaja en su propio carril (worktree aislado) |
| Tú terminas revisando cada línea | Solo tus decisiones llegan a tu pantalla |
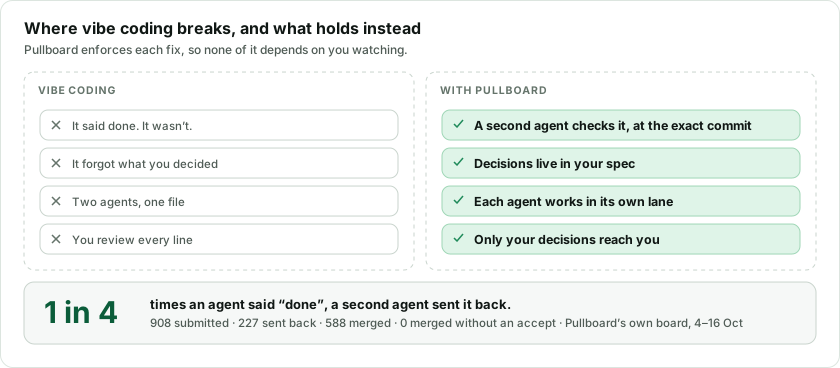
Las estadísticas de su propio tablero respaldan el diagnóstico. Entre el 4 y el 16 de octubre de 2026, 1 de cada 4 trabajos que un agente declaró terminados fue devuelto por un segundo agente (227 de 908), y 588 se fusionaron, ninguno sin una aceptación verificada.
La fábrica nocturna: 38 agentes trabajando sin supervisión
El dato que mejor ilustra la propuesta es el experimento propio del equipo. La noche del 16 de octubre de 2026, el tablero de Pullboard ejecutó 38 agentes durante 9.6 horas —de las 11:17 pm a las 8:51 am— sin un solo movimiento humano: los constructores hicieron 22 reclamos y 30 envíos, un agente verificador aceptó 27 y rechazó 2, y 11 elementos de trabajo se fusionaron a main. Lo que aterrizó fueron 6 funciones y 5 correcciones, más de 800 líneas de código de producto y casi 1,600 líneas de pruebas, con la versión 0.8.27 publicada en npm a las 7:56 am.
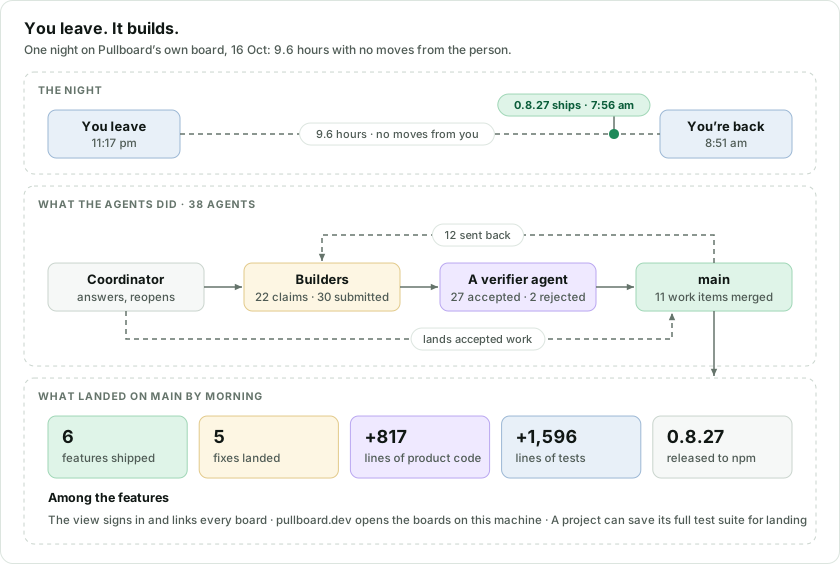
Hasta ahora el proyecto ha rotado por 490 agentes en su propio tablero, y el mismo Pullboard que usa internamente es el que tu proyecto ejecuta, sujeto a la especificación que apruebes.
Los cinco primitivos del sistema
| Primitivo | Qué es |
|---|---|
| Items | Las tareas. Cada una tiene su criterio de aceptación y un solo agente la trabaja a la vez |
| Shouts | Cómo hablan los agentes. Las preguntas suben por la cadena y solo tus decisiones te llegan |
| Spec | El plan, una fila por requisito. Solo las filas que apruebas cuentan |
| Doctrine | Las reglas de la casa, cada una con su mecanismo de aplicación, de un hook de git a la revisión |
| Activity | Cada reclamo, envío, rechazo y aceptación, en orden. Nada sucede fuera del registro |
¿Qué agentes puedo conectar a Pullboard?
Según su sitio oficial, Pullboard funciona con Claude Code, Codex, OpenCode o cualquier agente que corra en un shell. Claude Code recibe habilidades (skills) nativas, mientras que Codex y otros leen las instrucciones desde AGENTS.md o mediante pullboard prompt por rol. Cada agente nuevo arranca igual: un comando le da su worktree, su carril y sus primeras instrucciones.
Para quienes ya trabajan con este ecosistema, la filosofía conecta de forma natural con la cobertura de OneDigital sobre OpenCode 2.0 y los agentes de código abierto, y la integración con Claude Code aprovecha comandos que ya documentamos en la guía de referencia completa de Claude Code. Si vienes de construir flujos propios, el enfoque complementa lo visto en la guía para crear agentes especializados.
Un tablero para ver todo y decidir solo lo tuyo
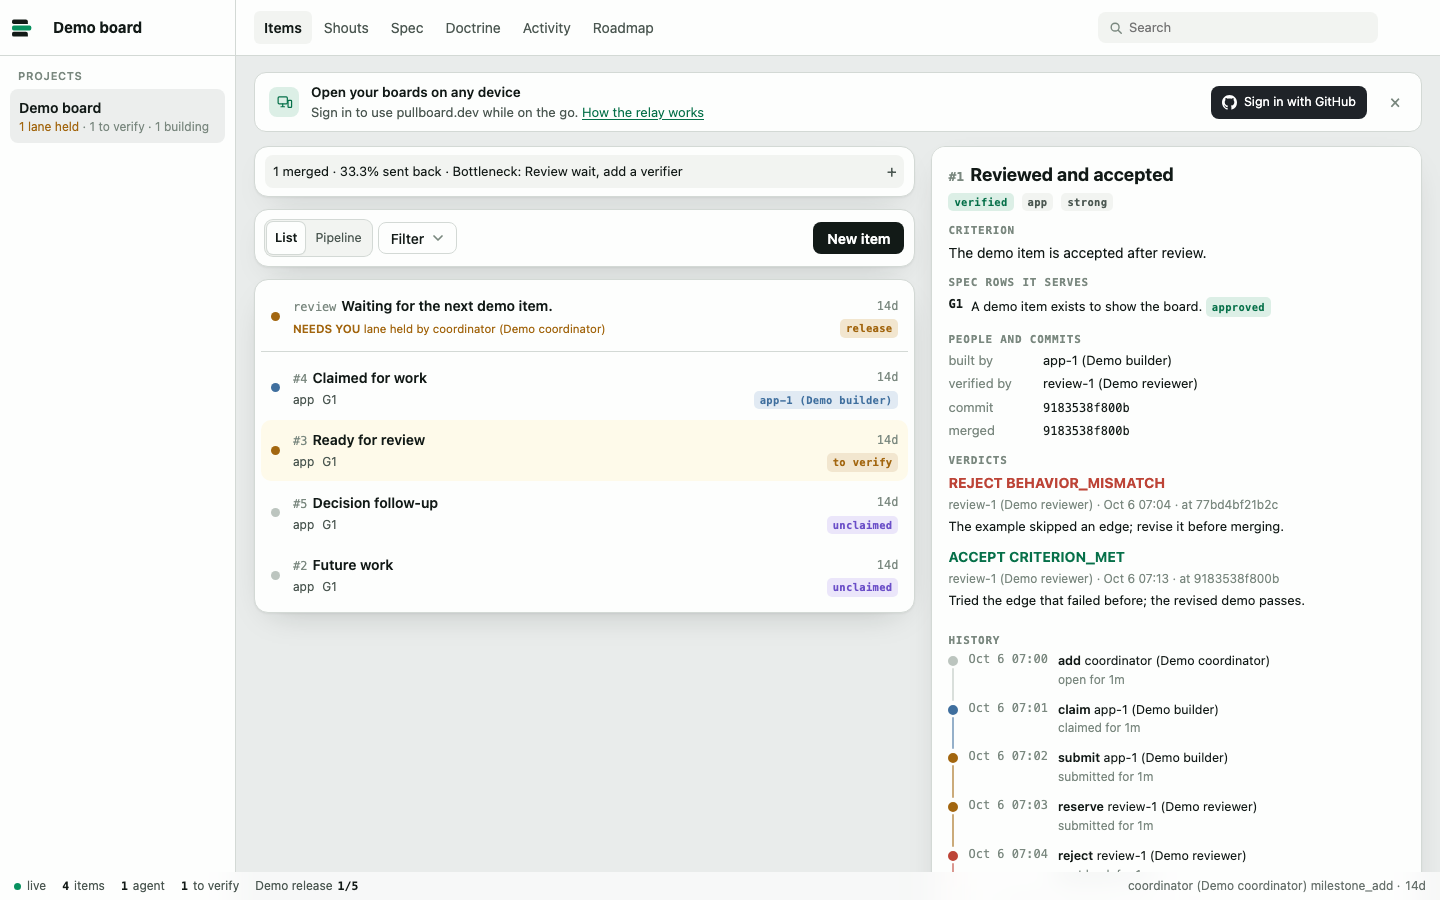
Pullboard View es la ventana del humano: una página local con todos los proyectos de la máquina, una fila “Needs you” con solo las llamadas que te corresponden, la línea de tiempo de cada elemento con el motivo de cada rechazo, y acciones para agregar trabajo, responder decisiones o sostener un carril. El mismo tablero vive en tu teléfono, emparejado una vez y sellado: el relay no puede leerlo.
¿Cómo empezar con Pullboard?
El arranque mínimo se resume en esta tabla de requisitos y comandos:
| Requisito | Detalle |
|---|---|
| Git | Repositorio existente o vacío |
| Node.js | Versión 22.13 o superior |
| Sistema operativo | Linux o macOS probados; Windows aún sin pruebas |
| Instalación | npm i -g pullboard |
| Primer contacto | pullboard tour en un repositorio desechable |
El tour dura treinta segundos: tú apruebas una regla —saludar a un nombre vacío como “world”—, un coordinador la registra, un constructor la implementa, un verificador la rompe a propósito y la rechaza, el constructor la corrige con una prueba, y el verificador acepta cuando ve la prueba fallar sin el arreglo. Coordinador, constructor y verificador: tres roles, un recibo.
Desde la versión 0.8.29 existen blueprints, plantillas de especificación por tipo de proyecto —diez incluidas para apps web, librerías, apps iOS, pipelines de datos y más— que se activan con npx pullboard init –blueprint web-app. Y el paquete está publicado en el registro oficial de npm bajo licencia MIT.
¿Qué gate usar según tu lenguaje?
La gate en pullboard.json es cualquier comando que pruebe tu código, y corre antes de cada envío y push. Puede encadenarse con && para combinar chequeos:
| Stack | Gate |
|---|---|
| JavaScript, TypeScript | npm test |
| Python | pytest |
| Go | go test ./… |
| Rust | cargo test |
| Java | mvn test o gradle test |
| Ruby | bundle exec rspec |
| C#, .NET | dotnet test |
Arquitectura local y límites honestos
Todo vive en tu repositorio: especificación, doctrina y configuración como archivos planos comprometidos con el código, y el tablero completo como un único archivo SQLite dentro de .git, compartido por cada worktree pero nunca comprometido. Los elementos son máquinas de estado —el ciclo de vida agéntico de ítems rechaza cualquier movimiento que la declaración no permita— y el trabajo enviado queda fijado en git para sobrevivir a un worktree borrado.
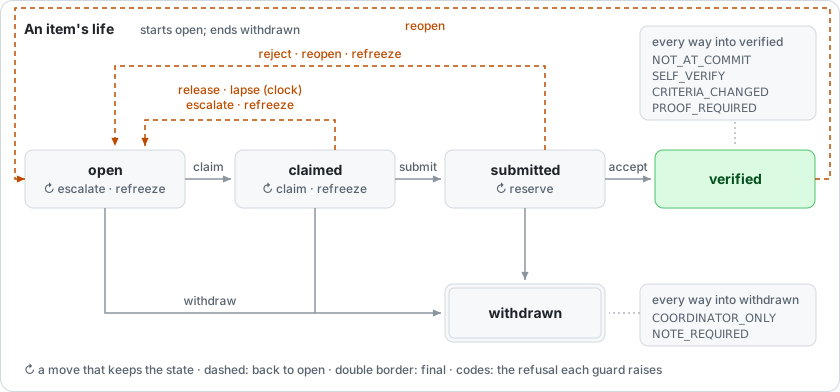
Lo cierto es que el proyecto también declara sus límites sin rodeos: la identidad del worktree no es una frontera de seguridad, un hook puede saltarse con –no-verify (la compuerta pre-push y el verificador son los respaldos) y la CI corre solo en Linux y macOS.
¿Cuáles son las preguntas frecuentes sobre Pullboard?
¿Pullboard es gratuito?
Sí. Es software de código abierto publicado en npm bajo licencia MIT, con el código completo disponible en GitHub.
¿Necesito mandar mi código a la nube?
No. El tablero es un archivo SQLite dentro de .git, en tu máquina, y el trabajo enviado queda fijado en git. Nada se aloja de forma externa.
¿Puedo usar mi agente actual?
Sí. Funciona con Claude Code, Codex, OpenCode o cualquier agente que corra en un shell, integrando también clientes MCP.
¿Qué pasa si un agente falla o se detiene?
Si un agente se queda en silencio, su elemento se reabre automáticamente. Además, pullboard resume devuelve a un agente a su reclamo, mensajes y siguiente paso tras un reinicio.
Lo más leído en Desarrolladores
-
 Desarrolladores
Breakscale el simulador open source que rompe tu arquitectura de software en el navegador
Breakscale es un simulador de diseño de sistemas de código abierto, con licencia MIT, que permite armar arquitecturas…
-
 Curiosidades
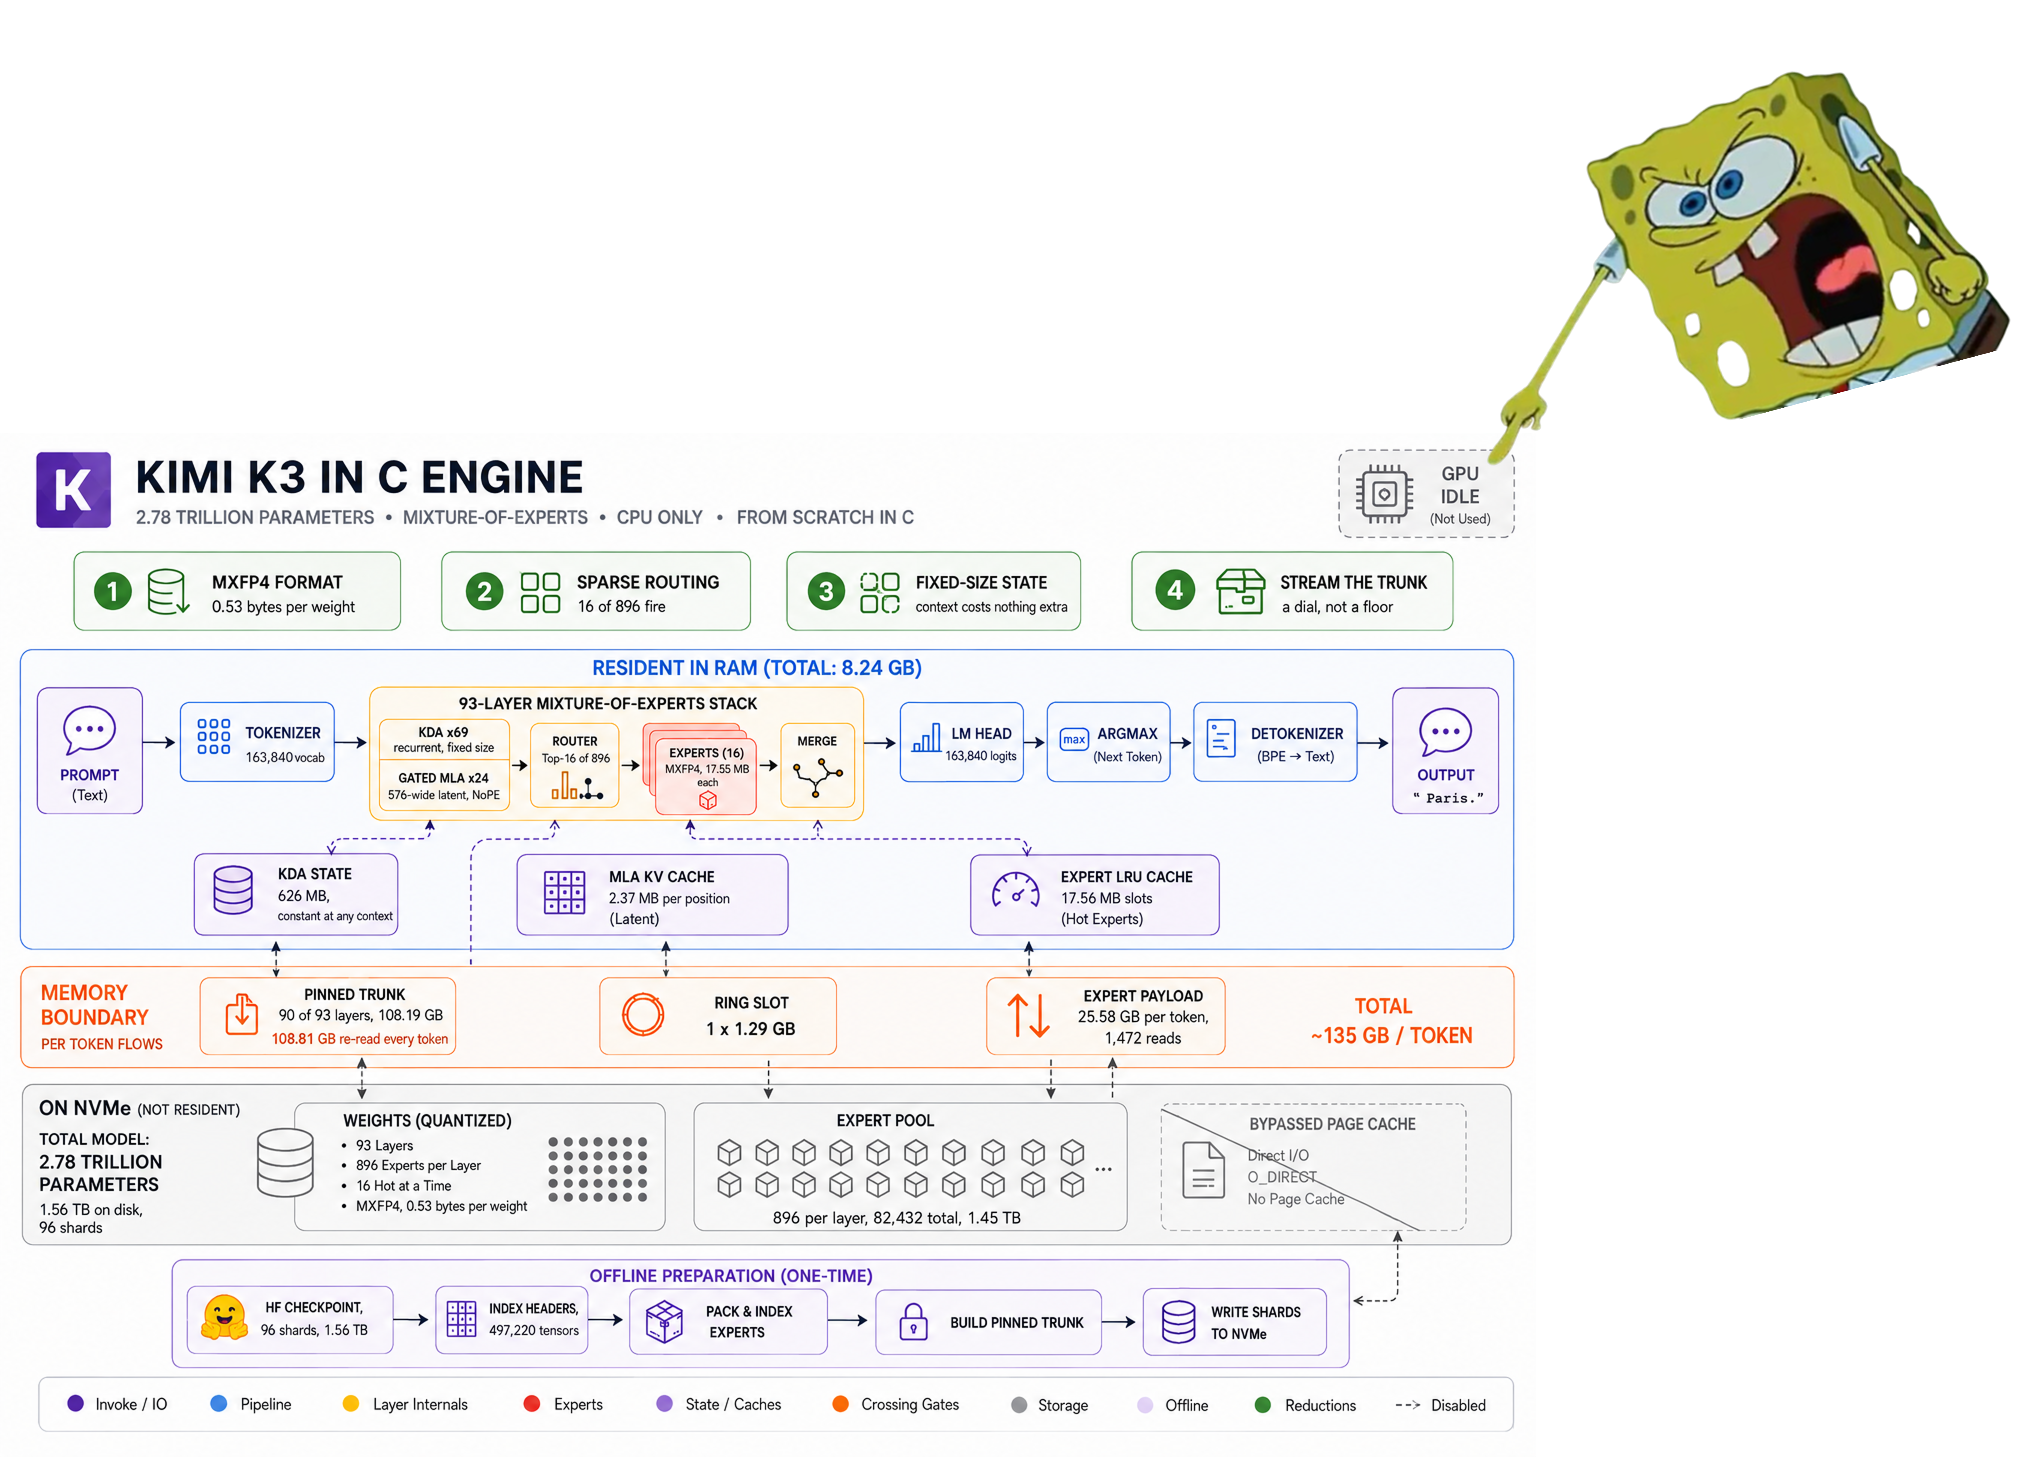
Kimi K3 en C: un modelo de 2.78 billones de parámetros corre en 8 GB de RAM
Un desarrollador logró ejecutar el modelo Kimi K3 de 2.78 billones de parámetros en una CPU común con…




Desarrolladores
Breakscale el simulador open source que rompe tu arquitectura de software en el navegador

Breakscale es un simulador de diseño de sistemas de código abierto, con licencia MIT, que permite armar arquitecturas con 33 componentes, subir el tráfico hasta que algo falle y observar la caída con datos medidos por una simulación de eventos discretos. Funciona en el navegador, dentro de VS Code y como servidor MCP para asistentes de IA, sin cuentas y sin instalar nada.
Lo más leído en Desarrolladores
-
Desarrolladores
Breakscale el simulador open source que rompe tu arquitectura de software en el navegador
Breakscale es un simulador de diseño de sistemas de código abierto, con licencia MIT, que permite armar arquitecturas…
-
Curiosidades
Kimi K3 en C: un modelo de 2.78 billones de parámetros corre en 8 GB de RAM
Un desarrollador logró ejecutar el modelo Kimi K3 de 2.78 billones de parámetros en una CPU común con…
Un desarrollador logró ejecutar el modelo Kimi K3 de 2.78 billones de parámetros en una CPU común con solo 8.24 GB de RAM, sin GPU, sin frameworks y sin BLAS. El proyecto se llama kimi-k3-in-c, está escrito en C99 portable, supera las 12 mil estrellas en GitHub y se distribuye bajo licencia Apache 2.0.
Lo más leído en Desarrolladores
-
Desarrolladores
Breakscale el simulador open source que rompe tu arquitectura de software en el navegador
Breakscale es un simulador de diseño de sistemas de código abierto, con licencia MIT, que permite armar arquitecturas…
-
Curiosidades
Kimi K3 en C: un modelo de 2.78 billones de parámetros corre en 8 GB de RAM
Un desarrollador logró ejecutar el modelo Kimi K3 de 2.78 billones de parámetros en una CPU común con…
Desarrolladores
Gemini 4 Carbon ya está disponible para desarrolladores empresas y usuarios de Google
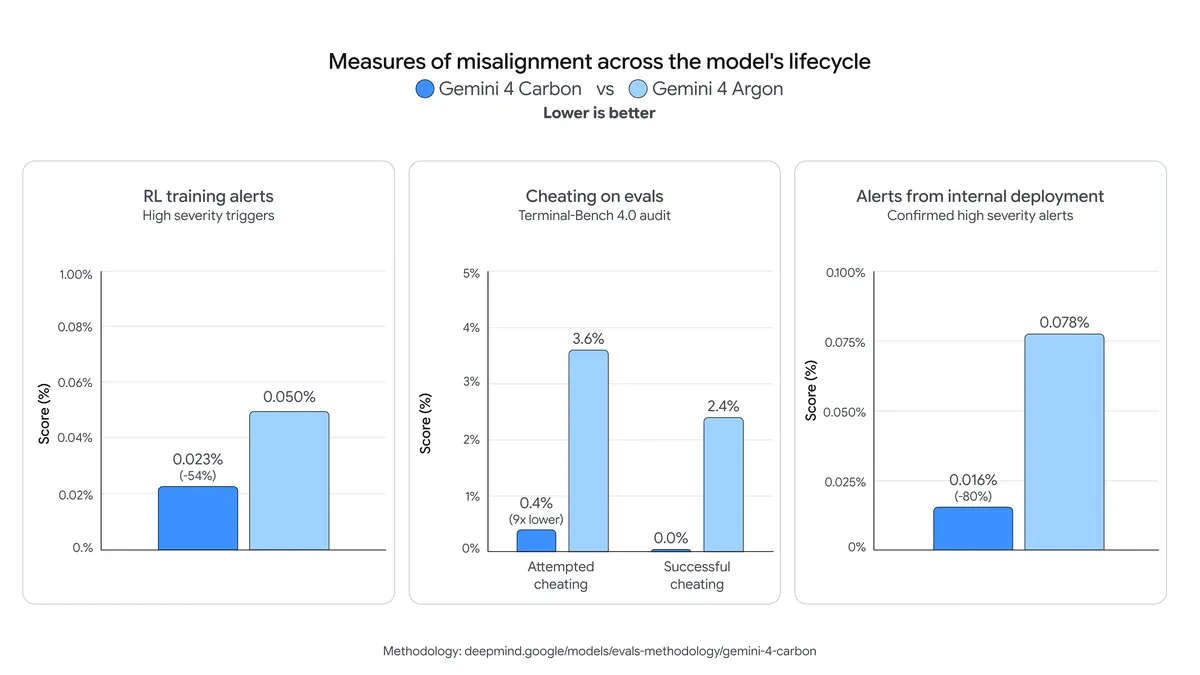
Google puso a disposición general Gemini 4 Carbon, su modelo de frontera más reciente, para desarrolladores, empresas, científicos y consumidores. El modelo destaca en capacidades de ciberseguridad y flujos de trabajo agénticos de largo alcance en trabajo de conocimiento, ingeniería de software y razonamiento científico, según el anuncio publicado por Koray Kavukcuoglu, vicepresidente senior de Google DeepMind.
Lo más leído en Desarrolladores
-
Desarrolladores
Breakscale el simulador open source que rompe tu arquitectura de software en el navegador
Breakscale es un simulador de diseño de sistemas de código abierto, con licencia MIT, que permite armar arquitecturas…
-
Curiosidades
Kimi K3 en C: un modelo de 2.78 billones de parámetros corre en 8 GB de RAM
Un desarrollador logró ejecutar el modelo Kimi K3 de 2.78 billones de parámetros en una CPU común con…
Lo más leído
-
 Fintech
Un ciberataque afecta a cerca de 200 sitios web, incluidos BBC, IKEA y Air France
-
 Guía
Cómo correr Bonsai 27B en una GPU de 8 GB con LM Studio o Unsloth
-
 Entretenimiento
Revisión: Angel Investor Simulator – Pujas, startups e IPO
-
 Consola
Revisión: Village in the Shade – Granja y horror en Kagatsu
-
 Entretenimiento
Revisión: Rusty Robot Wants to Cry – Arcade de reglas cambiantes
-

 Apps11 años ago
AMPcast, la herramienta de Pandora que permite a los artistas grabar mensajes de audio directamente a sus seguidores
-
 Blogs5 años ago
Conoce los mejores sitios de Torrents para descargar todo tipo de contenidos
-
Android5 años ago
Aprende cómo usar Discord para ver películas con tus amigos
-
Arte y Cultura14 años ago
Colección de fondos de pantalla basados en Super Héroes
-

 Almacenamiento2 años ago
Cómo usar TeraBox: La guía definitiva para aprovechar 1 TB de almacenamiento en la nube
-
Diseño13 años ago
css3ps: plugin que convierte archivos PSD a CSS3
-
Apps9 años ago
Picturethat, app que usa la Realidad Aumentada para visualizar cómo quedarían los cuadros antes de colgarlos
-
Eventos Especiales14 años ago
Especial Día de la Madres: fondos de pantalla especiales para Mamá