
Herramientas
Kimi K3.1 Pro desafía a los gigantes de la IA con pesos abiertos

Kimi K3.1 Pro es el primer modelo de la serie K3.1 de Moonshot AI y su modelo de clase 3T con pesos abiertos más capaz hasta la fecha, con ventana de contexto de un millón de tokens. Según el anuncio oficial, iguala o se acerca a los modelos propietarios más fuertes en codificación, capacidades agénticas y conocimiento, con mejoras notables en creación 3D e investigación financiera.
¿Qué es Kimi K3.1 Pro y qué lo hace diferente?
Se trata de una versión post-entrenada de Kimi K3 con una cantidad sustancialmente mayor de cómputo de entrenamiento posterior. El equipo de Moonshot optimizó cada capa de la pila (marco de aprendizaje por refuerzo, inferencia de contexto largo, eficiencia de entrenamiento, infraestructura de sandbox y verificación de calidad de entornos) para aplicar RL conjunto a escala en cientos de dominios, logrando ganancias consistentes en cada área evaluada.
Lo más relevante para el usuario es la propuesta de valor: rendimiento de frontera con pesos que se publicarán de forma abierta. La compañía también lanza Kimi K3.1 Pro Highspeed, una variante que duplica o triplica la velocidad del modelo base para interacciones más fluidas. Ambos están disponibles en Kimi.ai, Kimi Work, Kimi Code y la API de Kimi.
Rendimiento en benchmarks: ¿dónde se ubica realmente?
Los números publicados son competitivos frente a los pesos pesados del sector. En codificación agéntica y razonamiento, K3.1 Pro se coloca entre los mejores, aunque no encabeza todas las tablas. Estos son los resultados clave del anuncio:
| Benchmark | K3.1 Pro | Comparativa destacada |
|---|---|---|
| Terminal-Bench 4.0 (tareas reales en terminal) | 65.7% | Por encima de GPT-6 Astra (58.2%), apenas detrás de Claude Opus 5.5 (66.4%) |
| Kimi Code Bench 3.0 Long-horizon | 61.2% | Supera el 55.95% de su predecesor K3 |
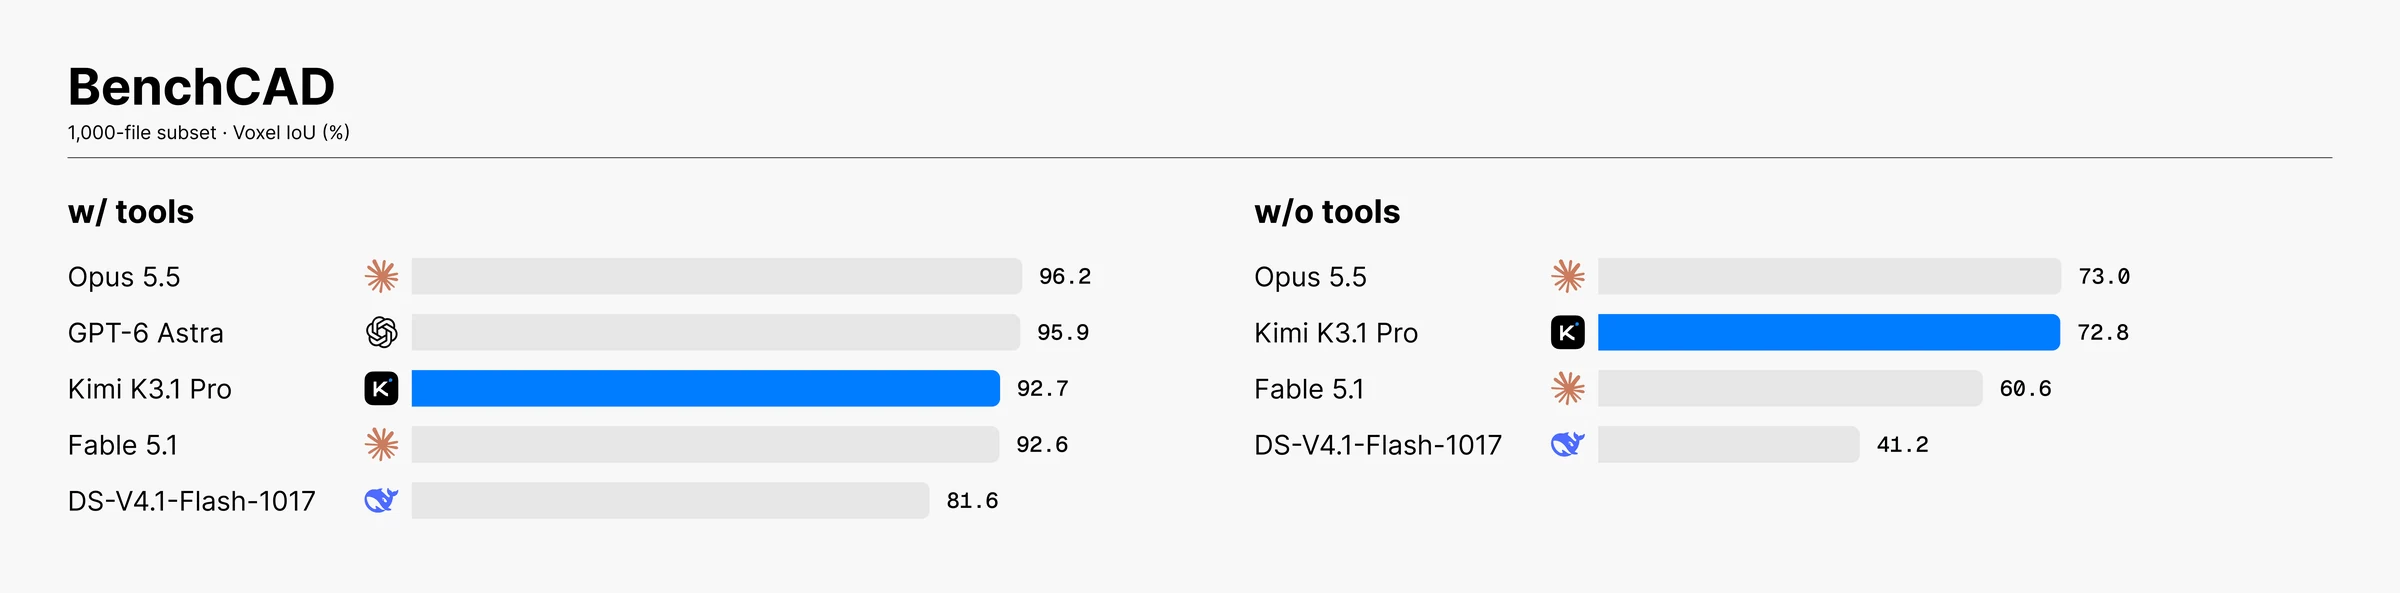
| BenchCAD (reconstrucción 3D con herramientas) | 92.7% | Cerca de Claude Opus 5.5 (96.2%) y GPT-6 Astra (95.9%) |
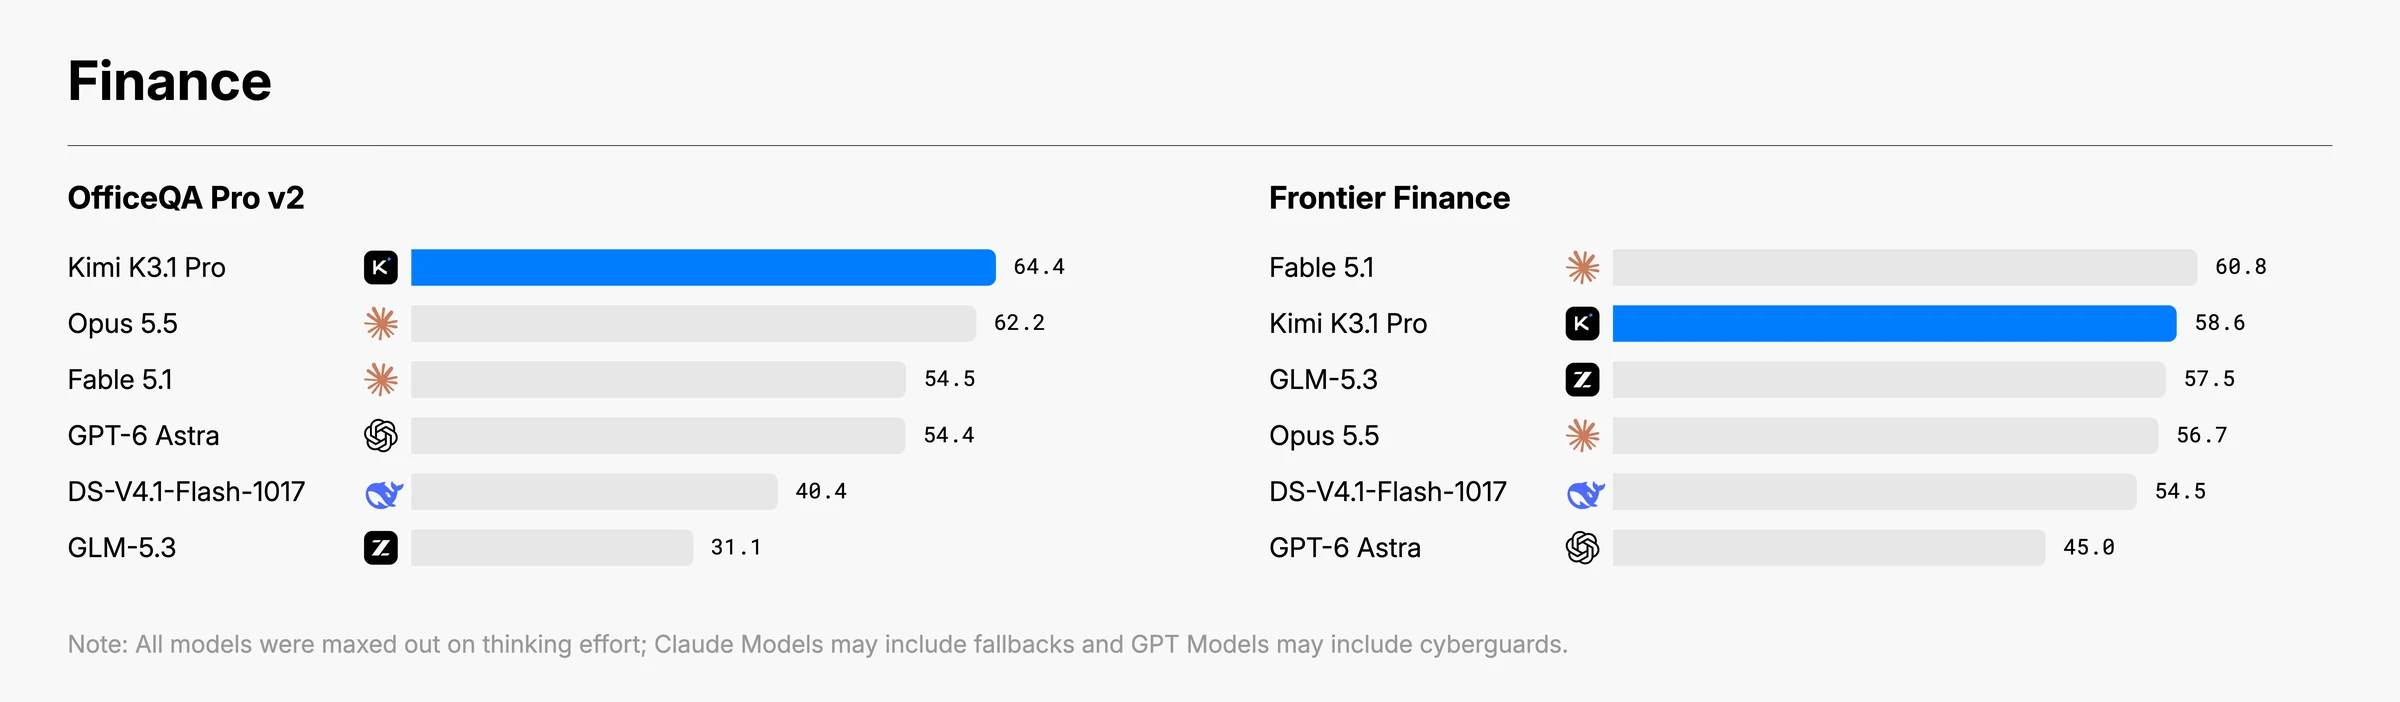
| OfficeQA Pro v2 (análisis fiscal sobre documentos reales) | 64.4 | Resultado del estado del arte según Moonshot |
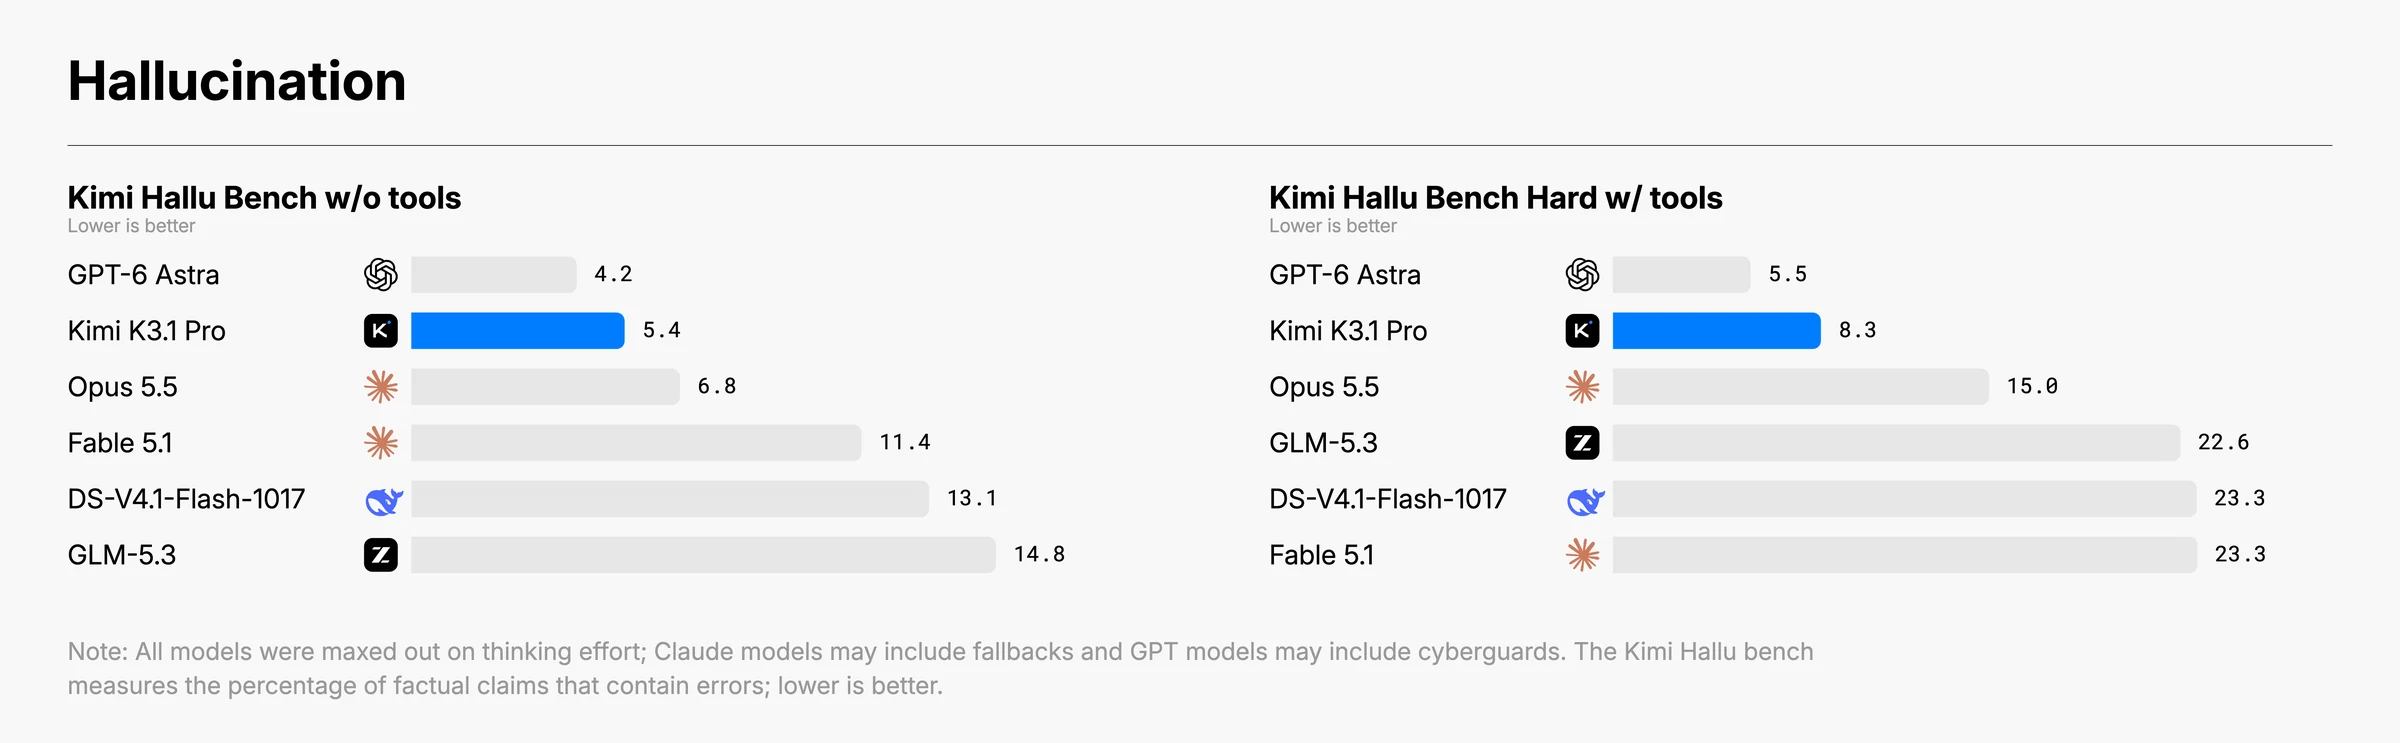
| Kimi Hallu Bench Hard (tasa de alucinación a nivel de afirmación) | 8.3% | Baja desde el 23.4% de K3 |
Vale la pena subrayar dos matices que un lector crítico debería conocer. Primero, varios de estos benchmarks son internos de Moonshot (Kimi Code Bench, Kimi Hallu Bench, OfficeQA Pro), lo cual es habitual en la industria pero conviene señalarlo. Segundo, la prueba de alucinaciones es deliberadamente adversarial: las tasas reportadas no representan las tasas de error en uso cotidiano.
Codificación y creación 3D: ¿qué puede construir?
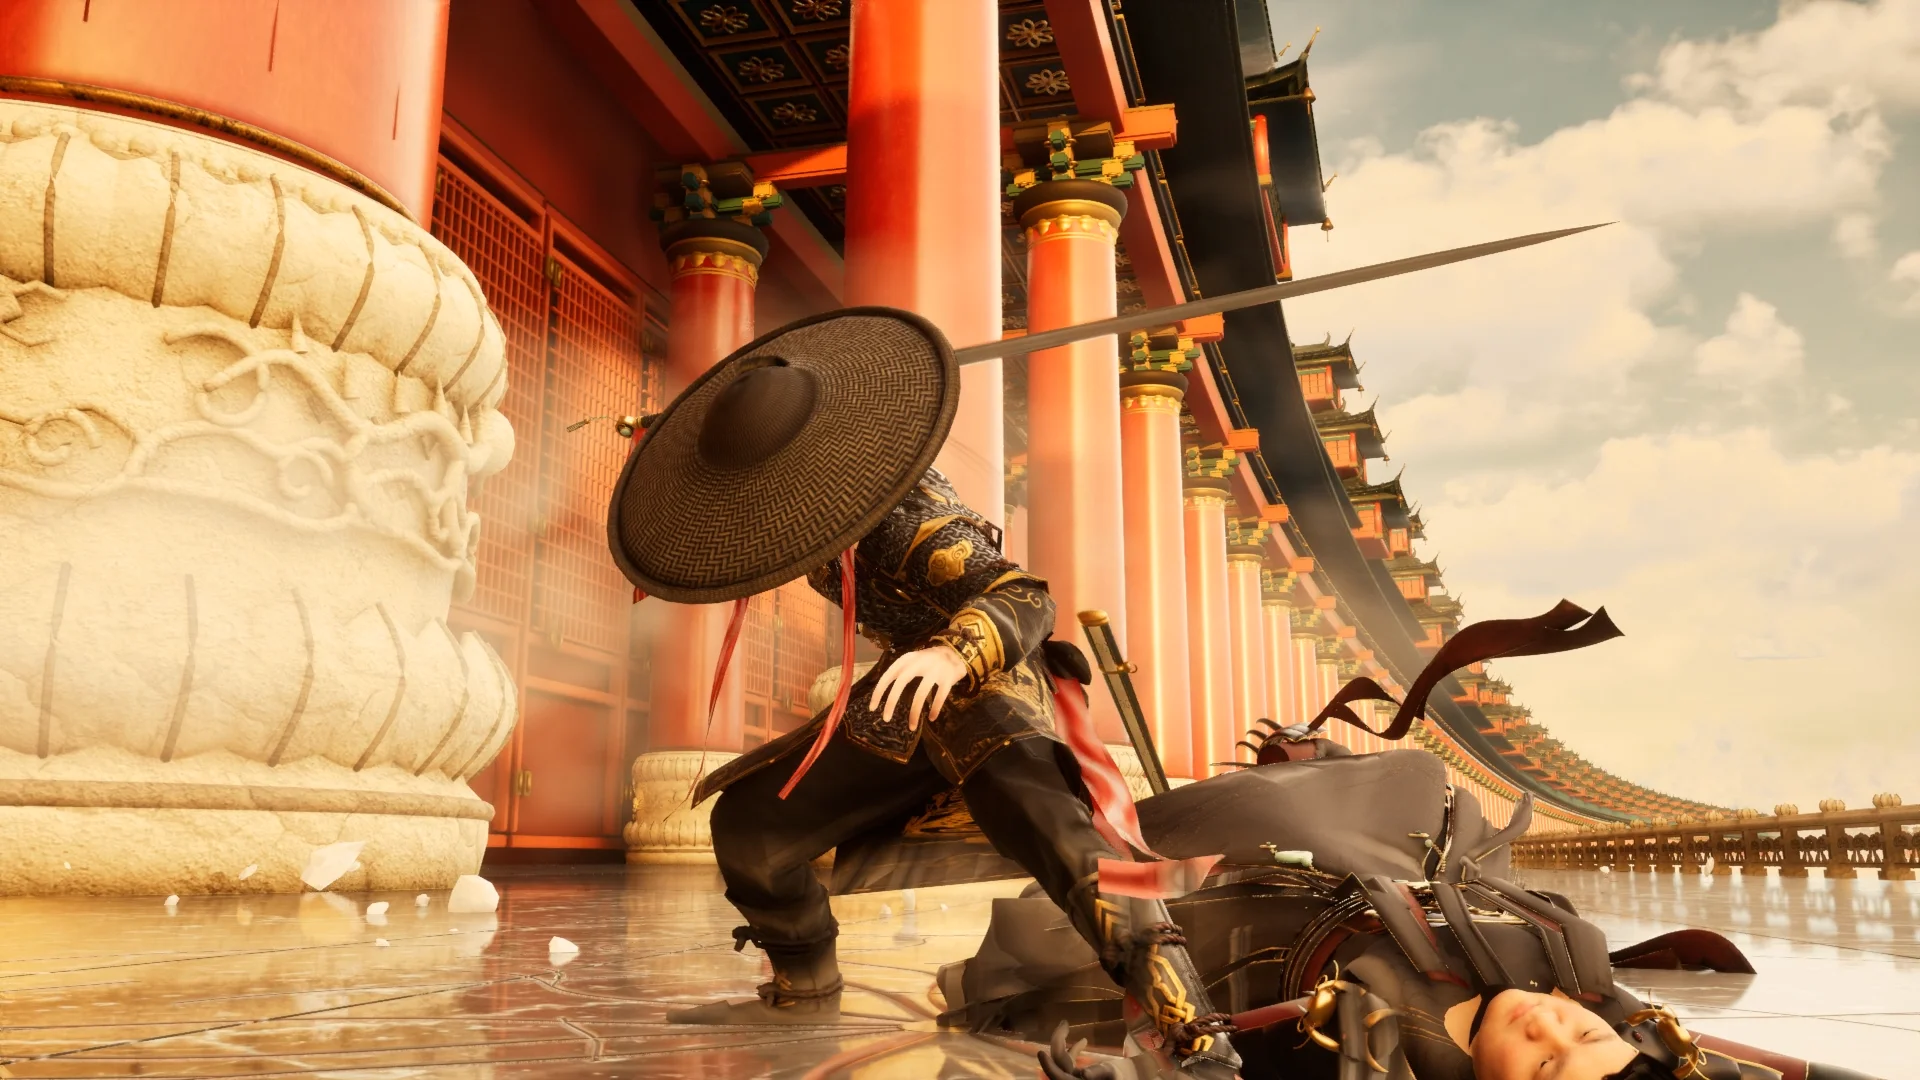
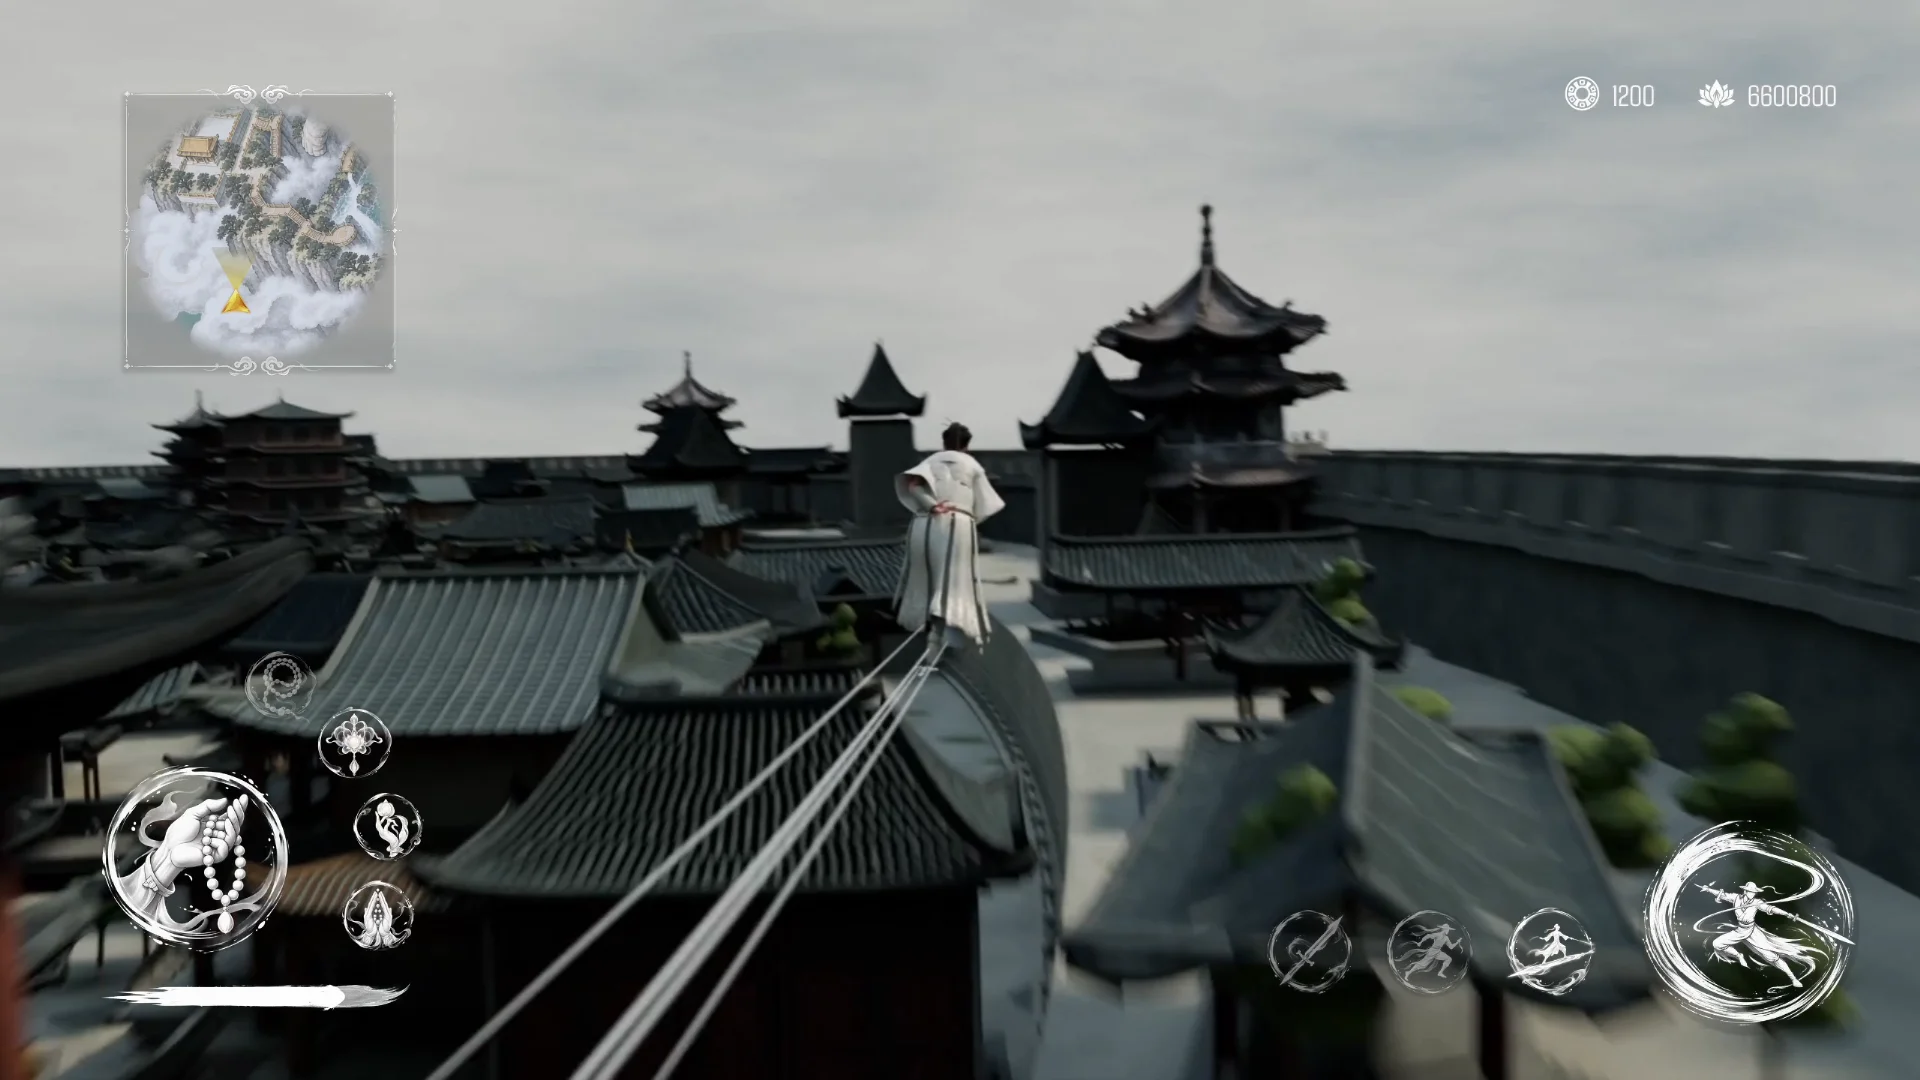
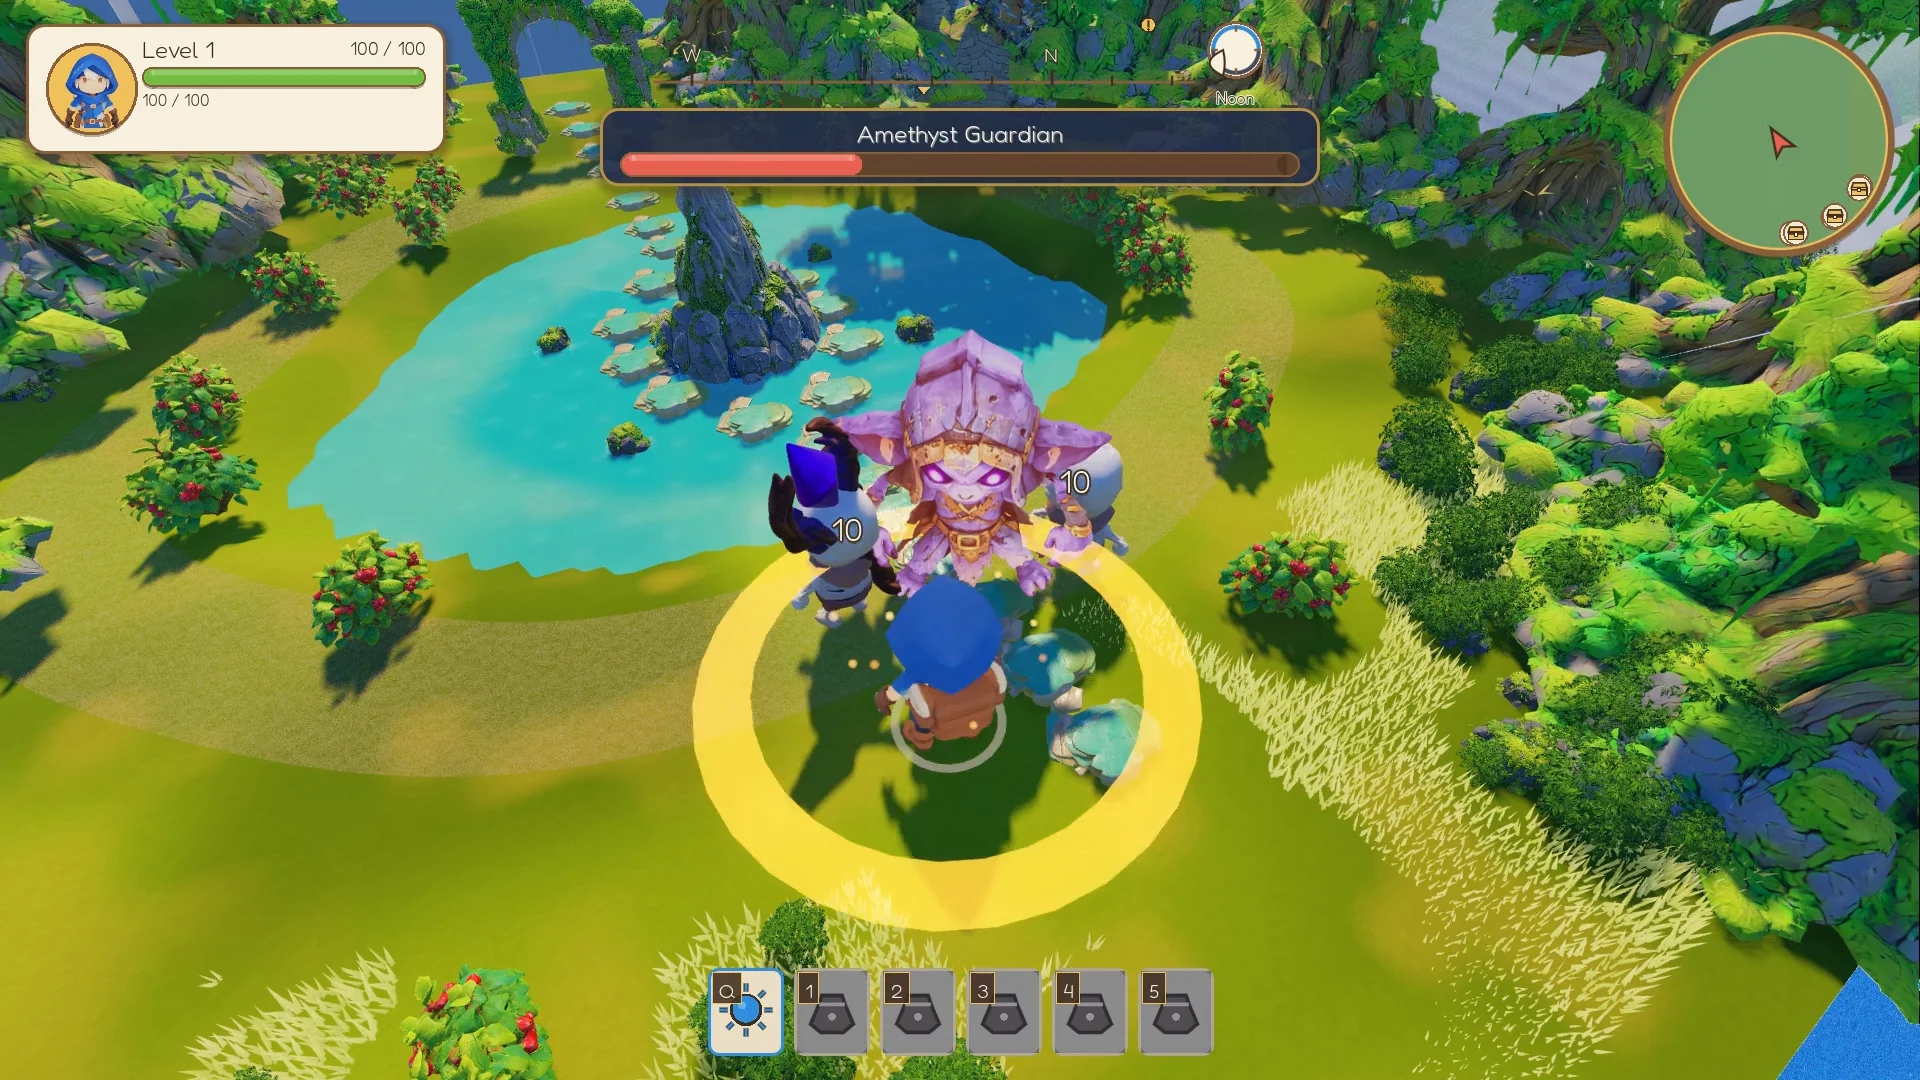
El modelo cubre todo el rango de trabajo de código, desde correcciones rápidas en repositorios reales hasta proyectos completos. Trabaja de forma efectiva en motores de juego como Unity, Unreal Engine y Godot, combinándolos con búsqueda web y generación 3D para crear experiencias terminadas, con mejor composición, tipografía y animación en páginas front-end y escenas Three.js.
El ejemplo más ilustrativo del anuncio es un test interno donde el modelo construyó un simulador de dinámica de caminata humana sobre human-atlas, un modelo anatómico de código abierto con 296 componentes esqueléticos y 402 musculares. A lo largo de 167 misiones y 420 revisiones independientes, el simulado pasó de colapsar en segundos a caminar 11.2 segundos con pasos alternados. Cuando el ajuste de recompensas no mejoraba el movimiento de los brazos, el modelo no insistió en la misma estrategia: ejecutó sondeos de la dinámica del simulador, identificó y corrigió 36 errores en los cálculos de brazos de momento de los músculos del hombro y reentrenó el controlador.
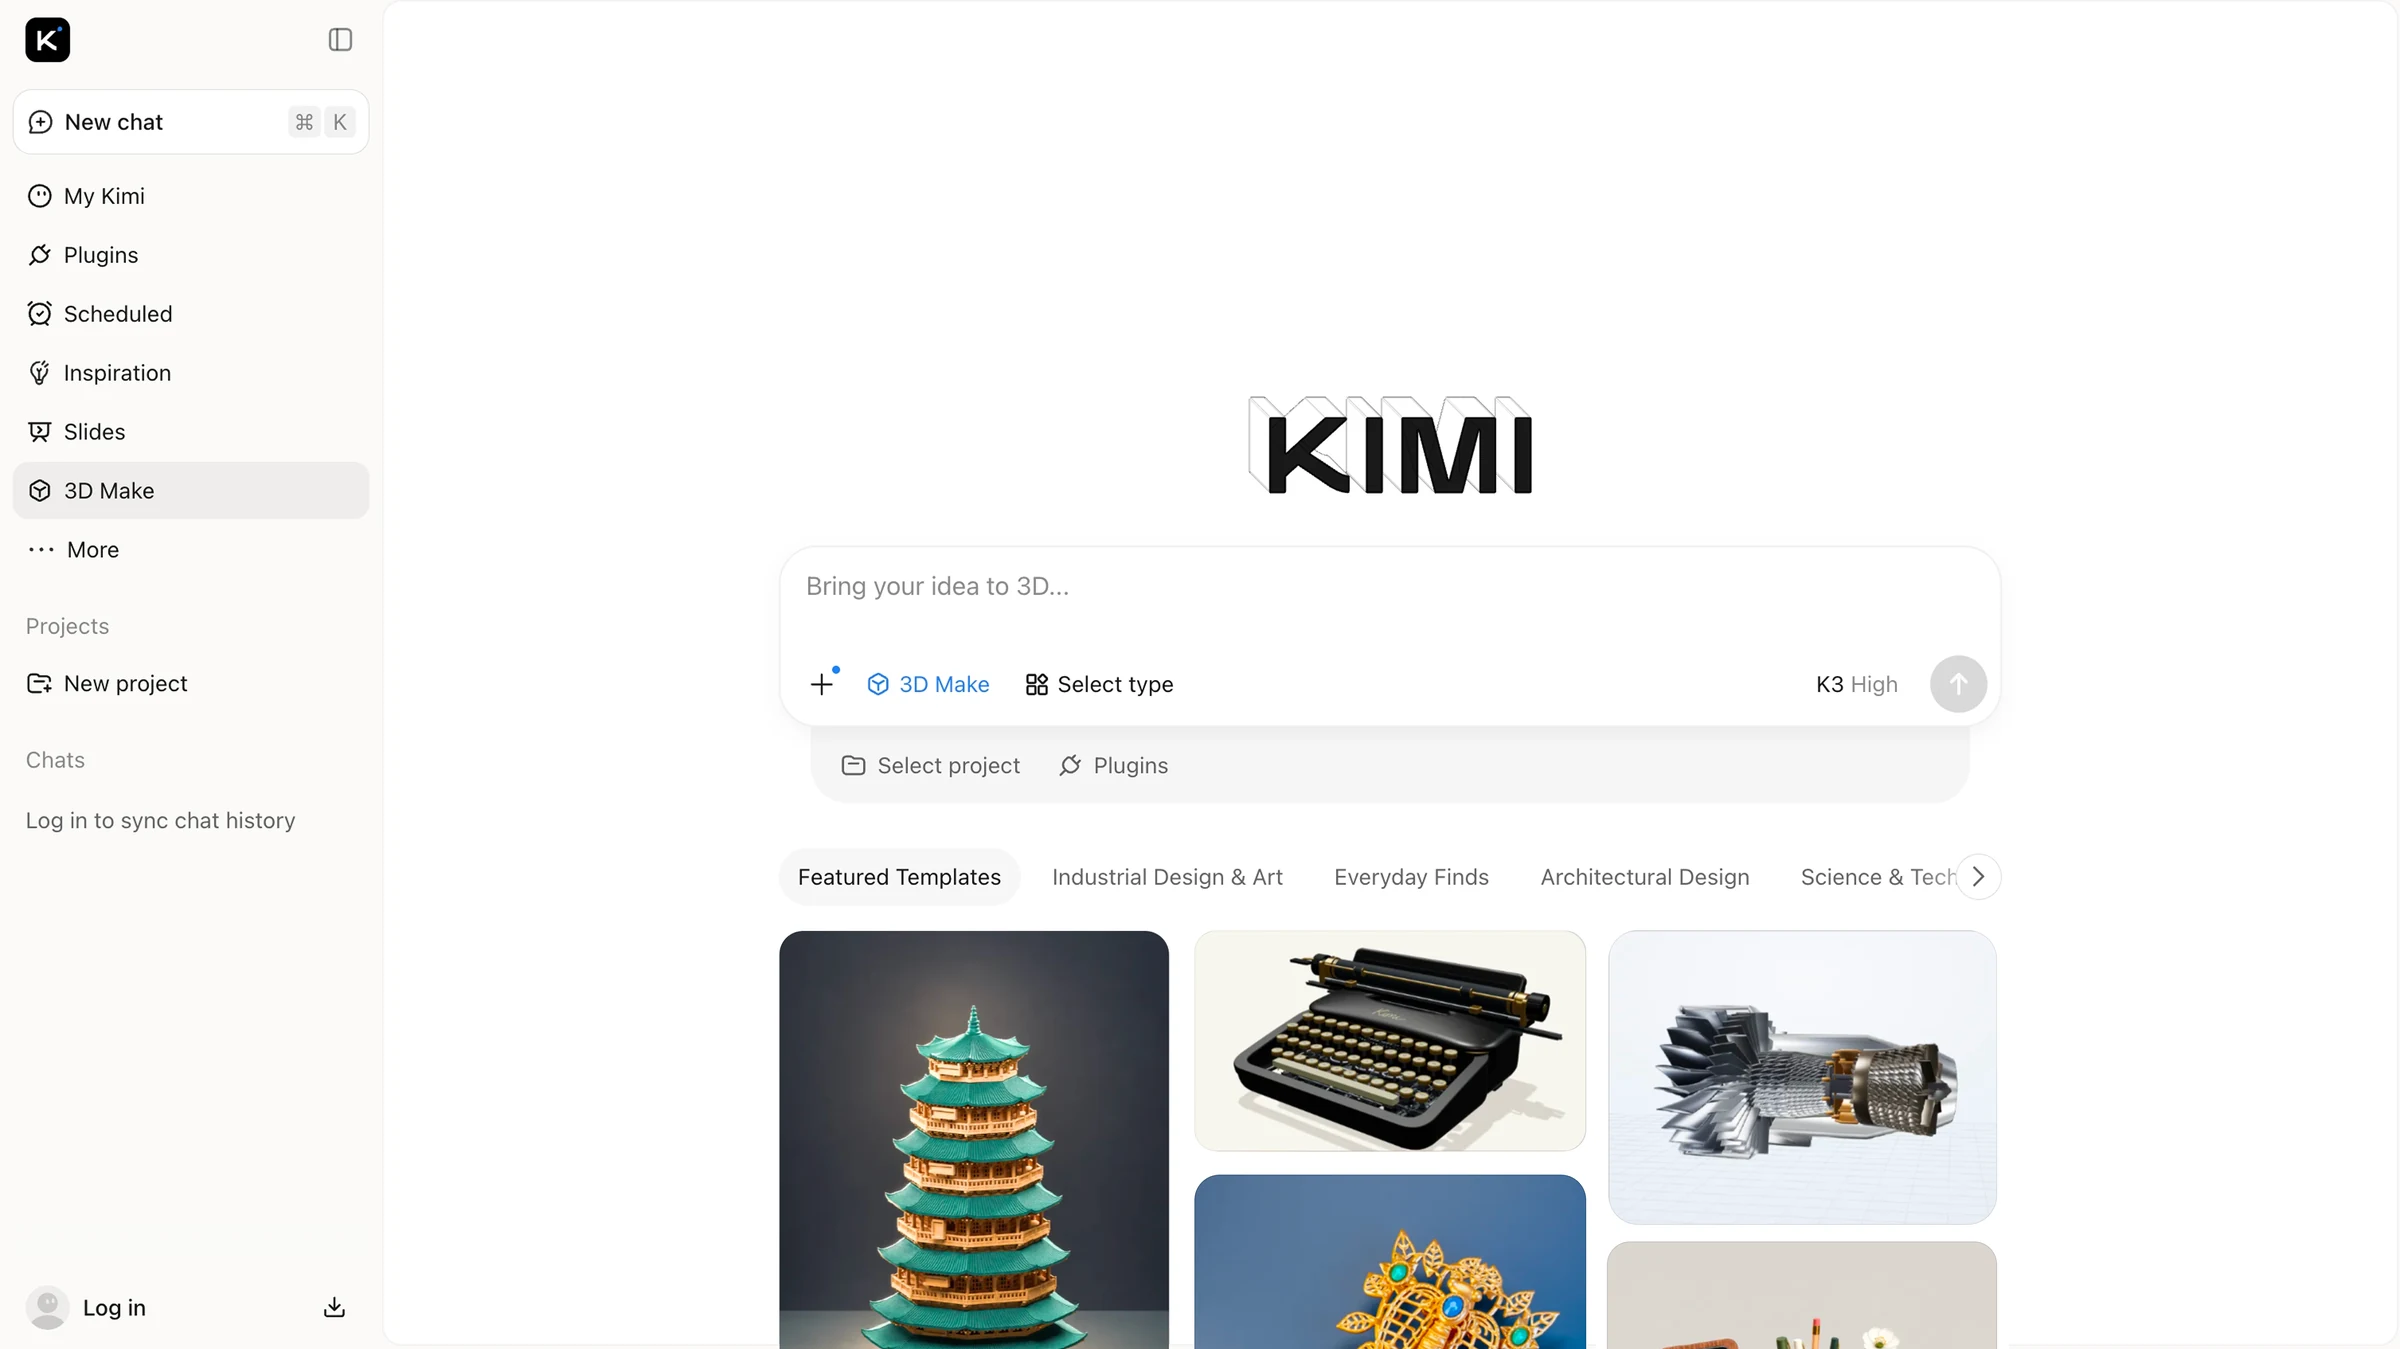
En 3D destaca el modelado paramétrico: piezas mecánicas, modelos arquitectónicos, productos configurables y mobiliario a medida. Sin necesidad de conectores MCP, escribe y ejecuta scripts para Blender y software CAD para construir y refinar activos. La función 3D Make ya está disponible en kimi.ai y la app móvil para previsualizar, editar, descargar para impresión 3D o exportar modelos como video.
Ejemplos en movimiento: experiencias creadas de principio a fin
El anuncio incluye tres demos en video construidas por completo por K3.1 Pro, cada una con su imagen de portada:
Finanzas: flujos completos con menos alucinaciones
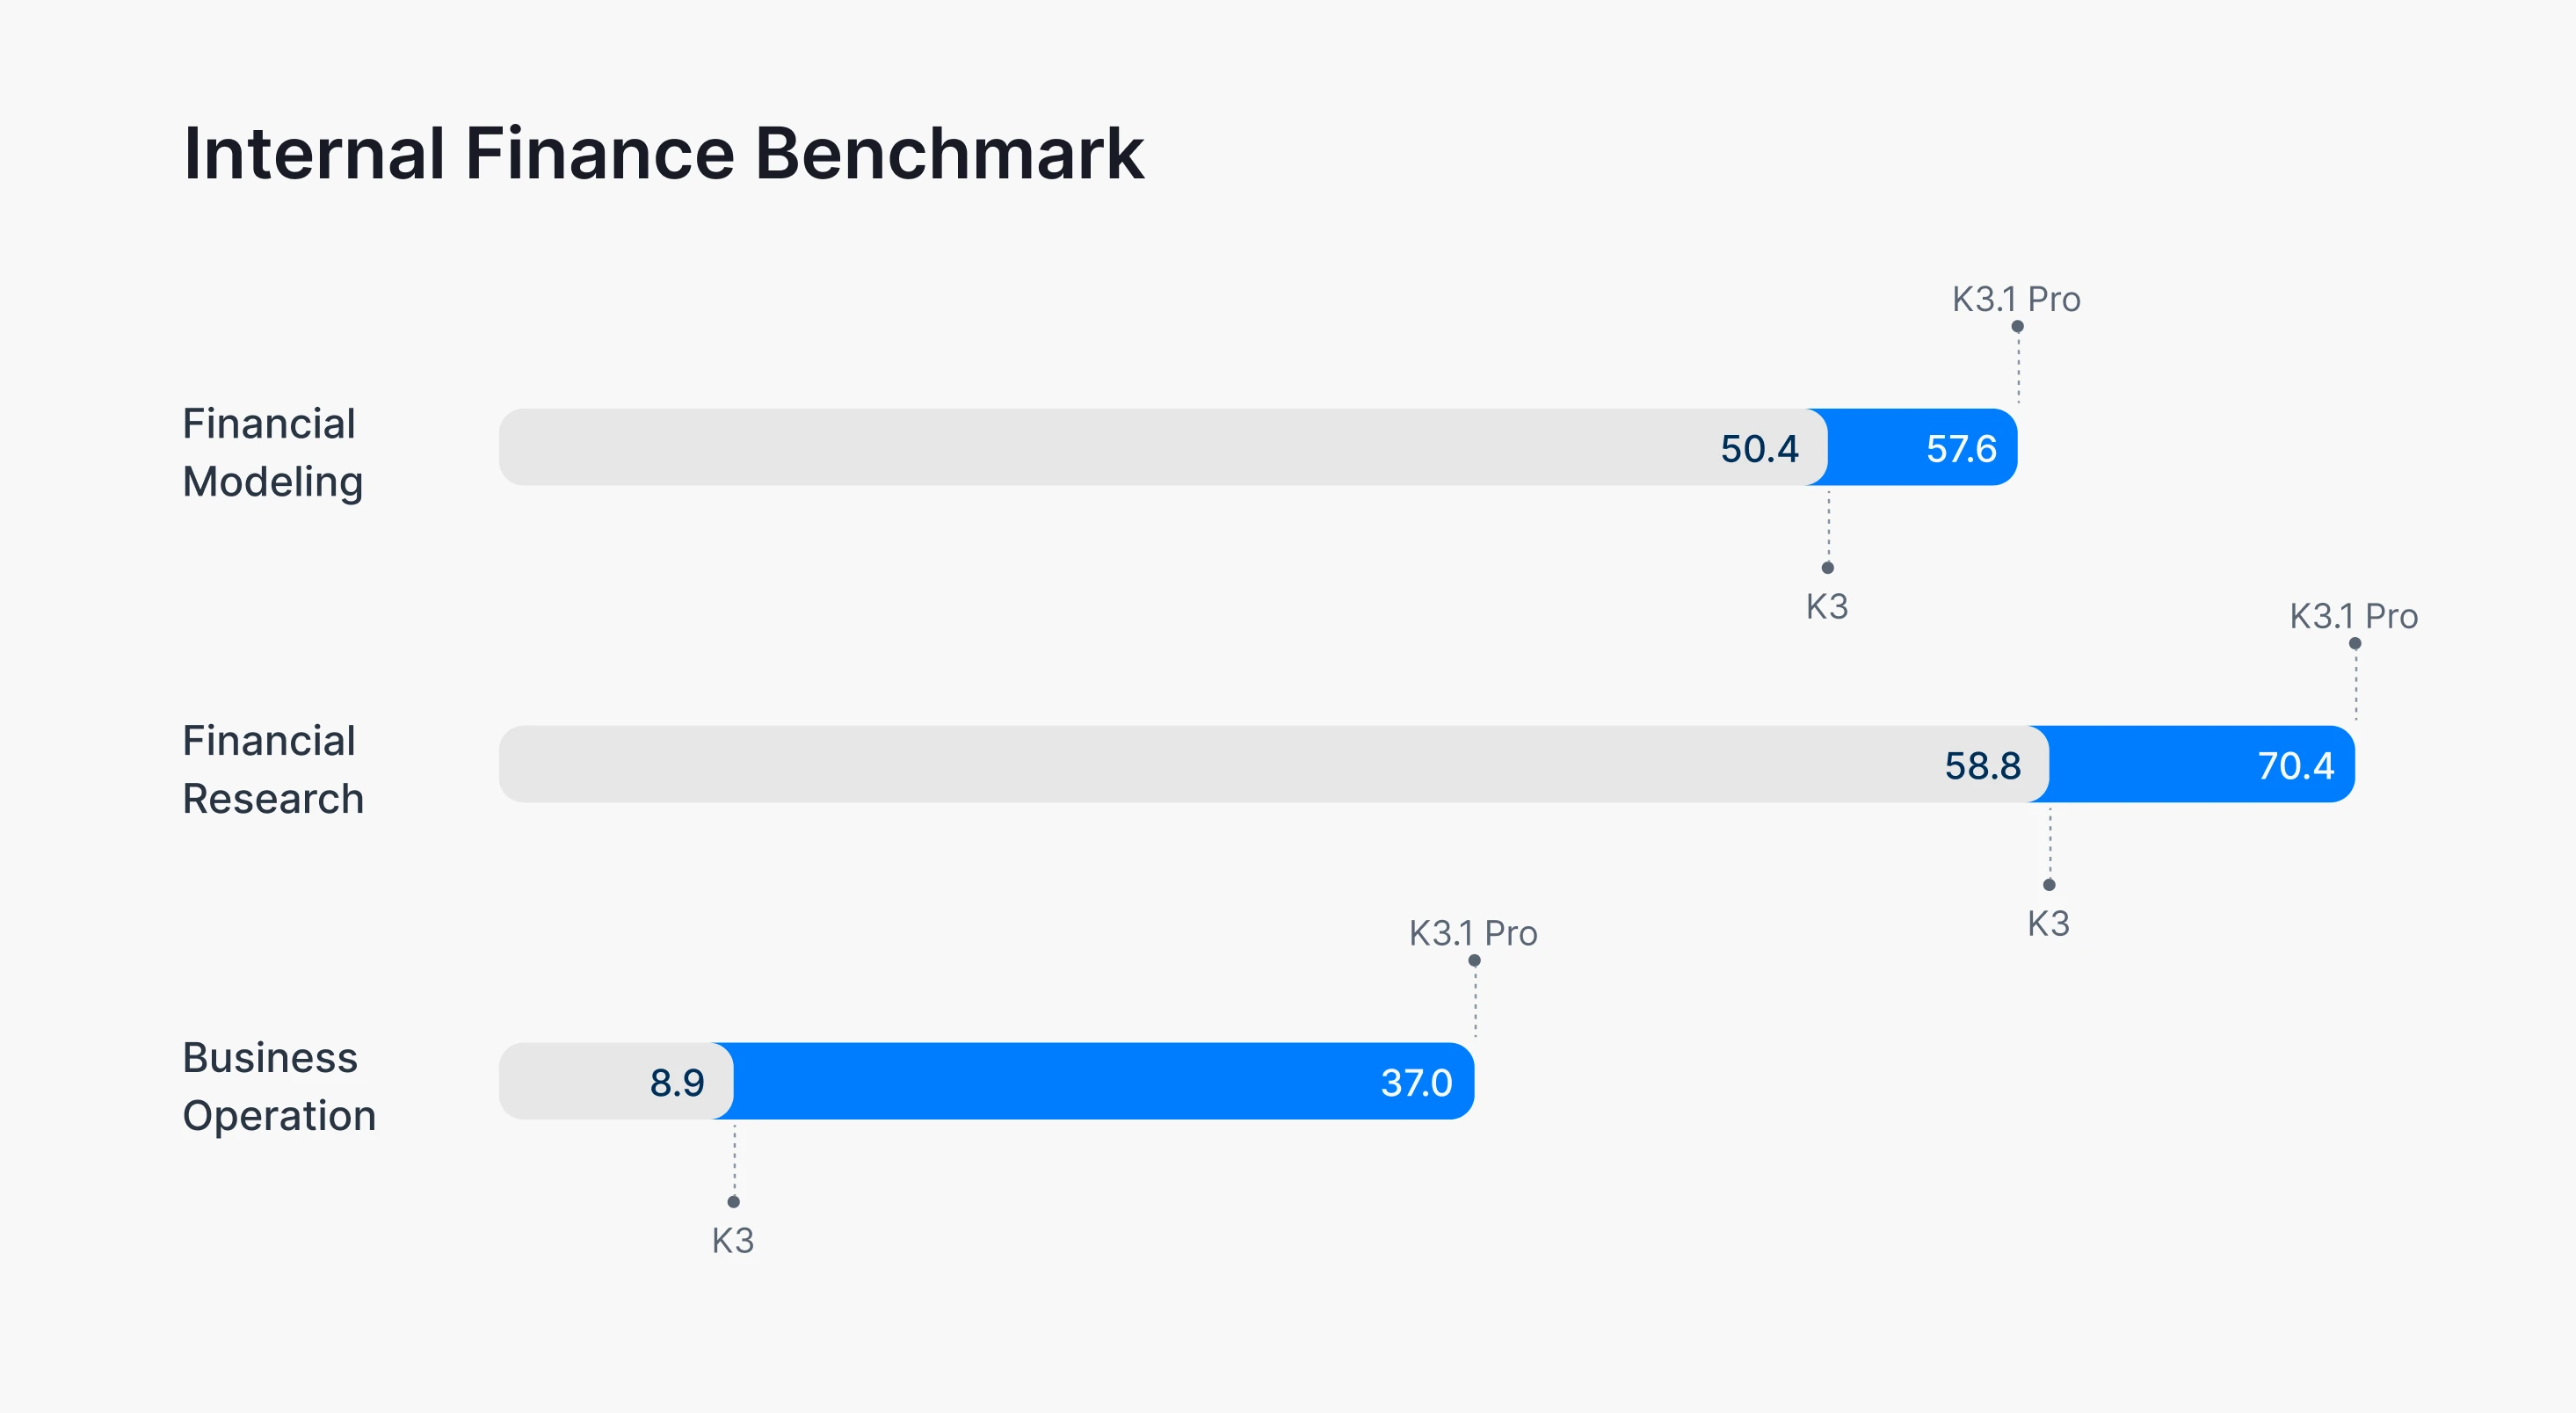
La apuesta por investigación financiera es una de las más explícitas del lanzamiento. K3.1 Pro mejora sobre K3 en los benchmarks internos de la casa: modelación financiera (+7.2 puntos), investigación financiera auditable bajo restricciones de evidencia (+11.6 puntos) y operación de negocios en entornos simulados, donde logra unas 4.2 veces el rendimiento de su predecesor.
La reducción de alucinaciones es el soporte de esa apuesta: la proporción de respuestas con al menos un error factual quedó en el 42.4% de la tasa de su predecesor. En un dominio donde una cifra equivocada cuesta dinero, esa mejora importa más que cualquier puntaje de leaderboard.
Seguridad informática: ¿por qué importa su decisión de pesos abiertos?
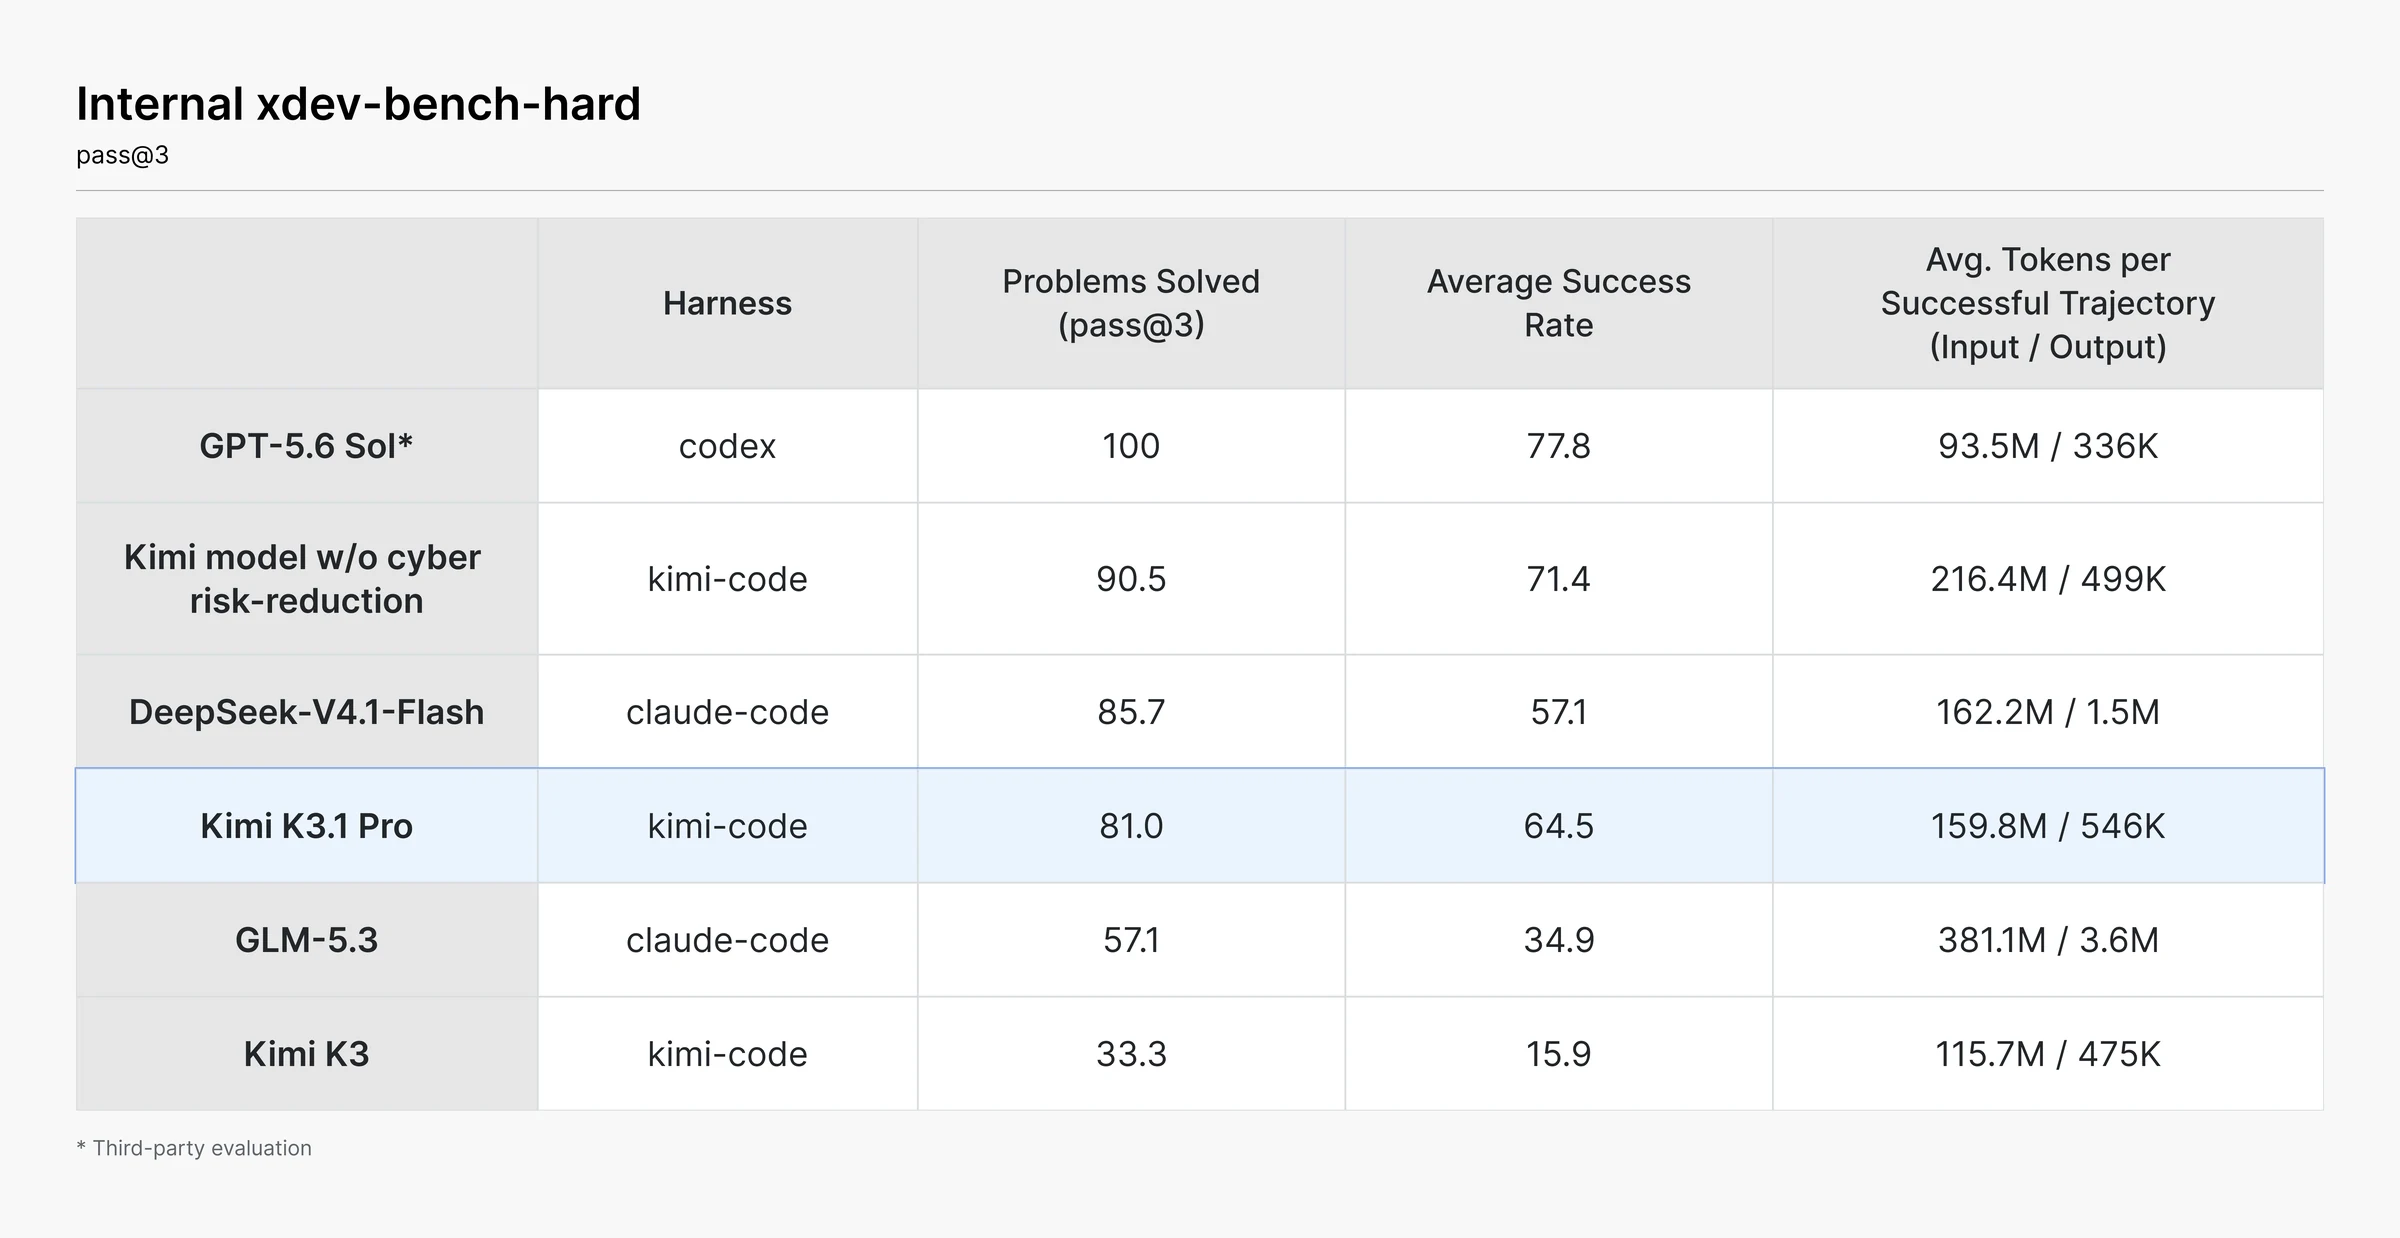
La sección más interesante del anuncio no es de rendimiento, sino de política. Moonshot detectó que la capacidad ofensiva de ciberseguridad crecía junto con el post-entrenamiento, rastreó su origen a datos cibernéticos incrustados en el corpus de entrenamiento medio y en la mezcla de entornos de RL, y decidió eliminarlos en ambas etapas para el lanzamiento abierto, conservando las tareas de codificación de propósito general.
El resultado es medible en xdev-bench-hard, su benchmark interno de descubrimiento y explotación de vulnerabilidades: el punto de control sin filtros resuelve 90.5% de los problemas, mientras que el K3.1 Pro final alcanza 81.0%. La diferencia es deliberada. La postura declarada es doble: no liberar pesos que extiendan la frontera absoluta de capacidad ofensiva, pero sí elevarla de forma gradual en el mundo abierto, argumentando que auditar código, incluidos sistemas heredados, beneficia la seguridad del ecosistema completo.
Alcances y limitaciones: ¿qué debe saber el usuario?
- Pesos abiertos aún no disponibles: la liberación completa está anunciada para el 4 de noviembre de 2026; hoy solo se usa vía productos y API de Kimi.
- Benchmarks internos: parte de los resultados provienen de pruebas propias de Moonshot (Code Bench, Hallu Bench, OfficeQA Pro, xdev-bench), no de tableros independientes.
- No lidera todas las tablas: en BenchCAD y Terminal-Bench queda detrás de Claude Opus 5.5; su ventaja es la combinación de rendimiento y apertura.
- Capacidad ofensiva recortada a propósito: es inferior a la que su propio pipeline podría producir, por decisión de seguridad.
- Empresa desactivado por defecto: los administradores de Kimi Enterprise deben habilitar K3.1 Pro manualmente para su organización.
- Configuración de evaluación: los resultados se obtuvieron con esfuerzo de razonamiento al máximo, lo que puede no reflejar el uso cotidiano más rápido.
Cómo probarlo hoy y contexto del mercado
El despliegue cubre toda la familia de productos: Kimi.ai y las apps móviles (iOS, Android y HarmonyOS), la app de escritorio Kimi Work versión 3.1.0 o posterior para Windows y Mac con Apple silicon, Kimi Code con el comando /model, y la API con los identificadores kimi-k3.1-pro y kimi-k3.1-pro-highspeed, que ofrece retención cero de datos para clientes de API.
El movimiento de Moonshot se inscribe en una carrera donde los modelos de pesos abiertos ya compiten en las evaluaciones agregadas, como vimos con MiniMax M2 y su arquitectura Mixture-of-Experts. La diferencia de K3.1 Pro es el énfasis en dominios verticales como finanzas y 3D, donde pocos modelos abiertos han mostrado resultados comparables.
Para quienes evalúan agentes en producción, el anuncio también conecta con la tendencia de agentes que operan entre tu equipo y la nube que documentamos en el análisis de la apuesta de Windows por la inteligencia híbrida, y con la discusión sobre qué tan lejos deben llegar los asistentes autónomos que abrimos al revisar cómo construir un equipo de agentes de IA eficiente.
Lo más leído en Herramientas
-
 Herramientas
LongCat-2.5 de Meituan abre sus pesos con licencia MIT
Meituan lanzó LongCat-2.5, un modelo de 1.6 billones de parámetros con cerca de 48 mil millones activados por…
-
 Gaming
optimizerDuck: el optimizador de Windows de código abierto
optimizerDuck es una herramienta gratuita y de código abierto para optimizar Windows 10 y Windows 11, disponible en…




optimizerDuck es una herramienta gratuita y de código abierto para optimizar Windows 10 y Windows 11, disponible en GitHub bajo licencia GPL v3. Reúne 42 ajustes de rendimiento y privacidad, 44 opciones de personalización y utilidades de limpieza en un solo ejecutable portátil, con sistema de reversión para deshacer cualquier cambio.
Lo más leído en Herramientas
-
Herramientas
LongCat-2.5 de Meituan abre sus pesos con licencia MIT
Meituan lanzó LongCat-2.5, un modelo de 1.6 billones de parámetros con cerca de 48 mil millones activados por…
-
Gaming
optimizerDuck: el optimizador de Windows de código abierto
optimizerDuck es una herramienta gratuita y de código abierto para optimizar Windows 10 y Windows 11, disponible en…
Meituan lanzó LongCat-2.5, un modelo de 1.6 billones de parámetros con cerca de 48 mil millones activados por token, y días después publicó sus pesos bajo licencia MIT. El modelo apunta a tareas de agentes de largo horizonte: desarrollo en bases de código complejas, construcción de proyectos completos, codificación visual y trabajo de oficina profesional, con una ventana de contexto de un millón de tokens.
Lo más leído en Herramientas
-
Herramientas
LongCat-2.5 de Meituan abre sus pesos con licencia MIT
Meituan lanzó LongCat-2.5, un modelo de 1.6 billones de parámetros con cerca de 48 mil millones activados por…
-
Gaming
optimizerDuck: el optimizador de Windows de código abierto
optimizerDuck es una herramienta gratuita y de código abierto para optimizar Windows 10 y Windows 11, disponible en…
Comunicados de Prensa
¿Se está enfriando el boom de la IA? Arabia Saudita lidera la caída del interés
El boom de la inteligencia artificial no se apagó, pero sí perdió velocidad. Esa es la conclusión central del informe de noviembre de 2026 de Go Vista AI, que comparó 31 países para detectar dónde se enfría más rápido el interés por la IA. Arabia Saudita encabeza la lista, seguida de Corea del Sur e Indonesia. Las búsquedas siguen creciendo y las visitas a chatbots siguen subiendo. Lo que cambió es el ritmo.
Lo más leído en Herramientas
-
Herramientas
LongCat-2.5 de Meituan abre sus pesos con licencia MIT
Meituan lanzó LongCat-2.5, un modelo de 1.6 billones de parámetros con cerca de 48 mil millones activados por…
-
Gaming
optimizerDuck: el optimizador de Windows de código abierto
optimizerDuck es una herramienta gratuita y de código abierto para optimizar Windows 10 y Windows 11, disponible en…
Lo más leído
-
 Sin categoría
Revisión: Here Comes the Horde – Hordas masivas en automático
-
 Entretenimiento
Primeras impresiones: Chess of the Hidden Gates – Ajedrez y mazos
-
Gaming
optimizerDuck: el optimizador de Windows de código abierto
-
 Entretenimiento
Revisión: Pegs of Hell – Pachinko roguelike de casino infernal
-
 Consola
Revisión: Highway Blossoms: Gold Rush Edition en Switch
-

 Apps11 años ago
AMPcast, la herramienta de Pandora que permite a los artistas grabar mensajes de audio directamente a sus seguidores
-
 Blogs5 años ago
Conoce los mejores sitios de Torrents para descargar todo tipo de contenidos
-
Android5 años ago
Aprende cómo usar Discord para ver películas con tus amigos
-
Arte y Cultura14 años ago
Colección de fondos de pantalla basados en Super Héroes
-

 Almacenamiento2 años ago
Cómo usar TeraBox: La guía definitiva para aprovechar 1 TB de almacenamiento en la nube
-
Diseño13 años ago
css3ps: plugin que convierte archivos PSD a CSS3
-
Apps9 años ago
Picturethat, app que usa la Realidad Aumentada para visualizar cómo quedarían los cuadros antes de colgarlos
-
Eventos Especiales14 años ago
Especial Día de la Madres: fondos de pantalla especiales para Mamá