

Almacenamiento
Soup: la herramienta de código abierto para entrenar modelos de IA sin límites de hardware

En el mundo de la inteligencia artificial, el fine-tuning de modelos de lenguaje es una tarea compleja que suele requerir hardware costoso y conocimientos técnicos avanzados. Soup es una herramienta de código abierto que democratiza este proceso, permitiendo entrenar modelos avanzados como Llama-3.1-8B en una GPU de 4 GB gracias a su tecnología de layer streaming y cuantización eficiente.
Con 23 métodos de entrenamiento, 142 recetas preconfiguradas y soporte para múltiples arquitecturas (Llama, Qwen, Mistral, entre otras), Soup automatiza la configuración, optimiza el uso de recursos y garantiza resultados confiables. Además, incluye herramientas para evaluar modelos, detectar fallos silenciosos en los datos y asegurar que cada modelo entrenado cumpla con estándares de calidad antes de su implementación.
En esta guía, exploraremos qué es Soup, cómo funciona, sus ventajas clave y cómo puedes comenzar a usarlo para entrenar tus propios modelos de IA, incluso con recursos limitados.

¿Qué es Soup?
Soup es una herramienta de línea de comandos (CLI) diseñada para simplificar el proceso de fine-tuning de modelos de lenguaje. A diferencia de otras herramientas que exigen una configuración manual compleja, Soup se encarga de:
- Analizar y preparar los datos antes del entrenamiento para evitar errores comunes como falta de tokens de finalización o duplicados semánticos.
- Seleccionar automáticamente el método de entrenamiento más adecuado para tu modelo y conjunto de datos.
- Generar configuraciones optimizadas (ej:
soup.yaml) sin necesidad de búsquedas manuales de hiperparámetros como tasa de aprendizaje, épocas o cuantización. - Evaluar los resultados y bloquear modelos que no cumplan con los estándares de calidad.
- Corregir problemas durante el entrenamiento, como el reward hacking.
Soup está diseñado para ser accesible y eficiente. Su tecnología de layer streaming permite cargar el modelo base en capas desde la RAM o el almacenamiento NVMe, reduciendo el uso de VRAM y permitiendo entrenar modelos grandes en hardware modesto.
¿Por qué usar Soup?
El fine-tuning tradicional puede ser un proceso complicado, especialmente para quienes no tienen experiencia en la optimización de modelos de IA. Soup resuelve estos problemas con las siguientes ventajas:
1. Automatización inteligente
Soup elimina la necesidad de ajustar manualmente hiperparámetros. En su lugar, utiliza reglas predefinidas para generar configuraciones optimizadas automáticamente. Esto reduce el tiempo de preparación y minimiza errores humanos.
Ejemplo: Mientras que en herramientas tradicionales debes definir manualmente parámetros como learning_rate, batch_size o quantization_bit, Soup los calcula y aplica de forma automática.
2. Eficiencia en hardware limitado
Una de las características más destacadas de Soup es su capacidad para entrenar modelos grandes en hardware modesto. Gracias al layer streaming, Soup carga el modelo base en capas desde la RAM o el almacenamiento NVMe, en lugar de cargarlo completo en la VRAM. Esto permite entrenar modelos como:
- Llama-3.1-8B en una GPU de 4 GB a 119.6 tokens/segundo.
- Qwen2.5-3B en la misma GPU a 264.2 tokens/segundo.
Además, Soup soporta la cuantización a 4 bits (NF4), lo que reduce el tamaño del modelo en un factor de cuatro, liberando aún más recursos.
3. Soporte para múltiples métodos de entrenamiento
Soup es compatible con 23 métodos de entrenamiento, incluyendo:
| Método | Descripción | Casos de uso |
|---|---|---|
| SFT | Supervised Fine-Tuning | Entrenamiento supervisado tradicional para tareas específicas. |
| DPO | Direct Preference Optimization | Optimización directa de preferencias para chatbots o sistemas de recomendación. |
| ORPO | Odds Ratio Preference Optimization | Optimización basada en proporciones de probabilidad. |
| SimPO | Simple Preference Optimization | Optimización simplificada de preferencias. |
| KTO | Kernel Touring Optimization | Optimización basada en núcleos para tareas complejas. |
Todos estos métodos pueden ejecutarse sobre un modelo base transmitido en capas, lo que los hace accesibles incluso en hardware limitado.
4. Evaluación y garantía de calidad
Soup no solo entrena modelos, sino que también los evalúa para garantizar que cumplan con los estándares de calidad. Con herramientas como soup ship, puedes obtener un veredicto claro:
- SHIP: El modelo está listo para implementarse.
- DON’T SHIP: El modelo tiene problemas y no debe implementarse.
Además, Soup incluye herramientas para:
- Detectar duplicados semánticos en los datos de entrenamiento.
- Verificar la memorización de información confidencial (canary testing).
- Evaluar la diversidad de los datos para evitar brain-rot (degradación por falta de variedad).
5. Integración con el ecosistema de IA
Soup está diseñado para integrarse con las herramientas más populares del ecosistema de IA, incluyendo:
| Categoría | Herramientas compatibles |
|---|---|
| Modelos | Hugging Face, Ollama, vLLM, SGLang, llama.cpp |
| Entrenamiento | Unsloth, DeepSpeed, FlashAttention |
| Seguimiento | W&B, MLflow, SwanLab, Trackio, TensorBoard |
| Exportación | GGUF, ONNX, TensorRT, AWQ, GPTQ |
Esto permite que Soup se adapte a flujos de trabajo existentes sin requerir cambios significativos en la infraestructura.
6. Código abierto y gratuito
Soup es un proyecto de código abierto bajo la licencia Apache-2.0, lo que significa que puedes usarlo, modificarlo y distribuirlo libremente. Además:
- No requiere suscripción ni tarjeta de crédito.
- Funciona completamente offline.
- Todas las métricas de rendimiento publicadas están respaldadas por pruebas reales.
¿Cómo funciona Soup?
Soup simplifica el proceso de fine-tuning mediante una serie de pasos automatizados. A continuación, te explicamos cómo funciona internamente:
1. Preparación de los datos
Antes de comenzar el entrenamiento, Soup analiza los datos para detectar problemas comunes, como:
- Errores en el formato (ej: falta de tokens de finalización).
- Duplicados semánticos (textos reescritos que MinHash no detecta).
- Falta de diversidad en los datos.
- Memorización de información confidencial.
Con herramientas como soup data doctor y soup advise, puedes identificar y corregir estos problemas antes de que afecten el entrenamiento.
2. Selección del método de entrenamiento
Soup elige automáticamente el método de entrenamiento más adecuado para tu modelo y conjunto de datos. Por ejemplo:
- Si estás entrenando un modelo para tareas de generación de texto, Soup puede seleccionar SFT.
- Si estás optimizando preferencias (ej: para un chatbot), puede elegir DPO o ORPO.
Además, Soup genera una configuración optimizada (ej: soup.yaml) que incluye parámetros como:
- Número de épocas.
- Tasa de aprendizaje.
- Cuantización (4-bit, 8-bit, etc.).
- Parámetros específicos del método (ej:
lora_rankpara LoRA).
3. Entrenamiento con layer streaming
Si el modelo es demasiado grande para caber en la VRAM de tu GPU, Soup utiliza layer streaming. Este proceso consiste en:
- Cargar el modelo base en capas desde la RAM o el almacenamiento NVMe.
- Cuantizar el modelo base a 4 bits (NF4) para reducir su tamaño.
- Copiar las capas en la VRAM una por una, según sea necesario.
Esto permite que modelos como Llama-3.1-8B se entrenen en una GPU de 4 GB sin problemas de memoria. Además, el modelo de referencia para métodos como DPO se carga de la misma manera, sin costo adicional de VRAM.
4. Evaluación y validación
Después del entrenamiento, Soup evalúa el modelo para garantizar que cumpla con los estándares de calidad. Con soup ship, obtienes un veredicto claro:
- SHIP: El modelo está listo para implementarse.
- DON’T SHIP: El modelo tiene problemas y no debe implementarse.
Además, Soup genera evidencia cometible junto con los pesos del modelo, lo que permite rastrear qué configuración produjo cada resultado.
Guía paso a paso: cómo usar Soup
A continuación, te mostramos cómo instalar y usar Soup para entrenar tu primer modelo de IA.
1. Instalación
Soup requiere Python 3.10 a 3.12. Puedes instalarlo con el siguiente comando:
pip install "soup-cli[train]"
Esto instalará la CLI de Soup junto con todas las dependencias necesarias para el entrenamiento.
2. Configuración inicial
Una vez instalado, ejecuta el siguiente comando para inicializar un proyecto de Soup:
soup init
Este comando generará un archivo de configuración soup.yaml con los parámetros predeterminados. Puedes personalizar este archivo según tus necesidades.
3. Preparación de los datos
Antes de entrenar, asegúrate de que tus datos estén en el formato correcto. Soup soporta múltiples formatos, incluyendo:
- JSONL (recomendado para datasets estructurados).
- CSV o TXT para datos simples.
Puedes usar herramientas como soup data doctor para validar tus datos:
soup data doctor --path ./data/entrenamiento.jsonl
4. Entrenamiento del modelo
Una vez que tengas tus datos y configuración listos, ejecuta el siguiente comando para comenzar el entrenamiento:
soup train
Soup se encargará del resto: cargará el modelo, aplicará la configuración y comenzará el entrenamiento. Si el modelo es demasiado grande para tu GPU, Soup activará automáticamente el layer streaming.
Ejemplo de configuración para layer streaming:
base: Qwen/Qwen2.5-3B

task: dpo

data:

train: ./prefs.jsonl

format: dpo

max_length: 512

training:

stream_layers: true

quantization: 4bit

stream_source: auto

batch_size: 1

lora: { r: 16, target_modules: [q_proj, v_proj] }
5. Evaluación del modelo
Después del entrenamiento, puedes evaluar el modelo con:
soup ship
Este comando ejecutará una serie de pruebas automatizadas y te dará un veredicto claro sobre si el modelo está listo para implementarse.
6. Implementación
Si el modelo pasa la evaluación, puedes implementarlo en tu aplicación. Soup es compatible con múltiples plataformas de implementación, como:
- Ollama: Para implementación local.
- vLLM: Para servidores de inferencia escalables.
- Hugging Face Spaces: Para compartir modelos en línea.
Por ejemplo, para implementar el modelo con Ollama:
ollama create mi-modelo -f ./saves/mi-modelo-entrenado
Casos de uso prácticos
Soup es una herramienta versátil que puede aplicarse en múltiples escenarios. Aquí te mostramos algunos ejemplos prácticos:
1. Entrenar un chatbot personalizado
Si quieres crear un chatbot especializado en un dominio específico (ej: atención al cliente, educación, etc.), puedes usar Soup para:
- Preparar un dataset con conversaciones de ejemplo.
- Entrenar el modelo usando SFT o DPO.
- Evaluar el rendimiento del chatbot con
soup ship.
Por ejemplo, si tienes un dataset de preguntas y respuestas sobre tecnología, puedes entrenar un modelo como Llama-3.1-8B para que actúe como un asistente técnico.
2. Optimizar un modelo para tareas específicas
Si ya tienes un modelo preentrenado pero quieres adaptarlo para una tarea específica (ej: traducción, resumen de textos, generación de código), Soup puede ayudarte a:
- Seleccionar el método de entrenamiento más adecuado (ej: LoRA para ajustes ligeros).
- Optimizar los hiperparámetros automáticamente.
- Entrenar el modelo en hardware limitado.
3. Migración desde otras herramientas
Si ya estás usando herramientas como LLaMA-Factory, Axolotl o Unsloth, Soup ofrece un comando para migrar tus configuraciones existentes:
soup migrate --config llama_factory_config.yaml
Esto convertirá automáticamente tu configuración al formato de Soup, permitiéndote continuar el entrenamiento sin perder el progreso.
4. Entrenamiento en hardware limitado
Uno de los mayores desafíos en el fine-tuning es el hardware. Con Soup, puedes entrenar modelos grandes en una GPU de 4 GB gracias al layer streaming. Por ejemplo:
- Llama-3.1-8B se entrena a 119.6 tokens/segundo en una RTX 3050 (4 GB).
- Qwen2.5-3B alcanza 264.2 tokens/segundo en la misma GPU.
Esto abre la puerta a que más personas puedan experimentar con modelos avanzados sin necesidad de hardware costoso.
Ventajas de Soup frente a otras herramientas
Soup no es la única herramienta para fine-tuning, pero ofrece varias ventajas clave frente a alternativas como LLaMA-Factory, Axolotl o Unsloth:
| Característica | Soup | Otras herramientas |
|---|---|---|
| Automatización | Automatiza la selección de métodos, hiperparámetros y configuraciones. | Requiere configuración manual compleja. |
| Eficiencia en hardware | Permite entrenar modelos como Llama-3.1-8B en GPUs de 4 GB. | Requiere al menos 8 GB o más de VRAM. |
| Evaluación integrada | Incluye herramientas como soup ship para validar modelos. |
No siempre incluye evaluación automatizada. |
| Métodos de entrenamiento | Soporte para 23 métodos, incluyendo DPO, ORPO, SimPO y KTO. | Limitados a SFT o LoRA en la mayoría de los casos. |
| Código abierto | 100% código abierto bajo licencia Apache-2.0. | Algunas herramientas tienen limitaciones de licencia. |
Limitaciones y consideraciones
Aunque Soup es una herramienta poderosa, es importante tener en cuenta algunas limitaciones:
1. Layer streaming en versión BETA
El layer streaming es una característica en versión BETA. Aunque funciona correctamente para modelos como Llama-3.1-8B, puede tener limitaciones con modelos más grandes o configuraciones específicas.
2. Requisitos de hardware para modelos muy grandes
Aunque Soup permite entrenar modelos como Llama-3.1-8B en una GPU de 4 GB, modelos más grandes (ej: 70B) pueden requerir hardware adicional o configuraciones avanzadas.
3. Curva de aprendizaje para configuraciones avanzadas
Si bien Soup automatiza gran parte del proceso, configuraciones avanzadas (ej: multi-GPU o DeepSpeed) pueden requerir conocimientos técnicos adicionales.
El futuro de Soup: Soup Zero
El equipo detrás de Soup está trabajando en Soup Zero, una plataforma completa de trabajo con IA que integrará:
- Playground: Un entorno interactivo para probar modelos.
- Gestión de datos: Herramientas avanzadas para preparar y analizar datasets.
- Evaluaciones automatizadas: Pruebas integradas para validar modelos.
- Fine-tuning: Entrenamiento optimizado.
- Implementación: Despliegue de modelos en producción.
- Monitoreo: Seguimiento del rendimiento de los modelos en tiempo real.
Soup Zero estará disponible como una aplicación de escritorio que funcionará en tu propio hardware, manteniendo la filosofía de código abierto y privacidad de Soup.
Conclusión
Soup es una herramienta revolucionaria para el fine-tuning de modelos de IA. Con su enfoque en la automatización, eficiencia en hardware y evaluación integrada, democratiza el acceso a tecnologías avanzadas de IA, permitiendo que desarrolladores y entusiastas puedan entrenar modelos grandes sin necesidad de hardware costoso o conocimientos técnicos profundos.
Si estás buscando una manera sencilla de adentrarte en el mundo del fine-tuning, Soup es una excelente opción. Su código abierto, su comunidad activa y su enfoque en la transparencia la convierten en una herramienta confiable y accesible para todos.
¿Listo para empezar? Instala Soup hoy mismo y comienza a entrenar tus propios modelos de IA con solo un comando.






Desactivar funciones de inteligencia artificial que trabajan directamente en el dispositivo puede liberar espacio real en el almacenamiento interno, pero conviene hacerlo con expectativas precisas.
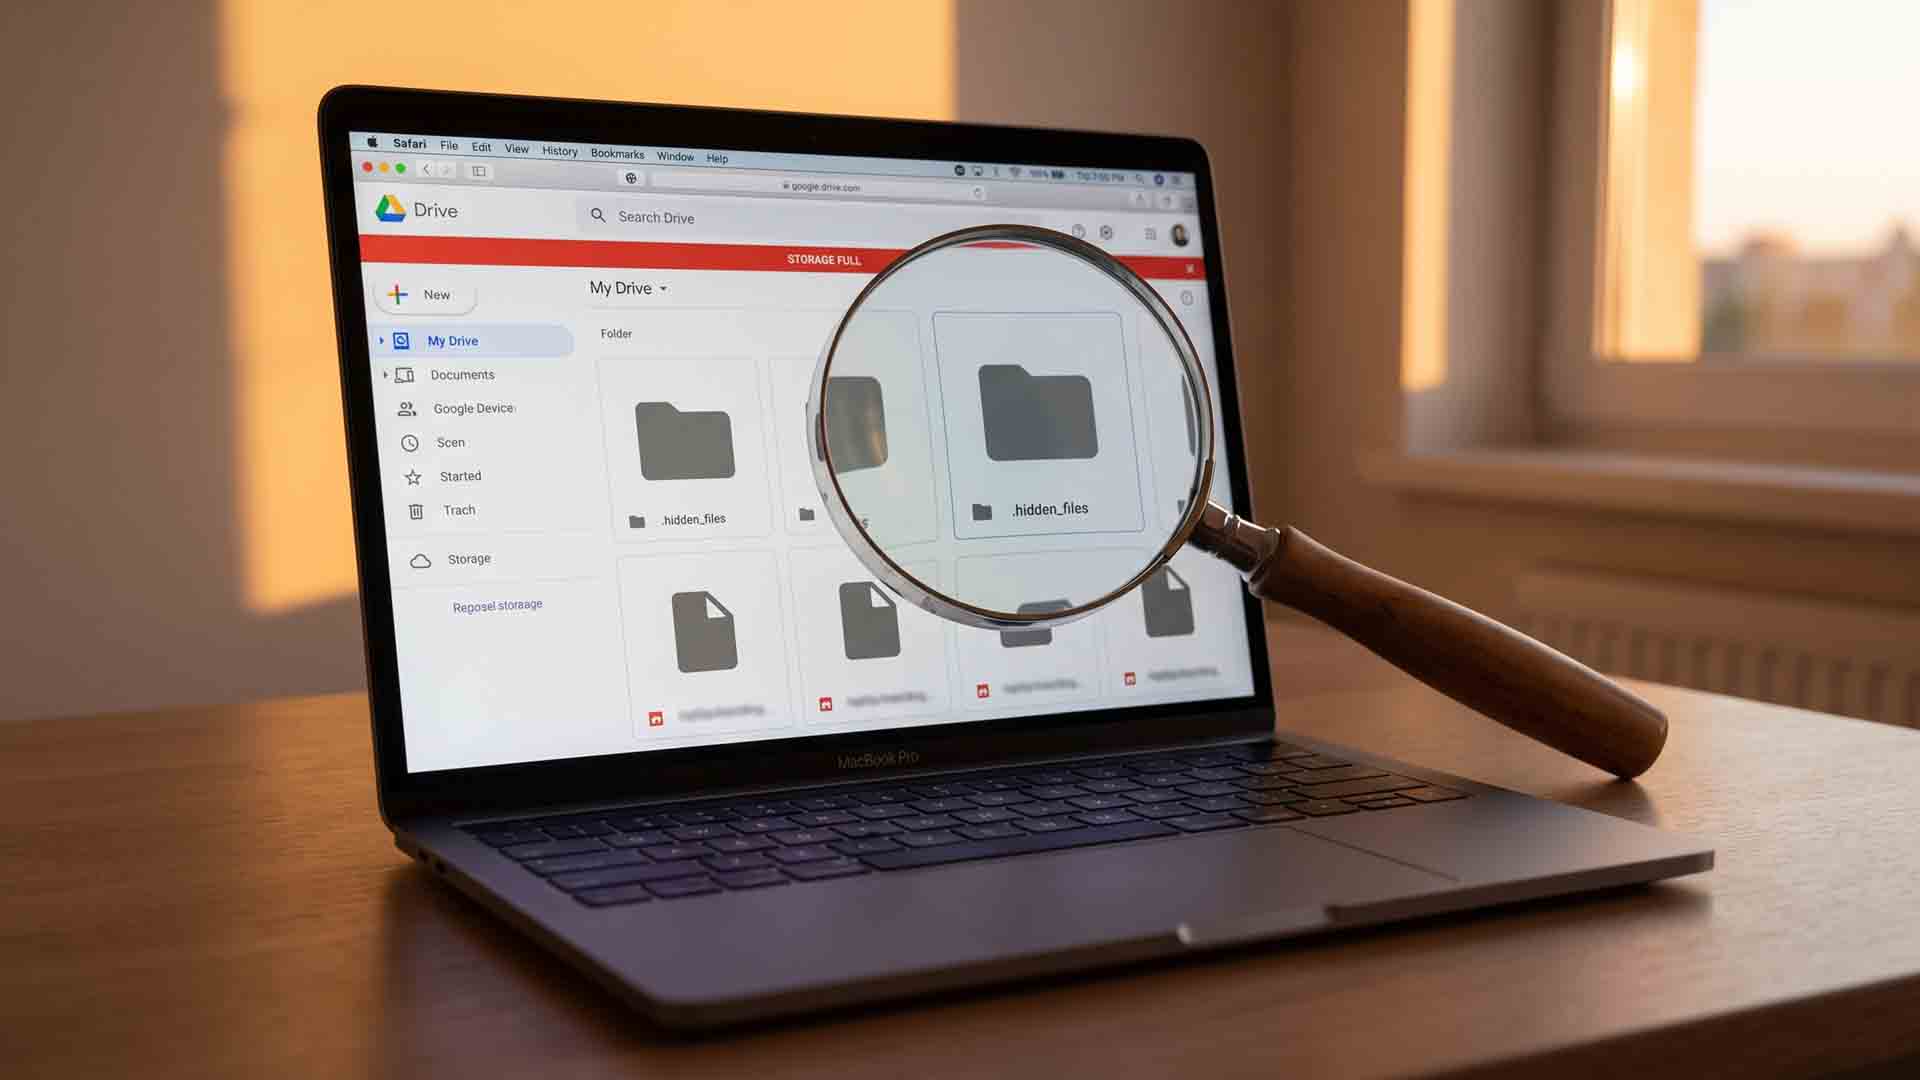
Google ofrece 15 GB gratuitos para Gmail, Drive y Photos, pero muchos usuarios cometen el error de eliminar fotos primero. El problema rara vez está en tu galería: los archivos más pesados suelen esconderse en áreas que el panel principal de almacenamiento ignora. La solución comienza en una página que Google no promociona: el Gestor de Almacenamiento de Google One, donde verás todo tu espacio usado en un solo lugar.

La organización de archivos de audio y video suele ser una tarea tediosa cuando las bibliotecas personales crecen sin control. Esta revisión analiza en profundidad SurSort Media Manager, un programa de escritorio para Windows y Mac desarrollado por Nabla Mind, enfocado en clasificar, etiquetar y proteger colecciones multimedia sin depender de servicios en la nube.
-

 Apps11 años ago
AMPcast, la herramienta de Pandora que permite a los artistas grabar mensajes de audio directamente a sus seguidores
-
 Blogs5 años ago
Conoce los mejores sitios de Torrents para descargar todo tipo de contenidos
-
Android5 años ago
Aprende cómo usar Discord para ver películas con tus amigos
-
Arte y Cultura14 años ago
Colección de fondos de pantalla basados en Super Héroes
-

 Almacenamiento2 años ago
Cómo usar TeraBox: La guía definitiva para aprovechar 1 TB de almacenamiento en la nube
-
Diseño13 años ago
css3ps: plugin que convierte archivos PSD a CSS3
-
Apps9 años ago
Picturethat, app que usa la Realidad Aumentada para visualizar cómo quedarían los cuadros antes de colgarlos
-
Eventos Especiales13 años ago
Especial Día de la Madres: fondos de pantalla especiales para Mamá