

Hardware
Cómo implementar el consejo de LLM de Andrej Karpathy en hardware local

El LLM Council es una idea publicada por Andrej Karpathy para consultar varios modelos, hacer que revisen de forma anónima las respuestas de los demás y sintetizar una respuesta final más sólida. El concepto es útil porque permite contrastar perspectivas, reducir errores aislados y mejorar la calidad final en tareas complejas.
¿Qué es el consejo de LLM y por qué resulta útil?
El consejo de LLM funciona como una mesa de deliberación entre varios modelos. En lugar de pedir una respuesta a un único modelo, se reparte la misma consulta entre varios sistemas, se comparan los resultados y luego uno de ellos sintetiza una versión final más útil.
En el flujo descrito por Karpathy, el proceso ocurre en tres etapas:
- Primera etapa: cada modelo responde de forma independiente a la misma pregunta.
- Segunda etapa: los modelos revisan y clasifican las respuestas de los demás de forma anónima.
- Tercera etapa: un modelo designado como presidente o sintetizador genera la respuesta final.
Este enfoque es útil por varias razones:
- Mayor control de calidad: una respuesta débil puede ser detectada por los demás modelos.
- Mejor equilibrio: cada modelo aporta fortalezas distintas, como razonamiento, redacción o síntesis.
- Más transparencia: puedes inspeccionar las respuestas intermedias si implementas tu propio flujo.
- Privacidad local: si toda la orquestación se ejecuta en Ollama sobre tu equipo, los datos no salen a servicios externos.
¿Qué debes tener claro antes de empezar?
Antes de montar tu entorno, conviene separar tres piezas que suelen confundirse:
- LLM Council: la idea y el repositorio experimental de Karpathy.
- Ollama: el motor local que descarga y ejecuta modelos en tu equipo.
- Open WebUI: una interfaz gráfica opcional para interactuar con modelos y APIs compatibles.
En otras palabras, Open WebUI no forma parte del repositorio oficial de LLM Council, y el repo oficial no usa Ollama por defecto. El proyecto original usa OpenRouter, una API distinta.
Requisitos mínimos para ejecutar una versión local
Los requisitos reales dependen del tamaño del modelo, de la cuantización y de si quieres correr uno o varios modelos cargados al mismo tiempo. Para una implementación práctica inspirada en el consejo de LLM, esta guía te servirá como referencia conservadora.
Hardware recomendado
- GPU:
- Mínimo funcional: 8 GB de VRAM para modelos pequeños y pruebas secuenciales.
- Recomendado: 12 GB de VRAM o más para trabajar con modelos de 7B a 9B con mayor comodidad.
- Más cómodo: 16 GB a 24 GB de VRAM si quieres experimentar con varios modelos grandes o mantener más contexto.
- CPU: 4 núcleos o más.
- RAM: 16 GB como base; 32 GB es preferible si vas a mover varios modelos y herramientas.
- Almacenamiento: SSD NVMe con al menos 50 GB libres, aunque 100 GB o más te darán margen real para varios modelos.
Software necesario
- Sistema operativo: Windows 10/11 o Linux.
- Controladores: drivers actualizados de NVIDIA o AMD según tu tarjeta.
- Ollama: backend local para descargar y ejecutar modelos. Su API local se sirve por defecto en
http://localhost:11434/api. - Open WebUI: opcional si quieres una interfaz web para conversar con tus modelos locales.
Instalación correcta de Ollama
Uno de los errores más comunes es usar comandos de Linux en Windows. La documentación oficial distingue ambos casos.
En Linux
curl -fsSL https://ollama.com/install.sh | shEn Windows
En Windows debes usar el instalador oficial o el método documentado por Ollama para Windows. No conviene presentar el script install.sh como si fuera un método nativo de Windows.
Verificación básica
Una vez instalado, Ollama suele quedar disponible en segundo plano en http://localhost:11434. Puedes comprobarlo así:
curl http://localhost:11434Y para listar modelos descargados mediante la API:
curl http://localhost:11434/api/tagsEl endpoint /api/tags está documentado oficialmente y devuelve los modelos instalados localmente.
Modelos adecuados para un consejo local
La clave no es solo descargar modelos grandes, sino combinar perfiles que se complementen. Como punto de partida, puedes pensar en tres roles:
- Razonamiento: un modelo bueno para análisis y pasos lógicos.
- Conocimiento general: un modelo equilibrado en cobertura y redacción.
- Síntesis: un modelo que estructure bien respuestas finales.
Ejemplos razonables dentro de la librería de Ollama:
- DeepSeek-R1 8B para razonamiento.
- Qwen 3.5 9B o variantes Qwen cercanas para conocimiento general y amplitud.
- Gemma 4 E4B para síntesis ligera, multimodalidad opcional y uso eficiente.
- Mistral 7B como opción rápida y equilibrada para tareas generales.
Si tu equipo tiene 8 GB a 12 GB de VRAM, lo más sensato es usar modelos pequeños o medianos y ejecutar las etapas de forma secuencial. Si dispones de más memoria, puedes experimentar con modelos más pesados o mantener varios cargados.
Descarga de modelos con Ollama
Después de instalar Ollama, puedes bajar los modelos que formarán tu consejo. Ejemplos:
ollama pull deepseek-r1:8b
ollama pull gemma4:e4b
ollama pull mistral
También puedes explorar los modelos disponibles en el catálogo oficial.
¿Cómo montar una versión local inspirada en LLM Council?
La forma más precisa de explicarlo es esta: vas a replicar la metodología del LLM Council sobre Ollama. Eso es más exacto que afirmar que el repositorio oficial de Karpathy ya funciona localmente solo con cambiar un endpoint.
Paso 1. define los miembros del consejo
Selecciona entre 3 y 4 modelos. Un ejemplo simple:
- Miembro 1:
deepseek-r1:8b - Miembro 2:
mistral - Presidente:
gemma4:e4b
No necesitas usar esos nombres exactamente, pero sí mantener una división clara entre modelos que generan propuestas y un modelo que sintetiza.
Paso 2. diseña el flujo en tres etapas
Tu orquestador debe seguir este patrón:
- Enviar el mismo prompt a todos los modelos por separado.
- Anonimizar las respuestas como Respuesta A, Respuesta B, Respuesta C.
- Pedir a cada modelo que evalúe las demás respuestas con criterios definidos.
- Entregar respuestas y evaluaciones al modelo presidente para producir una síntesis final.
Ese flujo coincide con la lógica conceptual del proyecto original.
Paso 3. usa la API correcta de Ollama
Para una implementación práctica, lo más útil es llamar a /api/chat o /api/generate, no solo almacenar una base URL genérica. Ejemplo con /api/chat:
curl http://localhost:11434/api/chat -d '{
  "model": "mistral",
  "messages": [
    {
      "role": "user",
      "content": "Explica cómo funciona el fine-tuning de un modelo de lenguaje."
    }
  ],
  "stream": false
}'
Paso 4. implementa un archivo de configuración simple
Como punto de partida, puedes definir algo como esto para tu propia adaptación:
{
  "models": [
    {"name": "deepseek-r1:8b", "role": "member"},
    {"name": "mistral", "role": "member"},
    {"name": "gemma4:e4b", "role": "chairman"}
  ],
  "ollama_base_url": "http://localhost:11434/api"
}
Este ejemplo no pertenece al repositorio oficial de Karpathy, pero sí es una base válida para una implementación local propia.
Paso 5. ejecuta en secuencial si tu VRAM es limitada
El repo original hace consultas paralelas a modelos remotos. En local, eso puede no ser viable si tu GPU no soporta mantener varios modelos cargados al mismo tiempo. En ese caso, ejecuta cada etapa de uno en uno para evitar errores de memoria.
Open WebUI como capa opcional
Si quieres una interfaz gráfica amigable para tus modelos locales, Open WebUI puede ayudarte, pero debes presentarlo como un componente opcional.
Open WebUI soporta Ollama y APIs compatibles, y su forma de despliegue más directa suele ser Docker.
Ejemplo rápido con Docker:
docker run -d -p 3000:8080 --add-host=host.docker.internal:host-gateway -v open-webui:/app/backend/data --name open-webui --restart always ghcr.io/open-webui/open-webui:mainSi prefieres instalación por Python, la propia documentación recomienda prestar atención a la versión de Python para evitar incompatibilidades.
¿Cómo obtener mejores resultados?
Usa prompts claros
En un consejo local, la calidad de la deliberación depende mucho del prompt base. Conviene evitar preguntas vagas y definir exactamente la tarea, el nivel de profundidad y el formato esperado.
Ejemplo de prompt útil:
Compara Cloudflare Tunnel y Pangolin en seguridad, facilidad de despliegue y mantenimiento.
Responde en formato de tabla y cierra con una recomendación para un homelab pequeño.
Define criterios de evaluación en la segunda etapa
Para que la revisión cruzada sea útil, da a los modelos criterios concretos, por ejemplo:
- Precisión factual
- Claridad
- Profundidad
- Utilidad práctica
También puedes pedir una clasificación final con un formato fijo para que tu orquestador pueda procesarla mejor.
Controla la longitud
Si alguno de los modelos tiende a extenderse demasiado, usa instrucciones de concisión y limita la salida con parámetros del endpoint de Ollama cuando corresponda. La documentación oficial permite ajustar opciones del modelo en la petición.
Problemas comunes y soluciones reales
Falta de VRAM
Problema: no puedes cargar varios modelos a la vez.
Soluciones:
- Usa modelos más pequeños.
- Ejecuta cada fase de forma secuencial.
- Descarga variantes cuantizadas cuando existan.
Ollama no responde
Problema: el orquestador no puede conectarse al backend local.
Soluciones:
- Confirma que Ollama está corriendo.
- Comprueba que el puerto sea
11434. - Prueba primero con
curl http://localhost:11434. - Revisa firewall o antivirus si el acceso local falla.
Confusión entre base URL y endpoint de inferencia
Problema: se define http://localhost:11434/api pero luego no se llama a /chat o /generate.
Solución: usa la base URL solo como raíz y realiza llamadas concretas a los endpoints de inferencia documentados.
¿Open WebUI no se conecta a Ollama?
Problema: la interfaz carga, pero no ve los modelos.
Soluciones:
- Verifica la URL configurada de Ollama.
- Si usas Docker, revisa el mapeo correcto hacia el host.
- Consulta la guía oficial de troubleshooting de Open WebUI.
Ejemplo práctico de flujo del consejo
Supongamos que envías esta consulta a tres modelos locales:
Explica las diferencias entre RAG y fine-tuning para una empresa pequeña.
Incluye cuándo conviene usar cada enfoque, costos aproximados y riesgos.
Tu implementación podría hacer esto:
- DeepSeek-R1 desarrolla el razonamiento y enumera escenarios.
- Mistral responde con un resumen técnico más directo.
- Gemma 4 E4B recibe ambas respuestas, más las evaluaciones cruzadas, y produce una síntesis final ordenada.
Ese patrón ya te da una versión práctica del consejo, incluso sin usar directamente el código del proyecto original.
Ventajas y desventajas de llevar esta metodología a local
Ventajas
- Privacidad: los datos pueden quedarse en tu propia máquina.
- Control: eliges modelos, parámetros y flujo.
- Experimentación: puedes modificar la lógica del consejo sin depender de un servicio externo.
- Ahorro recurrente: una vez descargados los modelos, no pagas por token en un proveedor externo.
Desventajas
- Mayor complejidad técnica: debes montar tu propia orquestación.
- Más consumo de recursos: varios modelos locales exigen VRAM, RAM y disco.
- Rendimiento variable: en local suele ser más lento que usar varios modelos de gama alta en la nube.
- El repo original no es plug and play para esto: requiere adaptación si quieres usarlo como base.
Conclusión
Sí, vale la pena implementar una versión local del consejo de LLM si buscas mejores respuestas en tareas complejas, control del proceso y privacidad. Pero es importante presentarlo con precisión: no se trata de instalar directamente el repositorio oficial de Andrej Karpathy sobre Ollama sin cambios, sino de replicar su metodología con un backend local como Ollama y, si lo deseas, una interfaz opcional como Open WebUI.
La recomendación más sólida para la mayoría de usuarios es empezar pequeño: dos o tres modelos, ejecución secuencial, prompts claros y una etapa final de síntesis bien definida. Una vez que el flujo funcione, ya podrás refinar criterios, evaluación cruzada y formatos de salida.





El proyecto open source dsv41-flash-offload logra servir DeepSeek V4.1 Flash, un modelo de unos 200GB en expertos, desde una única RTX 3090 de 24GB apoyada en RAM DDR4 y NVMe, con API compatible con OpenAI y contexto de 262,144 tokens.
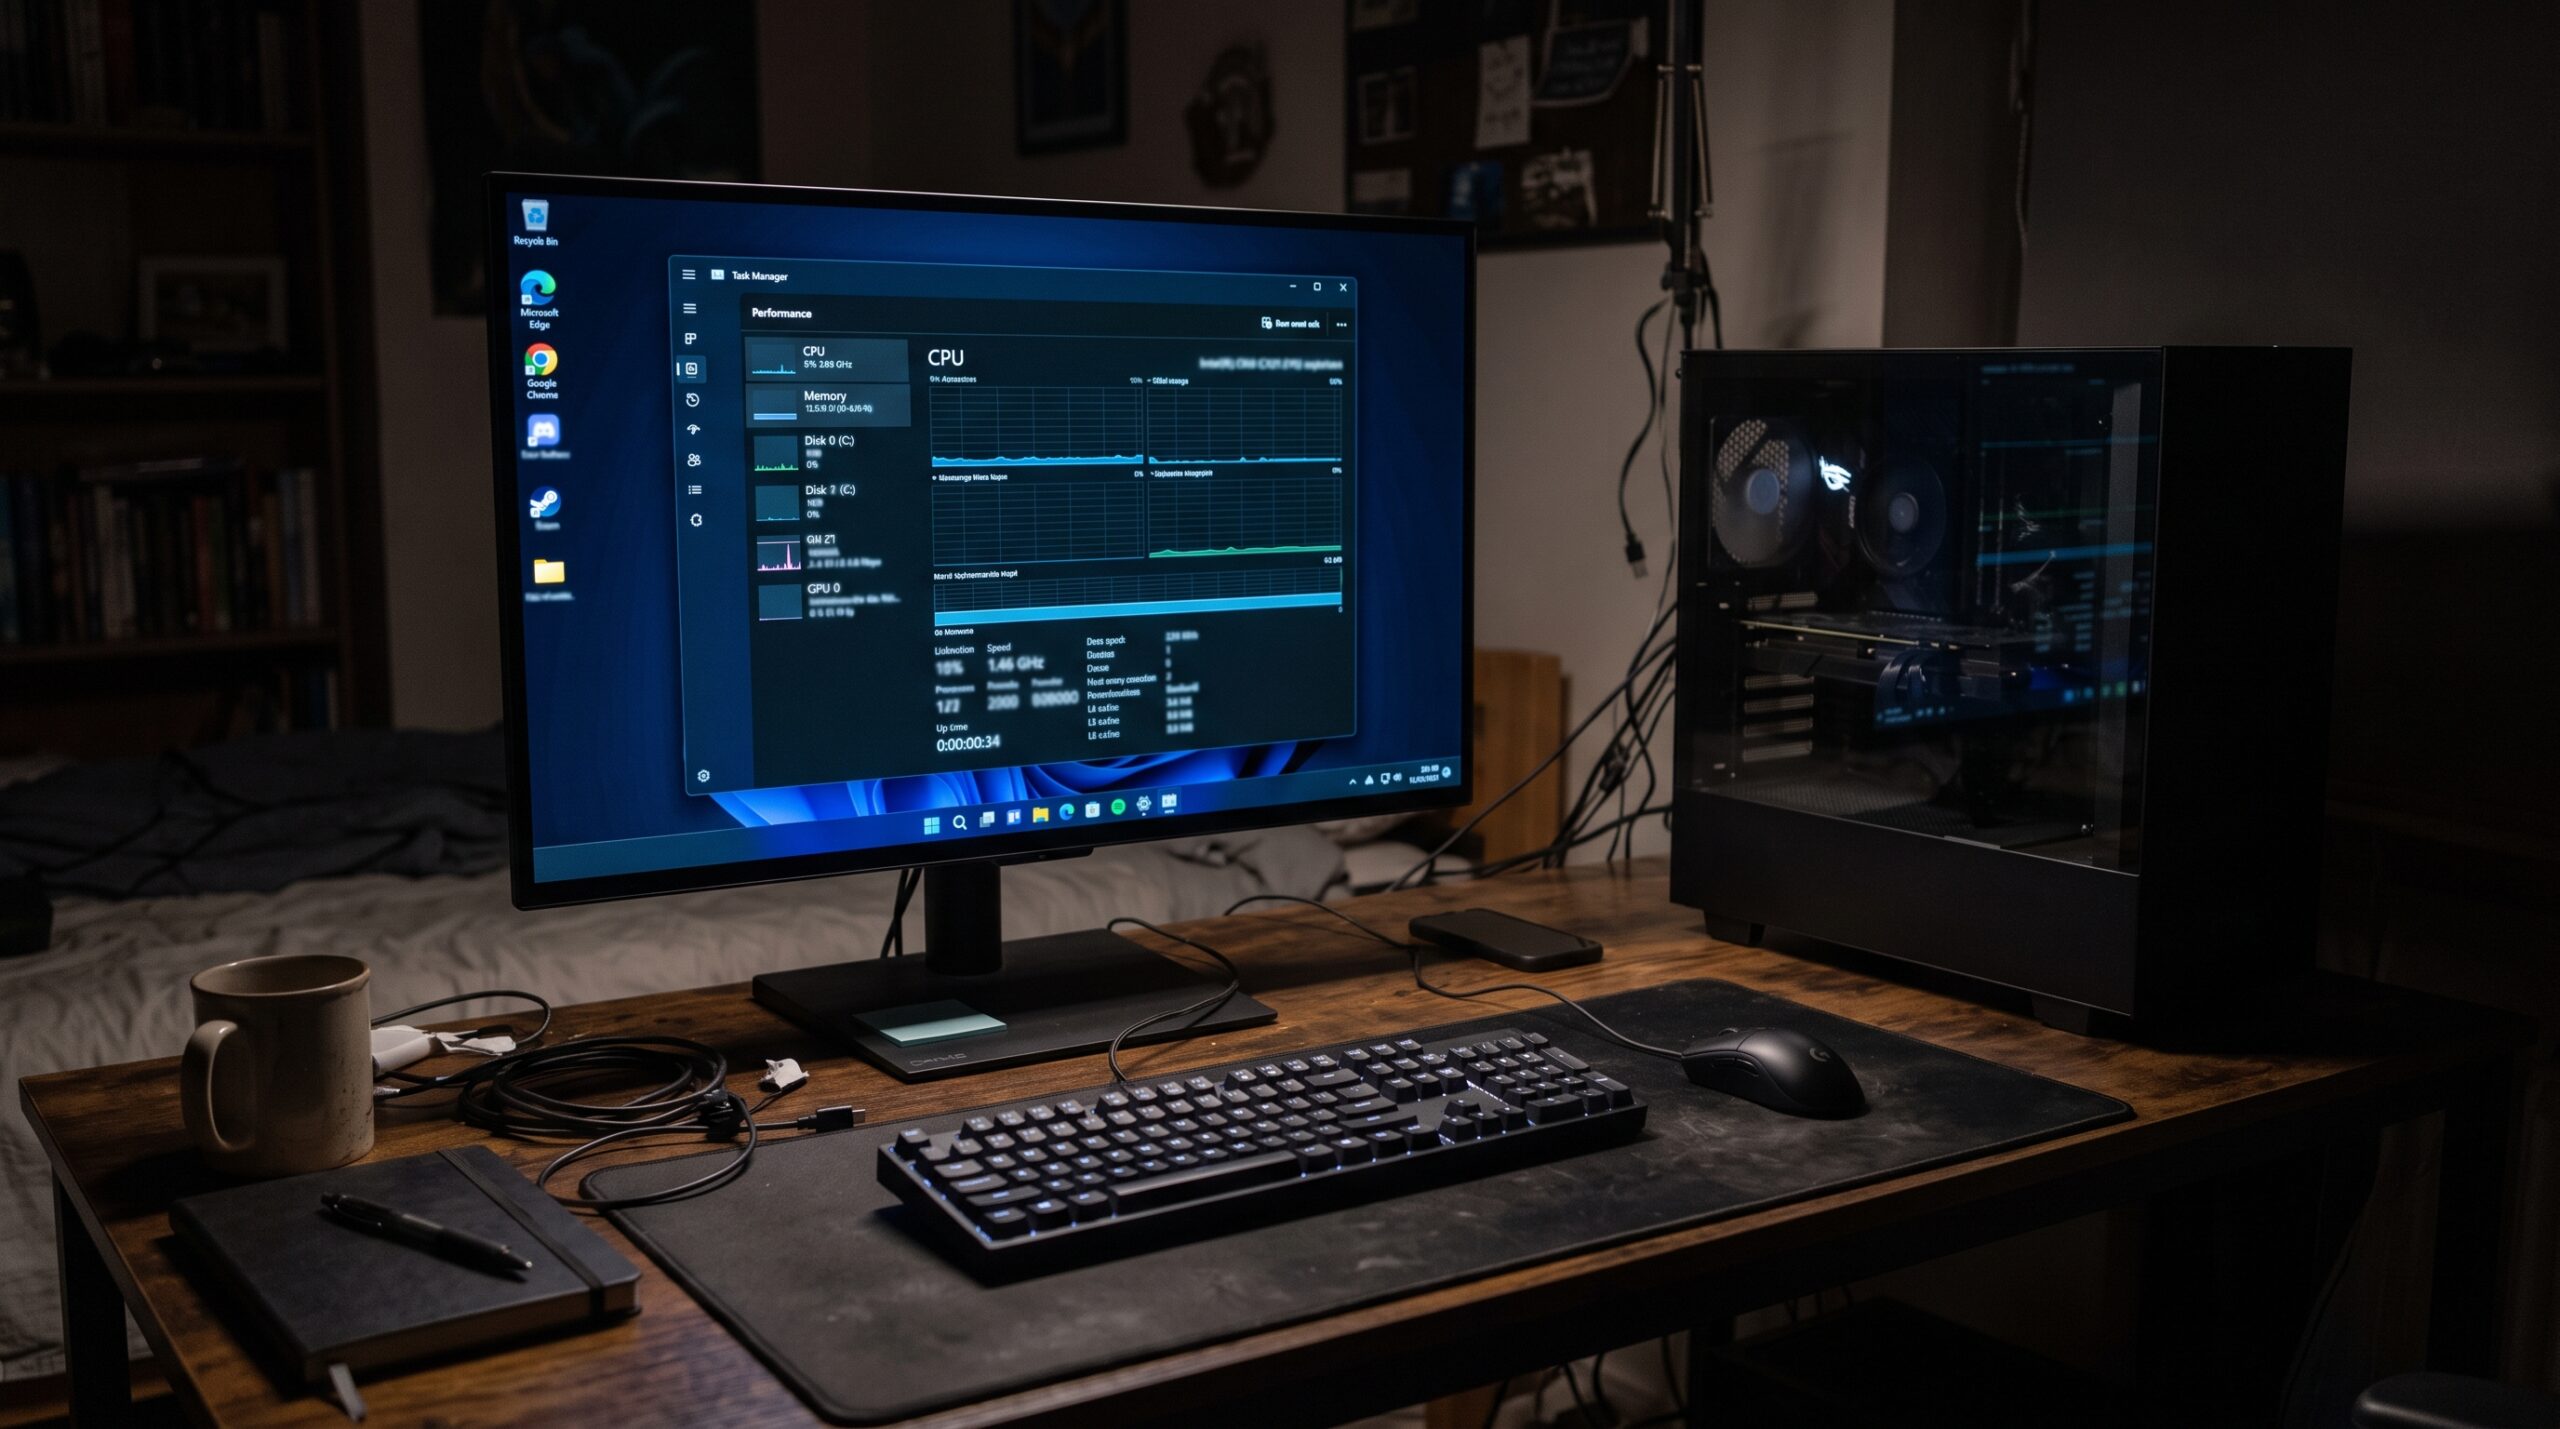
El usuario @soyaakinohara6 compartió en X una instalación de Windows 11 que consume apenas 2.5GB de 16GB de RAM en reposo, un 16 por ciento de utilización. El método: instalar con Rufus, eliminar todo el bloatware y luego aplicar la actualización 26H2.
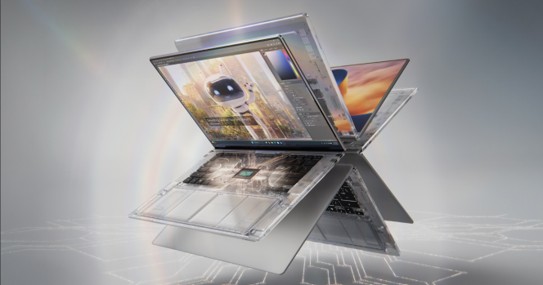
En el evento Windows AI and Surface celebrado en San Francisco, Jensen Huang y Satya Nadella presentaron RTX Spark, la plataforma de NVIDIA que lleva hasta un petaflop de cómputo de IA y 128 GB de memoria unificada a laptops y equipos de escritorio con Windows, pensada para ejecutar agentes de IA de forma local y segura.
-

 Apps11 años ago
AMPcast, la herramienta de Pandora que permite a los artistas grabar mensajes de audio directamente a sus seguidores
-
 Blogs5 años ago
Conoce los mejores sitios de Torrents para descargar todo tipo de contenidos
-
Android5 años ago
Aprende cómo usar Discord para ver películas con tus amigos
-
Arte y Cultura14 años ago
Colección de fondos de pantalla basados en Super Héroes
-

 Almacenamiento2 años ago
Cómo usar TeraBox: La guía definitiva para aprovechar 1 TB de almacenamiento en la nube
-
Diseño13 años ago
css3ps: plugin que convierte archivos PSD a CSS3
-
Apps9 años ago
Picturethat, app que usa la Realidad Aumentada para visualizar cómo quedarían los cuadros antes de colgarlos
-
Eventos Especiales13 años ago
Especial Día de la Madres: fondos de pantalla especiales para Mamá