
Actualización
Gemma 4, AITune y OpenClaw: guía práctica del stack de IA local 2026

Tres herramientas de código abierto ahora permiten correr inteligencia artificial de nivel profesional en tu propia computadora, sin costo mensual y sin enviar datos a terceros.
En abril de 2026, tres proyectos convergieron de forma que pocas personas han notado: Google Gemma 4, Nvidia AITune y OpenClaw. Juntos forman un sistema de inteligencia artificial local que cualquier persona puede instalar hoy, sin pagar suscripciones, sin enviar documentos a servidores externos y sin depender de que una empresa cambie sus condiciones en cualquier momento. Esta guía explica qué hace cada componente, qué equipo necesitas y cómo empezar desde cero.
¿Qué es la inteligencia artificial local y por qué importa ahora?
La mayoría de herramientas de inteligencia artificial que se usan hoy funcionan en la nube: el texto que escribes viaja a servidores de una empresa, se procesa allá y regresa como respuesta. Eso implica costos mensuales de entre 20 y 200 dólares dependiendo del servicio, y una dependencia total de que ese proveedor mantenga sus precios, su política de privacidad y su acceso sin interrupciones. La inteligencia artificial local invierte ese modelo: el procesamiento ocurre en tu propia computadora, los datos nunca salen de tu equipo y no existe factura mensual por uso.
Hasta hace poco, ejecutar modelos capaces de forma local requería conocimientos técnicos avanzados, hardware muy costoso o ambos. Lo que cambió en 2026 es que tres piezas clave del sistema ahora están disponibles de forma gratuita, son de código abierto y funcionan juntas con una configuración mínima. Vale la pena detenerse en cada una.
Gemma 4: el modelo que procesa texto, imágenes y documentos
Gemma 4 es la familia de modelos de código abierto publicada por Google DeepMind el 2 de abril de 2026 bajo licencia Apache 2.0. Incluye cuatro variantes diseñadas para distintos niveles de hardware, y todas ellas pueden procesar texto e imágenes desde el dispositivo local. El modelo de 26 mil millones de parámetros utiliza una arquitectura llamada MoE (mezcla de expertos), que activa solo una fracción de sus parámetros en cada respuesta, lo que permite correrlo en equipos con memoria limitada sin sacrificar demasiada capacidad.
Resulta particularmente relevante que los modelos más pequeños, E2B y E4B, fueron diseñados en colaboración con Qualcomm y MediaTek para correr en dispositivos móviles y computadoras portátiles sin necesidad de conexión a internet. Eso los hace útiles no solo para desarrolladores con estaciones de trabajo potentes, sino para cualquier persona que necesite procesar información sensible sin depender de una red.
¿Qué variante de Gemma 4 necesitas según tu equipo?
Esta es la decisión más importante antes de instalar. La tabla siguiente usa datos técnicos verificados de la documentación oficial y pruebas publicadas por la comunidad:
| Modelo | RAM mínima | RAM recomendada | Perfil de usuario |
|---|---|---|---|
| gemma4:e2b | 4 GB | 6 GB | Computadora portátil básica, uso sin conexión ligero |
| gemma4:e4b | 6 GB | 8 GB | Computadora portátil de gama media, Mac con chip M1 o posterior |
| gemma4:26b | 8 GB | 16–18 GB | Computadora de escritorio, estación de trabajo |
| gemma4:31b | 20 GB | 24–32 GB | Uso profesional intensivo, tarjeta gráfica dedicada de alta capacidad |
Si tienes dudas, empieza con gemma4:e4b. Corre en la mayoría de equipos comprados después de 2020 y ofrece capacidad multimodal completa.
Nvidia AITune: rendimiento automático sin configuración manual
AITune es una herramienta de código abierto publicada por Nvidia bajo licencia Apache 2.0 y disponible a través de PyPI. Su función es directa: en lugar de que el usuario evalúe manualmente qué configuración de aceleración funciona mejor en su tarjeta gráfica, AITune lo hace de forma automática. Evalúa cuatro motores de procesamiento compatibles —TensorRT, Torch-TensorRT, TorchAO y Torch Inductor— contra el modelo y el hardware específico del usuario, y guarda el resultado como un archivo listo para producción.
Lo cierto es que esto resuelve uno de los mayores obstáculos del despliegue local: la incertidumbre sobre qué configuración extraer el mejor rendimiento de una tarjeta gráfica particular. AITune ofrece dos modos de operación. El modo ahead-of-time compila el modelo una vez y lo despliega sin tiempo de calentamiento en cada uso posterior. El modo just-in-time optimiza al momento sin necesidad de modificar el código existente.
Es importante señalar que AITune tiene requisitos de sistema específicos: funciona en Linux con Ubuntu 22.04 o superior, requiere Python 3.10 o posterior y PyTorch 2.7 o posterior, además de una tarjeta gráfica Nvidia. No es compatible con Windows de forma nativa ni con tarjetas gráficas de otros fabricantes en este momento.
OpenClaw: el sistema que conecta y coordina todo
OpenClaw es un sistema de agentes de inteligencia artificial de código abierto que, en la última semana de marzo de 2026, agregó soporte nativo para Gemma 4 a través de Ollama, visión local y modo de conversación por voz completamente sin conexión. Su función dentro del sistema es la de coordinador: toma el modelo de lenguaje instalado localmente y lo convierte en un agente capaz de recordar conversaciones anteriores, programar tareas, usar herramientas externas y responder preguntas sobre documentos cargados por el usuario.
La combinación con Gemma 4 es especialmente útil porque elimina la necesidad de una clave de acceso a servicios externos. OpenClaw puede apuntar directamente a una instancia de Ollama corriendo en la misma máquina, de modo que ningún dato abandona el equipo en ningún momento del proceso.
¿Cómo instalar el sistema completo paso a paso?
Los pasos siguientes asumen una computadora con sistema operativo Windows 10 u 11, macOS 12 o posterior, o Ubuntu 22.04 o posterior. Para los pasos de AITune se requiere Linux y tarjeta gráfica Nvidia.
Paso 1: instalar Ollama
Ollama es la capa que gestiona la descarga y ejecución local de Gemma 4. Descarga el instalador para tu sistema operativo desde ollama.com/download. En Windows y Mac es un instalador visual sin configuración adicional. En Linux, ejecuta en la terminal:
curl -fsSL https://ollama.com/install.sh | sh
Paso 2: descargar Gemma 4
Con Ollama instalado, abre una terminal o símbolo del sistema y ejecuta el comando correspondiente a tu variante elegida según la tabla anterior. Por ejemplo, para el modelo de 4 mil millones de parámetros:
ollama run gemma4:e4b
Ollama descarga el modelo automáticamente y abre una sesión de conversación directa en la terminal. Para salir escribe /bye. El modelo queda guardado en tu equipo y puede usarse sin conexión a partir de ese momento.
Paso 3: instalar OpenClaw
OpenClaw requiere Node.js versión 22 o posterior instalado previamente. Descárgalo desde nodejs.org si aún no lo tienes. Luego ejecuta en terminal:
curl -fsSL https://openclaw.ai/install.sh | bash
Una vez instalado, ejecuta la configuración inicial con:
openclaw onboard –install-daemon
Este comando configura el acceso al proveedor de modelo, levanta el servicio local en el puerto 18789, instala el proceso en segundo plano y verifica que todo funcione. Durante la configuración, elige Ollama como proveedor para mantener el sistema completamente local. Finalmente, abre el panel de control con:
openclaw dashboard
¿Por qué no responde Ollama después de instalarlo?
El error más frecuente en la instalación es que el comando ollama no se reconoce en la terminal aunque la instalación haya finalizado correctamente. Esto ocurre porque el directorio de binarios de Ollama no fue agregado automáticamente a la variable de entorno PATH del sistema. En Linux o Mac, cierra y vuelve a abrir la terminal. Si el problema persiste, agrega manualmente la ruta con:
export PATH=$PATH:/usr/local/bin
En Windows, reinicia el sistema después de la instalación para que los cambios de PATH surtan efecto.
¿A quién le sirve este sistema en la práctica?
La utilidad del sistema no se limita a desarrolladores o personas con conocimientos técnicos avanzados. Estos son perfiles concretos donde el sistema aporta valor inmediato:
- Trabajadores independientes y emprendedores: pueden analizar contratos, presupuestos y documentos en formato PDF sin enviarlos a ningún servidor externo, algo crítico cuando se trabaja con información confidencial de clientes.
- Creadores de contenido: generan textos, descripciones y borradores directamente desde su equipo, sin límites de uso ni costos por volumen.
- Profesionales de salud, legal o finanzas: procesan información sensible de pacientes o clientes sin comprometer regulaciones de privacidad de datos vigentes en México y América Latina.
- Estudiantes e investigadores: pueden cargar documentos académicos extensos y hacerles preguntas directas, con contextos de hasta 256,000 unidades de texto en los modelos medianos.
- Usuarios en zonas con conectividad limitada: una vez descargado el modelo, el sistema funciona completamente sin conexión a internet.
Comparativa de costos: nube contra sistema local
El argumento económico es simple pero vale la pena precisarlo. La siguiente comparativa está basada en precios públicos de servicios vigentes al momento de publicación de este artículo:
| Escenario | Sistema en la nube | Sistema local |
|---|---|---|
| Suscripción mensual | 20–200 USD según servicio | 0 USD (hardware propio) |
| Privacidad de datos | Depende de la política del proveedor | Total, sin salida de datos |
| Disponibilidad sin internet | No | Sí, después de la descarga inicial |
| Riesgo de cambios en el servicio | Dependiente del proveedor | Ninguno |
| Capacidad multimodal | Disponible en planes premium | Incluida en Gemma 4 E4B sin costo |
El único costo real del sistema local es el tiempo de configuración inicial, que con esta guía debería tomar menos de 30 minutos en un equipo compatible.
¿Qué limitaciones tiene el sistema local?
Sería incompleto presentar este sistema sin señalar sus restricciones actuales. AITune solo funciona en Linux con tarjeta gráfica Nvidia, lo que excluye a usuarios de Windows y Mac que quieran aprovechar esa capa de optimización. Los modelos más capaces de Gemma 4 requieren equipos con cantidades de memoria que no todos poseen. OpenClaw tiene una curva de configuración inicial que puede resultar compleja para usuarios sin experiencia en herramientas de terminal. Ninguno de estos problemas es permanente: el ecosistema de inteligencia artificial local evoluciona con rapidez, pero conviene conocerlos antes de empezar.
En cualquier caso, incluso sin AITune y usando solo Gemma 4 con Ollama, cualquier persona con una computadora de gama media fabricada después de 2019 puede hoy acceder a un asistente de inteligencia artificial multimodal, gratuito, privado y funcional sin conexión. Eso, hace 18 meses, no era posible.





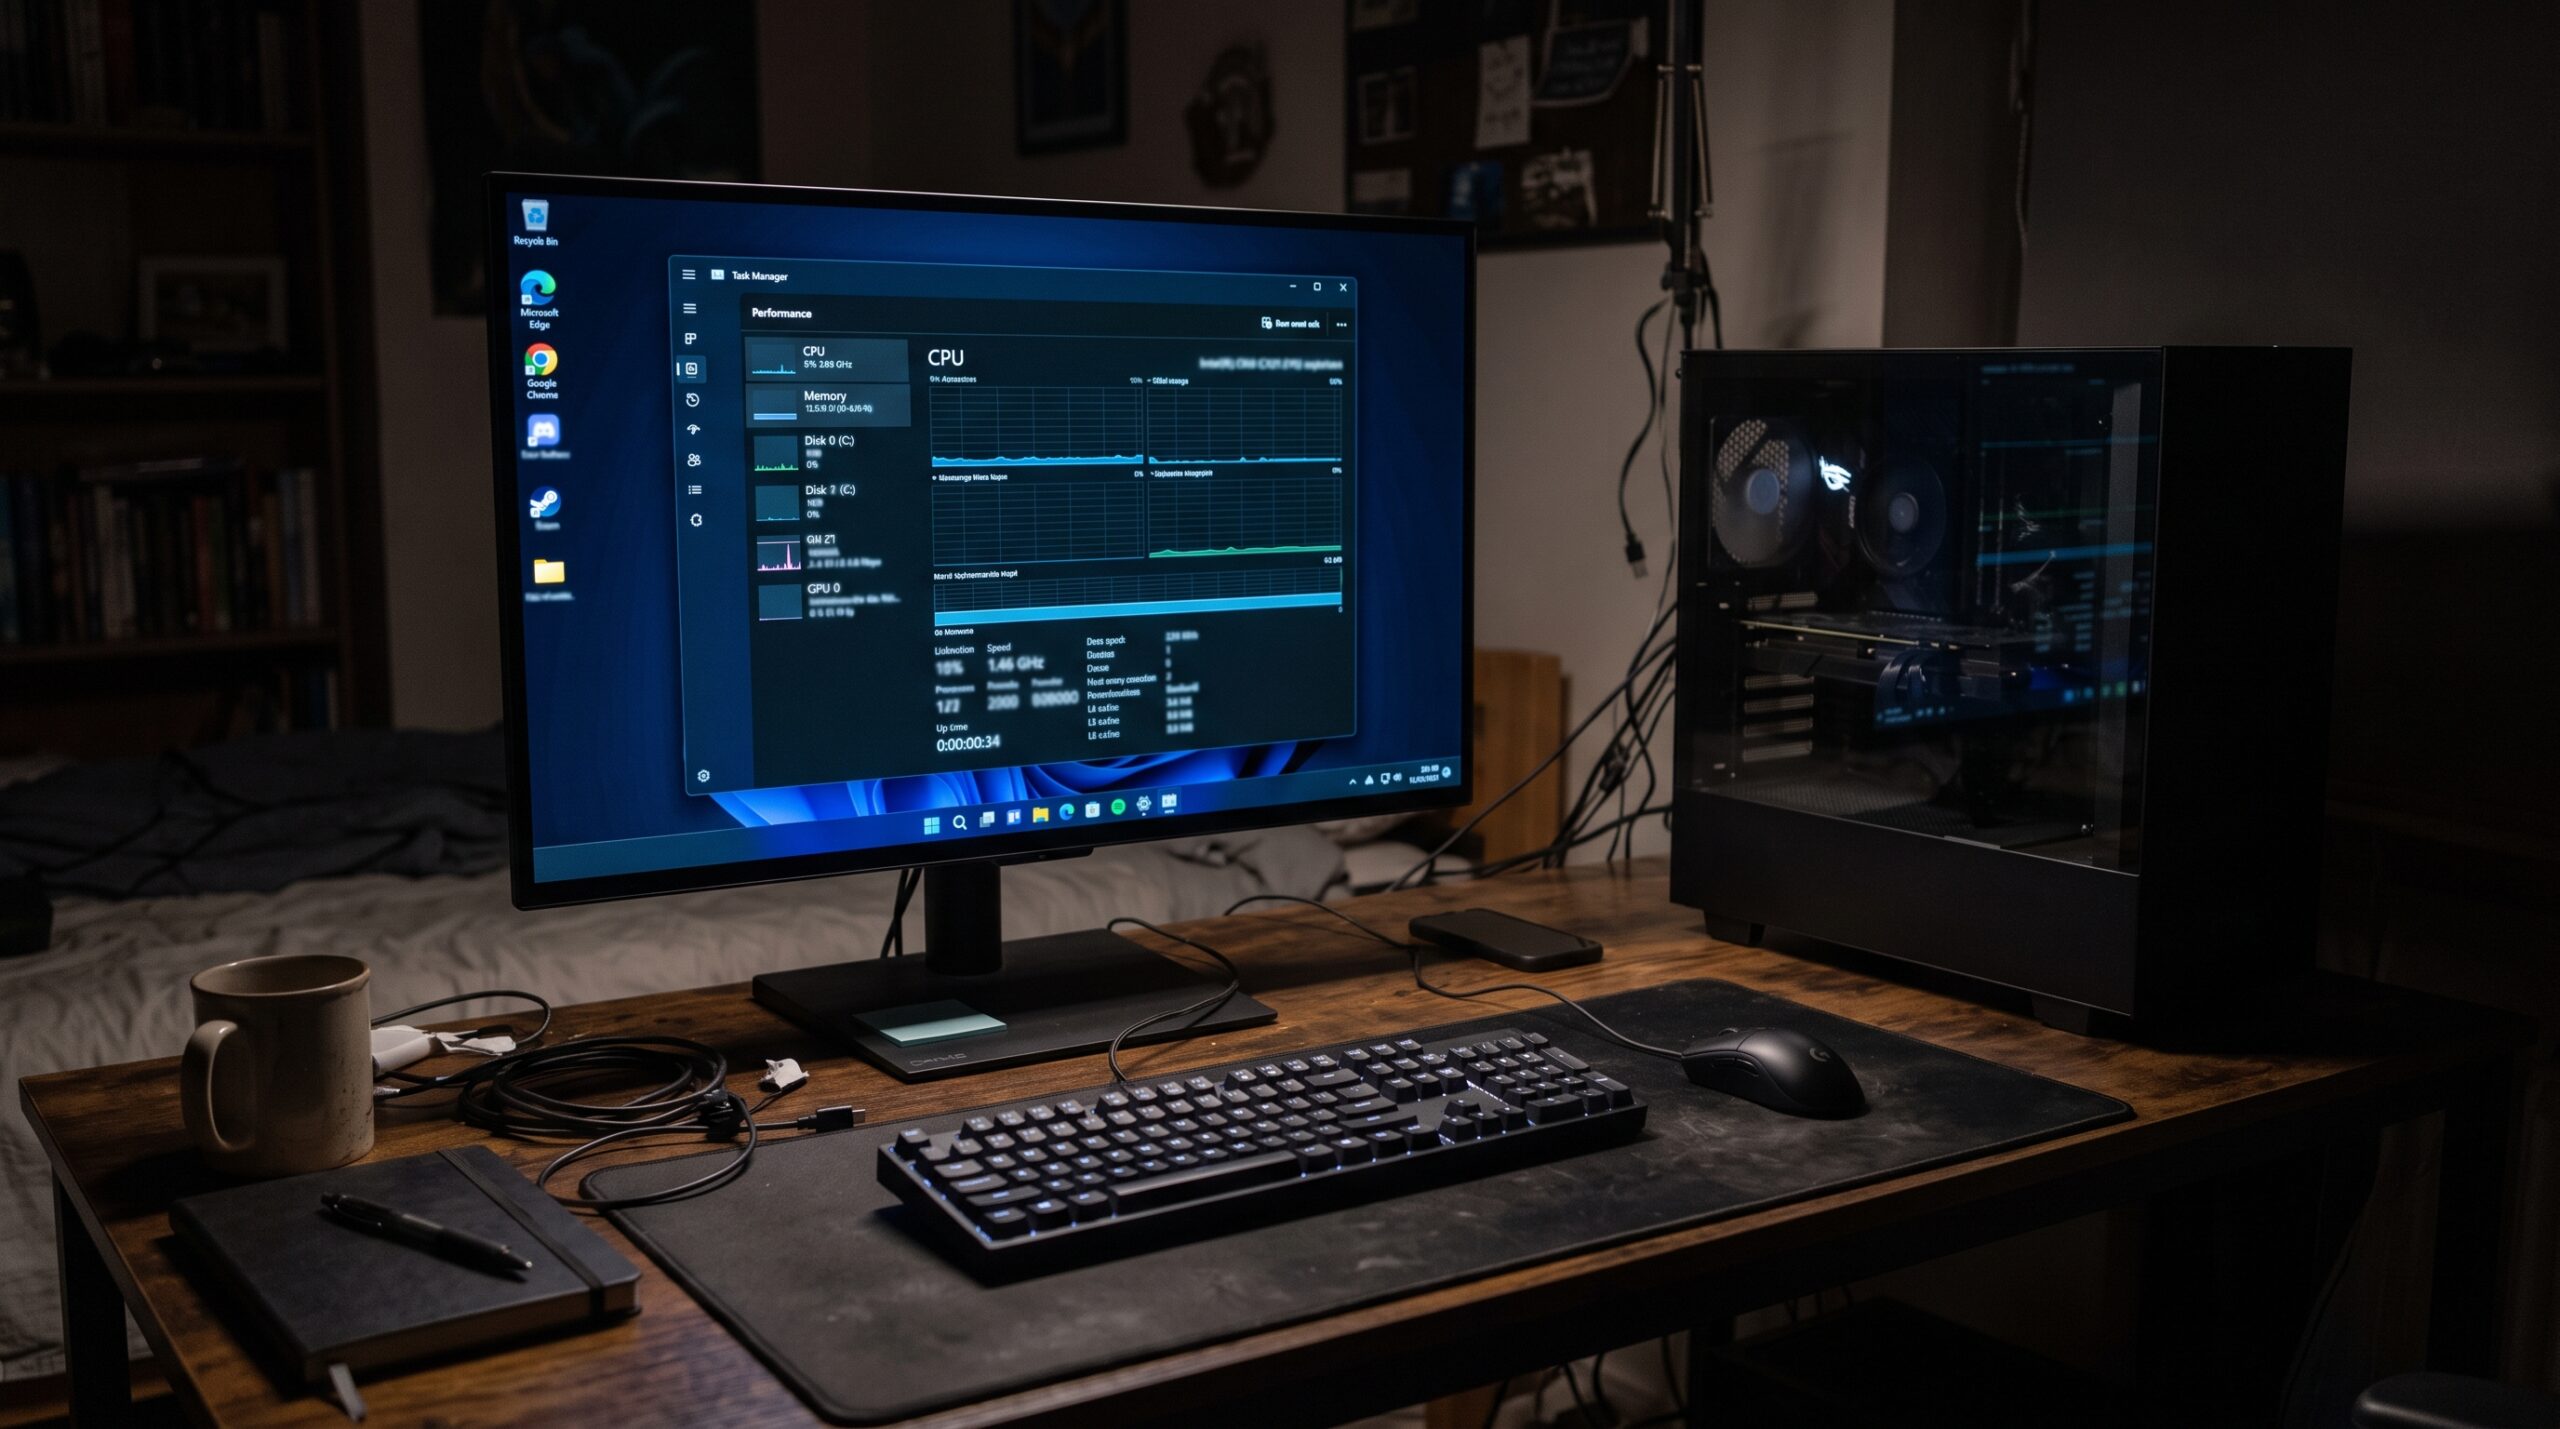
El usuario @soyaakinohara6 compartió en X una instalación de Windows 11 que consume apenas 2.5GB de 16GB de RAM en reposo, un 16 por ciento de utilización. El método: instalar con Rufus, eliminar todo el bloatware y luego aplicar la actualización 26H2.
Tu PC puede tener hardware de sobra y aun así sentirse lenta: tirones en los juegos, chasquidos en el audio, un ratón que se atasca. La causa suele ser un controlador que retiene el procesador más de la cuenta. LatencyMon, una herramienta gratuita para Windows, te dice exactamente cuál es el culpable. Te explicamos cómo usarla.
Windows 11 26H2 ya está disponible de forma general. Si tu PC ya ejecuta 24H2 o 25H2, no necesitas descargar gigabytes: el paquete de habilitación KB5121794 enciende las funciones dormidas con un solo reinicio. Te explicamos los requisitos, los enlaces oficiales de descarga y los pasos para instalarlo.
-

 Apps11 años ago
AMPcast, la herramienta de Pandora que permite a los artistas grabar mensajes de audio directamente a sus seguidores
-
 Blogs5 años ago
Conoce los mejores sitios de Torrents para descargar todo tipo de contenidos
-
Android5 años ago
Aprende cómo usar Discord para ver películas con tus amigos
-
Arte y Cultura14 años ago
Colección de fondos de pantalla basados en Super Héroes
-

 Almacenamiento2 años ago
Cómo usar TeraBox: La guía definitiva para aprovechar 1 TB de almacenamiento en la nube
-
Diseño13 años ago
css3ps: plugin que convierte archivos PSD a CSS3
-
Apps9 años ago
Picturethat, app que usa la Realidad Aumentada para visualizar cómo quedarían los cuadros antes de colgarlos
-
Eventos Especiales13 años ago
Especial Día de la Madres: fondos de pantalla especiales para Mamá