

Digitalización
Guía definitiva de Ollama con MiniMax-M2.7: OpenClaw VS Code y automatización paso a paso

Todo el ecosistema Ollama + MiniMax-M2.7 en una sola guía: instalación, OpenClaw, VS Code, automatización headless, costos y solución de errores.
Ollama terminó de consolidar en 2026 un ecosistema de desarrollo asistido por inteligencia artificial que opera tanto en local como en la nube, y su actualización más reciente lo lleva a otro nivel. El modelo MiniMax-M2.7 ya está disponible vía cloud de Ollama, OpenClaw incorpora investigación autónoma y agentes no interactivos, y Visual Studio Code se integra nativamente con Ollama a través de GitHub Copilot. Esta guía no deja nada afuera: cubre la instalación desde cero en Windows, macOS y Linux; la integración avanzada para quienes ya tienen el entorno funcionando; el diagnóstico de los errores más frecuentes con su solución exacta; y un análisis honesto de costos y límites para que ningún proyecto se detenga por sorpresas.
¿Qué es MiniMax-M2.7 y qué lo distingue de otros modelos?
MiniMax-M2.7 es el primer modelo de la familia M2 que participó activamente en su propia evolución: parte de su entrenamiento fue diseñado por versiones anteriores del propio modelo, lo que lo convierte en un caso singular dentro del panorama de los large language models. Su arquitectura está orientada específicamente a dos dominios de alto rendimiento: ingeniería de software profesional de extremo a extremo, y productividad de oficina compleja. Sumado a esto, incorpora inteligencia emocional y la capacidad de aprender desde la web en tiempo real, guardando esos aprendizajes como skills reutilizables dentro de OpenClaw.

- SWE-Pro: 56.22% — empata con GPT-5.3-Codex en tareas reales de ingeniería de software.
- VIBE-Pro: 55.6% — prácticamente a la par con Claude Opus 4.6 en razonamiento aplicado.
- Terminal Bench 2: 57.0% — comprensión profunda de sistemas multi-paso complejos.
- GDPval-AA ELO: 1,495 — el puntaje más alto entre 45 modelos open-source evaluados.
- 97% de adherencia a habilidades en 40 tareas de más de 2,000 tokens cada una.
- Costo vs. competencia: $0.30/millón de tokens de entrada frente a $5.00 de Claude Opus 4.6, aproximadamente 16 veces más económico para proyectos de alto volumen.
Requisitos del sistema: qué necesitas antes de comenzar
Verificar estos requisitos antes de ejecutar cualquier comando evita la mayoría de los errores de instalación. Los requisitos difieren según si usarás el modelo en la nube de Ollama o en modo completamente local:
- Sistema operativo: macOS 11+, Windows 10/11 (64-bit), o Linux con kernel 4.0+. En Windows, OpenClaw funciona mejor bajo WSL2, aunque también puede ejecutarse directamente desde PowerShell con dependencias adicionales.
- RAM mínima (modo nube): 8 GB. Se recomiendan 16 GB para sesiones largas de agente o múltiples modelos concurrentes.
- RAM mínima (modo local con M2.7): 64 GB de RAM unificada en Apple Silicon M3 Pro o superior, o GPU con 24 GB de VRAM como la NVIDIA RTX 4090.
- Espacio en disco: Mínimo 5 GB libres para Ollama y dependencias base. Para modo local, entre 15 y 40 GB adicionales según la variante del modelo.
- Node.js 22+: Requerido por OpenClaw. En Windows se recomienda instalarlo manualmente antes para evitar errores de permisos.
- Git: Necesario en Windows para que npm resuelva dependencias de OpenClaw correctamente. Sin Git instalado, el proceso fallará silenciosamente.
- Conexión a internet: Requerida para el modo cloud, la descarga inicial de Ollama y los plugins de búsqueda web de OpenClaw.
- VS Code 1.90+: Necesario únicamente para la integración con GitHub Copilot. Las rutas alternativas funcionan con versiones anteriores.
PARTE 1 — Instalación desde cero en cualquier sistema operativo
¿Cómo instalar Ollama en macOS?
La instalación en macOS es la más directa de las tres plataformas y no requiere ninguna herramienta adicional:
- Descarga el instalador desde ollama.com/download y selecciona macOS.
- Abre el archivo
.dmgdescargado y arrastra Ollama a la carpeta Aplicaciones. - Lanza Ollama desde Aplicaciones; aparecerá como ícono en la barra de menú superior derecha.
- Abre Terminal (Cmd+Espacio, escribe Terminal) y verifica la instalación:
ollama --versionDeberías ver algo como ollama version 0.6.x. Si el comando no es reconocido, cierra y vuelve a abrir la terminal completamente. Para confirmar que el servidor responde:
ollama listAunque la lista esté vacía, el comando debe ejecutarse sin error. Si aparece Error: could not connect to ollama app, haz clic en el ícono de Ollama en la barra de menú y selecciona Start.
¿Cómo instalar Ollama en Windows?
Windows tiene consideraciones específicas que no existen en macOS o Linux. El proceso más confiable combina la instalación del ejecutable de Ollama con la preparación de Git y Node.js antes de tocar OpenClaw:
Instalación de Ollama:
- Descarga
OllamaSetup.exedesde ollama.com/download (selecciona Windows). - Ejecuta el instalador. No requiere permisos de administrador. Ollama se agrega automáticamente al
PATHdel sistema. - Al finalizar, Ollama aparecerá en el System Tray. Haz clic derecho para acceder a sus opciones.
- Abre PowerShell y verifica:
ollama --version
ollama list
Instalación de Git para Windows (obligatorio para OpenClaw):
- Descarga Git desde git-scm.com/download/win.
- Durante la instalación, en la pantalla “Adjusting your PATH environment”, selecciona “Git from the command line and also from 3rd-party software”. Esta opción es crítica; sin ella, npm no encontrará Git al instalar OpenClaw.
- Completa la instalación con las opciones por defecto para el resto de las pantallas.
- Cierra y vuelve a abrir PowerShell. Verifica:
git --versionInstalación de Node.js 22+ en Windows (obligatorio para OpenClaw):
- Descarga el instalador LTS desde nodejs.org.
- Ejecuta el instalador y asegúrate de que la casilla “Add to PATH” esté marcada.
- Verifica en PowerShell:
node --version
npm --version
Deberías ver versiones como v22.x.x y 10.x.x respectivamente.
Configuración de WSL2 (recomendado para mayor compatibilidad):
WSL2 elimina la mayoría de los problemas de permisos y rutas al usar OpenClaw en Windows. Si prefieres usarlo, ejecuta en PowerShell como administrador y reinicia el sistema:
wsl --installTras el reinicio, abre la terminal de Ubuntu desde el menú inicio y sigue los pasos de instalación de Linux descritos a continuación. Ollama para Windows expone su API en localhost:11434, accesible desde WSL2 sin configuración adicional.
¿Cómo instalar Ollama en Linux?
En Linux el proceso es el más directo: un único comando descarga Ollama, lo instala y configura el servicio del sistema de forma automática:
- Abre la terminal y ejecuta:
curl -fsSL https://ollama.com/install.sh | sh- El script detecta tu distribución, descarga el binario correspondiente y configura Ollama como servicio con systemd.
- Verifica que el servidor esté activo:
ollama --version
ollama list
Para servidores sin systemd, arranca el servidor en segundo plano:
nohup ollama serve > /var/log/ollama.log 2>&1 &Error frecuente en Linux — “command not found: ollama”:
export PATH=$PATH:/usr/local/bin
source ~/.bashrc
Para que el cambio sea permanente, agrega esa línea al final del archivo ~/.bashrc o ~/.zshrc según tu shell.
PARTE 2 — Lanzar OpenClaw con MiniMax-M2.7
El error más frecuente y cómo evitarlo desde el inicio
Antes de escribir cualquier comando, es fundamental entender la distinción que genera el error más reportado por usuarios nuevos. MiniMax-M2.7 no existe como archivo descargable; opera exclusivamente desde la infraestructura de nube de Ollama. El error Error: failed to pull minimax-m2.7: pull model manifest: file does not exist ocurre porque el comando se escribió sin la etiqueta :cloud, lo que hace que Ollama intente buscar un manifiesto local inexistente:
❌ Incorrecto — genera el error de manifiesto:
ollama launch openclaw --model minimax-m2.7✅ Correcto — incluye la etiqueta obligatoria :cloud:
ollama launch openclaw --model minimax-m2.7:cloudOllama distingue tres tipos de modelos en su ecosistema:
- Modelos locales descargables: Se instalan con
ollama pull nombre:tagy corren completamente en tu hardware sin internet. Ejemplo:ollama pull llama3.2,ollama pull deepseek-r1:7b. - Modelos en la nube de Ollama (
:cloud): No se descargan ni ocupan espacio en disco. Requieren conexión a internet y cuenta activa en ollama.com. Ejemplo:minimax-m2.7:cloud,kimi-k2.5:cloud,glm-5:cloud. - Modelos mixtos: Algunos modelos tienen versiones locales y en la nube con el mismo nombre base. Siempre verifica las etiquetas disponibles en ollama.com/library antes de ejecutar comandos.
Paso 4: Primer lanzamiento de OpenClaw con MiniMax-M2.7
Con Ollama instalado, Node.js 22+ y Git disponibles, el siguiente comando gestiona todo el proceso automáticamente:
ollama launch openclaw --model minimax-m2.7:cloudDurante el primer lanzamiento, Ollama ejecuta estos pasos en orden sin intervención manual:
- Instalación: Si OpenClaw no está en el sistema, lo descarga e instala vía npm.
- Aviso de seguridad: Muestra una notificación sobre permisos de acceso a herramientas. Lee el aviso y escribe
ypara aceptar. Solo aparece en el primer lanzamiento. - Selección de modelo: Confirma
minimax-m2.7:cloudcomo modelo activo. Si aparece un selector interactivo, navega con las flechas del teclado y presiona Enter para confirmar. - Configuración del proveedor: Establece Ollama como proveedor y arranca el daemon del gateway en segundo plano.
- Plugins automáticos: Instala los plugins de búsqueda web y fetch que permiten al agente consultar información en tiempo real.
- Interfaz TUI: Abre la interfaz de texto de OpenClaw lista para recibir tareas.
Checklist completo para Windows si el lanzamiento falla
Si el comando anterior arroja errores en Windows, sigue esta secuencia exacta antes de buscar otras soluciones:
- Actualiza Ollama a la versión más reciente. Esta es la causa número uno de errores en Windows. Ejecuta:
ollama --versionSi la versión es anterior a
0.6.x, descarga e instala el ejecutable más reciente desde ollama.com/download. No necesitas desinstalar la versión anterior. - Verifica que Ollama está activo como servicio. Busca el ícono en el System Tray. Si no aparece, ábrelo desde el menú inicio. Luego confirma:
ollama list - Verifica Git y Node.js en el PATH:
git --version
node --version
Si alguno arroja “not recognized”, instálalo siguiendo los pasos del apartado anterior y cierra/abre PowerShell antes de continuar.
- Verifica que tienes sesión activa en Ollama. Los modelos
:cloudrequieren autenticación. Abre ollama.com y confirma que tu cuenta está activa con un plan vigente. - Ejecuta el comando correcto:
ollama launch openclaw --model minimax-m2.7:cloud - Si OpenClaw se instala pero no muestra modelos en la nube: Haz clic derecho en el ícono de Ollama en el System Tray → Settings → activa la opción Cloud → guarda. Vuelve a ejecutar el comando.
- Si
openclawno es reconocido como comando tras la instalación:npm config get prefixCopia la ruta que aparece (típicamente
C:\Users\TuUsuario\AppData\Roaming\npm) y agrégala al PATH:[System.Environment]::SetEnvironmentVariable("PATH", $env:PATH + ";C:\Users\TuUsuario\AppData\Roaming\npm", "User")Reemplaza
TuUsuariocon tu nombre de usuario real. Cierra y vuelve a abrir PowerShell.
PARTE 3 — Integración avanzada para instalaciones ya funcionales
¿Cómo cambiar a MiniMax-M2.7 en OpenClaw sin reinstalar nada?
Si ya tienes OpenClaw corriendo con otro modelo, existen dos rutas para migrar sin perder historial ni configuración:
Opción A — Desde dentro de OpenClaw (instantáneo, sin cerrar la sesión):
/model ollama/minimax-m2.7:cloudOpenClaw confirma el cambio y el modelo activo aparece actualizado en la cabecera de la interfaz.
Opción B — Desde la terminal:
ollama launch openclaw --model minimax-m2.7:cloudSi OpenClaw ya está instalado, Ollama detecta la instalación existente y solo actualiza el modelo configurado.
Verificar el modelo activo y el estado del servidor:
ollama psLa salida muestra todos los modelos cargados en memoria, su uso de RAM y VRAM, y el tiempo de inactividad hasta que sean descargados automáticamente.
Paso 5: Autoaprendizaje e investigación autónoma con OpenClaw
Una de las capacidades más potentes de MiniMax-M2.7 dentro de OpenClaw es su habilidad de aprender desde la web en tiempo real y guardar los marcos aprendidos como skills reutilizables. Un flujo de trabajo documentado hoy queda disponible como un proceso ejecutable en todos los proyectos futuros con un único prompt. Lo cierto es que esto reduce drásticamente el tiempo de configuración en tareas recurrentes: reportes financieros, auditorías de código, resúmenes de reuniones o análisis de competencia.
Ejemplo práctico: reporte financiero completo sobre TSMC
El siguiente prompt puede entregarse directamente desde la interfaz TUI de OpenClaw o vía --message en modo no interactivo:
“Teach yourself how to write financial research reports by studying examples from top analysts. Write a PPT presentation and Word document report on TSMC based on their latest earnings. Save your research framework as a skill so future reports follow the same process.”
Lo que OpenClaw ejecuta internamente, paso a paso:
- Busca en la web ejemplos de reportes de analistas financieros de referencia usando el plugin de búsqueda web.
- Aprende la estructura estándar: portada, resumen ejecutivo, métricas clave, análisis competitivo y proyecciones.
- Consulta los resultados financieros más recientes de TSMC desde fuentes públicas verificadas.
- Genera el documento PPT y el reporte Word con la estructura aprendida, guardándolos en el directorio de trabajo local.
- Guarda el marco de trabajo como una skill interna reutilizable (por ejemplo,
financial-report).
Para aplicar ese skill en un reporte futuro sobre otra empresa:
Use the financial-report skill to write a report on Samsung Q1 2026 earningsPaso 6: Modo no interactivo para servidores y automatización
El flag --yes permite lanzar agentes sin ninguna intervención humana, indispensable en entornos de CI/CD, contenedores Docker o tareas programadas con cron. La bandera acepta automáticamente todos los selectores de configuración y ejecuta el agente directamente en segundo plano:
ollama launch openclaw \
    --model minimax-m2.7:cloud \
    --yes -- agent \
    --agent main \
    --local \
    --message "Prepare a pre-read for my next meeting"
Desglose completo de cada parámetro:
--model minimax-m2.7:cloud— especifica el modelo. Siempre incluir:cloud.--yes— omite todos los selectores interactivos. Sin esta bandera, el proceso se detiene esperando confirmación manual.-- agent— lanza en modo agente autónomo. El doble guion separa los argumentos de Ollama de los de OpenClaw.--agent main— selecciona el agente principal. Otros valores:researcher,coder.--local— fuerza ejecución local sin requerir el gateway web. Útil para entornos sin interfaz gráfica.--message "..."— el prompt de tarea inicial que recibirá el agente al arrancar.
Redirigir la salida a un archivo:
ollama launch openclaw \
    --model minimax-m2.7:cloud \
    --yes -- agent \
    --agent main \
    --local \
    --message "Daily project status summary" > /ruta/resumen_$(date +%Y%m%d).txt 2>&1
Programar ejecución diaria automática con cron en Linux/macOS:
Edita tu crontab con crontab -e y agrega esta línea para ejecutar el agente cada día a las 8:00 AM:
0 8 * * * ollama launch openclaw --model minimax-m2.7:cloud --yes -- agent --agent main --local --message "Daily project status summary" >> ~/logs/daily_summary.log 2>&1Integración en un pipeline de GitHub Actions:
- name: Run AI Code Review
  run: |
    ollama launch openclaw \
      --model minimax-m2.7:cloud \
      --yes -- agent \
      --agent main \
      --local \
      --message "Review the changes in this PR and identify potential bugs or security issues"
PARTE 4 — Integración completa con Visual Studio Code y GitHub Copilot
La integración de Ollama con VS Code es nativa a partir de la versión 1.90 del editor. Existen tres rutas de integración distintas según el tipo de cuenta y las preferencias de configuración. Ollama debe estar corriendo activamente antes de abrir VS Code para que los modelos aparezcan en el selector.
Ruta A: Integración oficial vía GitHub Copilot
Esta es la ruta documentada oficialmente y ofrece acceso completo a los tres modos de Copilot Chat. Requiere una suscripción activa a GitHub Copilot ($10/mes en el plan Individual) y VS Code 1.90 o superior:
- Confirma que Ollama está activo:
- Windows: ícono visible en el System Tray.
- macOS: ícono visible en la barra de menú superior.
- Linux: ejecuta
ollama listen terminal; debe responder sin error.
- Abre VS Code y verifica que la extensión GitHub Copilot Chat está instalada. Si no está, instálala desde el Marketplace buscando “GitHub Copilot” (el paquete oficial de GitHub).
- Abre el panel de Copilot Chat con Ctrl+Alt+I (Windows/Linux) o Cmd+Alt+I (macOS).
- Haz clic en el nombre del modelo activo en la parte superior del panel para desplegar el menú de modelos.
- Selecciona “Manage Models…” o “Add Models” → elige Ollama. VS Code se conecta a
http://localhost:11434y carga todos los modelos disponibles. - Busca
minimax-m2.7:clouden la lista. Si aparece como oculto, haz clic en Unhide para que quede activo de forma permanente. - Verifica la conexión con un mensaje de prueba:
Hello, which model are you?La respuesta debe identificarse como MiniMax-M2.7.
Para usuarios de Windows que no ven los modelos en el selector tras seguir los pasos: Confirma que Ollama está en el System Tray. Luego recarga VS Code con Ctrl+Shift+P → “Developer: Reload Window”. Regresa al selector de modelos y busca Ollama nuevamente.
Ruta B: Extensión Ollama Copilot desde el Marketplace (sin suscripción a Copilot)
Esta ruta es ideal para quienes no tienen suscripción a GitHub Copilot o prefieren una configuración sin dependencias externas. La extensión conecta directamente con la API local de Ollama y ofrece autocompletado en tiempo real y panel de chat integrado:
- En VS Code abre el panel de Extensiones con Ctrl+Shift+X.
- Busca “Ollama Copilot” y selecciona la extensión del autor namdang. Haz clic en Install.
- Abre la configuración de VS Code con Ctrl+, y busca “Ollama”. Establece los siguientes valores:
ollama-copilot.baseUrl:http://localhost:11434ollama-copilot.model:minimax-m2.7:cloudollama-copilot.chatModel:minimax-m2.7:cloudollama-copilot.maxTokens:500(el valor por defecto de 100 es demasiado bajo para contextos complejos).ollama-copilot.temperature:0.2(mantén este valor bajo para código).ollama-copilot.debounceMs:500(tiempo de espera antes de activar el autocompletado).
- Haz clic en el ícono de Ollama en la barra de actividad lateral para abrir el panel de chat.
- Abre cualquier archivo de código y comienza a escribir; las sugerencias aparecerán como texto fantasma. Presiona Tab para aceptar o Esc para descartar.
Si el autocompletado no responde: Abre la consola de desarrollador de VS Code (Help → Toggle Developer Tools) y busca errores de conexión. El problema más común es que Ollama escucha en 0.0.0.0:11434 pero la extensión apunta a 127.0.0.1:11434. Ajusta ollama-copilot.baseUrl a la dirección exacta que muestra ollama serve al iniciar.
Ruta C: Endpoint OpenAI-compatible para configuraciones avanzadas
Esta ruta es preferida por equipos que integran múltiples proveedores de modelos o herramientas como LiteLLM, Continue.dev o PromptFlow. Ollama expone por defecto una API compatible con el estándar de OpenAI en http://localhost:11434/v1:
- Abre la paleta de comandos: Ctrl+Shift+P.
- Busca y selecciona: “GitHub Copilot: Manage Language Models”.
- Elige “Add custom model endpoint”.
- Ingresa estos valores:
- Endpoint URL:
http://localhost:11434/v1/chat/completions - Model ID:
minimax-m2.7:cloud - API Key:
ollama(cualquier cadena no vacía; Ollama no valida la clave en local)
- Guarda la configuración. El modelo aparecerá de inmediato en el selector de Copilot Chat como proveedor personalizado.
Los tres modos de GitHub Copilot Chat con Ollama
Una vez configurado el modelo, Copilot Chat opera en tres modos que determinan el nivel de autonomía del agente y el riesgo de cambios no deseados en el código:
- Modo Agente (Agent mode) — Autonomía máxima. Copilot determina qué archivos modificar, sugiere cambios, ejecuta comandos en la terminal e itera hasta completar el objetivo. Ideal para tareas concretas donde se confía plenamente en el modelo.
Prompts recomendados:
"Run the tests and fix any failures""Generate unit tests for this file""Update the README with the new API changes""Refactor this function to improve performance"
- Modo Plan (Plan mode) — Control humano antes de ejecutar. Copilot genera un plan de implementación detallado que el desarrollador debe revisar y aprobar antes de que el agente modifique un solo archivo. Recomendado para cambios en código de producción o bases de código desconocidas.
Prompts recomendados:
"Refactor the authentication module to support OAuth2""Migrate this class from JavaScript to TypeScript"
- Modo Pregunta (Ask mode) — Exploración sin modificaciones. El modelo responde preguntas sobre el codebase, explica arquitecturas y discute conceptos sin tocar ningún archivo. Útil como punto de partida antes de usar el Modo Plan o Agente.
Prompts recomendados:
"Explain how the authentication middleware works in this project""What would be the best approach to implement caching here?""Are there any security vulnerabilities in this function?"
PARTE 5 — Costos y límites del servicio en la nube
Antes de construir cualquier proyecto sobre MiniMax-M2.7 en la nube de Ollama, es indispensable entender qué se mide, qué se cobra y dónde están los límites reales. A diferencia de proveedores que cobran por token fijo, Ollama mide el tiempo de GPU consumido por sesión, lo que favorece el uso conversacional ligero pero puede sorprender en agentes continuos o investigación profunda. Los planes no publican un número máximo de tokens exacto de forma deliberada; están estructurados por intensidad de uso, no por cifras fijas.
¿Cuánto cuesta cada plan de Ollama Cloud?
- Plan Free — $0/mes: 1 modelo concurrente activo. Para evaluación del servicio, prototipado ligero y chateo ocasional. No apto para automatización continua ni agentes headless de larga duración.
- Plan Pro — $20/mes (o $200/año con dos meses gratis): 3 modelos concurrentes y 50 veces más cuota de GPU que el plan Free. Cubre trabajo diario con M2.7, tareas de investigación en OpenClaw y hasta 3 proyectos activos en paralelo.
- Plan Max — $100/mes: 10 modelos concurrentes y 5 veces más cuota que Pro. Para agentes en ejecución continua, múltiples agentes simultáneos y sesiones largas con modelos de alta demanda.
Si se accede a M2.7 directamente vía API de MiniMax (ruta recomendada para producción), la estructura de cobro es por token individual:
- MiniMax-M2.7: $0.30 por millón de tokens de entrada / $1.20 por millón de salida.
- MiniMax-M2.7-highspeed: $0.60 por millón de entrada / $2.40 por millón de salida.
- Caché de contexto (lectura): $0.06 por millón de tokens, ideal para conversaciones largas sobre el mismo contexto.
- Plan Coding de MiniMax ($10/mes): Alternativa popular entre desarrolladores con carga alta; usuarios reportan la práctica eliminación de errores de límite de tasa incluso en sesiones intensivas con OpenClaw.
Límites reales de sesión y concurrencia
- Límite de sesión: Aproximadamente 4-5 horas de GPU activo antes de un reinicio parcial de cuota. La sesión no se interrumpe; simplemente se ralentiza la respuesta o se encola la solicitud.
- Límite semanal: Se reinicia automáticamente cada semana sin fecha fija publicada. Si se agota antes del fin de semana en el Plan Pro, Ollama muestra un aviso en la interfaz.
- Concurrencia: Free = 1 modelo / Pro = 3 modelos / Max = 10 modelos. Las solicitudes que exceden el límite se encolan; solo se rechazan si la cola también está saturada.
- Rate limit vía API directa de MiniMax: 500 RPM y 20,000,000 TPM — prácticamente sin límite para uso individual.
- Token Plan MiniMax Starter ($10/mes): 1,500 solicitudes cada 5 horas. Plan Plus: 4,500. Plan Max: 15,000.
¿Qué plan elegir según el tipo de proyecto?
- Aprendizaje y prototipado: Plan Free de Ollama. Sin costo, cubre exploración de OpenClaw y pruebas en VS Code.
- Desarrollo profesional individual: Plan Pro de Ollama ($20/mes) o Plan Coding de MiniMax ($10/mes) como alternativa más económica.
- Automatización media o equipos pequeños: Plan Pro o Max según intensidad. Si se usan 3 o más modelos en paralelo regularmente, Pro puede ser insuficiente en semanas de alta carga.
- Producción con alto volumen: API directa de MiniMax con pay-as-you-go o hardware local. El costo por token de MiniMax es significativamente más predecible que cualquier plan de cuota de GPU.
- Agentes headless continuos en servidores: Plan Max o API directa de MiniMax obligatoriamente. El modo
--yescon tareas largas consume cuota rápidamente; el Plan Free o Pro puede agotarse en horas en pipelines activos.
¿Cuándo conviene migrar al modo completamente local?
Existe un punto de inflexión donde ejecutar MiniMax-M2.7 en hardware propio resulta más económico, más rápido y completamente predecible. El modo local elimina los límites de sesión, los límites semanales, la latencia de red y cualquier preocupación sobre la privacidad de los datos procesados.
Señales de que es momento de migrar:
- Alcanzas el límite semanal antes del viernes de forma regular.
- Los agentes headless fallan por cuota agotada en horario laboral.
- El costo mensual combinado supera los $100.
- El proyecto procesa datos sensibles que no deben salir de tu infraestructura.
Requisito mínimo de hardware: GPU con 24 GB de VRAM (NVIDIA RTX 4090 o superior) o Apple Silicon M3 Pro o superior con 64 GB de RAM unificada.
Comandos para migrar a modo local:
ollama pull minimax-m2.7
ollama launch openclaw --model minimax-m2.7
Si ya estás dentro de OpenClaw:
/model ollama/minimax-m2.7Nota crítica sobre producción: MiniMax documenta explícitamente que su Token Plan está diseñado para uso individual interactivo de desarrolladores, no para entornos productivos con múltiples usuarios concurrentes. Para producción a escala, la recomendación oficial es el esquema pay-as-you-go con clave de API directa.
PARTE 6 — MaxClaw: la alternativa sin infraestructura
Para quienes no deseen gestionar servidores, rotaciones de claves de API ni actualizaciones de dependencias, MiniMax ofrece MaxClaw: un despliegue totalmente gestionado de OpenClaw en la nube de MiniMax, operativo en menos de 10 segundos con un solo clic y sin ninguna configuración técnica. Usa el mismo modelo M2.7, las mismas capacidades de agente y el mismo ecosistema de plugins, pero elimina completamente la capa de infraestructura.
- Despliegue instantáneo: Un clic en agent.minimax.io crea un agente completamente funcional en menos de 10 segundos. Sin servidores, sin Docker, sin claves de API que gestionar manualmente.
- Siempre activo: El agente corre 24/7 en la infraestructura de MiniMax, recuerda conversaciones entre sesiones y puede conectarse a Telegram, Slack o Discord de forma nativa sin configuración de webhooks.
- Cuándo elegir MaxClaw: Cuando la prioridad es velocidad de despliegue y no se necesita control sobre el modelo ni sobre dónde residen los datos. Solo tiene un modelo disponible (M2.5/M2.7) y no permite cambiar de proveedor.
- Cuándo seguir con OpenClaw + Ollama: Cuando se necesita flexibilidad para cambiar de modelo, trabajar con datos sensibles en local, integrar pipelines de CI/CD o usar la bandera
--yespara automatización no interactiva.
Flujo de trabajo completo: ejemplo real de extremo a extremo
El siguiente flujo integra todas las capacidades de esta guía en un proceso de desarrollo profesional real:
- Preparar el contexto antes de abrir el editor:
ollama launch openclaw \
    --model minimax-m2.7:cloud \
    --yes -- agent \
    --agent main \
    --local \
    --message "Summarize the last 10 commits, identify technical debt and suggest the 3 highest-priority fixes"
OpenClaw analiza el repositorio y genera un resumen estructurado antes de que el desarrollador abra VS Code.
- Abrir VS Code con
minimax-m2.7:cloudseleccionado en Copilot Chat. - Activar Modo Plan y solicitar los cambios identificados:
Apply the top 3 technical debt fixes identified in the project summaryCopilot presenta el plan; el desarrollador lo revisa y aprueba sección por sección.
- Cambiar a Modo Agente para ejecutar los cambios y verificar pruebas:
Run the tests and fix any failures introduced by the recent changes - Guardar el flujo como skill en OpenClaw:
/skill save tech-debt-review "Summarize commits, identify debt, suggest fixes, apply top 3, run tests" - Programar ejecución automática cada lunes a las 7:00 AM:
0 7 * * 1 ollama launch openclaw --model minimax-m2.7:cloud --yes -- agent --agent main --local --message "Use tech-debt-review skill on the current branch" >> ~/logs/weekly_review.log 2>&1
Resolución de errores: guía de referencia completa
- “pull model manifest: file does not exist”
Causa: Se usó
minimax-m2.7sin la etiqueta:cloud.Solución: Usa siempre
minimax-m2.7:cloud. Si el error persiste con la etiqueta correcta, actualiza Ollama a la versión más reciente. - “command not found: ollama”
Causa: Binario no está en el PATH de la sesión actual.
Solución Linux/macOS:
export PATH=$PATH:/usr/local/bin && source ~/.bashrc. En Windows: cierra y vuelve a abrir PowerShell. - “connection refused 127.0.0.1:11434”
Causa: El servidor de Ollama no está activo.
Solución: Ejecuta
ollama serveen una terminal separada y déjala abierta, o activa Ollama desde el System Tray en Windows. - Los modelos no aparecen en el selector de VS Code
Causa: Ollama no estaba activo cuando VS Code cargó el panel de Copilot.
Solución: Confirma que Ollama está corriendo, luego recarga VS Code con Ctrl+Shift+P → “Developer: Reload Window”.
- “The AI service is temporarily overloaded”
Causa: Alta demanda en la infraestructura de Ollama Cloud en horarios pico.
Solución: Espera 2-5 minutos e intenta de nuevo. Verifica el estado en status.ollama.com.
- OpenClaw no instala vía npm en Windows
Causa: Node.js o Git no están en el PATH del sistema.
Solución: Instala ambos siguiendo el Paso 2 de esta guía. Cierra y vuelve a abrir PowerShell antes de reintentar.
- El agente headless no guarda resultados
Causa: La salida del proceso no está redirigida a un archivo.
Solución: Agrega
> /ruta/archivo.txt 2>&1al final del comando de lanzamiento. - Errores de tasa frecuentes en OpenClaw
Causa: El plan actual se agotó o la API de MiniMax alcanzó el límite del plan Starter.
Solución: Migra al Plan Coding de MiniMax ($10/mes) o al Plan Pro de Ollama.
- LiteLLM o integraciones de terceros fallan en la segunda solicitud
Causa: Bug conocido con
minimax-m2.7vía Ollama Cloud en frameworks que mantienen sesión activa.Solución temporal: Desactiva la persistencia de sesión en tu configuración de LiteLLM o usa la API directa de MiniMax hasta que se publique el fix oficial.
- OpenClaw silencioso o sin respuesta en macOS Apple Silicon
Causa: Versión desactualizada de OpenClaw con incompatibilidad en chips M-series.
Solución:
npm update -g openclaw. Verifica la versión conopenclaw --version. - El autocompletado de la extensión Marketplace no responde en VS Code
Causa: Discrepancia entre la dirección que usa Ollama y la configurada en la extensión.
Solución: Ajusta
ollama-copilot.baseUrla la dirección exacta que muestraollama serveal iniciar.





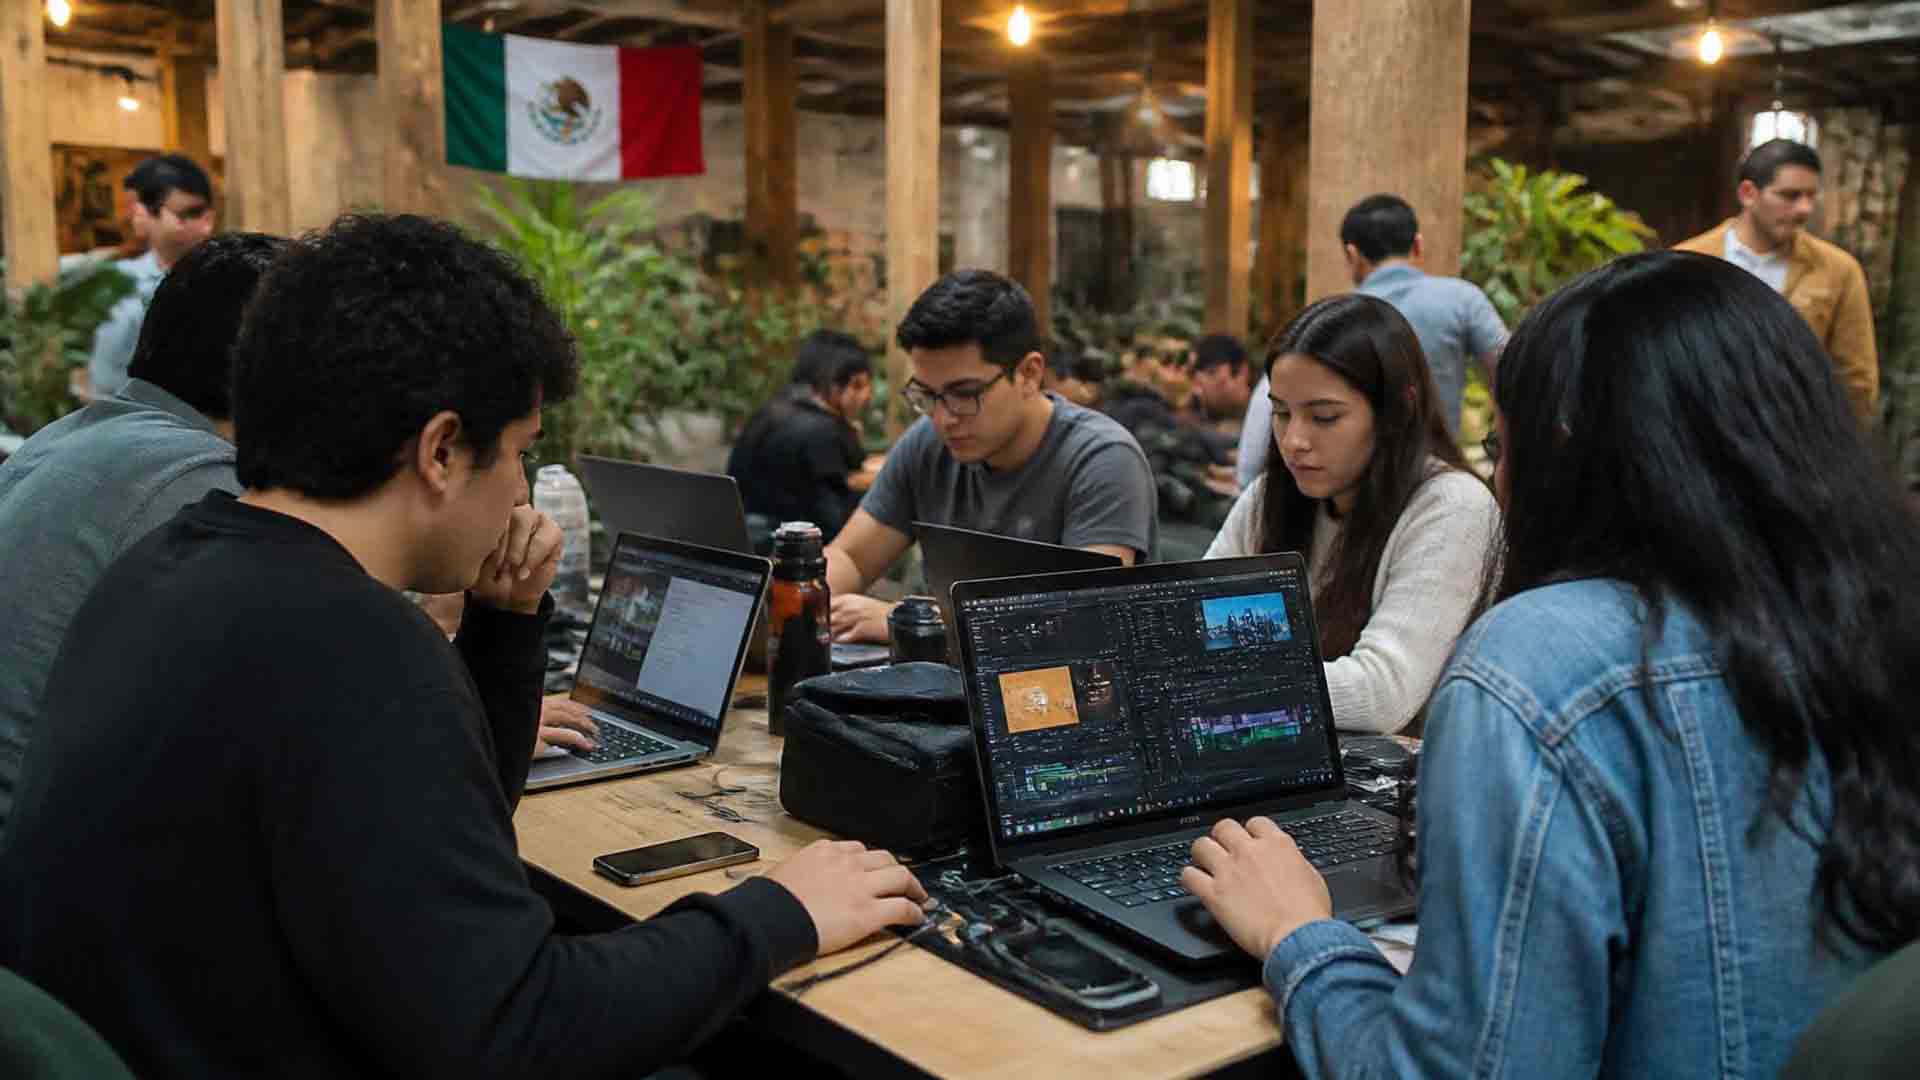
CapCut participará en México Tech Week 2026 con el CapCut Design Studio: Speed-to-Scale Hackathon, una activación gratuita para crear en cuatro horas una pieza lista para mostrar usando herramientas de IA. El cupo es de 30 lugares con registro previo.
¿Y si pudieras contratar un equipo de asistentes de IA que trabajara en tu propia computadora, con tus archivos, tu navegador y el plan de ChatGPT, Claude, Gemini o Grok que ya pagas? Eso es exactamente lo que propone OpenBot, una aplicación de escritorio gratuita que convierte varios agentes de IA en compañeros de trabajo persistentes, con espacios de trabajo dedicados, colas de tareas y hasta colaboración entre agentes.

Google lanzó Nano Banana 2.1, la actualización de su modelo de generación y edición de imágenes por IA: mejor calidad visual, texto más legible, consistencia de personajes y un precio en la API reducido a casi la mitad respecto a Nano Banana 2.
-

 Apps11 años ago
AMPcast, la herramienta de Pandora que permite a los artistas grabar mensajes de audio directamente a sus seguidores
-
 Blogs5 años ago
Conoce los mejores sitios de Torrents para descargar todo tipo de contenidos
-
Android5 años ago
Aprende cómo usar Discord para ver películas con tus amigos
-
Arte y Cultura14 años ago
Colección de fondos de pantalla basados en Super Héroes
-

 Almacenamiento2 años ago
Cómo usar TeraBox: La guía definitiva para aprovechar 1 TB de almacenamiento en la nube
-
Diseño13 años ago
css3ps: plugin que convierte archivos PSD a CSS3
-
Apps9 años ago
Picturethat, app que usa la Realidad Aumentada para visualizar cómo quedarían los cuadros antes de colgarlos
-
Eventos Especiales13 años ago
Especial Día de la Madres: fondos de pantalla especiales para Mamá