
Especificaciones
Cómo instalar Odysseus AI de PewDiePie paso a paso (2026)

Odysseus AI es el workspace de inteligencia artificial autoalojado creado por PewDiePie: chat, agentes, investigación, correo y calendario en una sola interfaz web. Esta guía te lleva de cero a tenerlo instalado con Docker, tu primer modelo conectado y la instalación protegida.
¿Qué es Odysseus AI en un minuto?
Odysseus es un espacio de trabajo de IA self-hosted: lo instalas en tu propio equipo o servidor, en lugar de usar un servicio en la nube. Es gratuito y de código abierto (licencia AGPL-3.0), lo mantiene la organización odysseus-dev de GitHub y ya supera las 88.000 estrellas. Su filosofía es local-first: con modelos locales, el procesamiento ocurre en tu máquina y tus datos no pasan por servidores de terceros.
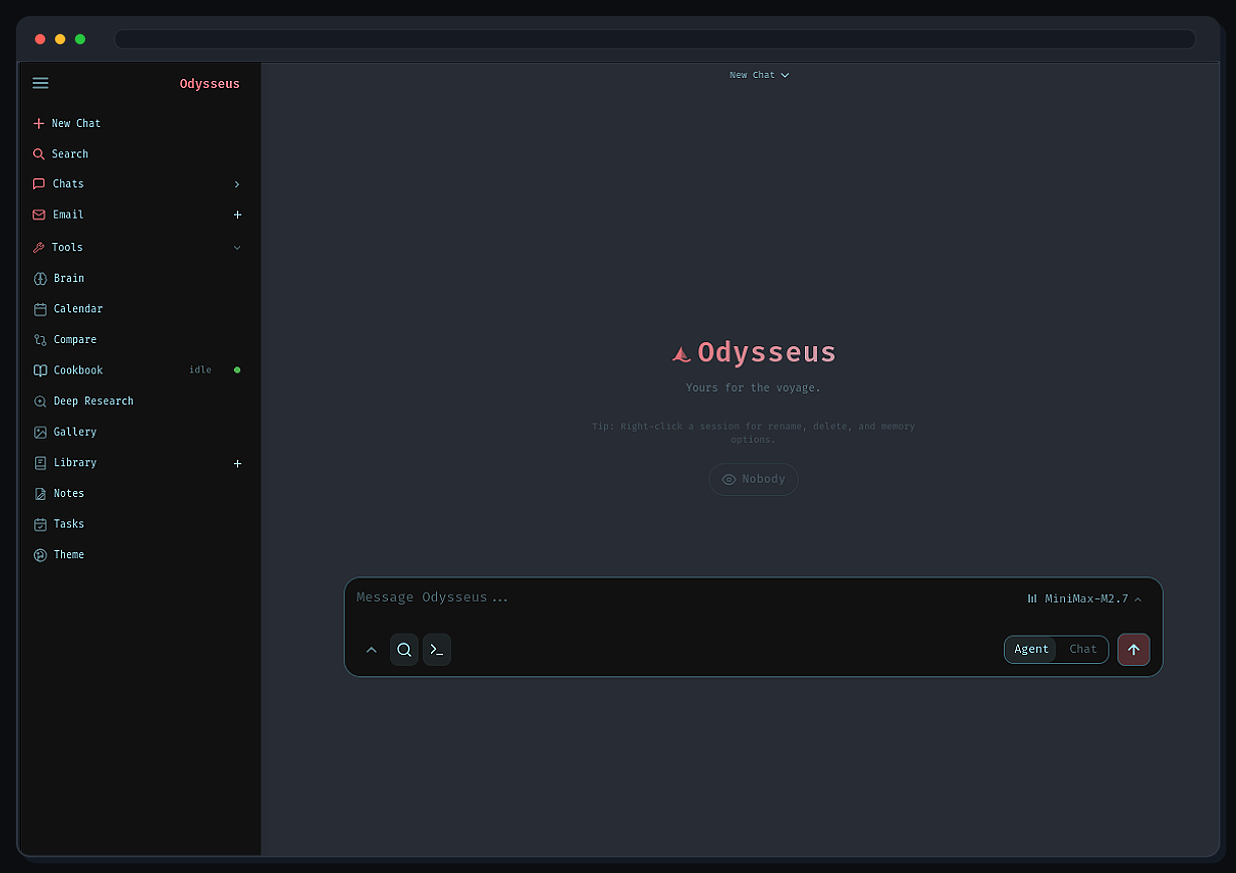
Acepta tres tipos de backend para ejecutar los modelos:
- Modelos locales: Ollama, llama.cpp, vLLM, LM Studio o SGLang
- APIs en la nube: OpenRouter, OpenAI, Anthropic, Gemini, Groq, xAI, DeepSeek, Mistral y otras compatibles con OpenAI
- Suscripción a ChatGPT: inicio de sesión con tu cuenta Plus o Pro mediante OAuth, sin API key ni pago por token
Si aún no tienes claro para qué te serviría, estos usos prácticos de los modelos de lenguaje local muestran tareas cotidianas que ya resuelve sin chatbots de pago.
Qué necesitas antes de empezar
- Docker y Git: Docker Desktop en Windows y macOS, o Docker Engine en Linux
- Sistema: macOS con Apple Silicon, o Linux con Python 3.11+ si prefieres instalación nativa (Windows existe, pero el proyecto no lo prueba activamente)
- GPU: opcional pero muy recomendable para modelos locales; sin ella funcionan los backends por API
- Elegir rama: el repositorio usa dev como rama por defecto (novedades primero) y main como rama curada; para producción conviene main
Paso 1: ¿Puede tu equipo ejecutar Odysseus AI?
El factor decisivo es la VRAM de tu GPU o, en una Mac, la memoria unificada. El Cookbook integrado analiza tu hardware y puntúa qué modelos encajan, pero esta tabla te orienta antes de instalar nada.
| Tu equipo | Qué puedes ejecutar | Modelos de ejemplo |
|---|---|---|
| Solo CPU | Modelos pequeños de 1-4B parámetros; chat simple, lento para agentes y documentos largos | Qwen3 1.7B, Gemma 3 1B, Phi-4-mini (Q4) |
| 8 GB de VRAM | Modelos cuantizados de 7-8B: el punto de partida recomendado | Qwen3 8B (Q4), Llama 3.1 8B (Q4), Gemma 3 4B |
| 12 GB de VRAM | Modelos de 12-14B con margen para los contextos largos que exigen los agentes y Deep Research | Gemma 4 12B (QAT), Qwen3 14B (Q4), Phi-4 14B (Q4) |
| 24 GB o más | Modelos de 27-32B; los de 70B requieren unos 40 GB en Q4 (dos tarjetas, una de 48 GB o descarga pesada a CPU) | Qwen3 32B (Q4), gpt-oss-20b, Gemma 3 27B (Q4) |
¿Qué significa Q4? Es la versión cuantizada del modelo: comprimida para ocupar menos memoria a cambio de una pérdida de calidad pequeña. Es el mejor formato para empezar. Si tu equipo se queda corto, esta guía sobre qué LLM local elegir según tu VRAM en 2026 detalla configuraciones óptimas para Ollama y LM Studio con 4, 6, 8 o 12 GB.
Paso 2: Elige tu método de instalación
Docker es la vía recomendada: un solo comando deja corriendo la aplicación junto con ChromaDB, SearXNG y ntfy, vinculados por defecto a 127.0.0.1. Esta tabla resume las rutas por plataforma.
| Plataforma | Método | Acceso |
|---|---|---|
| Docker (recomendado) | Docker Compose con la imagen oficial ghcr.io/odysseus-dev/odysseus | http://localhost:7000 |
| Windows | Lanzador launch-windows.ps1, o Docker Desktop con WSL2 (más fiable, porque Windows no se prueba activamente) | localhost:7000 con Docker |
| macOS (Apple Silicon) | Script start-macos.sh con aceleración Metal | http://localhost:7860 |
| Linux | Docker con los overlays de GPU del repositorio, o Python 3.11+ nativo | http://localhost:7000 |
| NAS | Apps comunitarias para Unraid y TrueNAS | Según tu configuración |
Paso 3: Instálalo con Docker
La guía oficial de Odysseus AI recomienda verificar la fuente antes de empezar. El quick start del README son cuatro comandos:
- Clona el repositorio (usa la rama main si buscas estabilidad): git clone https://github.com/odysseus-dev/odysseus.git y entra con cd odysseus
- Prepara la configuración: cp .env.example .env
- Arranca todo: docker compose up -d –build — la primera vez tarda mientras descarga las imágenes
- Abre el navegador en http://localhost:7000 cuando los contenedores estén sanos
Para aceleración por GPU, el repositorio incluye los archivos docker-compose.gpu-nvidia.yml y docker-compose.gpu-amd.yml, que se añaden al Compose principal según tu tarjeta. Para despliegues serios, el README sugiere fijar la imagen a una etiqueta inmutable del tipo 1.0.2-7c8070f en lugar de :latest.
Paso 4: Entra por primera vez
La primera contraseña de administrador se imprime en los registros: búscala con docker compose logs odysseus. Si instalas de forma nativa, el asistente te pide elegir una, y también puedes predefinirla con la variable ODYSSEUS_ADMIN_PASSWORD en el archivo .env antes del primer arranque. Al entrar: cámbiala por una larga y única, activa el 2FA con TOTP y guarda los códigos de respaldo.
Paso 5: Conecta tu primer modelo
Sin un modelo conectado, Odysseus no puede responder. Tres rutas según tu prioridad:
| Ruta | Privacidad | Costo | Ideal para |
|---|---|---|---|
| Modelo local (Ollama, llama.cpp, vLLM) | Máxima: nada sale de tu equipo | Solo electricidad | Datos sensibles y uso sin conexión |
| API en la nube (OpenRouter o compatible con OpenAI) | Los datos viajan al proveedor | Pago por token | Modelos potentes sin GPU propia |
| Suscripción a ChatGPT (Plus o Pro) | Los datos viajan a OpenAI | Ya incluida en tu plan | Aprovechar una suscripción que ya pagas |
Para la ruta local, la guía oficial detalla cómo conectar Ollama con su endpoint y el sufijo /v1 correspondiente. Si la conexión te da problemas, el patrón de servidor local con una GPU de 8 GB explica cómo elegir bien la cuantización y conectar tus apps mediante una API compatible con la de OpenAI.
Paso 6: ¿Cómo proteges la instalación?
Autoalojar es seguro mientras mantengas el acceso privado. El propio proyecto es claro: su modelo de amenazas asume usuarios de confianza en una red privada, así que trátalo como una consola de administración. Revisa la guía de seguridad oficial y esta lista antes del uso real:
- Autenticación activada: AUTH_ENABLED=true y LOCALHOST_BYPASS=false (ambos son los valores por defecto)
- Nunca expongas el puerto 7000 directamente a internet: para acceso remoto usa Tailscale, Cloudflare Access o WireGuard, nunca port forwarding
- HTTPS para todo lo que pase de localhost: Caddy o nginx como proxy inverso, o certificados de Tailscale
- Pocas cuentas admin y registro abierto desactivado; los agentes ejecutan shell y archivos sin sandbox (brecha conocida del proyecto), así que no apruebes a ciegas
- Respalda antes de actualizar: python3 scripts/odysseus-backup snapshot; luego git pull y docker compose up -d –build, preferiblemente en la rama main
Paso 7: Empieza a usar sus herramientas
Ya dentro del workspace, estas son las herramientas que vas a encontrar y para qué sirve cada una.
| Herramienta | Qué hace | Cuándo usarla |
|---|---|---|
| Documents | Editor con ediciones y sugerencias de IA para Markdown, HTML y CSV, con resaltado de sintaxis | Redactar y pulir textos y datos |
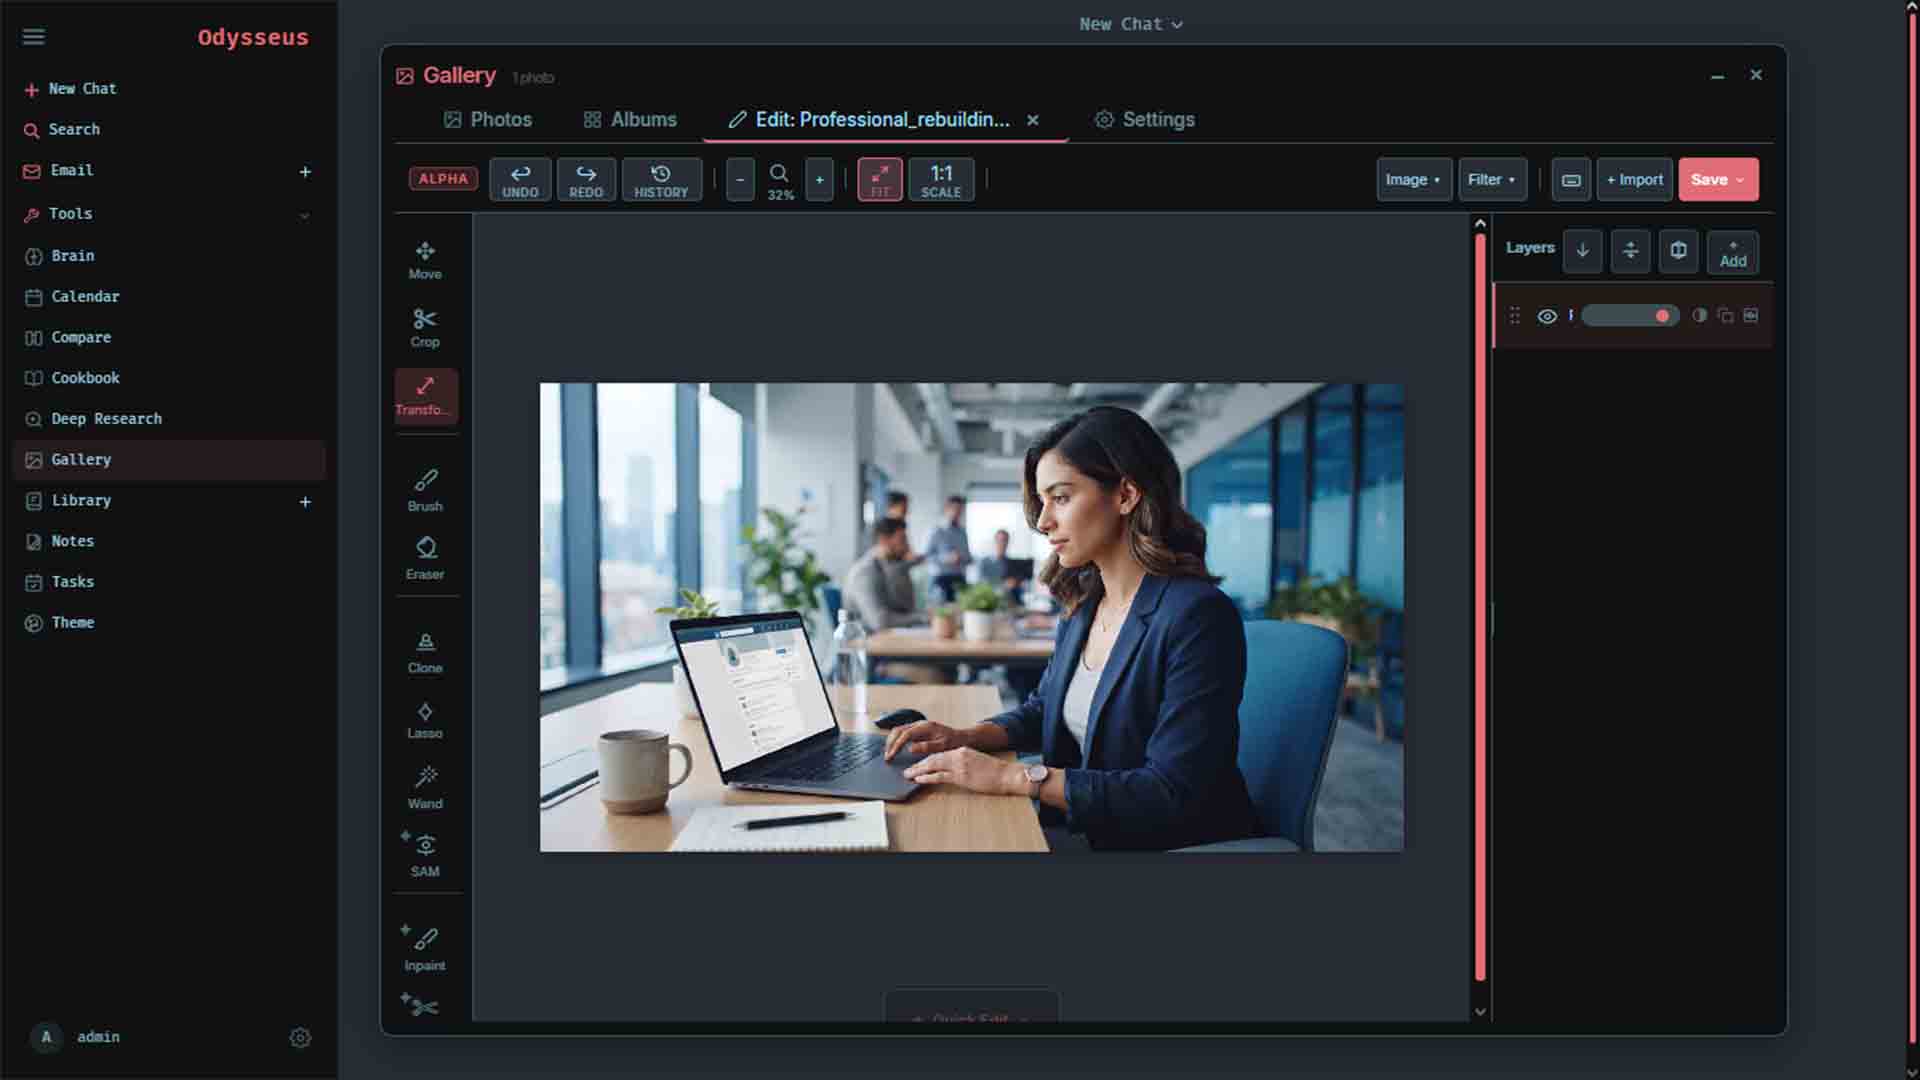
| Galería de imágenes | Galería con editor de imágenes integrado | Retocar gráficos sin salir del workspace |
| Deep Research | Investigación web en varios pasos con SearXNG integrada | Reportes con fuentes verificadas |
| Compare | Comparación ciega de dos modelos lado a lado | Elegir el mejor modelo para tu equipo |
| IMAP/SMTP con clasificación, etiquetas, resúmenes y respuestas (OAuth de Gmail para Workspace y .edu) | Triaje del correo | |
| Notas, tareas y calendario | Recordatorios, tareas agendadas de agentes, CalDAV y push vía ntfy | Agenda y automatizaciones |
| Cookbook | Escaneo de hardware, puntuación de modelos, descargas y servicio local o por SSH | Saber qué modelos corren en tu GPU |
| Memoria y Skills | Memoria vectorial ChromaDB y skills importables | Contexto persistente entre sesiones |
¿Algo falla? Problemas conocidos y su solución
El proyecto es joven y mantiene una lista pública de limitaciones; estos son los tropiezos más frecuentes documentados por el propio equipo y la comunidad.
| Problema | Causa | Solución |
|---|---|---|
| En una Mac no carga localhost:7000 | El script de macOS sirve en otro puerto | Abre http://localhost:7860 |
| Cookbook en Docker detecta la GPU pero cae a CPU | Problema abierto conocido del proyecto (issue #831) | Sigue el issue en GitHub y prueba servir el modelo con llama.cpp u Ollama fuera de Docker |
| Los vectores de ChromaDB se pierden al recrear contenedores | Volumen montado en la ruta equivocada (reportado en agosto de 2026) | Respalda data/ con el CLI oficial antes de recrear; el volumen de ChromaDB requiere copia aparte |
| El correo de Microsoft 365 rechaza la contraseña | Microsoft desactivó la autenticación básica y el OAuth de Microsoft aún no está implementado | Usa Gmail con OAuth2 (cuentas Workspace y .edu) u otra cuenta IMAP con contraseña de aplicación |
| El modo agente falla o responde lento | El propio roadmap admite que el modo agente es demasiado pesado para modelos de contexto pequeño (4k-16k) | Usa un modelo cuantizado Q4 más capaz o reduce la tarea a pasos más cortos |
¿Cuánto cuesta frente a ChatGPT y Claude de pago?
El software es gratis; el costo real está en el hardware, la electricidad o los tokens. Estas cifras son estimaciones en dólares publicadas por la guía oficial en agosto de 2026: trátalas como referencia.
| Factor | Odysseus (local) | ChatGPT Plus | Claude Pro |
|---|---|---|---|
| Costo del software | $0 (AGPL-3.0) | $20/mes | $20/mes |
| Electricidad | ~$5-20/mes con GPU activa | Incluida | Incluida |
| Hardware inicial | $0 si ya tienes GPU; $300-1,600 si compras una (RTX 4060 a RTX 4090) | $0 | $0 |
| Costo anual estimado | $60-1,840 según hardware | $240 | $240 |
| Privacidad | Todo local en tu máquina | Servidores de OpenAI | Servidores de Anthropic |
| Límites de uso | Tu hardware | Límites de tasa | Límites de tasa |
La matemática del punto de equilibrio: una RTX 4060 de ~$300 se paga sola en unos 15 meses frente a una suscripción Plus de $20/mes. La guía oficial detalla el desglose completo de costos reales, incluida la ruta híbrida por OpenRouter.
La comparación detallada, incluido el inicio de sesión con tu suscripción de ChatGPT, está en la página oficial de Odysseus AI frente a ChatGPT.
Odysseus AI frente a Open WebUI y AnythingLLM
El punto fuerte de Odysseus es ser un espacio de trabajo todo en uno; sus rivales maduros concentran sus fortalezas en otros frentes.
| Criterio | Odysseus AI | Open WebUI | AnythingLLM |
|---|---|---|---|
| Estrellas en GitHub | 88k+ | 149k+ | 65k+ |
| Licencia | AGPL-3.0 | Personalizada (basada en BSD-3) | MIT |
| Instalación | Docker Compose, lanzadores nativos, Unraid/TrueNAS | Docker | Docker o escritorio |
| Enfoque | Workspace integral: agentes, investigación, correo, calendario, notas | Multiusuario, herramientas, automatizaciones | Documentos, agentes, escritorio |
| Punto débil | Desarrollo acelerado, sin releases etiquetadas | Los flujos de terminal requieren un servicio extra | Escritorio y servidor difieren |
| Madurez | Temprana | Madura | Madura |
El código y la comunidad viven en el repositorio oficial de Odysseus en GitHub, con 2.098 commits y unos 320 colaboradores hasta septiembre de 2026.
Preguntas frecuentes
¿Odysseus AI es gratis?
Sí. Es software libre bajo AGPL-3.0-or-later, sin suscripción ni capa freemium; el costo real es el hardware, la electricidad o las APIs de pago que decidas usar.
¿Necesito una GPU?
No es obligatoria: sin GPU puedes usar modelos pequeños de 1-4B parámetros o backends por API. Con una GPU de 8 GB o más la experiencia mejora notablemente.
¿Puedo usar mi suscripción de ChatGPT?
Sí: Odysseus permite iniciar sesión con una cuenta Plus o Pro mediante OAuth, usando la suscripción como backend sin API key ni facturación por token, respetando los límites de tu plan.
¿Es seguro autoalojarlo?
Sí, con acceso privado: autenticación activada, HTTPS más allá de localhost y acceso remoto por Tailscale, Cloudflare Access o VPN. Ten presente que los agentes no corren en sandbox, así que conviene aprobar cada acción y mantener pocas cuentas de administrador.
Lo más leído en Especificaciones
-
 Apps
Claude Duet vs Hermes Agent la carrera del agente de IA proactivo
Anthropic presentó Claude Duet, una app donde Claude actúa como agente proactivo que monitorea apps conectadas y trabaja…
-
 Curiosidades
Un flag de llama.cpp permite correr un modelo 35B en 8GB de VRAM
Una prueba documentada muestra cómo el flag –n-cpu-moe de llama.cpp descarga los expertos de un modelo Mixture-of-Experts a…





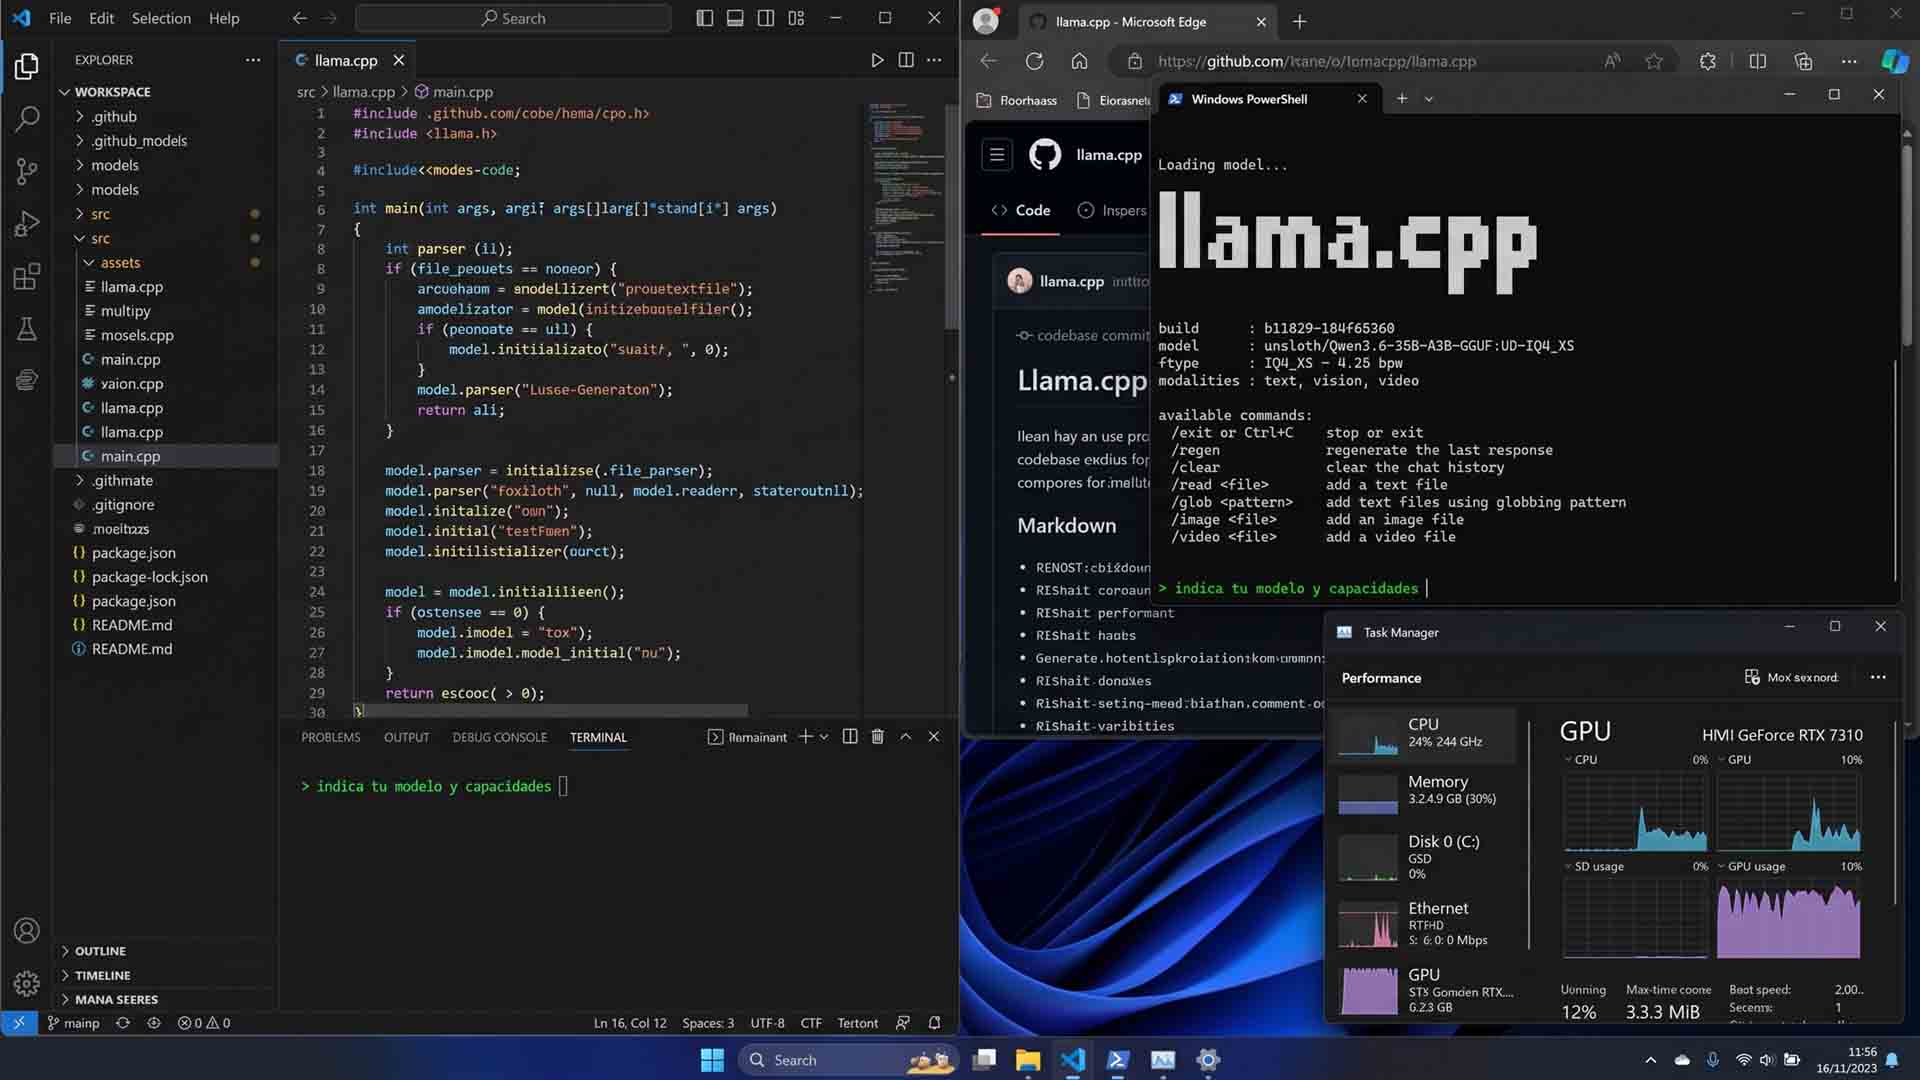
Una prueba documentada muestra cómo el flag –n-cpu-moe de llama.cpp descarga los expertos de un modelo Mixture-of-Experts a la RAM del sistema y multiplica por ocho la velocidad de generación en una GPU de laptop de 8GB. Aquí la guía completa paso a paso para Windows.
Lo más leído en Especificaciones
-
Apps
Claude Duet vs Hermes Agent la carrera del agente de IA proactivo
Anthropic presentó Claude Duet, una app donde Claude actúa como agente proactivo que monitorea apps conectadas y trabaja…
-
Curiosidades
Un flag de llama.cpp permite correr un modelo 35B en 8GB de VRAM
Una prueba documentada muestra cómo el flag –n-cpu-moe de llama.cpp descarga los expertos de un modelo Mixture-of-Experts a…
Anthropic presentó Claude Duet, una app donde Claude actúa como agente proactivo que monitorea apps conectadas y trabaja en segundo plano. Frente a él, Hermes Agent de Nous Research ofrece la alternativa de código abierto para montar un sistema similar con control total.
Lo más leído en Especificaciones
-
Apps
Claude Duet vs Hermes Agent la carrera del agente de IA proactivo
Anthropic presentó Claude Duet, una app donde Claude actúa como agente proactivo que monitorea apps conectadas y trabaja…
-
Curiosidades
Un flag de llama.cpp permite correr un modelo 35B en 8GB de VRAM
Una prueba documentada muestra cómo el flag –n-cpu-moe de llama.cpp descarga los expertos de un modelo Mixture-of-Experts a…
Gobiernos y empresas de todo el mundo corren para corregir dos fallas críticas en PHP reveladas el 21 de octubre de 2026. El conjunto, bautizado PHP2Shell, podría permitir ejecución remota de código sin autenticación y exposición de memoria sensible. Fue descubierto con ayuda de inteligencia artificial.
Lo más leído en Especificaciones
-
Apps
Claude Duet vs Hermes Agent la carrera del agente de IA proactivo
Anthropic presentó Claude Duet, una app donde Claude actúa como agente proactivo que monitorea apps conectadas y trabaja…
-
Curiosidades
Un flag de llama.cpp permite correr un modelo 35B en 8GB de VRAM
Una prueba documentada muestra cómo el flag –n-cpu-moe de llama.cpp descarga los expertos de un modelo Mixture-of-Experts a…
Lo más leído
-
 Consola
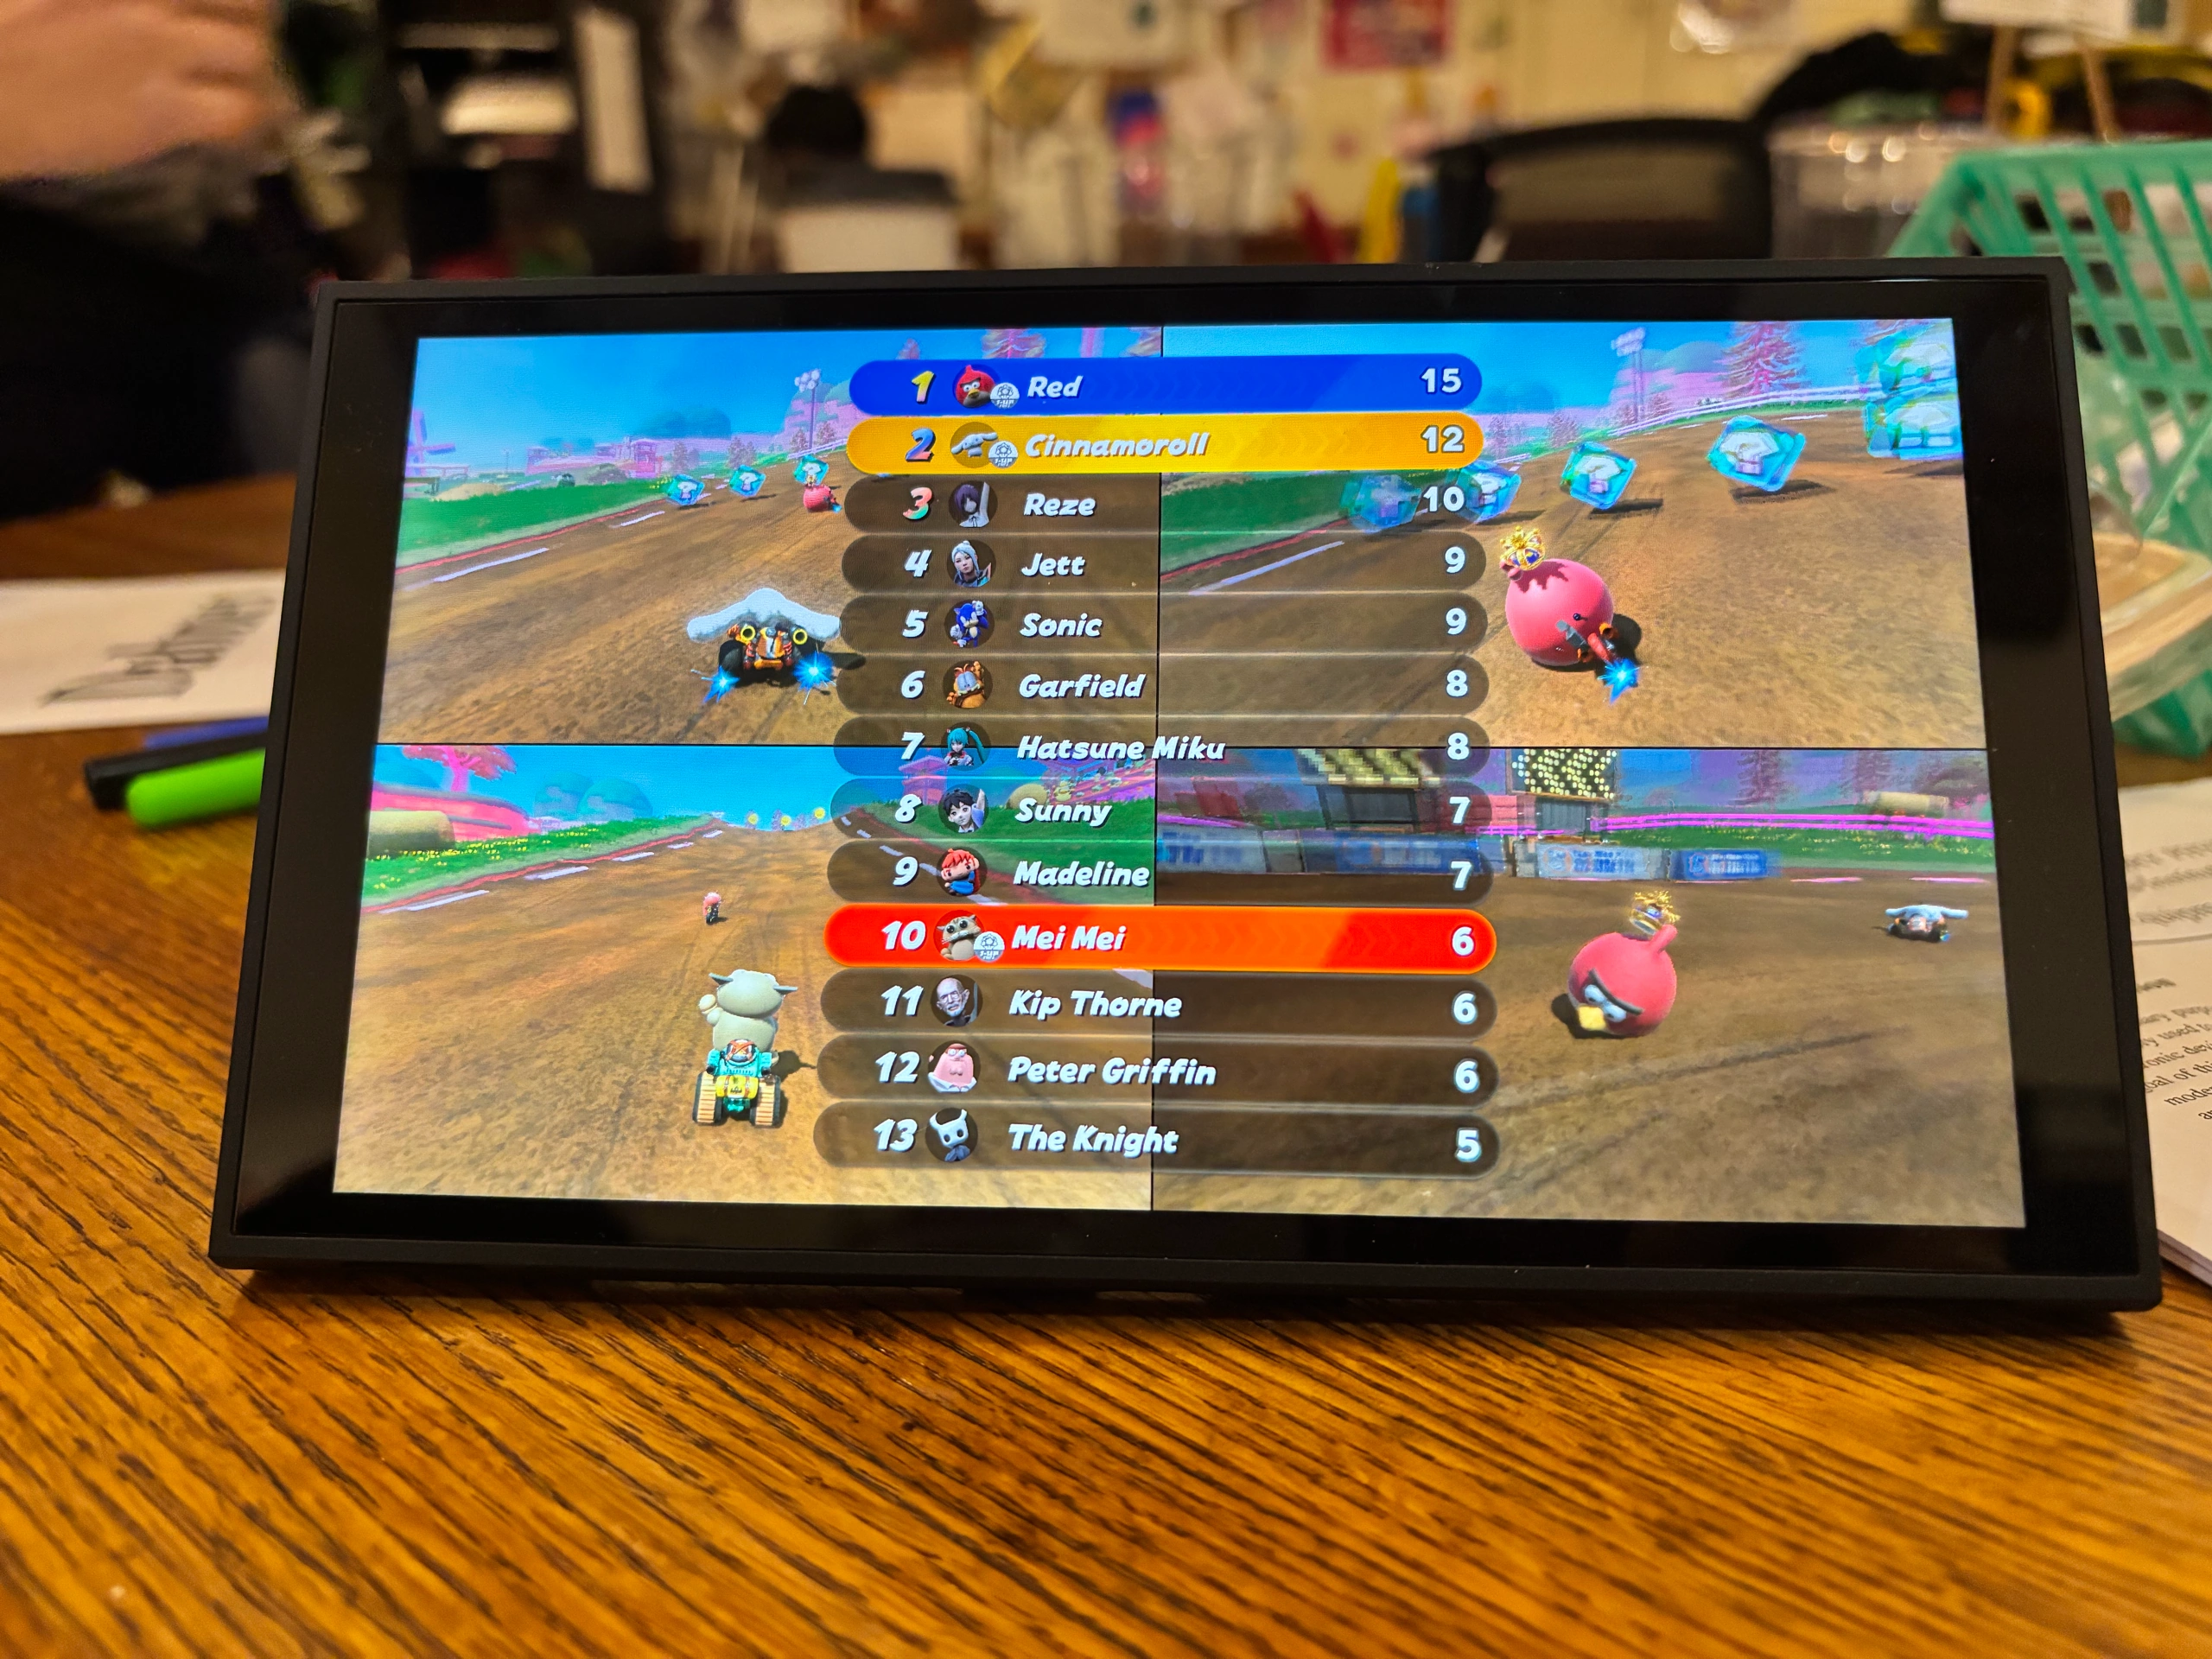
Nintendo Switch 2 fue liberada por primera vez con ayuda de la IA
-
 Entretenimiento
Revisión: Terry’s Terraforming – Planetas en realidad virtual
-
Apps
Claude Duet vs Hermes Agent la carrera del agente de IA proactivo
-
Curiosidades
Un flag de llama.cpp permite correr un modelo 35B en 8GB de VRAM
-
 Desarrolladores
PHP2Shell: vulnerabilidades detectadas con IA afectan 70% de la web
-

 Apps11 años ago
AMPcast, la herramienta de Pandora que permite a los artistas grabar mensajes de audio directamente a sus seguidores
-
 Blogs5 años ago
Conoce los mejores sitios de Torrents para descargar todo tipo de contenidos
-
Android5 años ago
Aprende cómo usar Discord para ver películas con tus amigos
-
Arte y Cultura14 años ago
Colección de fondos de pantalla basados en Super Héroes
-

 Almacenamiento2 años ago
Cómo usar TeraBox: La guía definitiva para aprovechar 1 TB de almacenamiento en la nube
-
Diseño13 años ago
css3ps: plugin que convierte archivos PSD a CSS3
-
Apps9 años ago
Picturethat, app que usa la Realidad Aumentada para visualizar cómo quedarían los cuadros antes de colgarlos
-
Eventos Especiales13 años ago
Especial Día de la Madres: fondos de pantalla especiales para Mamá