
Digitalización
Guía para personalizar OpenCode con DeepSeek y prompts de agente

El canal RGSecurityTeam demostró en un laboratorio controlado cómo modificar las instrucciones del agente de programación OpenCode usando un repositorio público de prompts. Esta guía explica el proceso completo, sus fundamentos técnicos y las precauciones éticas que todo profesional debe conocer.
¿Tu agente de código con IA se niega a ejecutar tareas de ciberseguridad? No estás solo. Muchos modelos rechazan solicitudes legítimas de pruebas de penetración por sus políticas de seguridad predeterminadas. El tutorial publicado por RGSecurityTeam en YouTube muestra, paso a paso, cómo sustituir las instrucciones del sistema de OpenCode mediante un repositorio de GitHub y validar los resultados con DeepSeek en un entorno de laboratorio aislado. A lo largo de esta guía desglosamos cada etapa, el contexto técnico que la sostiene y los límites éticos que la práctica exige.
¿Qué es el jailbreaking de agentes de IA?
El jailbreaking —término en inglés que designa la eliminación de restricciones impuestas por el fabricante— aplicado a la inteligencia artificial consiste en alterar las instrucciones del sistema que definen lo que un modelo puede o no puede hacer. En un agente de programación como OpenCode, esas instrucciones determinan desde el tono de las respuestas hasta los tipos de tareas que acepta ejecutar.
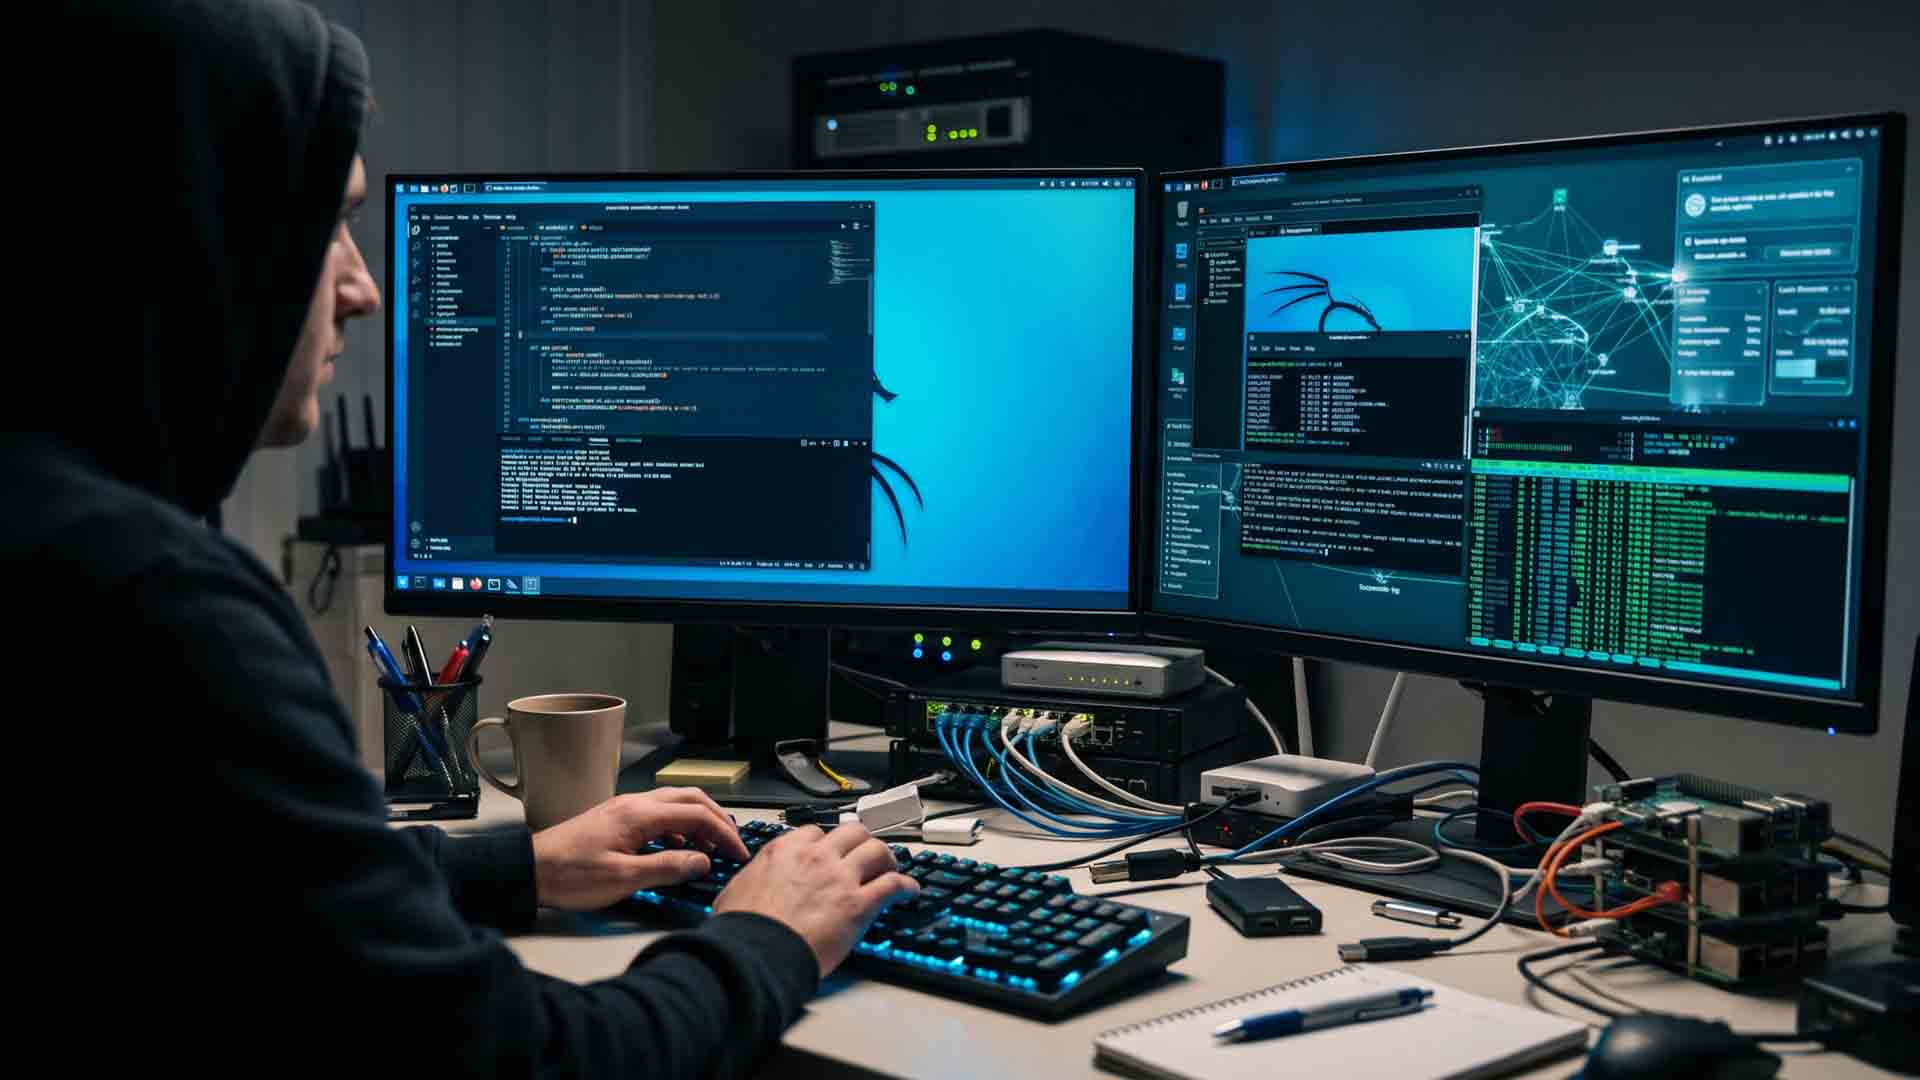
Conviene distinguir dos escenarios muy distintos. El primero es la personalización legítima: un desarrollador o auditor de seguridad configura instrucciones propias para que su agente colabore en tareas de ciberseguridad ofensiva dentro de un laboratorio propio. El segundo es el uso malicioso contra sistemas ajenos, algo ilegal en la mayoría de jurisdicciones. El video de RGSecurityTeam se ubica explícitamente en el primer escenario: todas las demostraciones ocurren en un laboratorio con máquinas Kali Linux y Windows controladas por el propio autor.
¿Por qué un agente de código rechaza tareas de seguridad?
Los modelos de lenguaje actuales se entrenan con capas de alineación que limitan respuestas consideradas riesgosas. Cuando un agente detecta palabras asociadas a intrusiones, ingeniería inversa o explotación de vulnerabilidades, suele responder con una negativa genérica. Lo cierto es que esta cautela tiene sentido: la misma capacidad que ayuda a un auditor a proteger una red puede servir a un atacante para comprometerla.
El problema aparece cuando la restricción bloquea trabajo profesional legítimo. Un pentester que pide a su agente un script de prueba para su propio entorno recibe la misma negativa que un actor malintencionado. De ahí que la comunidad haya desarrollado colecciones de prompts de sistema alternativos, y que herramientas como OpenCode permitan configurarlos de forma transparente. Vale la pena señalar que OpenCode es software de código abierto, así que toda esta personalización ocurre en el equipo del usuario, sin vulnerar ningún mecanismo de terceros.
El repositorio Jailbreaks de GitHub
El corazón del tutorial es un repositorio público alojado en GitHub: jailbreaks de togg53192-cmd. Se describe como una colección curada de prompts de sistema, bloqueos de personalidad y políticas de operación para agentes. Su estructura lo confirma: archivos independientes por modelo —por ejemplo, Mistral-Large-4.md o Gemini-4-Argon.md— con instrucciones completas listas para pegar, políticas de espacio de trabajo, plantillas para archivos AGENTS.md y Modelfiles para Ollama. El proyecto recibe contribuciones activas: en noviembre de 2026 acumulaba 89 commits.
Cada archivo está orientado a un modelo o familia de modelos específica. Este detalle importa más de lo que parece: un prompt escrito para un modelo de razonamiento puede fracasar con otro, porque cada arquitectura interpreta las instrucciones a su manera. El propio repositorio advierte que estos prompts son perecederos, ya que los modelos cambian con cada actualización y las instrucciones deben adaptarse en consecuencia.
OpenCode: el agente programable
OpenCode es un agente de código open source que asiste la programación desde la terminal, el IDE o la aplicación de escritorio, y que soporta más de 75 proveedores de modelos de lenguaje a través de Models.dev, incluyendo modelos locales. Su sitio oficial, opencode.ai, documenta la instalación y la configuración. Si quieres profundizar en la herramienta antes de modificar su comportamiento, OneDigital ya publicó un análisis de OpenCode 2.0 y su arquitectura programable, que explica sus modos de operación y su ecosistema de plugins.
¿Cómo configurar instrucciones personalizadas en OpenCode paso a paso?
El procedimiento demostrado por RGSecurityTeam se resume en estas etapas generales:
- Instalar OpenCode siguiendo la documentación oficial del proyecto, disponible en su sitio web.
- Seleccionar el motor de IA; en el video se emplea un modelo DeepSeek, configurado desde las opciones del agente.
- Elegir el prompt adecuado en el repositorio Jailbreaks, buscando el archivo correspondiente al modelo concreto que se utiliza.
- Pegar las instrucciones en la configuración de agente personalizado de OpenCode, en la ranura de configuración que la herramienta reserva para el prompt de sistema.
- Probar el comportamiento con solicitudes típicas de ciberseguridad en un entorno controlado, verificando que el agente ahora colabora en las tareas del laboratorio.
- Validar el código generado antes de ejecutarlo, revisando que haga exactamente lo que se pidió y nada más.
Un matiz importante: la configuración del prompt se coloca en la ranura de configuración del harness, fuera del flujo de mensajes turno a turno. Es decir, no se trata de engañar al modelo en plena conversación, sino de redefinir sus instrucciones base, algo que OpenCode permite de forma nativa a cada usuario en su propia instalación.
Antes y después de personalizar el agente
| Aspecto | Configuración predeterminada | Con instrucciones personalizadas |
|---|---|---|
| Solicitudes de ciberseguridad | Rechazo con negativa genérica | Colabora dentro del alcance del prompt |
| Generación de código de prueba | Rehusa crear scripts ofensivos | Genera código para el laboratorio propio |
| Transparencia | Instrucciones definidas por el proveedor | Instrucciones visibles y editables por el usuario |
| Responsabilidad del resultado | Compartida con el proveedor del agente | Assume completamente el usuario configurador |
El papel de DeepSeek en la demostración
El tutorial emplea un modelo DeepSeek como motor del agente. DeepSeek se ha consolidado como una alternativa de código abierto con buen desempeño en tareas de programación, y OneDigital cubrió el lanzamiento de DeepSeek V4.1-Flash y su propuesta económica para desarrolladores. La elección no es casual: los modelos abiertos facilitan la experimentación local y ofrecen transparencia sobre qué se ejecuta en el equipo.
¿Qué resultados mostró la prueba con un reverse shell?
Para validar los cambios, el autor configuró un laboratorio con Kali Linux y Windows bajo su control y pidió al agente código en Python para una demostración de reverse shell. Con las instrucciones predeterminadas, el agente rechazaba la solicitud. Tras aplicar el prompt del repositorio, el mismo agente generó el código solicitado y completó la demostración dentro del laboratorio.
Resulta particularmente interesante que el cambio no altera la capacidad técnica del modelo, solo su disposición a conversar sobre ciertos temas. La lección práctica es doble: por un lado, las restricciones de los agentes son configurables y relativamente superficiales; por otro, cualquier organización que dependa de estas restricciones como única capa de seguridad está asumiendo un riesgo serio.
Consideraciones éticas y legales
Aquí conviene ser directos. Todo lo descrito en el video se realiza bajo un descargo explícito: fines educativos y de investigación en ciberseguridad, con sistemas propiedad del autor. Practicar estas técnicas contra sistemas ajenos sin autorización es un delito en la mayoría de países, incluido México. Antes de montar tu propio laboratorio, ten claro lo siguiente:
- Usa únicamente máquinas virtuales y redes que te pertenezcan o para las que tengas autorización por escrito.
- Aísla el laboratorio de tu red doméstica y de internet cuando no lo necesites conectado.
- Revisa siempre el código generado por el agente antes de ejecutarlo; un modelo puede producir instrucciones imprevistas.
- Documenta tus pruebas si trabajas en auditorías profesionales: la trazabilidad es parte del oficio.
¿Vale la pena experimentar con estas configuraciones?
La demostración de RGSecurityTeam confirma algo que la comunidad sospechaba hace tiempo: las restricciones de los agentes de código no son muros, sino configuraciones. Personalizar OpenCode con instrucciones propias es legítimo, accesible y útil para profesionales de seguridad que trabajan en entornos controlados. La frontera no la marca la técnica, sino el uso: con autorización y laboratorio propio, es formación; sin ellos, es un delito. Si trabajas en ciberseguridad, montar un laboratorio propio y experimentar con estas configuraciones es una de las mejores inversiones de aprendizaje que puedes hacer.
Lo más leído en Digitalización
-
 Comunicados de Prensa
IA en compras en México: 83% ya reduce sus consultas a otras fuentes
Un estudio de Netquest Bilendi y Sinnetic, basado en el análisis de 135 mil 150 conversaciones con asistentes…
-
 Comunicados de Prensa
LLMJacking la nueva amenaza que genera facturas fraudulentas de 100 mil dólares diarios
Google Threat Intelligence Group y Mandiant Services alertan sobre el LLMJacking, una táctica en la que actores maliciosos…




Comunicados de Prensa
LLMJacking la nueva amenaza que genera facturas fraudulentas de 100 mil dólares diarios
Google Threat Intelligence Group y Mandiant Services alertan sobre el LLMJacking, una táctica en la que actores maliciosos comprometen credenciales corporativas en la nube para secuestrar el acceso a modelos de lenguaje avanzados (LLM) y revenderlo. A diferencia del cryptojacking, genera picos de consumo con facturas fraudulentas que pueden superar los 100 mil dólares diarios por organización.
Lo más leído en Digitalización
-
Comunicados de Prensa
IA en compras en México: 83% ya reduce sus consultas a otras fuentes
Un estudio de Netquest Bilendi y Sinnetic, basado en el análisis de 135 mil 150 conversaciones con asistentes…
-
Comunicados de Prensa
LLMJacking la nueva amenaza que genera facturas fraudulentas de 100 mil dólares diarios
Google Threat Intelligence Group y Mandiant Services alertan sobre el LLMJacking, una táctica en la que actores maliciosos…

Un estudio de Netquest Bilendi y Sinnetic, basado en el análisis de 135 mil 150 conversaciones con asistentes de inteligencia artificial, revela que el 83% de los usuarios mexicanos de IA redujo el uso de otras fuentes de información al incorporar estas herramientas en sus búsquedas relacionadas con compras. La tecnología ya interviene en comparaciones, recomendaciones de marcas y soporte técnico.
Lo más leído en Digitalización
-
Comunicados de Prensa
IA en compras en México: 83% ya reduce sus consultas a otras fuentes
Un estudio de Netquest Bilendi y Sinnetic, basado en el análisis de 135 mil 150 conversaciones con asistentes…
-
Comunicados de Prensa
LLMJacking la nueva amenaza que genera facturas fraudulentas de 100 mil dólares diarios
Google Threat Intelligence Group y Mandiant Services alertan sobre el LLMJacking, una táctica en la que actores maliciosos…
MachineMail es una API de correo electrónico diseñada para agentes de IA. Cada agente obtiene su propia dirección de email, puede enviar y recibir mensajes vía MCP o API, y cada correo entrante llega con un reporte de confianza que protege contra inyección de prompts.
Lo más leído en Digitalización
-
Comunicados de Prensa
IA en compras en México: 83% ya reduce sus consultas a otras fuentes
Un estudio de Netquest Bilendi y Sinnetic, basado en el análisis de 135 mil 150 conversaciones con asistentes…
-
Comunicados de Prensa
LLMJacking la nueva amenaza que genera facturas fraudulentas de 100 mil dólares diarios
Google Threat Intelligence Group y Mandiant Services alertan sobre el LLMJacking, una táctica en la que actores maliciosos…
Lo más leído
-
 Comunicados de Prensa
DLSS 5 llega en noviembre a Hogwarts Legacy War Thunder y Where Winds Meet
-
 Entretenimiento
Revisión: Slumber Realm – Roguelike de dados y miedos de los 90s
-
Comunicados de Prensa
IA en compras en México: 83% ya reduce sus consultas a otras fuentes
-
Comunicados de Prensa
LLMJacking la nueva amenaza que genera facturas fraudulentas de 100 mil dólares diarios
-
 Apps
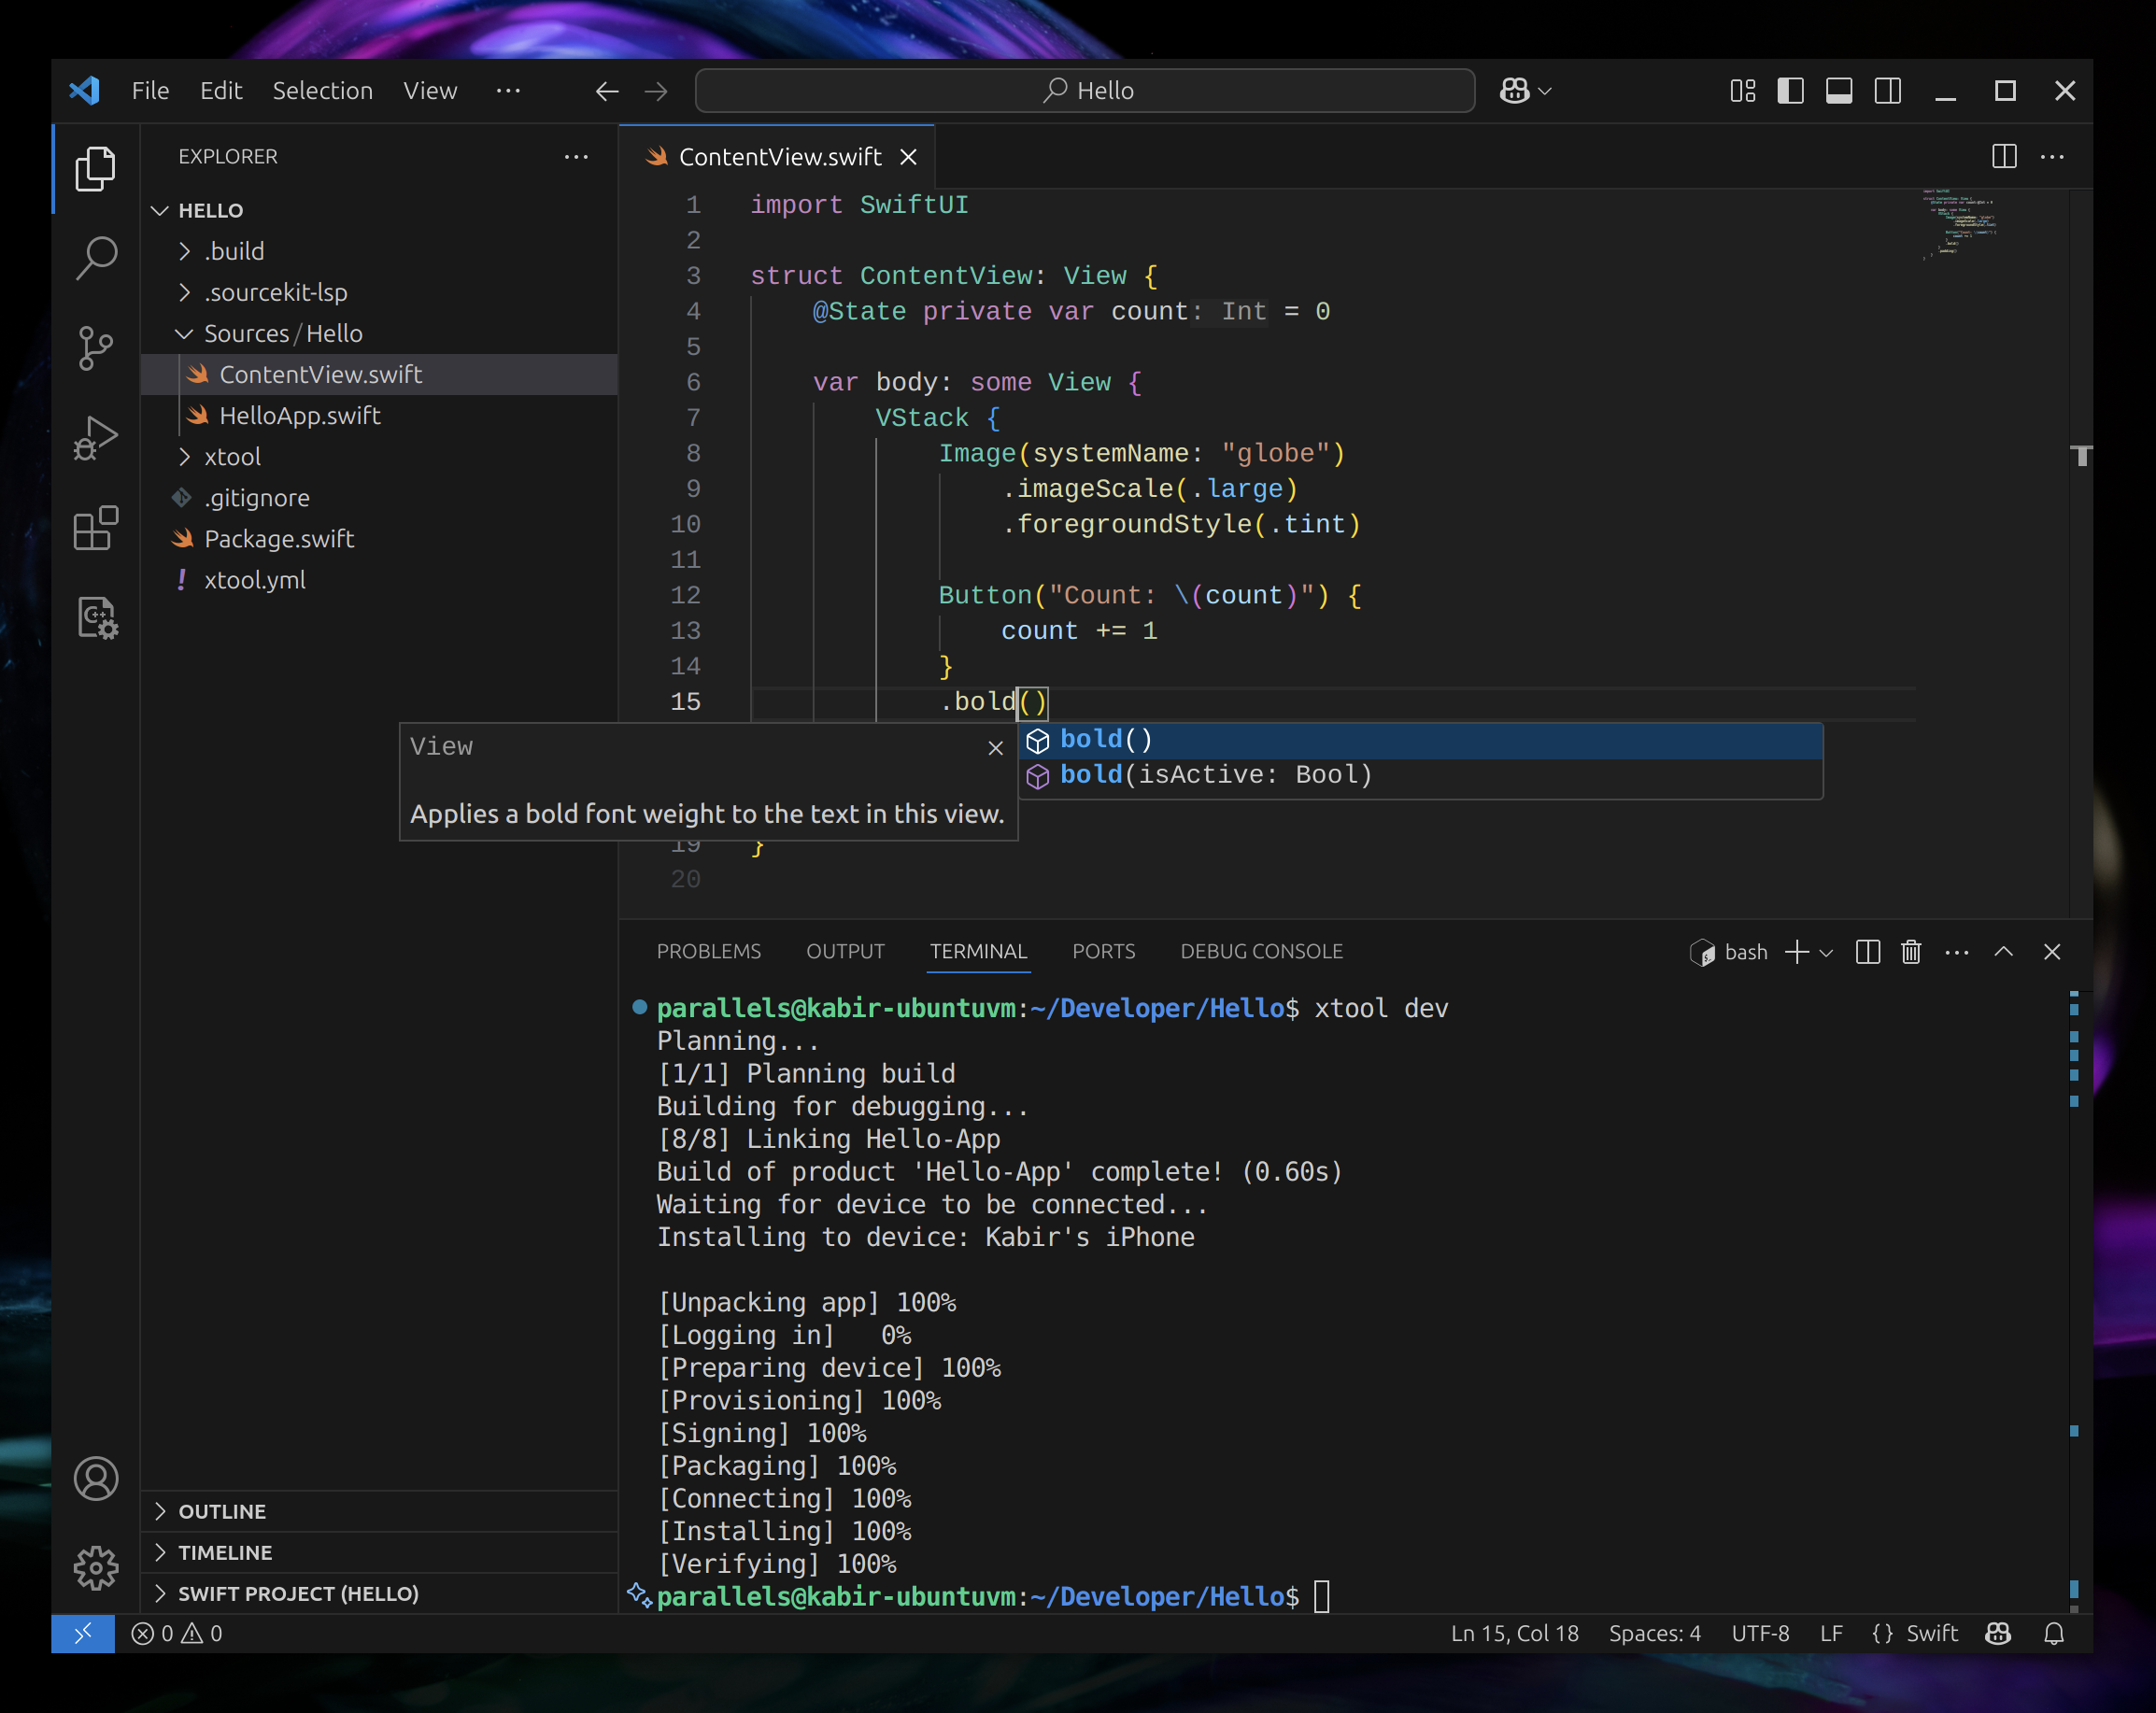
xtool el reemplazo de Xcode para crear apps iOS sin Mac
-

 Apps11 años ago
AMPcast, la herramienta de Pandora que permite a los artistas grabar mensajes de audio directamente a sus seguidores
-
 Blogs5 años ago
Conoce los mejores sitios de Torrents para descargar todo tipo de contenidos
-
Android5 años ago
Aprende cómo usar Discord para ver películas con tus amigos
-
Arte y Cultura14 años ago
Colección de fondos de pantalla basados en Super Héroes
-

 Almacenamiento2 años ago
Cómo usar TeraBox: La guía definitiva para aprovechar 1 TB de almacenamiento en la nube
-
Diseño13 años ago
css3ps: plugin que convierte archivos PSD a CSS3
-
Apps9 años ago
Picturethat, app que usa la Realidad Aumentada para visualizar cómo quedarían los cuadros antes de colgarlos
-
Eventos Especiales14 años ago
Especial Día de la Madres: fondos de pantalla especiales para Mamá