

Almacenamiento
Cómo ahorrar costos en proyectos de IA sin sacrificar calidad

Reducir gastos en proyectos de inteligencia artificial no significa renunciar a resultados sólidos. En muchos equipos, el problema no es la falta de capacidad técnica, sino el uso indiscriminado de modelos caros para tareas que no lo requieren. Cuando el mismo modelo se utiliza para planear, leer archivos, revisar logs, investigar en la web, generar código, escribir pruebas y verificar resultados, el costo por tokens crece con rapidez y la eficiencia real del flujo de trabajo se deteriora.
La alternativa más razonable no consiste en abandonar por completo herramientas como Claude Code, sino en reservarlas para los momentos donde realmente aportan valor: diseño de arquitectura, razonamiento complejo, tareas ambiguas o sesiones largas de depuración con contexto amplio. Para el resto del trabajo diario, un conjunto de modelos locales especializados puede absorber buena parte de la carga con un costo operativo mucho más predecible.
Ese es el principio central de este enfoque: usar modelos locales para el trabajo repetitivo, estructurado o acotado, y recurrir a modelos frontier solo cuando el problema lo justifique. Bien implementado, este esquema permite bajar el gasto sin deteriorar la calidad de entrega.
¿Por qué los modelos frontier pueden encarecer el trabajo diario?
Herramientas como Claude Code siguen siendo muy valiosas, pero su costo no debe evaluarse solo por la suscripción o por el nombre del modelo. El gasto real aparece cuando se combinan contexto largo, múltiples iteraciones, uso de herramientas, búsquedas web, reasoning extendido y subagentes. En otras palabras, no se paga únicamente por “preguntar algo”, sino por mantener una conversación técnica cada vez más pesada y más instrumentada.
Además, Claude Code no siempre se factura de la misma manera. Puede utilizarse dentro de planes como Pro, Max, Team o Enterprise, pero también puede consumir usage credits o funcionar bajo un esquema más cercano al cobro por uso. En despliegues empresariales, la propia documentación de Claude Code advierte que el costo por desarrollador puede variar ampliamente según el tamaño del repositorio, el modelo elegido y la forma de uso. Por eso, pensar que todo flujo de trabajo con IA debe correr sobre el mismo modelo premium suele conducir a una arquitectura cara antes de ser realmente eficiente.
Hay otra razón práctica: muchas tareas cotidianas no necesitan razonamiento de frontera. Buscar el archivo donde vive un componente roto, proponer una prueba unitaria, resumir un log o transformar una consulta en un plan JSON son acciones útiles, pero no siempre ameritan el modelo más costoso disponible. Ahí es donde los modelos locales bien elegidos ofrecen una relación costo-beneficio mucho más sensata.
La lógica correcta: especialización en lugar de sobrecapacidad
El enfoque más efectivo se parece más a un equipo técnico que a un asistente único. Un perfil organiza la tarea, otro escribe código, otro investiga, otro automatiza y otro valida. No todos necesitan el mismo nivel de inteligencia ni el mismo contexto. De hecho, forzar a un solo modelo a cargar con todo suele generar más costo, más ruido y menos trazabilidad.
Con herramientas como Ollama y n8n, es posible construir una arquitectura local o híbrida donde cada modelo asume un rol específico. Conviene precisar que n8n no es simplemente “open source” en el sentido tradicional: hoy se presenta como una plataforma self-hosted y fair-code, algo importante si el artículo busca ser técnicamente preciso.
Una configuración razonable puede verse así:
- Qwen3.5 2B como router, encargado de clasificar la solicitud y devolver un plan estructurado.
- Qwen2.5-Coder 7B como especialista en generación, refactorización y corrección de código.
- Qwen3.5 9B como modelo para tareas de investigación, análisis de datos o automatización supervisada.
- Qwen3.5 4B como verificador final, centrado en comprobar si el resultado cumple los criterios de éxito.
Este reparto tiene una ventaja decisiva: cada modelo opera con un contexto más pequeño y relevante. Si una parte falla, no hace falta reiniciar toda la conversación ni reprocesar el mismo paquete de información. Solo se repite el bloque implicado.
Una observación importante: local no siempre significa completamente offline
Aquí conviene hacer una corrección conceptual importante. Si uno de los workers consulta la web, entonces el sistema ya no es totalmente local: es híbrido. Eso no invalida el enfoque, pero sí obliga a describirlo con precisión. Un flujo puede ser local para código, pruebas, análisis de archivos y verificación, y al mismo tiempo usar acceso web controlado para tareas de investigación pública. Lo importante es separar claramente ambos planos.
En entornos sensibles, la recomendación editorial más sólida es esta: los workers conectados a la web deben quedar reservados para documentación pública, búsqueda de librerías, changelogs o referencias abiertas. El código privado, los datos internos y los artefactos confidenciales deben permanecer en el circuito local.
Arquitectura práctica de bajo costo
En términos operativos, la arquitectura se puede resumir en cuatro etapas:
- El router recibe la solicitud y la convierte en una tarea estructurada.
- El worker especializado ejecuta la parte correspondiente: código, investigación, datos o automatización.
- n8n orquesta herramientas externas o internas bajo reglas específicas.
- El verificador compara el resultado con criterios de éxito y decide si se acepta, se corrige o se reintenta.
Esto reduce el gasto por dos vías. Primero, evita usar un modelo caro para tareas simples. Segundo, impide que todo el contexto del proyecto se arrastre innecesariamente en cada turno. A nivel financiero, el ahorro no significa “IA gratis”, sino sustituir costos variables por tokens por una estructura más controlada de hardware, energía, almacenamiento y mantenimiento.
Ejemplos adicionales del flujo de trabajo
El mejor modo de entender este esquema es verlo en tareas concretas. A continuación, varios flujos donde la especialización mejora costos y mantiene resultados aceptables.
Ejemplo 1: Corregir un botón roto en una aplicación web
Un desarrollador detecta que el botón de pago dejó de responder después de una actualización de frontend.
- El router recibe la instrucción: “el botón de checkout no funciona en móvil”.
- Clasifica la tarea como código y devuelve un JSON con posibles archivos relevantes, por ejemplo componentes de checkout, estilos móviles y lógica de eventos.
- El worker de código abre solo esos archivos, inspecciona el flujo y propone un cambio mínimo.
- n8n puede disparar una prueba local, un linter o una compilación controlada.
- El verificador revisa si el botón vuelve a responder, si no rompió el layout y si la compilación sigue limpia.
En este flujo, un modelo frontier no es indispensable. El problema está acotado y el costo se mantiene bajo porque el contexto no incluye todo el repositorio ni una conversación histórica extensa.
Ejemplo 2: Generar pruebas unitarias para una función nueva
El equipo añade una función de validación de formularios y necesita cobertura mínima antes del merge.
- El router clasifica la tarea como código y detecta que el objetivo principal es generar pruebas.
- El worker de código lee la función, identifica casos esperados y escribe los tests.
- n8n ejecuta la suite de pruebas en un entorno controlado.
- Si falla una prueba, el verificador devuelve el error exacto al worker para un segundo intento.
- Solo si el segundo intento también falla se eleva el caso a revisión humana o a un modelo más potente.
La ventaja aquí no está solo en el ahorro, sino en la disciplina del flujo. El sistema no “conversa sin fin”: produce, prueba y verifica.
Ejemplo 3: Investigar una librería antes de adoptarla
El equipo quiere decidir si conviene migrar a una nueva librería de autenticación.
- El router identifica una tarea de investigación.
- El worker de research consulta documentación pública, changelogs, issues conocidos y ejemplos de implementación.
- Resume ventajas, riesgos, compatibilidad y posibles impactos en el stack actual.
- El verificador comprueba si el resumen cubre criterios concretos: compatibilidad, seguridad, mantenimiento y complejidad de migración.
Aquí el sistema ya no es 100% local, porque entra la web. Sin embargo, sigue siendo mucho más económico que lanzar cada consulta sobre un modelo frontier durante toda la investigación. El modelo caro puede reservarse únicamente para la decisión final si el cambio tiene implicaciones estratégicas.
Ejemplo 4: Analizar logs de error y proponer la causa raíz
Un servicio empieza a fallar de forma intermitente y el equipo exporta logs para revisarlos fuera de producción.
- El router clasifica la entrada como datos o código, según el tipo de análisis necesario.
- El worker de datos genera un script en Python para agrupar excepciones, contar incidencias y detectar patrones horarios o por endpoint.
- n8n ejecuta el script y devuelve una salida resumida.
- El worker de código usa ese resumen para relacionar el patrón con módulos concretos del repositorio.
- El verificador valida que la hipótesis esté apoyada por evidencia y no solo por inferencia textual.
Este flujo es especialmente útil porque separa el análisis estadístico del análisis semántico. Un solo modelo grande haría ambas cosas con más contexto y mayor costo. Aquí cada etapa recibe solo lo que necesita.
Ejemplo 5: Automatizar una tarea repetitiva de mantenimiento
El equipo necesita renombrar archivos, mover carpetas temporales y ejecutar una secuencia segura de comandos de limpieza antes de una release.
- El router clasifica la solicitud como automatización.
- El worker correspondiente no ejecuta comandos arbitrarios, sino que llama acciones preaprobadas en n8n.
- n8n realiza únicamente operaciones permitidas: mover, copiar, borrar temporales, generar respaldos o disparar scripts concretos.
- El verificador comprueba que el estado final coincida con el objetivo esperado.
La ganancia aquí no es solo económica. También hay control operativo. El modelo no recibe poder ilimitado sobre el sistema; actúa dentro de un conjunto restringido de herramientas.
Ejemplo 6: Documentar cambios después de un refactor
Tras reorganizar módulos de un proyecto, el equipo necesita actualizar documentación interna y notas de release.
- El router detecta una tarea de documentación, que puede correr sobre el worker de código o de investigación según el flujo elegido.
- El modelo revisa diffs, nombres de archivos y cambios funcionales.
- Genera un resumen técnico, una versión para changelog y otra más breve para stakeholders internos.
- El verificador revisa que no se inventen cambios inexistentes y que la documentación mantenga consistencia con el código real.
Este tipo de trabajo suele consumir muchos tokens en plataformas externas porque mezcla contexto, lenguaje natural y revisión incremental. En local, el costo marginal es mucho más estable.
Implementación base
Para un laboratorio pequeño o un equipo que quiere probar este enfoque, el punto de partida es bastante directo.
Primero, se instala Ollama para servir los modelos localmente. Después, se monta n8n como capa de orquestación. A partir de ahí, se descargan los modelos especializados y se crean flujos con reglas explícitas.
ollama pull qwen3.5:2b
ollama pull qwen2.5-coder:7b
ollama pull qwen3.5:9b
ollama pull qwen3.5:4b
El router puede trabajar con temperatura baja y salida JSON estricta. Los workers técnicos deben operar con permisos mínimos y herramientas delimitadas. El verificador debe evaluar criterios concretos, no impresiones vagas. Y, sobre todo, conviene limitar los reintentos automáticos para evitar bucles costosos o resultados engañosamente plausibles.
Ventajas reales de este enfoque
La primera ventaja es el control de costos. No porque el entorno local elimine todos los gastos, sino porque evita que cada tarea cotidiana consuma tokens premium. La segunda es la trazabilidad: con n8n resulta mucho más sencillo ver qué modelo hizo qué, con qué entrada y con qué resultado. La tercera es la modularidad: si un worker funciona mal, se reemplaza ese bloque sin rediseñar toda la arquitectura.
También hay un beneficio estratégico menos obvio. Un equipo que aprende a dividir bien las tareas termina entendiendo mejor su propio proceso. Y esa claridad, por sí misma, mejora la calidad del trabajo con o sin IA.
Cuándo sigue teniendo sentido usar Claude Code o modelos frontier
Sería un error vender este enfoque como reemplazo absoluto. Los modelos frontier siguen siendo superiores cuando el problema es ambiguo, cuando hace falta planificar una arquitectura desde cero, cuando se requiere un nivel de juicio más alto o cuando el repositorio, el objetivo y las restricciones forman una mezcla difícil de encapsular en workers pequeños.
También siguen siendo útiles cuando el hardware local es insuficiente o cuando la velocidad de implementación importa más que la optimización del costo. En esos casos, la mejor solución no es elegir un bando, sino adoptar una estrategia híbrida: local para el trabajo repetitivo, frontier para la excepción difícil.
Conclusión
Ahorrar costos en proyectos de IA sin sacrificar calidad sí es posible, pero no a partir de slogans, sino de arquitectura. El error habitual consiste en usar un modelo premium para todo. La alternativa más sensata es diseñar un sistema donde cada tarea caiga en el nivel de inteligencia que realmente necesita.
Con Ollama, n8n y modelos como Qwen3.5 o Qwen2.5-Coder, es viable construir flujos locales o híbridos capaces de absorber una parte importante del trabajo diario de desarrollo. No sustituyen por completo a Claude Code, pero sí pueden recortar de forma sustancial el gasto innecesario y, en muchos casos, mejorar la visibilidad y el control del proceso.
La promesa real no es “hacerlo gratis”, sino operar con más criterio. Y, en este momento, esa diferencia ya empieza a ser más importante que la potencia bruta del modelo.






Desactivar funciones de inteligencia artificial que trabajan directamente en el dispositivo puede liberar espacio real en el almacenamiento interno, pero conviene hacerlo con expectativas precisas.
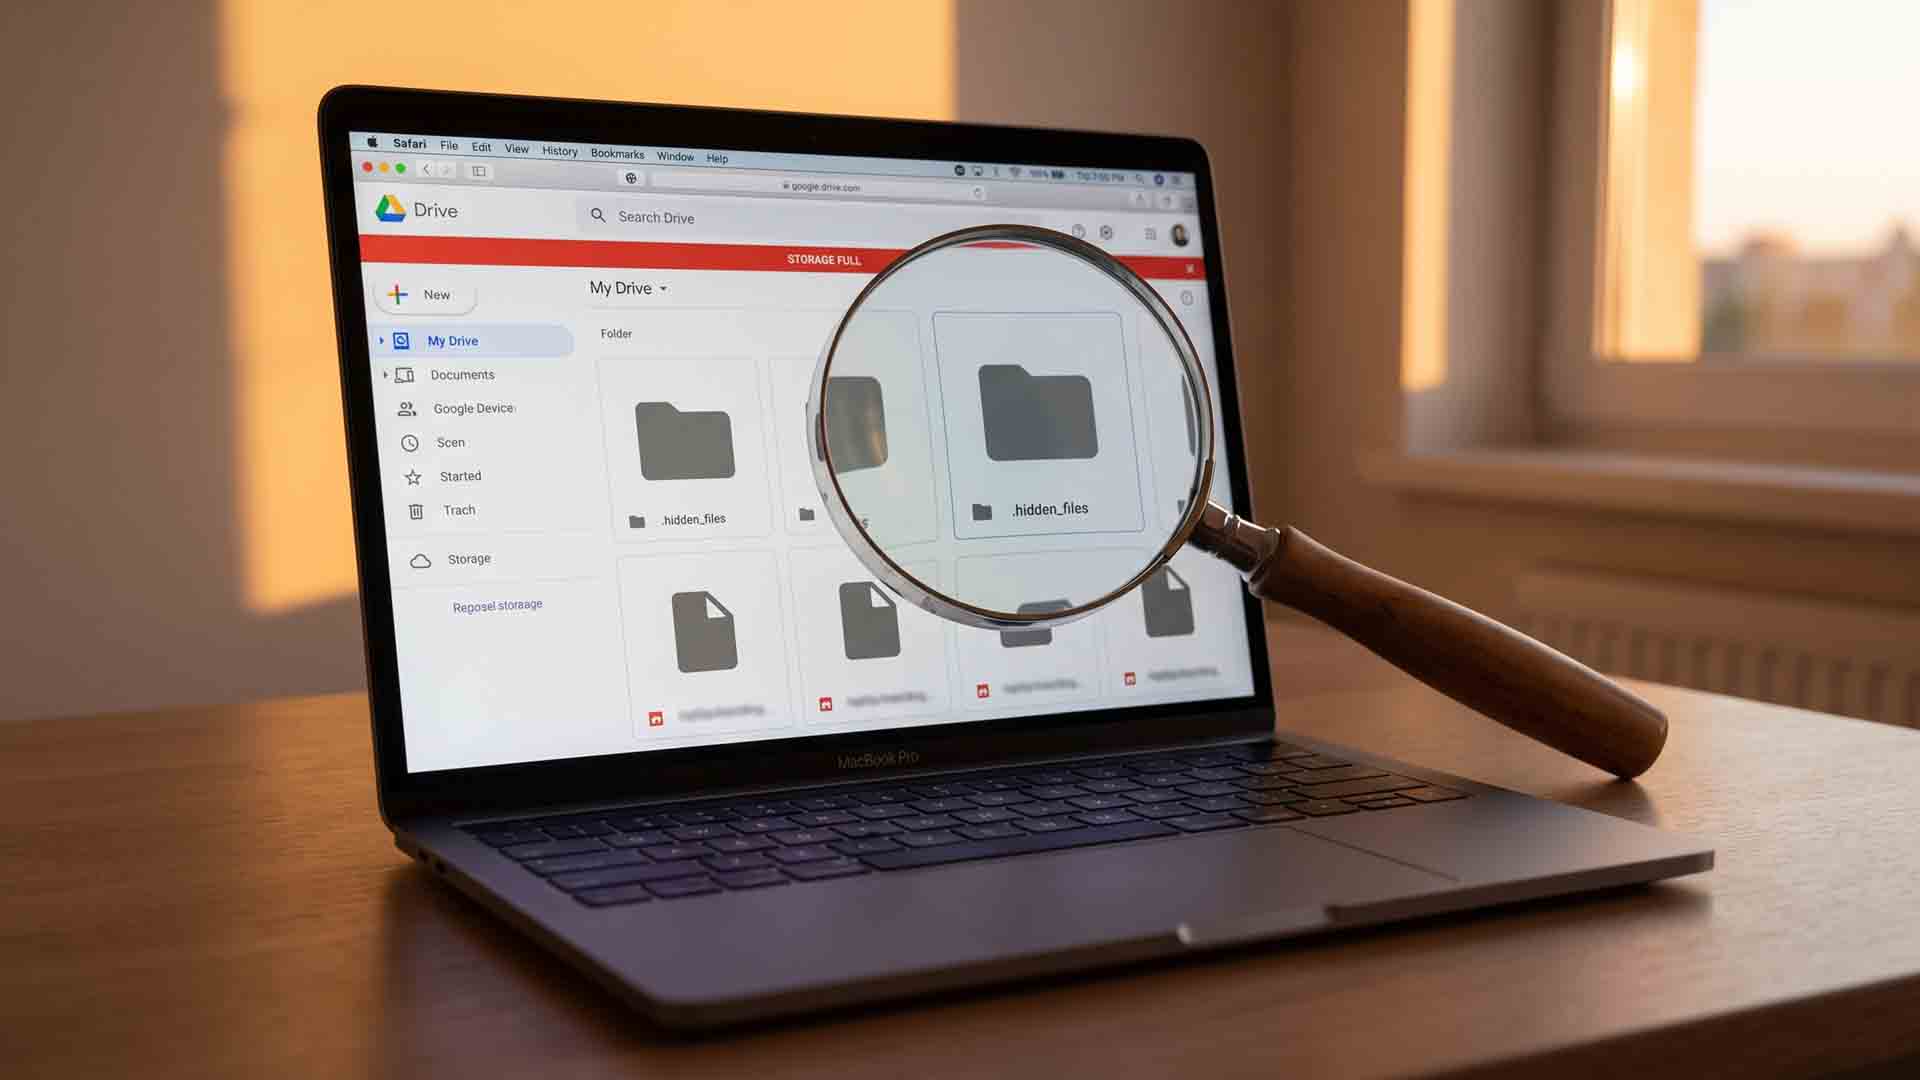
Google ofrece 15 GB gratuitos para Gmail, Drive y Photos, pero muchos usuarios cometen el error de eliminar fotos primero. El problema rara vez está en tu galería: los archivos más pesados suelen esconderse en áreas que el panel principal de almacenamiento ignora. La solución comienza en una página que Google no promociona: el Gestor de Almacenamiento de Google One, donde verás todo tu espacio usado en un solo lugar.

La organización de archivos de audio y video suele ser una tarea tediosa cuando las bibliotecas personales crecen sin control. Esta revisión analiza en profundidad SurSort Media Manager, un programa de escritorio para Windows y Mac desarrollado por Nabla Mind, enfocado en clasificar, etiquetar y proteger colecciones multimedia sin depender de servicios en la nube.
-

 Apps11 años ago
AMPcast, la herramienta de Pandora que permite a los artistas grabar mensajes de audio directamente a sus seguidores
-
 Blogs5 años ago
Conoce los mejores sitios de Torrents para descargar todo tipo de contenidos
-
Android5 años ago
Aprende cómo usar Discord para ver películas con tus amigos
-
Arte y Cultura14 años ago
Colección de fondos de pantalla basados en Super Héroes
-

 Almacenamiento2 años ago
Cómo usar TeraBox: La guía definitiva para aprovechar 1 TB de almacenamiento en la nube
-
Diseño13 años ago
css3ps: plugin que convierte archivos PSD a CSS3
-
Apps9 años ago
Picturethat, app que usa la Realidad Aumentada para visualizar cómo quedarían los cuadros antes de colgarlos
-
Eventos Especiales13 años ago
Especial Día de la Madres: fondos de pantalla especiales para Mamá