
Digitalización
Perplexica: guía completa de instalación y uso del motor de búsqueda con IA local con Ollama

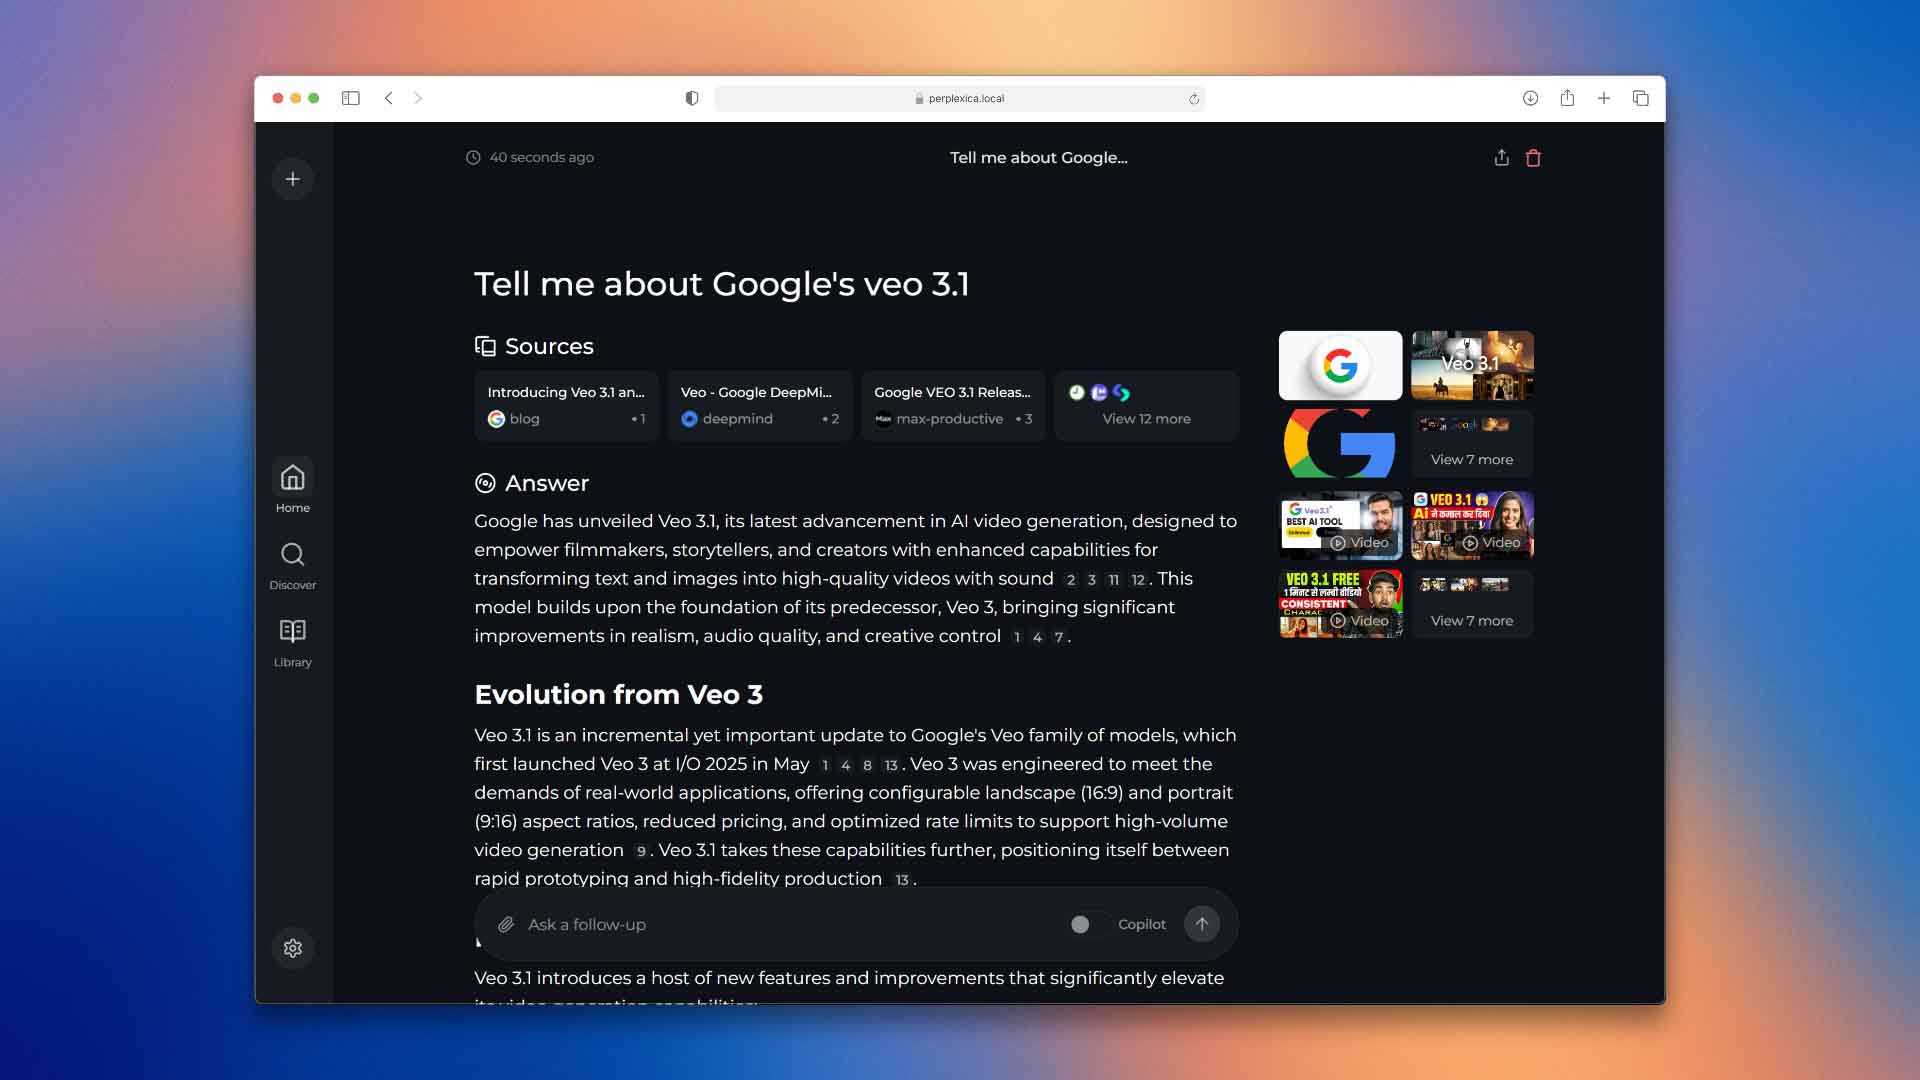
Perplexica es un motor de búsqueda con IA de código abierto que corre en tu equipo con Ollama y Docker, sin suscripción ni rastreo de datos.
Perplexica es una alternativa de código abierto a Perplexity AI que funciona directamente en tu equipo, sin enviar consultas a servidores externos y sin costo de suscripción. Con más de 30,600 estrellas en GitHub bajo licencia MIT, este proyecto acerca la búsqueda con inteligencia artificial local a cualquier persona con conocimientos técnicos básicos. La versión actual es la v1.12.1, publicada en diciembre de 2025.
¿Qué es Perplexica y por qué usarla?
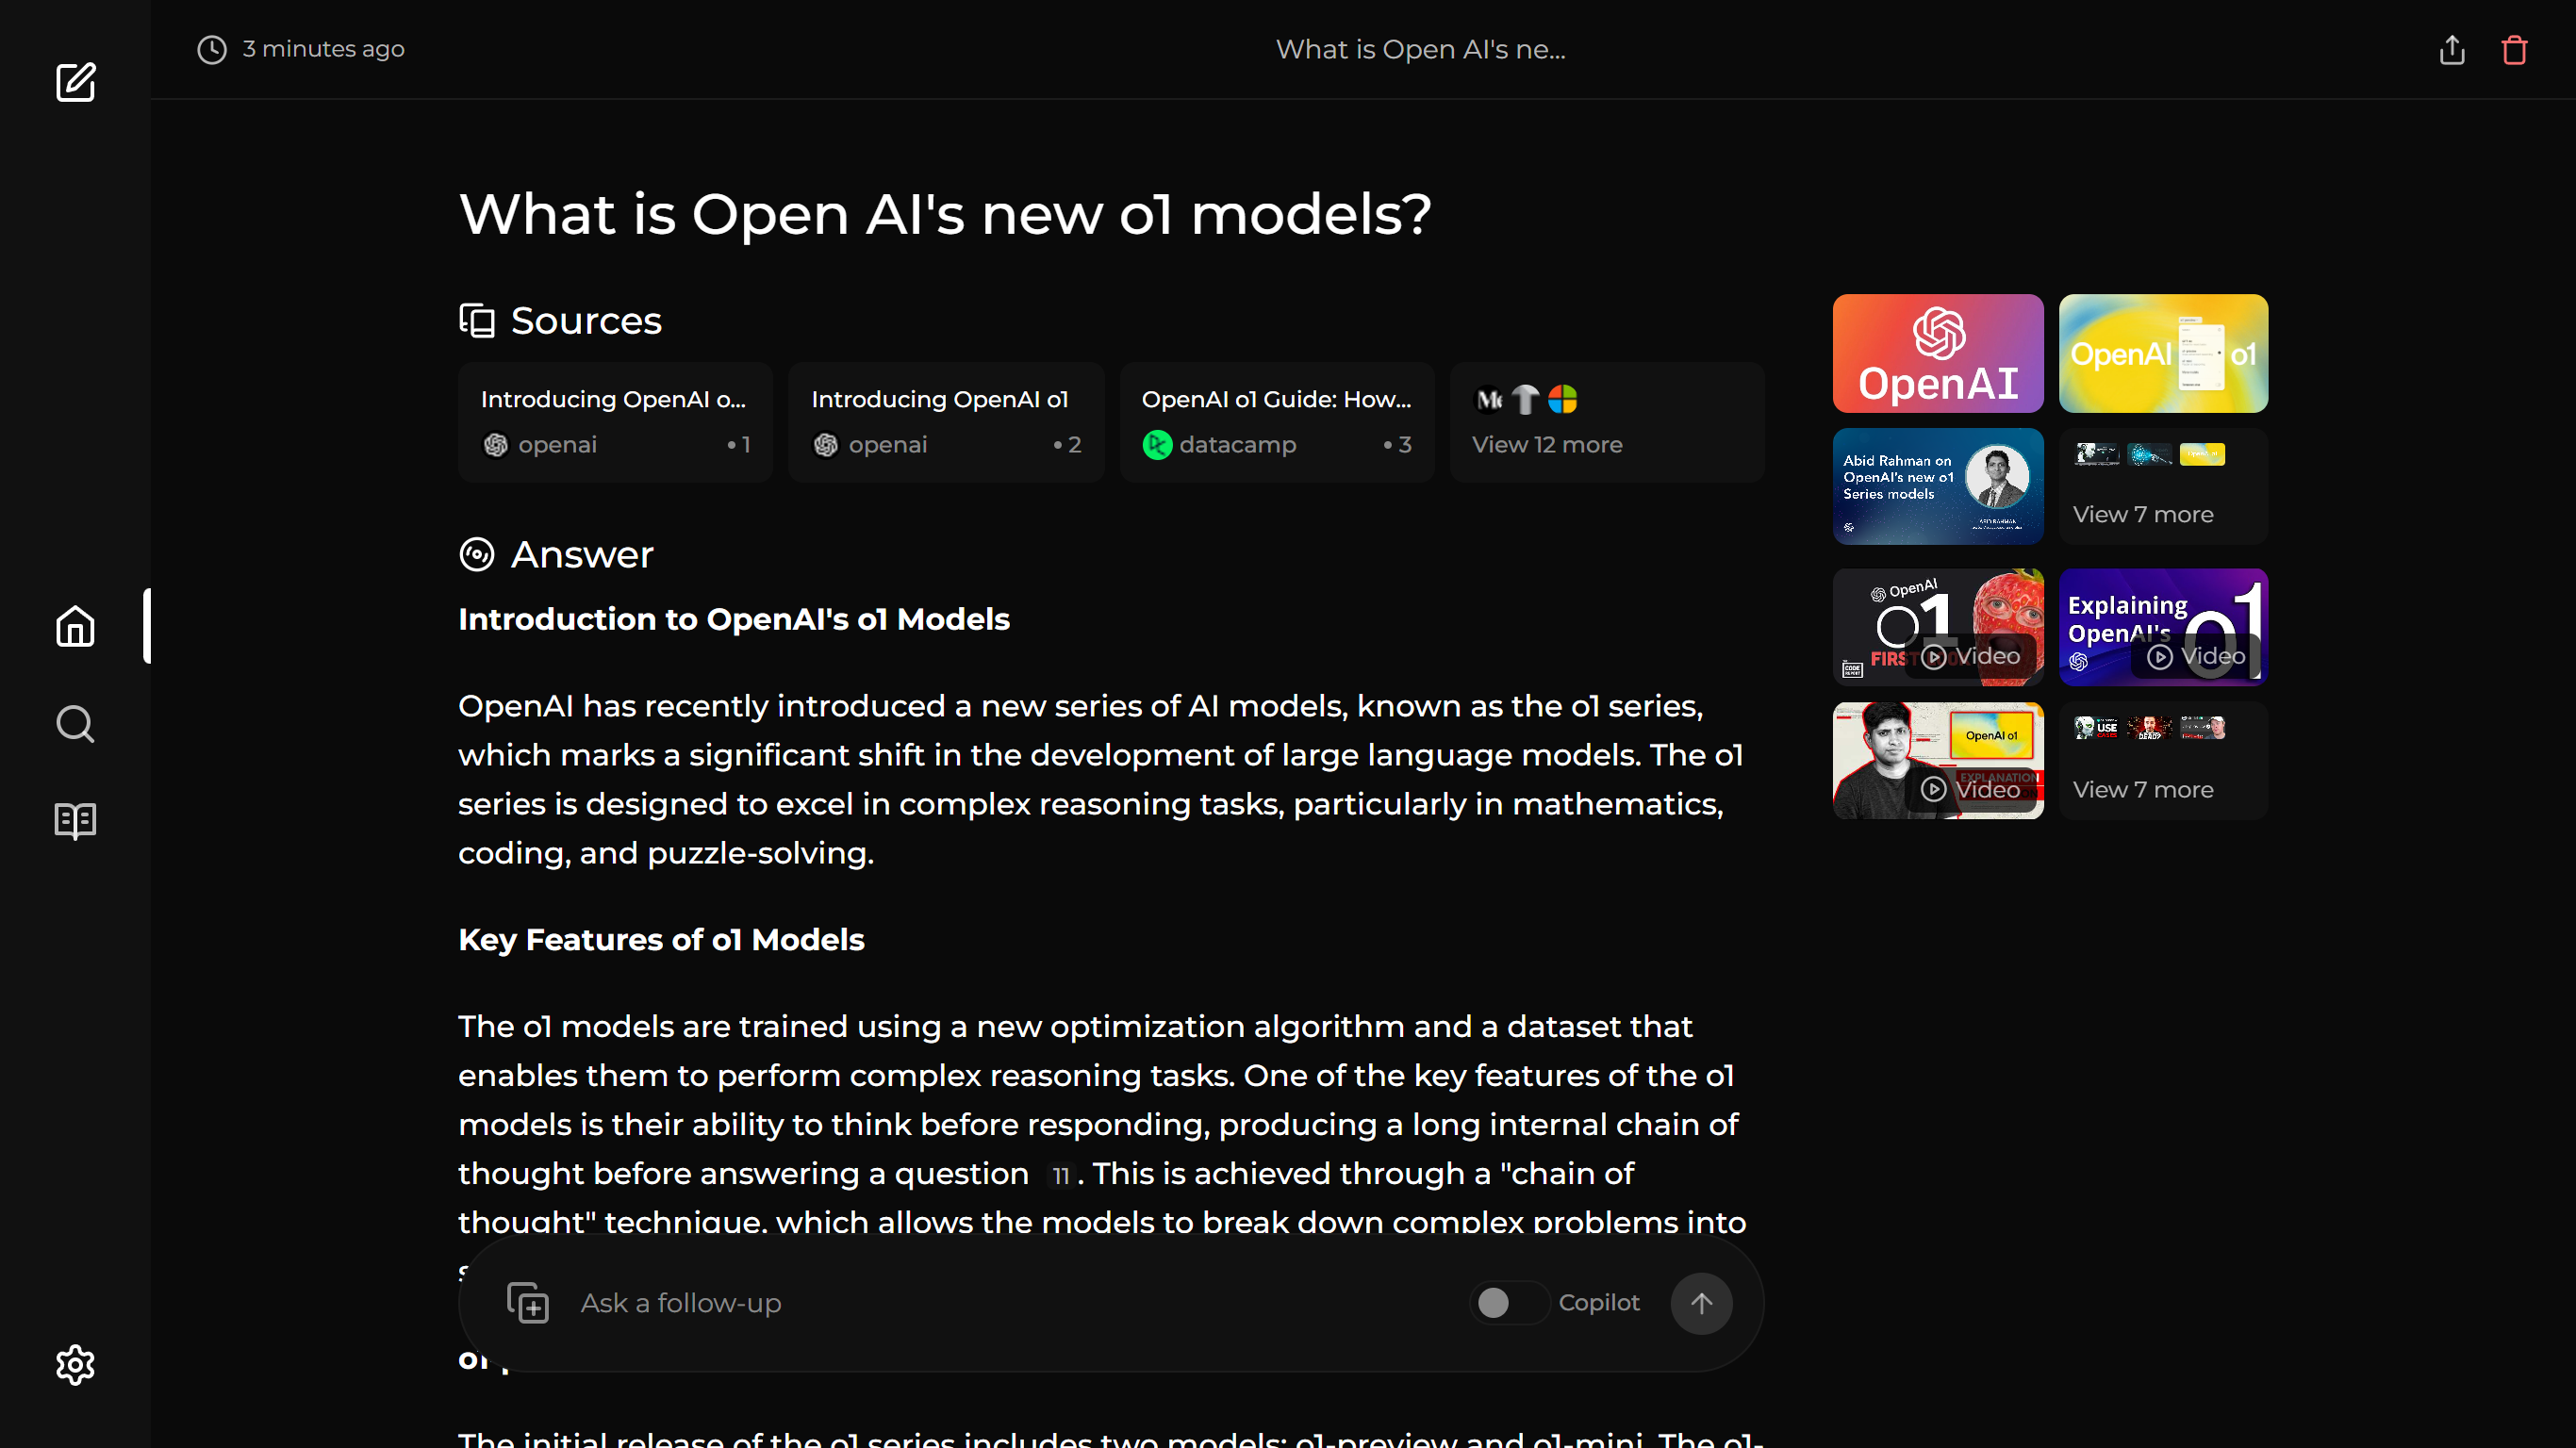
Perplexica combina SearXNG —un metabuscador de código abierto que agrega resultados de Google, Bing y DuckDuckGo simultáneamente— con modelos de lenguaje locales mediante Ollama, entregando respuestas con fuentes citadas directamente desde el navegador. Lo que distingue a Perplexica de una búsqueda tradicional es su capacidad de sintetizar información de varias fuentes en una respuesta coherente con referencias verificables al final. La imagen del contenedor Docker ya incorpora SearXNG integrado, por lo que no se requiere configuración adicional de servidores externos.
- Privacidad local: Las consultas no salen de la red cuando se usan modelos mediante Ollama
- Sin costo recurrente: La infraestructura es propia; no hay pago por uso ni por modelos locales
- Código auditable: Licencia MIT; cualquiera puede revisar o modificar el código fuente en GitHub
- Respuestas con fuentes: Cada respuesta incluye los sitios consultados para su elaboración
- Modelos flexibles: Compatible con Ollama, OpenAI, Groq, Anthropic Claude, Google Gemini y LM Studio
- Versión actual: v1.12.1, publicada en diciembre de 2025
Requisitos previos antes de instalar
El único requisito obligatorio es tener Docker instalado y en ejecución en el sistema. Ollama es opcional: si se prefiere usar proveedores en la nube como OpenAI o Groq, no es necesario instalarlo. Para una experiencia completamente local, se recomienda tener Ollama activo con al menos un modelo descargado antes de iniciar Perplexica. Los modelos de entre 3,000 y 8,000 millones de parámetros funcionan bien con 8 GB de memoria RAM disponible; para modelos más grandes se recomiendan al menos 16 GB.
Cómo instalar Ollama por sistema operativo
Ollama se instala con un solo comando en Linux y como aplicación nativa en macOS y Windows. Una vez activo, descarga el modelo que se usará con Perplexica antes de continuar. El sitio oficial es ollama.com.
- Linux: curl -fsSL https://ollama.com/install.sh | sh
- macOS y Windows: Descarga el instalador desde ollama.com y sigue el asistente de instalación
- Verificar modelos instalados: ollama list muestra todos los modelos disponibles con su tamaño y fecha
- Modelo recomendado para comenzar: ollama pull qwen3:8b para uso general o ollama pull llama3.2 si el equipo tiene recursos limitados
¿Cómo instalar Perplexica con Docker?
La instalación completa se realiza con un solo comando desde la terminal. Docker descargará la imagen oficial que ya incluye Perplexica y SearXNG integrados, sin necesidad de clonar repositorios ni editar archivos de configuración manualmente. Toda la configuración posterior se realiza desde el asistente visual en el navegador al abrir la aplicación por primera vez.
- Asegúrate de que Docker Desktop esté abierto y activo — el ícono de ballena debe aparecer en la bandeja del sistema sin animación de carga
- Ejecuta el siguiente comando en la terminal:
docker run -d -p 3000:3000 -v perplexica-data:/home/perplexica/data –name perplexica itzcrazykns1337/perplexica:latest
- Abre el navegador y ve a http://localhost:3000
- Completa el asistente de configuración: Selecciona Ollama como proveedor, introduce la URL del servidor y elige el modelo
- Guarda los cambios y realiza una consulta de prueba para confirmar que todo funciona
Si ya se cuenta con una instancia propia de SearXNG en funcionamiento, se puede usar la versión reducida de la imagen que no la incluye:
docker run -d -p 3000:3000 -e SEARXNG_API_URL=http://tu-searxng:8080 -v perplexica-data:/home/perplexica/data –name perplexica itzcrazykns1337/perplexica:slim-latest
¿Cómo solucionar errores de conexión con Ollama?
El error más frecuente al configurar Perplexica es que el contenedor Docker no logra comunicarse con Ollama, que corre fuera de Docker en el sistema anfitrión. La URL correcta depende del sistema operativo y se establece en el panel de ajustes de Perplexica dentro del navegador.
- Windows y macOS: Usa http://host.docker.internal:11434 como URL de Ollama en la configuración
- Linux: Usa la dirección IP local del equipo en la red, por ejemplo http://192.168.x.x:11434
En Linux existe un paso adicional obligatorio: Ollama debe configurarse para aceptar conexiones desde todas las interfaces de red. Sin este ajuste, incluso con la IP correcta, la conexión fallará.
- Abre el archivo de servicio: sudo nano /etc/systemd/system/ollama.service
- Agrega en la sección [Service]: Environment=”OLLAMA_HOST=0.0.0.0:11434″
- Recarga la configuración: systemctl daemon-reload
- Reinicia el servicio: systemctl restart ollama
Para confirmar que Ollama está activo antes de configurar Perplexica, abre en el navegador http://localhost:11434. Si responde con el texto Ollama is running, el servidor está listo. Si Perplexica no responde después de configurarla correctamente, reinicia el contenedor con docker restart perplexica sin perder ninguna configuración guardada.
Modos de búsqueda disponibles en Perplexica
Perplexica ofrece tres modos de optimización que determinan el equilibrio entre velocidad y profundidad de análisis, combinables de forma independiente con el tipo de fuentes a consultar. Esta flexibilidad permite adaptar cada búsqueda según el tipo de información que se necesita sin cambiar de herramienta.
- Modo rápido: Prioriza la velocidad de respuesta; adecuado para consultas directas y verificaciones puntuales
- Modo equilibrado: Balance entre velocidad y profundidad; recomendado para la mayoría de búsquedas cotidianas
- Modo calidad: Análisis más profundo de las fuentes; indicado para investigación o contenido técnico
El tipo de fuentes se selecciona de forma independiente al modo elegido:
- Web general: Resultados de múltiples buscadores a través de SearXNG
- Discusiones: Comunidades y foros en línea; útil para conocer experiencias reales de usuarios
- Documentos académicos: Publicaciones científicas e investigación especializada
¿Qué archivos acepta Perplexica?
Perplexica permite cargar archivos directamente en la interfaz de consulta para hacer preguntas sobre su contenido. Es importante distinguir entre los formatos que Perplexica admite de forma nativa y los que requieren herramientas complementarias o modelos en la nube, ya que no todos los tipos de archivo están soportados localmente de la misma forma.
- PDF: Compatible de forma nativa; Perplexica extrae el texto del documento y lo usa como contexto de la respuesta
- TXT: Compatible de forma nativa; el contenido se procesa directamente sin conversión previa
- Imágenes (PNG, JPEG, WebP): Compatible cuando se usa un modelo con capacidad visual activo en Ollama; sin modelo visual el análisis de imágenes no está disponible
- DOCX: Soporte limitado; algunos documentos Word se procesan correctamente pero no está garantizado en todos los casos según la versión del archivo
- XLSX y CSV: No confirmados como soportados de forma nativa en Perplexica local; para este tipo de archivos se recomienda usar Perplexity AI en la nube, ChatGPT o Claude, que tienen soporte verificado para hojas de cálculo
Modelos recomendados según el tipo de tarea y archivo
La elección del modelo determina qué tipos de tareas se pueden realizar y con qué calidad. Los modelos de texto puro son más rápidos y ligeros; los modelos con capacidad visual requieren más recursos pero amplían considerablemente las posibilidades. Desde mayo de 2025, Ollama incorpora un motor nativo para modelos multimodales que mejora la fiabilidad y precisión del análisis de imágenes.
- Llama 3.2 3B (~2 GB): Solo texto; consultas rápidas, verificaciones directas, búsqueda informativa simple
- Qwen3:8B (~5.5 GB): Solo texto; uso general en Perplexica, síntesis de fuentes, redacción, análisis de PDF y TXT
- Mistral 7B (~4.1 GB): Solo texto; redacción de artículos, resúmenes, traducción de documentos
- DeepSeek R1 8B (~5.5 GB): Solo texto; razonamiento paso a paso, análisis técnico, resolución de problemas de código
- Qwen2.5 VL 7B (~5.5 GB): Texto e imágenes; análisis de capturas de pantalla, descripción de fotografías, lectura de texto en imágenes, interpretación de gráficas
- Llama 4 Scout (~8 GB): Texto e imágenes; modelo multimodal de Meta con contexto extendido; análisis de documentos con imágenes integradas
- Gemma 3 4B / 12B (~3 / ~8 GB): Texto e imágenes; modelo de Google con buen rendimiento en análisis visual y comprensión de documentos
- Mistral Small 3.1 (~12 GB): Texto e imágenes; alta calidad en análisis visual y síntesis de información compleja; requiere más VRAM
- LLaVA 7B (~5.5 GB): Texto e imágenes; primera generación de modelos visuales en Ollama; funcional pero superado en calidad por Qwen2.5 VL y Gemma 3
Tabla de modelos por tipo de archivo y caso de uso
- Analizar un PDF de texto: Qwen3:8B, Mistral 7B, DeepSeek R1 8B — cualquiera de estos tres funciona bien; carga el archivo en Perplexica y formula la pregunta directamente
- Leer texto dentro de una imagen o captura de pantalla: Qwen2.5 VL 7B, Gemma 3, Llama 4 Scout — imprescindible usar un modelo con capacidad visual
- Describir o analizar una fotografía: Qwen2.5 VL 7B, Gemma 3, Mistral Small 3.1 — los tres producen descripciones detalladas con buena precisión
- Interpretar una gráfica o diagrama: Qwen2.5 VL 7B, Llama 4 Scout — estos modelos tienen mejor desempeño en comprensión de elementos visuales estructurados
- Analizar un archivo de texto plano (TXT, Markdown): Cualquier modelo de texto; Qwen3:8B o Mistral 7B son suficientes
- Analizar un archivo DOCX: Qwen3:8B con soporte parcial en Perplexica; para resultados garantizados, usa ChatGPT, Claude o Perplexity AI en la nube
- Analizar una hoja de cálculo XLSX o CSV: No recomendado en Perplexica local; usa ChatGPT (GPT-4o), Claude 3.5 o Perplexity AI Pro que tienen soporte nativo verificado para este formato
- Redactar un artículo o texto largo: Mistral 7B, Qwen3:8B; para textos que requieran alta coherencia y extensión superior a 1,500 palabras, un asistente conversacional local o en la nube es más adecuado que Perplexica
- Resolver código o depurar errores: DeepSeek R1 8B, Qwen3-Coder (si se cuenta con hardware suficiente); para proyectos complejos, Claude 3.5 o GPT-4o siguen siendo superiores
- Búsqueda con fuentes en tiempo real: Cualquier modelo de texto con Perplexica en modo web; la calidad de la síntesis depende más de Qwen3:8B o Mistral que de modelos más pequeños
¿Cuánto tiempo tarda en responder?
El tiempo de respuesta depende del modelo activo, la complejidad de la consulta y el hardware disponible. Con una tarjeta gráfica dedicada, Ollama procesa entre 30 y 60 unidades de texto por segundo con modelos de 7,000 a 8,000 millones de parámetros. Conviene distinguir entre la lentitud normal del proceso y un bloqueo real antes de interrumpir la operación.
- Búsqueda y recuperación de fuentes web: 3 a 8 segundos — comportamiento normal de SearXNG
- Generación de respuesta con modelos de 7-8B en GPU: 6 a 15 segundos para respuestas estándar
- Análisis de imagen con modelo visual en GPU: 10 a 25 segundos según el tamaño de la imagen
- Sin respuesta después de 30 segundos: Posible bloqueo; cancelar y reintentar
Para cancelar una generación en curso, haz clic en el botón de detener que aparece junto al campo de texto mientras Perplexica genera la respuesta. Si la interfaz no responde, reinicia el contenedor con docker restart perplexica sin perder la configuración guardada.
¿Qué tamaño deben tener las consultas?
Perplexica es un motor de búsqueda con síntesis, no un asistente conversacional. Las consultas funcionan de forma diferente a las de herramientas como ChatGPT o un asistente con Ollama: deben ser concisas, directas y contener una sola pregunta o intención por consulta. Mensajes demasiado largos o con múltiples preguntas producen respuestas menos precisas y más lentas.
- Longitud recomendada: Entre 10 y 40 palabras por consulta
- Número de preguntas por consulta: Una sola; si se necesitan varias respuestas, envía consultas separadas
- Contexto adicional útil: Incluir año, versión de software o nombre de herramienta específica mejora la precisión
Ejemplos de consultas correctas e incorrectas
La diferencia entre una consulta bien formulada y una mal estructurada puede significar la diferencia entre una respuesta útil y una respuesta vaga o incompleta:
- Correcto: ¿Cómo instalar Docker en Ubuntu 24.04? — específico, una sola acción, versión incluida
- Correcto: Mejores modelos locales de IA para síntesis de texto en 2025 — intención clara, contexto temporal
- Correcto: ¿Qué diferencia hay entre Qwen3:8B y Mistral 7B para redacción? — comparación directa entre dos opciones concretas
- Correcto: Errores frecuentes al conectar Ollama con Docker en Windows 11 — consulta técnica con contexto de sistema operativo
- Incorrecto: Explícame Docker, cómo instalarlo, sus ventajas, diferencias con Kubernetes y ejemplos de uso para desarrollo web — cinco preguntas distintas en una; el resultado será superficial en todas
- Incorrecto: Responde en formato HTML sin markdown, con al menos tres secciones y fuentes en APA — las instrucciones de formato no son procesadas por Perplexica como lo haría un asistente
- Incorrecto: Como te dije antes, el problema sigue igual — Perplexica no mantiene contexto conversacional entre búsquedas
¿Cuándo usar un modelo local y cuándo uno en la nube?
Elegir entre un modelo local con Ollama y un servicio en la nube como ChatGPT, Claude o Perplexity AI depende de cuatro factores principales: privacidad de los datos, calidad requerida en la respuesta, tipo de archivo o tarea y velocidad necesaria. No existe una opción universalmente superior; cada una tiene casos de uso donde destaca.
- Usa un modelo local si: la información es confidencial o sensible, trabajas sin conexión a internet, necesitas consultas frecuentes sin costo acumulado o prefieres control total sobre el historial de conversaciones
- Usa un modelo en la nube si: necesitas alta calidad constante sin depender del hardware local, el archivo es XLSX o una hoja de cálculo compleja, la tarea requiere contexto muy largo (más de 50 páginas de PDF), o necesitas capacidades de audio y video que los modelos locales aún no manejan de forma estable
- Archivos donde los servicios en la nube son superiores actualmente: XLSX con fórmulas, PPTX con diseño visual, archivos de audio, video y documentos con tablas complejas o múltiples idiomas mezclados
- Archivos donde los modelos locales funcionan bien: PDF de texto, TXT, Markdown, código fuente, imágenes con texto o escenas cuando se usa un modelo visual actualizado
Comparativa directa: local vs. nube por caso de uso
- Búsqueda web con síntesis y fuentes: Perplexica local con Qwen3:8B es funcional; Perplexity AI Pro ofrece mayor calidad y velocidad constante
- Redacción de artículos: Asistente local con Mistral 7B o Qwen3:8B funciona bien para borradores; ChatGPT o Claude producen textos más pulidos en menos tiempo
- Análisis de PDF: Local con Qwen3:8B maneja bien documentos de texto; Claude 3.5 es superior para PDFs con tablas, gráficas o múltiples columnas
- Análisis de imágenes: Local con Qwen2.5 VL o Gemma 3 es suficiente para capturas de pantalla y fotografías; GPT-4o sigue siendo más preciso en imágenes técnicas complejas
- Análisis de XLSX y CSV: Los modelos locales en Perplexica no tienen soporte garantizado; ChatGPT con Intérprete de código o Claude son las opciones más confiables
- Código y depuración: DeepSeek R1 local es competitivo para proyectos medianos; Claude 3.5 Sonnet sigue siendo la referencia para proyectos complejos de programación
- Privacidad absoluta: Solo los modelos locales garantizan que los datos no salen del equipo; todos los servicios en la nube procesan las consultas en servidores externos
Funciones adicionales de Perplexica v1.12.1
Más allá de la búsqueda principal, la versión actual incluye herramientas que amplían su utilidad para distintos flujos de trabajo. Resulta particularmente práctica para creadores de contenido la sección de exploración, que muestra artículos e información relevante sin necesidad de formular una consulta activa.
- Tarjetas informativas contextuales: Datos de clima, cálculos matemáticos y precios de mercado que aparecen automáticamente según el tipo de consulta
- Búsqueda de imágenes y videos: Los resultados no se limitan a texto; es posible buscar contenido visual dentro de la misma interfaz
- Carga de archivos: PDF, TXT e imágenes para hacer preguntas sobre su contenido directamente en la interfaz
- Búsqueda en dominios específicos: Restringe la búsqueda a un sitio web determinado; útil para documentación técnica o bases de conocimiento propias
- Historial local: Todas las búsquedas se guardan en el equipo para consulta posterior sin necesidad de cuenta o registro
- Sección de exploración: Muestra artículos e información de tendencia a lo largo del día sin búsqueda activa
- API pública: Permite integrar Perplexica en aplicaciones propias; la documentación está disponible en el repositorio oficial de GitHub
Cómo usar Perplexica como buscador del navegador
Una vez instalada, Perplexica puede configurarse como motor de búsqueda adicional en el navegador, lo que permite lanzar consultas directamente desde la barra de dirección sin abrir pestañas adicionales. Esta integración es especialmente útil para quienes realizan búsquedas frecuentes durante el trabajo.
- Abre la configuración del navegador y localiza la sección Motores de búsqueda
- Agrega un nuevo motor con la URL: http://localhost:3000/?q=%s
- Asígnalo como motor predeterminado o como acceso directo con una palabra clave personalizada
- Si Perplexica está instalada en otro equipo de la red local, sustituye localhost por la dirección IP correspondiente y el puerto configurado
¿Tiene ventajas usarlo en equipos con Snapdragon o Apple Silicon?
Sí, con matices importantes según el chip. Tanto los procesadores Apple Silicon como los Snapdragon X Elite comparten una característica que los diferencia de los equipos con tarjeta gráfica dedicada: la memoria unificada, donde el procesador y la parte gráfica acceden al mismo banco de memoria. Esto permite ejecutar modelos más grandes que los que cabrían en una tarjeta gráfica con memoria de video dedicada limitada.
Apple Silicon (M1, M2, M3, M4)
Ollama tiene soporte nativo y optimizado para Apple Silicon desde sus primeras versiones, utilizando todos los núcleos gráficos disponibles para la ejecución de modelos. Un equipo con M3 Pro y 36 GB de memoria unificada puede ejecutar modelos de hasta 30,000 millones de parámetros completamente en memoria, algo imposible con una tarjeta gráfica de 12 GB de memoria de video dedicada. La eficiencia energética es otra ventaja real: los modelos corren con un consumo considerablemente menor que en equipos con tarjeta gráfica de alto rendimiento.
- M1 y M2: Entre 11 y 26 unidades de texto por segundo con modelos de 7-8B
- M3 Pro y M4: Entre 50 y 124 unidades de texto por segundo con modelos de 7-8B
- Ventaja clave: Memoria unificada expandible hasta 128 GB; modelos grandes sin fragmentación entre procesador y tarjeta gráfica
- Limitación: Una tarjeta gráfica dedicada de gama alta supera al Apple Silicon en velocidad bruta con modelos pequeños
Snapdragon X Elite (Windows con arquitectura ARM)
El soporte de Ollama para Snapdragon X Elite es funcional pero más limitado que en Apple Silicon a marzo de 2026. El procesador ARM ejecuta los modelos con optimizaciones de cuantización específicas que mejoran el rendimiento en texto, alcanzando velocidades similares a las del Apple M2 en condiciones óptimas. Sin embargo, la parte gráfica Adreno del Snapdragon aún no cuenta con soporte de aceleración en Ollama, por lo que toda la carga de procesamiento recae en los núcleos del procesador principal. El procesador neuronal del chip tampoco es compatible directamente con Ollama.
- Velocidad estimada con procesador principal: Entre 18 y 37 unidades de texto por segundo con modelos de 3-8B
- Ventaja: Bajo consumo energético; útil en equipos portátiles donde la autonomía de batería es prioritaria
- Limitación actual: Sin aceleración por parte gráfica ni por procesador neuronal en Ollama a marzo de 2026
- Memoria unificada: Al igual que Apple Silicon, permite ejecutar modelos más grandes que una tarjeta gráfica con memoria dedicada equivalente
Para un equipo de escritorio con tarjeta gráfica Nvidia dedicada de gama media o alta, el rendimiento en velocidad bruta seguirá siendo superior con Ollama y Perplexica. Apple Silicon destaca en eficiencia energética y capacidad para modelos grandes. Snapdragon X Elite es una opción viable para uso portable, con soporte en desarrollo activo para aceleración de hardware.
¿Vale la pena frente a Perplexity AI?
Ambas herramientas resuelven el mismo problema desde perspectivas distintas. Perplexity AI ofrece una experiencia consistente sin gestión técnica; Perplexica otorga control total sobre la infraestructura y los datos a cambio de una configuración inicial. Lo cierto es que la calidad de las respuestas en Perplexica depende directamente del modelo elegido y del hardware disponible.
- Elige Perplexica si: la privacidad de los datos es prioritaria, se trabaja con información sensible, se cuenta con hardware suficiente y resulta cómodo gestionar servicios locales
- Elige Perplexity AI u otro servicio en la nube si: se necesitan respuestas de alta calidad sin configuración técnica, el equipo disponible tiene recursos limitados, o se trabaja frecuentemente con hojas de cálculo, presentaciones o archivos de audio y video
- Opción mixta: Perplexica permite conectar APIs externas de OpenAI, Groq o Gemini para obtener calidad de modelos en la nube con la infraestructura de búsqueda propia, combinando privacidad parcial con mayor calidad en respuestas
El repositorio oficial del proyecto está disponible en github.com/ItzCrazyKns/Perplexica. Para ver el proceso de instalación completo en video, este tutorial en español cubre la configuración con Docker y SearXNG.




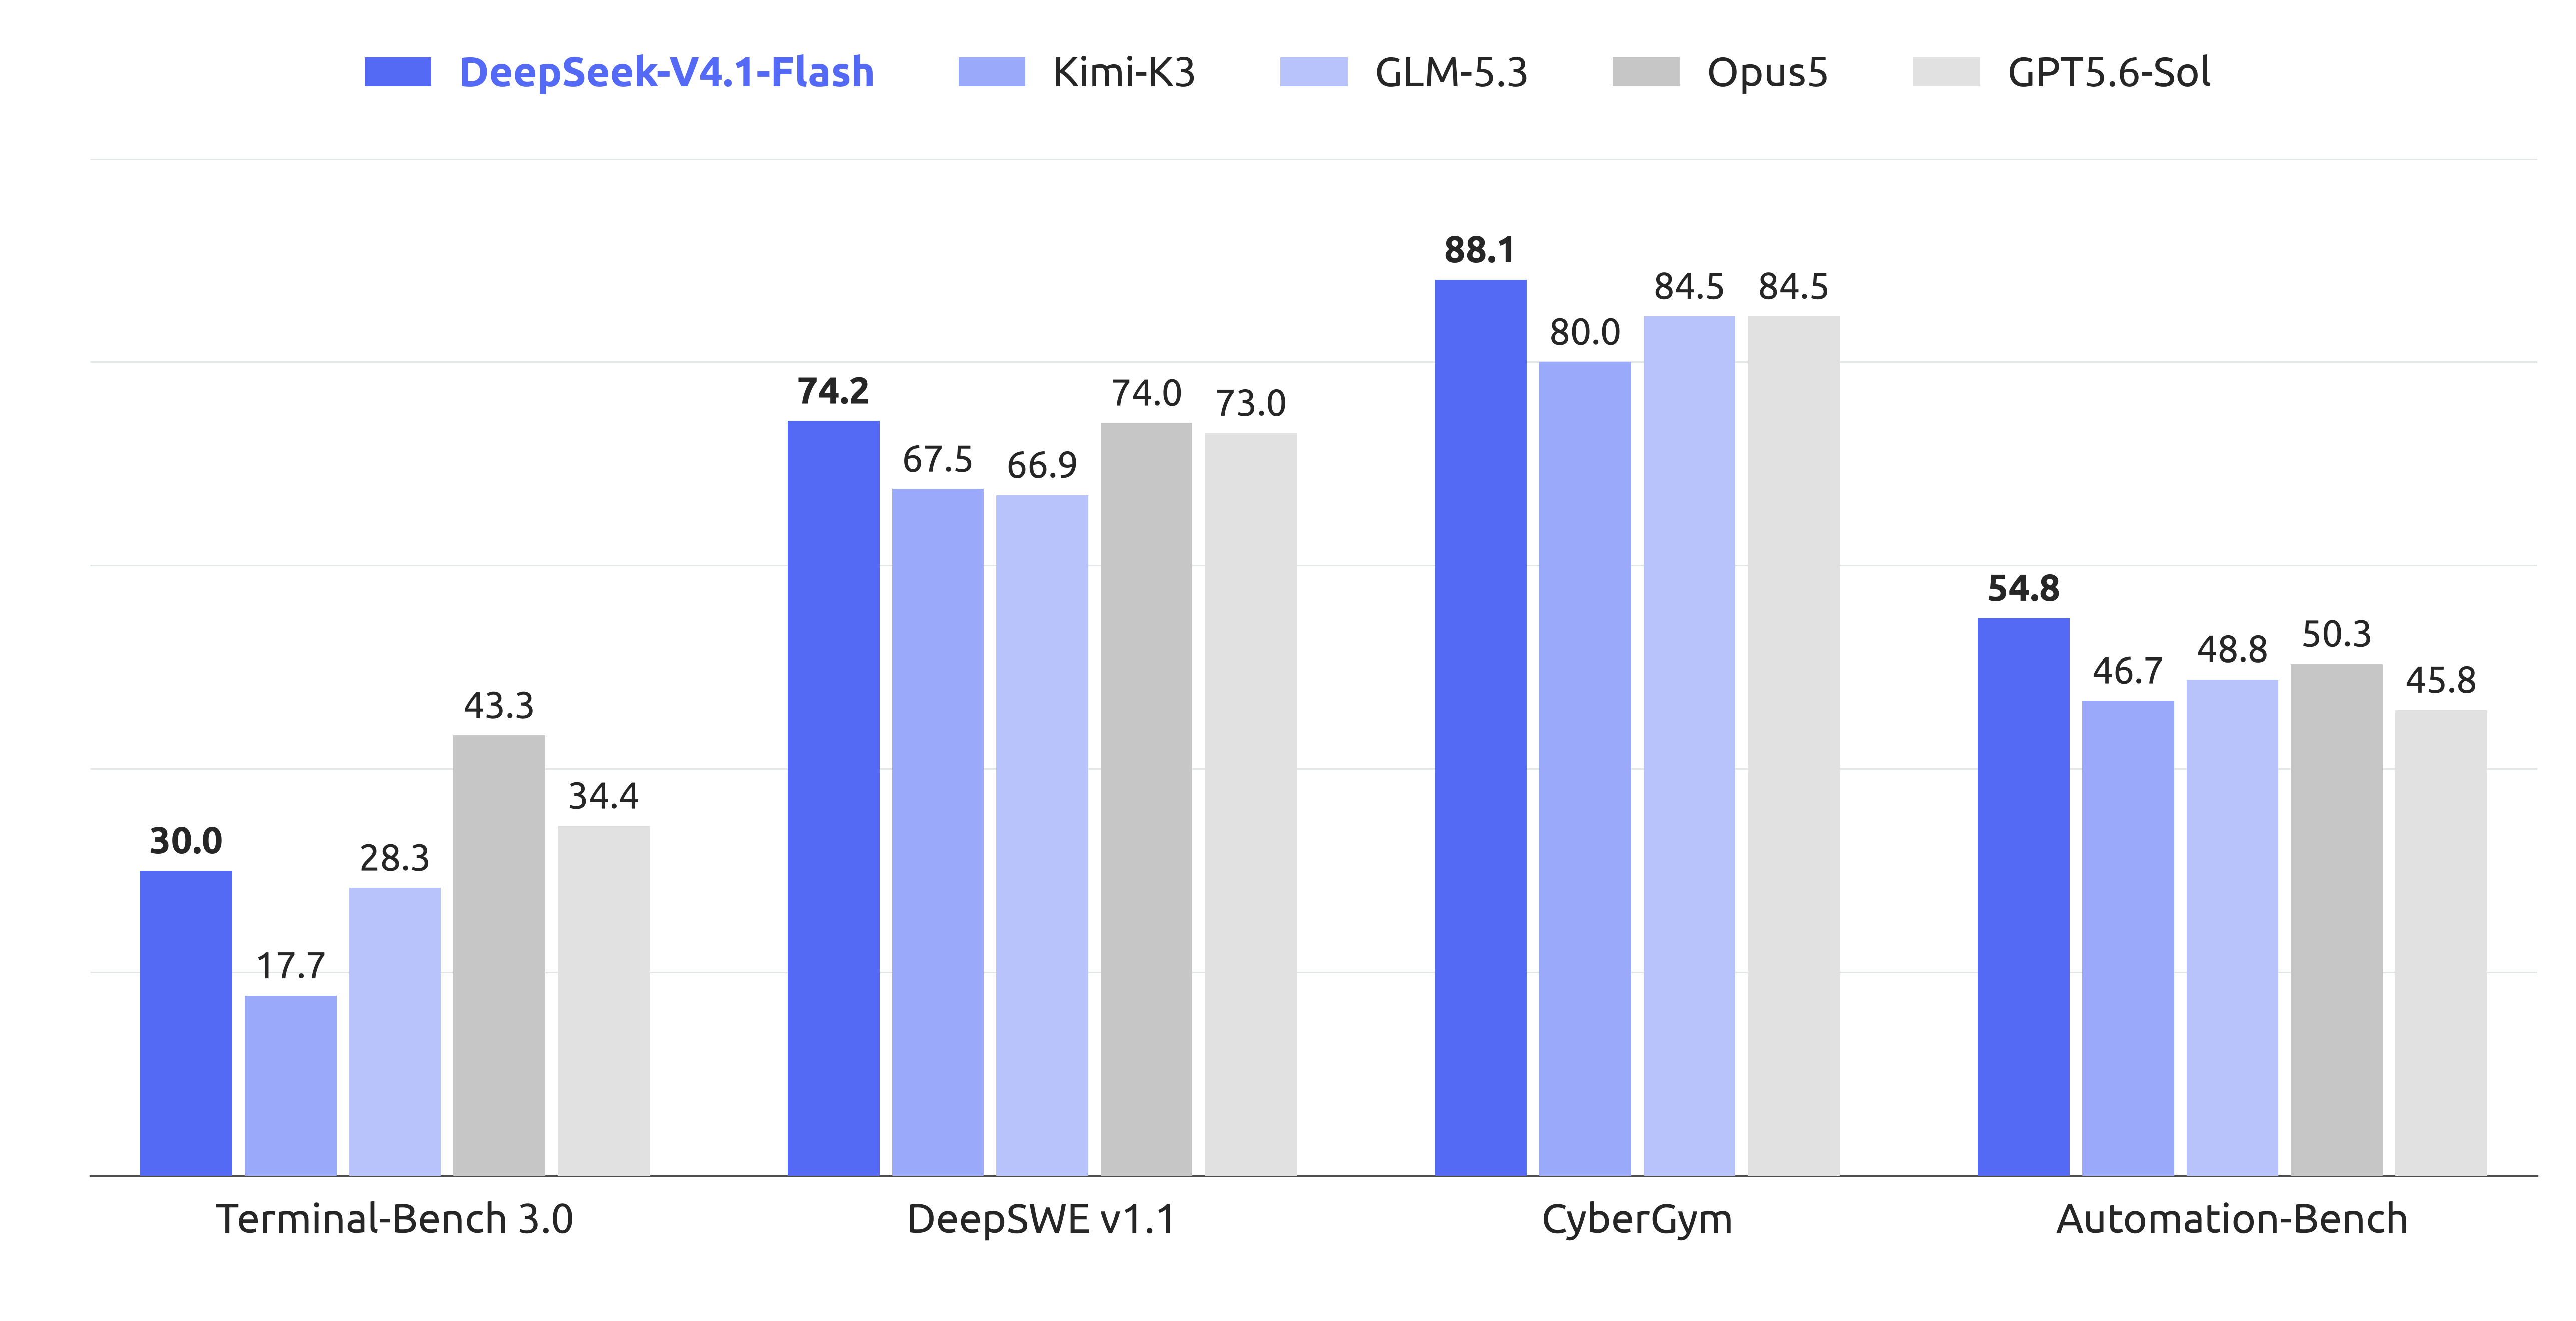
DeepSeek ha presentado V4.1-Flash, su modelo de inteligencia artificial más pequeño y económico hasta la fecha, con precios desde $0.003 por millón de tokens gracias a su sistema de caché. Según la compañía, este modelo supera a GPT-5.6 Sol de OpenAI y a Claude Opus 5 de Anthropic en tareas de programación y ciberseguridad, marcando un hito en la relación costo-rendimiento.
Este lanzamiento podría redefinir el mercado de los modelos de lenguaje, ofreciendo una alternativa accesible para desarrolladores y empresas.
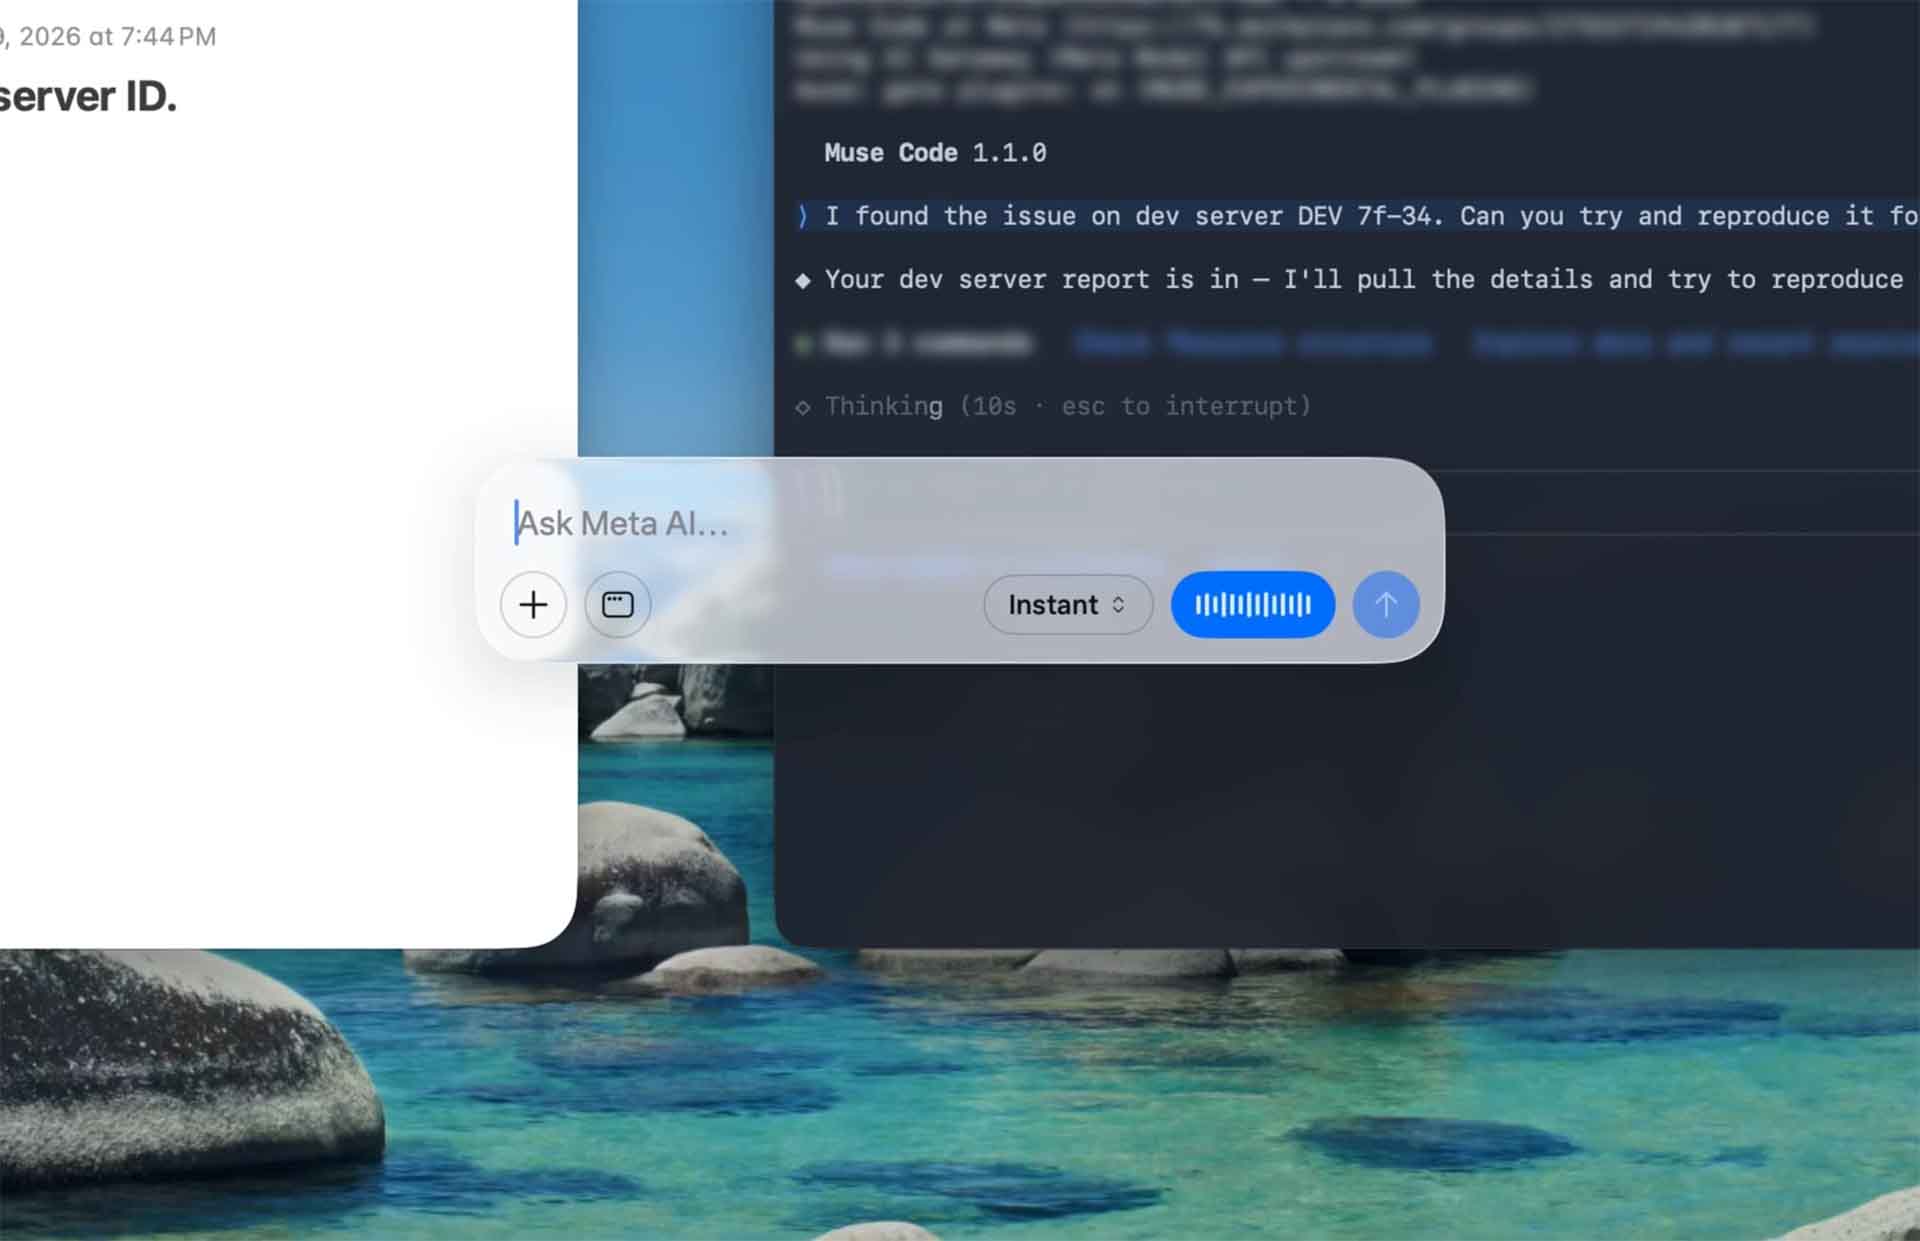
Meta lanza Muse Voice Transcribe, su primer modelo de audio en tiempo real con diarización para 20+ hablantes y soporte multilingüe. Un avance en transcripción de voz con IA que redefine la interacción humana con la tecnología.
Google ha presentado Gemini 3.5 Transcribe, su modelo más avanzado de transcripción de voz a texto, diseñado para ofrecer precisión y eficiencia en tiempo real. A diferencia de los modelos tradicionales, que tienen dificultades con el ruido de fondo, la jerga técnica o las disfluencias en el habla, este nuevo modelo convierte el audio en bruto en texto pulido, formateado y listo para usar.
-

 Apps11 años ago
AMPcast, la herramienta de Pandora que permite a los artistas grabar mensajes de audio directamente a sus seguidores
-
 Blogs5 años ago
Conoce los mejores sitios de Torrents para descargar todo tipo de contenidos
-
Android5 años ago
Aprende cómo usar Discord para ver películas con tus amigos
-
Arte y Cultura13 años ago
Colección de fondos de pantalla basados en Super Héroes
-

 Almacenamiento2 años ago
Cómo usar TeraBox: La guía definitiva para aprovechar 1 TB de almacenamiento en la nube
-
Diseño13 años ago
css3ps: plugin que convierte archivos PSD a CSS3
-
Apps9 años ago
Picturethat, app que usa la Realidad Aumentada para visualizar cómo quedarían los cuadros antes de colgarlos
-
Eventos Especiales13 años ago
Especial Día de la Madres: fondos de pantalla especiales para Mamá