

Desarrolladores
MiniMax M3 vs Claude Opus y GPT‑5.5: ¿el nuevo estándar para agentes y código largo?

MiniMax M3 irrumpe como modelo multimodal de 1M de contexto, barato y orientado a agentes; se acerca a Claude Opus y supera a GPT‑5.5 en algunos benchmarks, pero aún tiene trade‑offs claros.
MiniMax M3 se posiciona como un modelo multimodal de 1 millón de tokens de contexto pensado para coding, agentes y uso prolongado, con una relación calidad/precio agresiva frente a modelos cerrados como GPT‑5.5 y Claude Opus 4.7/4.8. Sin embargo, los datos disponibles combinan métricas reportadas por MiniMax con comparativas independientes, y muestran un cuadro más matizado: M3 gana en algunos benchmarks y precio, mientras que Opus y GPT siguen mandando en consistencia y tareas críticas.
¿Qué es MiniMax M3 y en qué liga juega?
MiniMax M3 es un modelo fundacional multimodal de MiniMax que acepta texto, imágenes y vídeo como entrada, produce texto como salida y ofrece una ventana de contexto declarada de 1M de tokens, algo pensado para agentes de largo horizonte y bases de código grandes. Se presenta explícitamente como modelo open‑weights o open‑access orientado a coding, tool use y trabajo agentic prolongado, con precios muy por debajo de los modelos frontier cerrados.
- M3 utiliza una arquitectura de atención escasa tipo MiniMax Sparse Attention (MSA) para mantener costes manejables en contexto largo, con un mínimo garantizado de alrededor de 512k tokens y hasta 1M en configuración extendida.
- MiniMax lo posiciona como el primer modelo “de pesos abiertos” con tres capacidades de frontera combinadas: contexto largo, rendimiento sólido en código y comportamiento agentic razonable.
- Según medios especializados, el objetivo claro de M3 es competir directamente con Claude Opus, GPT‑5.x/5.5 y Gemini 3.1 Pro en tareas complejas sin replicar su costo.
¿Cómo se compara MiniMax M3 en benchmarks clave?
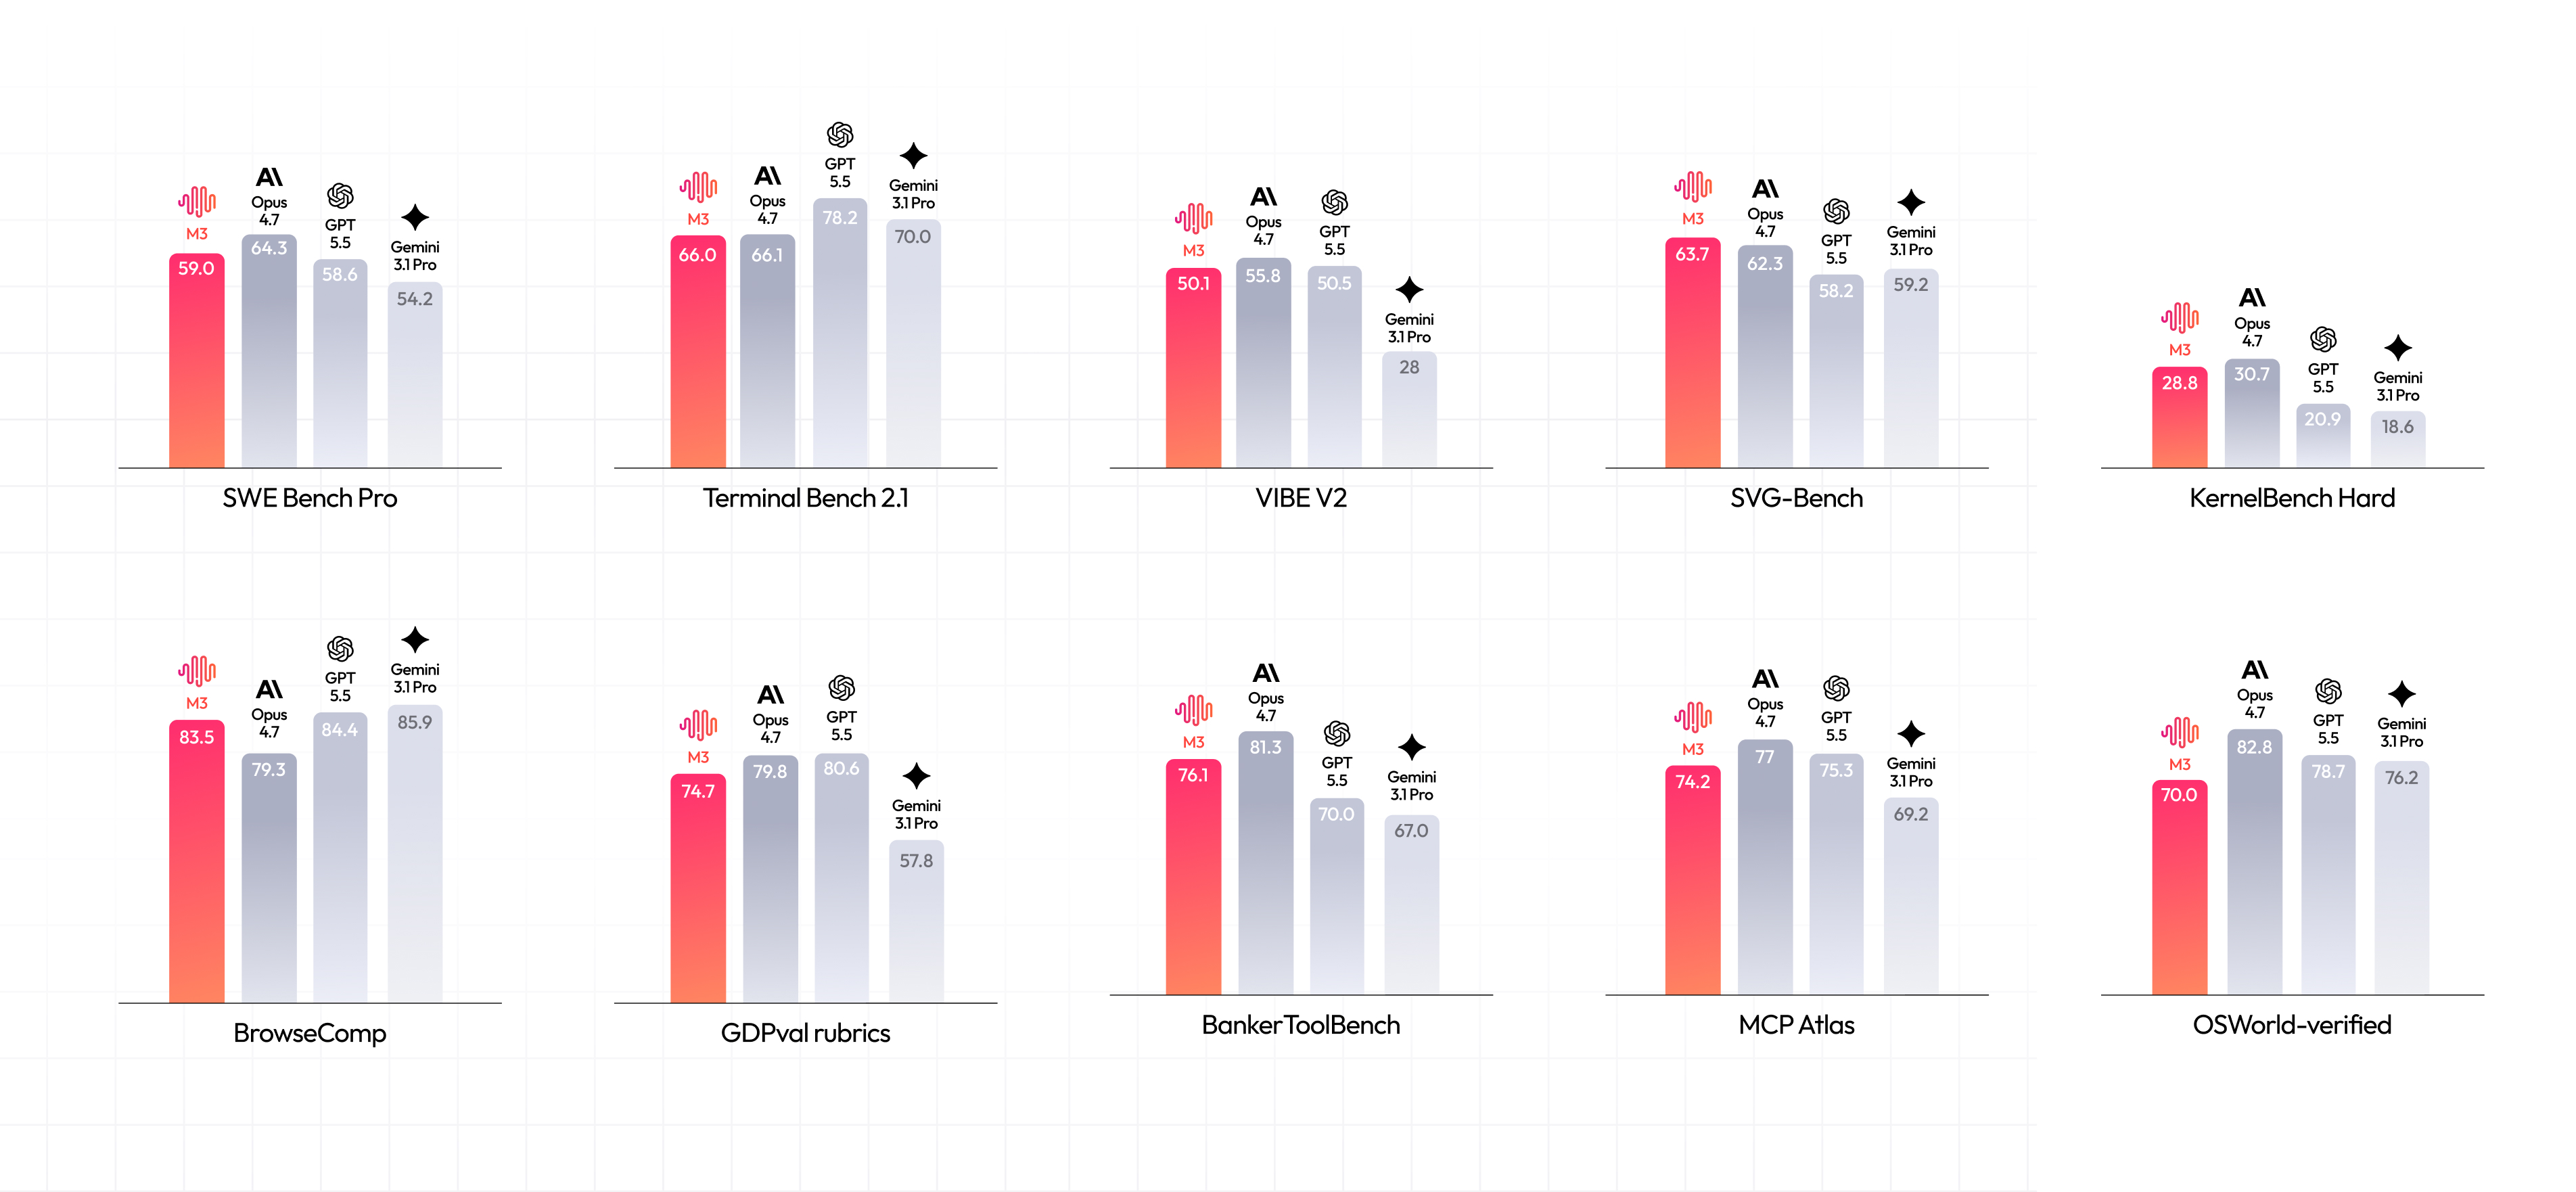
Los benchmarks pintan un cuadro mixto: en algunos escenarios M3 supera a GPT‑5.5 y Gemini 3.1 Pro, acercándose a Claude Opus 4.7, mientras que en otras pruebas más generales sigue por detrás de Opus y GPT. Vale la pena destacar que buena parte de los números proviene de MiniMax o de agregadores que usan sus propias mediciones, por lo que conviene verlos como señales, no como sentencia final.
| Benchmark | MiniMax M3 | GPT‑5.5 | Claude Opus 4.7/4.8 | Comentario |
|---|---|---|---|---|
| SWE‑Bench Pro (coding / agentic) | ≈ 59,0% (MiniMax reportado) | Por debajo de 59%; MiniMax afirma superarlo | Algo por encima de M3; MiniMax dice que M3 se “acerca” a Opus 4.7 | M3 queda por encima de GPT‑5.5 y Gemini 3.1 Pro en este benchmark concreto, pero todavía detrás de Opus. |
| Terminal‑Bench 2.1 (agente en terminal) | ≈ 66,0% (reportado) | Cifras algo inferiores según comparativas, aunque no siempre homogéneas. | Cercano a M3; varias reseñas indican que “está ahí al lado” en rendimiento de terminal. | Para agentes que operan en shell, M3 es competitivo con Opus y por encima de varios GPT según los datos citados. |
| BrowseComp (agente con navegación) | ≈ 83,5 (MiniMax) | Por debajo de M3 según los gráficos publicados. | M3 llega a superar a Opus 4.7 en este benchmark concreto. | En tareas de navegación autónoma, M3 puede incluso superar a Opus en las pruebas reportadas. |
| PostTrainBench (robustez general) | ≈ 0,37 | ≈ 0,39 | ≈ 0,42 | Aquí Opus y GPT‑5.5 siguen por delante; M3 queda algo detrás en calidad global después de entrenamiento. |
Reseñas independientes señalan que, aunque los números de M3 son impresionantes en papel, en uso real puede sentirse más lento y menos fiable que Opus o GPT en tareas de refactorización compleja o trabajo intensivo sobre bases de código grandes. No obstante, resulta particularmente interesante que en benchmarks como SWE‑Bench Pro y BrowseComp M3 se acerque o incluso supere a modelos cerrados mucho más caros, lo que lo vuelve muy atractivo para entornos de pruebas y agentes intensivos en tokens.
¿Cómo queda la relación calidad/precio frente a Claude y GPT?
En precio, MiniMax M3 se sitúa claramente por debajo de los modelos frontier cerrados: OpenRouter indica unos 0,30 USD/M tokens de entrada y 1,20 USD/M tokens de salida, con contexto de 1M tokens. Comparado con Claude Sonnet 4.6, M3 es aproximadamente 6 veces más barato por millón de tokens; frente a Opus, la diferencia se amplía aún más.
- OpenRouter enumera M3 con precios promocionales que lo colocan muy por debajo de muchos modelos cerrados, manteniendo la ventana de contexto máxima de 1M tokens.
- Una comparativa directa con Claude Sonnet 4.6 destaca que M3 cuesta alrededor de 0,60/2,40 USD por millón de tokens (entrada/salida) frente a 3/15 USD de Sonnet, es decir, unos 6x más barato.
- Guías de selección de modelos subrayan que, para código, Sonnet y Opus siguen liderando en reasoning sofisticado, mientras que MiniMax (M2.x, M3) apunta a ofrecer “performance frontier” a precio de modelo open‑weights.
¿En qué casos conviene MiniMax M3 frente a GPT‑5.5 y Claude Opus?
Las guías de desarrolladores y plataformas que comparan M3 con Opus y GPT coinciden en una recomendación general: usar M3 como modelo por defecto para trabajos largos y agentes, y escalar a Claude o GPT solo cuando el coste de error es muy alto. En la práctica, esto encaja bien con pipelines donde se mezclan acciones automáticas de bajo riesgo con pasos puntuales de verificación humana reforzada por un modelo premium.
- Se recomienda elegir M3 cuando necesitas un default barato para agentes, contexto largo y entradas multimodales, especialmente si quieres integrarlo en clientes compatibles con OpenAI o el formato de mensajes de Anthropic.
- Claude Opus 4.8 sigue siendo el candidato preferido para tareas donde fallar es muy caro, como decisiones de negocio críticas, refactorizaciones masivas sin revisión humana o cadenas de herramientas altamente sensibles.
- Algunos análisis proponen directamente un esquema “dual routing”: M3 como caballo de batalla, Opus o GPT‑5.x como vía de escalado para consultas difíciles o validaciones finales de alto valor.
¿Qué ventajas ofrece MiniMax M3 para agentes y contexto largo?
Donde M3 realmente brilla es en el triángulo contexto largo + multimodalidad + coste, una combinación que lo vuelve atractivo para proyectos de agentes complejos, análisis de repos completos y procesamiento de sesiones prolongadas. Su ventana de 1M tokens y soporte para vídeo le permiten ingerir grandes cantidades de documentación, código o contenido audiovisual, algo que los modelos cerrados también ofrecen, pero a un coste notablemente mayor.
- MiniMax lo promociona como modelo capaz de manejar tareas de código de gran escala y agentes que necesitan memoria extendida, con mejoras de velocidad y coste frente a generaciones anteriores como M2.7.
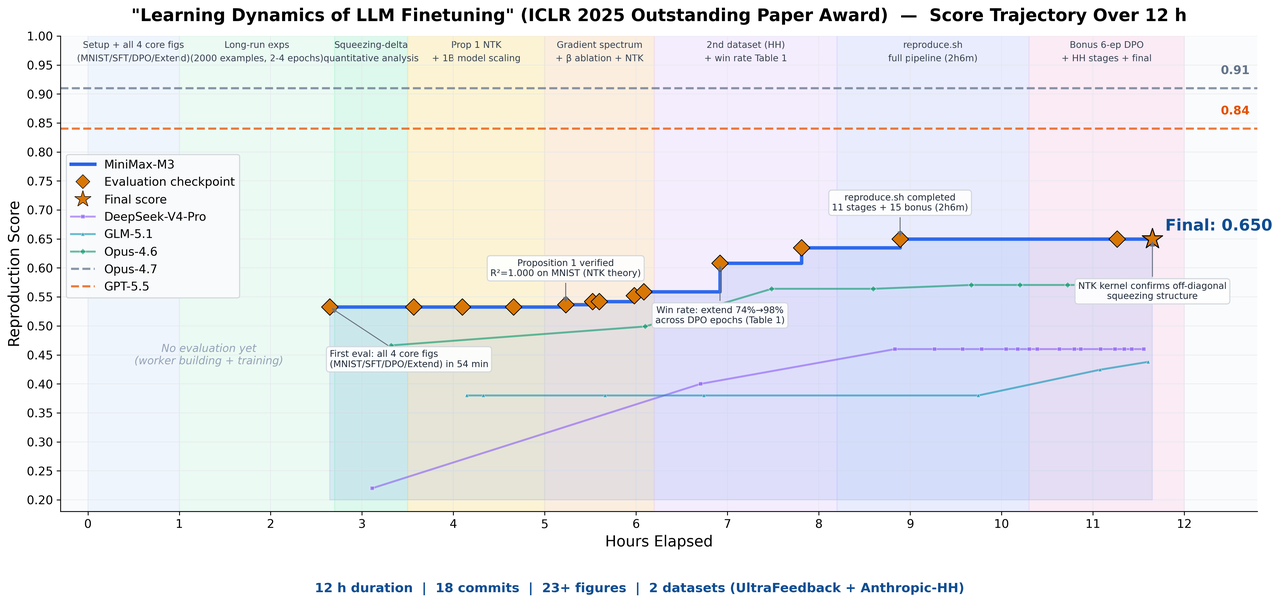
- Comparativas especializadas señalan que, para navegación autónoma y tareas complejas de terminal, M3 alcanza o supera a algunos frontier cerrados, lo que lo vuelve ideal para “cerebros” de agentes con mucho contexto.
- En términos prácticos, reseñas de usuarios que lo han probado en proyectos reales indican que M3 puede encargarse de la mayor parte del trabajo de código y agentes, siempre y cuando se acepte cierto grado de inestabilidad frente a Opus o GPT.
¿Cuáles son las limitaciones y trade‑offs de MiniMax M3 frente a Claude y GPT?
A pesar de los benchmarks favorables, varias reseñas destacan que M3 todavía arrastra problemas de latencia, fiabilidad y consistencia en comparación con Opus o GPT‑5.x, especialmente en escenarios de refactorización compleja y cambios delicados en código productivo. Además, hay que tener en cuenta que una parte importante de las métricas publicadas proviene de la propia MiniMax, y algunos analistas recomiendan validarlas con pruebas internas antes de cambiar defaults en producción.
- Un análisis crítico lo describe como “barato y potente, pero lento e inconsistente” en ciertos flujos, con resultados pobres en benchmarks como BridgeBench para refactorización, pese a brillar en SWE‑Bench Pro.
- Comparativas de calidad global como PostTrainBench siguen dando ventaja a Opus y GPT‑5.5, lo que sugiere que M3 todavía no sustituye completamente a los frontier más maduros en diversidad de tareas.
- Diversos autores recomiendan medir coste por tarea resuelta en tu propio entorno antes de sustituir modelos premium por M3, sobre todo en pipelines críticos o con contratos de SLA estrictos.
¿Qué modelo elegir para coding y agentes en 2026?
Si el objetivo es maximizar valor económico para agentes de largo horizonte, coding asistido y contexto extenso, MiniMax M3 es una opción muy fuerte: open‑weights, multimodal, 1M tokens y precios de modelo medio/low‑cost. En cambio, cuando el trabajo es tan crítico que un error puntual tiene impacto alto en negocio, Claude Opus y GPT‑5.x mantienen una ventaja práctica por su fiabilidad y rendimiento global más robusto.
Lo cierto es que la estrategia más razonable que sugieren muchos análisis consiste en usar M3 como default para la mayoría de llamadas de agentes y tareas de código largas, reservando Claude Opus o GPT‑5.5 para rutas de “escalado” en las que cada fallo sale caro. De esta forma se aprovecha la economía de M3 sin renunciar a la solidez de los frontier, y se mantiene flexibilidad para adaptar el ruteo según el coste por resultado correcto que observes en tus propios proyectos.




¿Y si pudieras contratar un equipo de asistentes de IA que trabajara en tu propia computadora, con tus archivos, tu navegador y el plan de ChatGPT, Claude, Gemini o Grok que ya pagas? Eso es exactamente lo que propone OpenBot, una aplicación de escritorio gratuita que convierte varios agentes de IA en compañeros de trabajo persistentes, con espacios de trabajo dedicados, colas de tareas y hasta colaboración entre agentes.

AI Website Cloner Template es una plantilla de código abierto que convierte a tu agente de IA en un clonador de sitios: le das una URL y reconstruye el sitio como una aplicación Next.js limpia y editable. Te explicamos cómo funciona, qué necesitas y cuándo conviene usarlo.
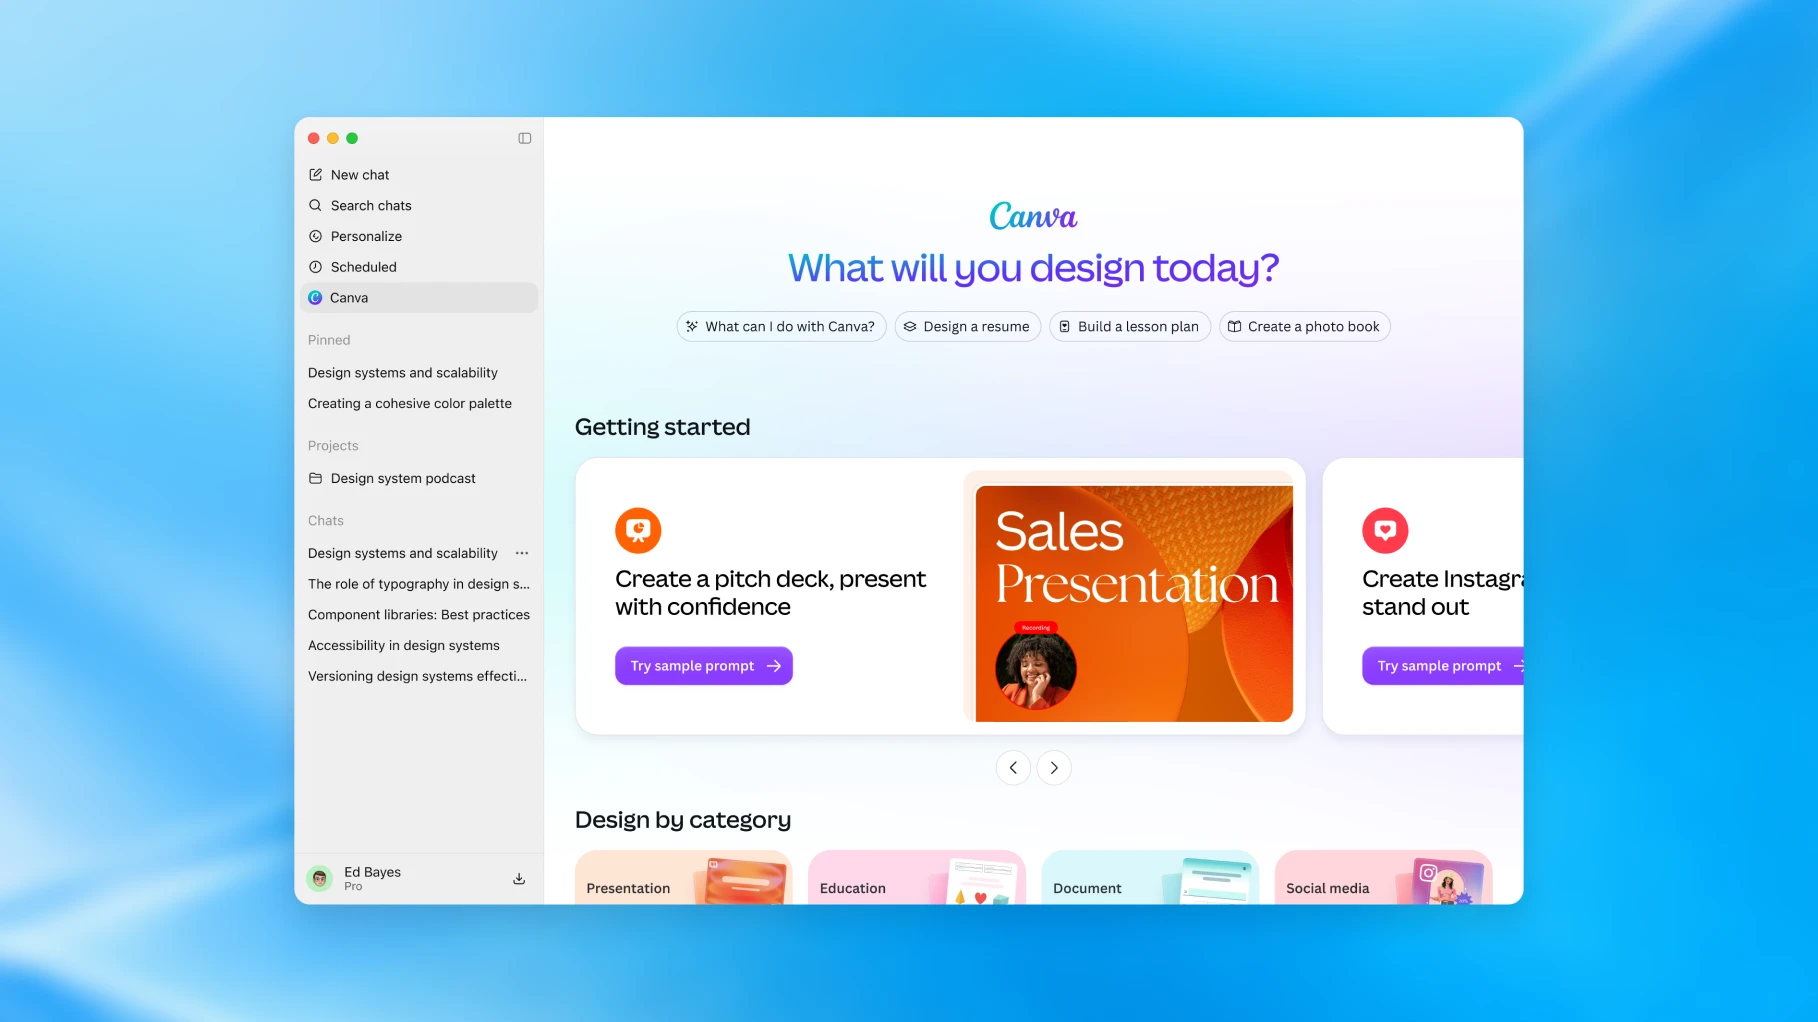
OpenAI presentó en su evento DevDay 2026 en San Francisco más de 20 novedades para ChatGPT y sus modelos, ante 2.500 desarrolladores. El anuncio central son los dots: agentes construidos con GPT-6 Astra que asumen responsabilidades continuas dentro de los límites que defina cada usuario.
-

 Apps11 años ago
AMPcast, la herramienta de Pandora que permite a los artistas grabar mensajes de audio directamente a sus seguidores
-
 Blogs5 años ago
Conoce los mejores sitios de Torrents para descargar todo tipo de contenidos
-
Android5 años ago
Aprende cómo usar Discord para ver películas con tus amigos
-
Arte y Cultura13 años ago
Colección de fondos de pantalla basados en Super Héroes
-

 Almacenamiento2 años ago
Cómo usar TeraBox: La guía definitiva para aprovechar 1 TB de almacenamiento en la nube
-
Diseño13 años ago
css3ps: plugin que convierte archivos PSD a CSS3
-
Apps9 años ago
Picturethat, app que usa la Realidad Aumentada para visualizar cómo quedarían los cuadros antes de colgarlos
-
Eventos Especiales13 años ago
Especial Día de la Madres: fondos de pantalla especiales para Mamá