

Herramientas
Hunyuan-A13B: el modelo de IA más eficiente del momento

Descubre Hunyuan-A13B, el modelo de lenguaje abierto de Tencent que supera a la competencia. Aprende cómo instalarlo, probarlo y sacarle el máximo provecho.
Hunyuan-A13B es el modelo de lenguaje abierto más avanzado de Tencent, diseñado con una arquitectura Mixture-of-Experts (MoE) que combina eficiencia, velocidad y calidad. Con 80 mil millones de parámetros totales y solo 13 mil millones activos por inferencia, logra resultados superiores a modelos como ChatGPT, Qwen y DeepSeek, y permite contextos ultra largos, razonamiento dinámico y una experiencia de usuario global sin precedentes.
¿Por qué Hunyuan-A13B marca tendencia en la IA?
- Procesamiento ultrarrápido y eficiente gracias a su arquitectura MoE.
- Capacidad de contexto de hasta 256K tokens, ideal para documentos extensos y conversaciones complejas.
- Razonamiento dinámico: adapta la profundidad de sus respuestas según la pregunta.
- Soporte para tareas de agente y llamadas a herramientas en lenguaje natural.
- Benchmarks innovadores y rendimiento superior en tareas de comprensión, matemáticas y programación.
- Accesibilidad global: código abierto, documentación y comunidad activa.
Comparativa global: Hunyuan-A13B frente a los líderes de IA
| Característica | Hunyuan-A13B | ChatGPT-4o | Qwen2-72B | DeepSeek-V2 |
|---|---|---|---|---|
| Arquitectura | MoE (Mixture-of-Experts) | MoE (No confirmado oficialmente) | Dense Transformer | MoE (Mixture-of-Experts) |
| Parámetros (Total / Activos) | 80B / 13B | N/A | 72B / 72B | 236B / 21B |
| Contexto Máximo | 256K tokens | 128K tokens | 128K tokens | 128K tokens |
| Ventaja Clave | Máxima eficiencia y velocidad | Multimodalidad nativa | Rendimiento open-source | Eficiencia de inferencia |
Guía rápida de instalación: todo lo que necesitas
Instalar y probar Hunyuan-A13B es más sencillo de lo que parece. Aquí tienes una guía paso a paso para usuarios con conocimientos básicos de Python y manejo de terminal:
- Requisitos de hardware:
- Una GPU moderna (NVIDIA A100, RTX 4090, H100 o similar) con al menos 24 GB de VRAM para pruebas locales.
- CPU potente y al menos 64 GB de RAM para manejar contextos extensos.
- Almacenamiento suficiente (al menos 50 GB libres para los pesos del modelo y dependencias).
- Herramientas necesarias:
- Python 3.10 o superior
- pip actualizado
- PyTorch (preferentemente con soporte CUDA)
- Transformers (biblioteca de Hugging Face)
- git
- Paso a paso de instalación:
- Clona el repositorio oficial:
git clone https://github.com/Tencent-Hunyuan/Hunyuan-A13B.git - Instala las dependencias:
cd Hunyuan-A13B

pip install -r requirements.txt - Descarga los pesos del modelo desde Hugging Face.
- Ejecuta un ejemplo de inferencia:
python demo_inference.py --model_path /ruta/al/modelo
- Clona el repositorio oficial:
- Documentación y soporte:
- Consulta la documentación oficial en GitHub para detalles avanzados, scripts de prueba y configuración de servidores.
¿No tienes GPU potente? Puedes probar el modelo en la nube usando plataformas como Google Colab, AWS o Azure, adaptando los pasos anteriores.
Importante: página oficial solo en chino
El sitio oficial de Hunyuan está disponible únicamente en chino. Si deseas probar el modelo directamente en la web, puedes usar traductores automáticos o acceder a la versión en Hugging Face, que ofrece una interfaz más amigable para usuarios internacionales.
Ejemplos prácticos: prompts y respuestas destacadas
Ejemplo 1: resumen de documento extenso
Prompt: “Resume en 10 puntos clave este artículo de 2000 palabras sobre política internacional.”
Respuesta: Hunyuan-A13B identifica los temas principales, agrupa los argumentos por relevancia y entrega un resumen ordenado y coherente, manteniendo el contexto y evitando repeticiones.
Ejemplo 2: generación de código avanzado
Prompt: “Crea una función en Python que procese archivos CSV grandes en paralelo y devuelva estadísticas básicas.”
Respuesta: El modelo ofrece una función optimizada con uso de multiprocessing, manejo de errores y comentarios detallados, mostrando comprensión del problema y buenas prácticas de programación.
Ejemplo 3: agente conversacional
Prompt: “Actúa como un asistente de viajes y sugiere un itinerario de 7 días en Japón, incluyendo transporte, alojamiento y actividades.”
Respuesta: Entrega un itinerario día por día, con recomendaciones de trenes, hoteles y lugares turísticos, además de consejos culturales y opciones alternativas.
Aplicaciones globales por industria
- Educación: Tutores virtuales que adaptan el contenido a cada estudiante y resuelven dudas en tiempo real.
- Salud: Asistentes para análisis de literatura médica, síntesis de historiales y apoyo en diagnóstico.
- Finanzas: Generación de resúmenes de reportes, análisis de tendencias y automatización de consultas regulatorias.
- Desarrollo de software: Ayuda en generación, revisión y documentación de código, así como en pruebas automatizadas.
- Marketing y negocios: Creación de campañas, análisis de sentimiento y generación de contenido personalizado para audiencias globales.
Guía para optimizar prompts y aprovechar el contexto largo
- Define el objetivo: Especifica claramente qué resultado esperas (“resume”, “compara”, “genera código”, etc.).
- Proporciona contexto suficiente: Aprovecha la ventana de 256K tokens para incluir antecedentes, datos o instrucciones detalladas.
- Solicita formato: Pide listas, tablas o secciones para respuestas más organizadas.
- Itera: Si la respuesta no es perfecta, ajusta el prompt con más detalles o nuevas instrucciones.
Preguntas frecuentes
¿Puedo usar Hunyuan-A13B para proyectos comerciales?
Sí, el modelo se distribuye bajo licencia Apache 2.0, permitiendo uso comercial, modificación y distribución.
¿Qué idiomas soporta?
Está optimizado para chino e inglés, pero ofrece buen desempeño en español y otros idiomas principales.
¿Qué tan seguro es para datos privados?
Al ejecutarlo localmente, tus datos no salen de tu infraestructura, lo que mejora la privacidad frente a servicios en la nube.
¿Cuánto cuesta operar el modelo?
El uso eficiente de parámetros reduce el consumo de GPU y energía, lo que disminuye costos frente a modelos densos.
¿Dónde encuentro soporte y comunidad?
En GitHub y Hugging Face hay foros, issues y documentación activa. Además, existen comunidades globales en Discord y foros de IA.
Costos y eficiencia energética
Hunyuan-A13B destaca por su bajo consumo computacional: solo el 16% de sus parámetros están activos en cada inferencia, lo que reduce el uso de GPU, el gasto energético y los costos operativos. Esto permite democratizar el acceso a IA avanzada incluso para organizaciones con recursos limitados.
Glosario de conceptos clave
- MoE (Mixture-of-Experts): Arquitectura donde solo subredes “expertas” se activan según la tarea, optimizando recursos.
- Parámetros: Variables internas del modelo que determinan su capacidad de aprendizaje y respuesta.
- Token: Unidad de texto procesada por el modelo, como una palabra o parte de ella.
- Inferencia: Proceso de generar una respuesta usando el modelo ya entrenado.
- Benchmark: Prueba estandarizada para medir el rendimiento de los modelos de IA.
- Ventana de contexto: Cantidad máxima de texto que el modelo puede analizar en una sola interacción.
- Licencia Apache 2.0: Permite uso, modificación y distribución comercial del software.
- GPU: Unidad de procesamiento gráfico, esencial para cálculos de IA.
- Inferencia local: Ejecutar el modelo en tu propio hardware, sin depender de la nube.
- Hugging Face: Plataforma líder para compartir y probar modelos de IA de código abierto.
Recursos oficiales y comunidad global
- Página oficial (en chino): hunyuan.tencent.com
- Repositorio GitHub: Tencent-Hunyuan/Hunyuan-A13B
- Modelo en Hugging Face: Hunyuan-A13B-Instruct
- Benchmarks: C3-Bench y ArtifactsBench
- Comunidad internacional: Foros de IA, Discord, Hugging Face Spaces y grupos en X (Twitter).
Conclusión
Hunyuan-A13B representa un salto en eficiencia, escalabilidad y accesibilidad para la inteligencia artificial global. Su arquitectura MoE, soporte para contextos ultra largos y bajo costo computacional lo convierten en una opción ideal para desarrolladores, empresas y entusiastas que buscan IA avanzada sin barreras. Explora sus capacidades, pruébalo en local o en la nube y únete a la comunidad que está definiendo el futuro de la IA abierta.




CapCut participará en México Tech Week 2026 con el CapCut Design Studio: Speed-to-Scale Hackathon, una activación gratuita para crear en cuatro horas una pieza lista para mostrar usando herramientas de IA. El cupo es de 30 lugares con registro previo.

El proyecto open source dsv41-flash-offload logra servir DeepSeek V4.1 Flash, un modelo de unos 200GB en expertos, desde una única RTX 3090 de 24GB apoyada en RAM DDR4 y NVMe, con API compatible con OpenAI y contexto de 262,144 tokens.
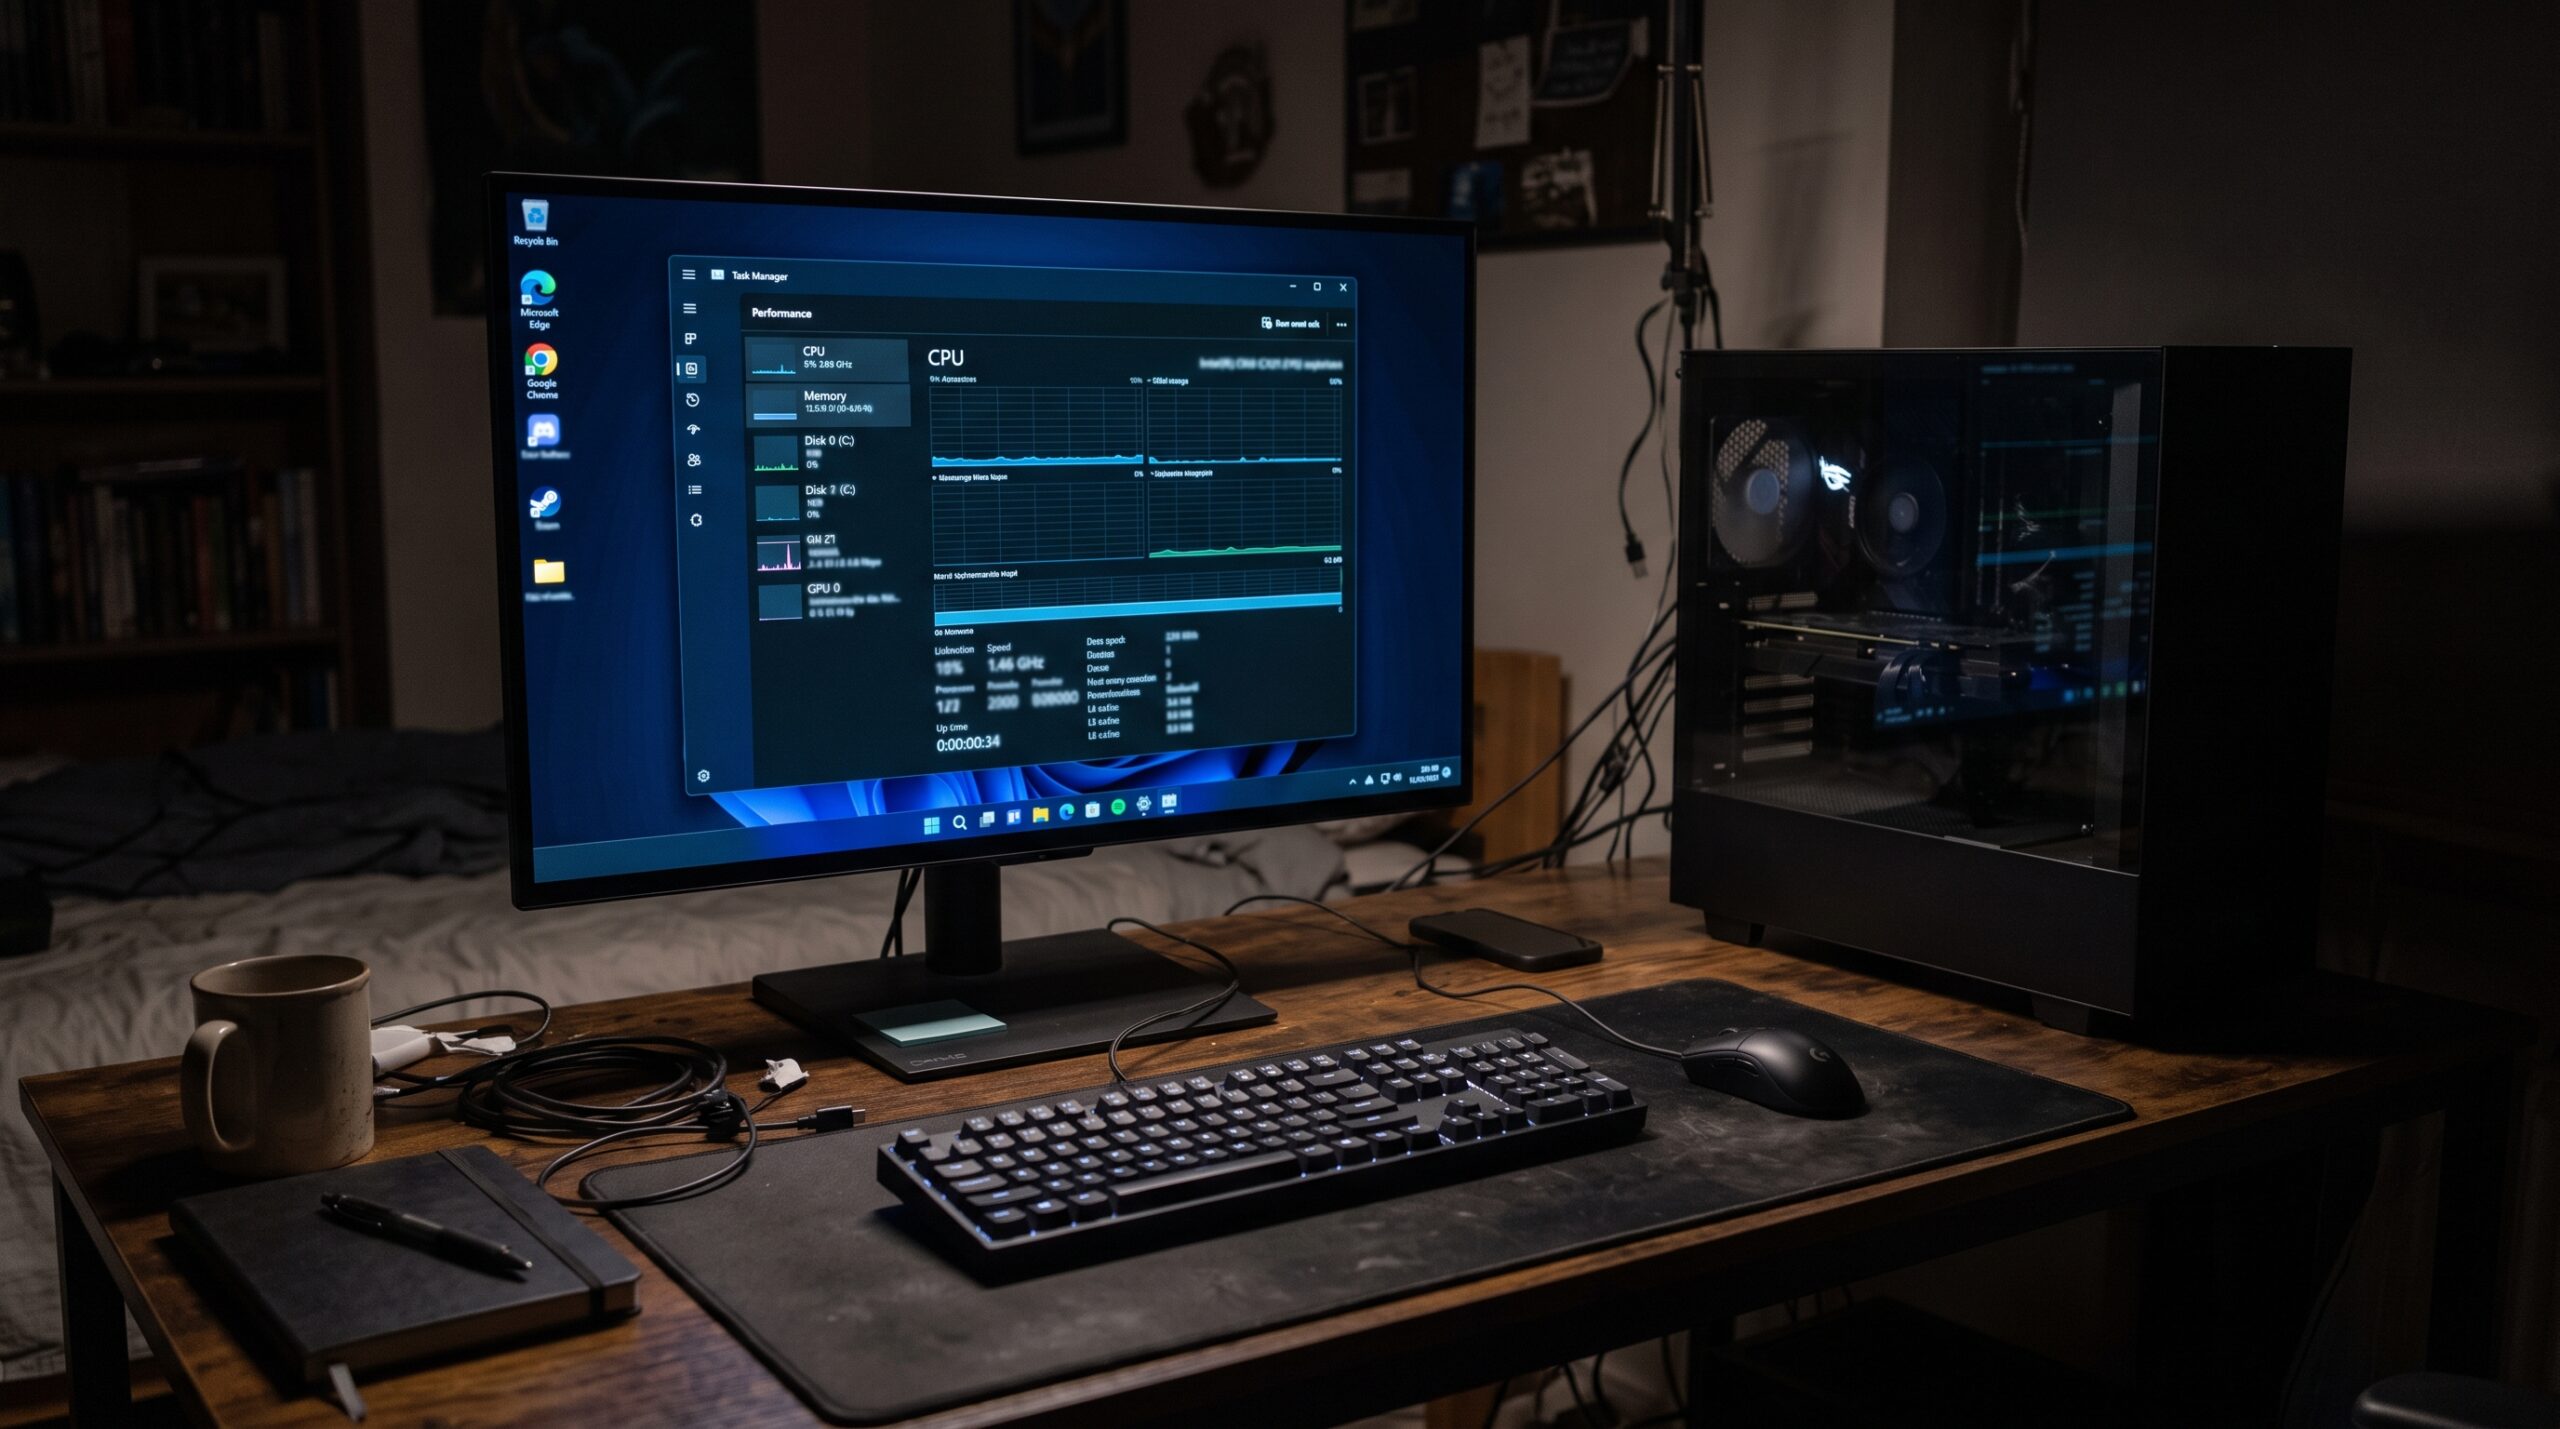
El usuario @soyaakinohara6 compartió en X una instalación de Windows 11 que consume apenas 2.5GB de 16GB de RAM en reposo, un 16 por ciento de utilización. El método: instalar con Rufus, eliminar todo el bloatware y luego aplicar la actualización 26H2.
-

 Apps11 años ago
AMPcast, la herramienta de Pandora que permite a los artistas grabar mensajes de audio directamente a sus seguidores
-
 Blogs5 años ago
Conoce los mejores sitios de Torrents para descargar todo tipo de contenidos
-
Android5 años ago
Aprende cómo usar Discord para ver películas con tus amigos
-
Arte y Cultura14 años ago
Colección de fondos de pantalla basados en Super Héroes
-

 Almacenamiento2 años ago
Cómo usar TeraBox: La guía definitiva para aprovechar 1 TB de almacenamiento en la nube
-
Diseño13 años ago
css3ps: plugin que convierte archivos PSD a CSS3
-
Apps9 años ago
Picturethat, app que usa la Realidad Aumentada para visualizar cómo quedarían los cuadros antes de colgarlos
-
Eventos Especiales13 años ago
Especial Día de la Madres: fondos de pantalla especiales para Mamá