
Actualización
LM Studio Bionic vs Claude: guía para migrar con más control y costos predecibles

Para quienes ya trabajan con Claude y buscan una estructura más flexible, LM Studio Bionic aparece como una alternativa relevante. Su propuesta no se basa en replicar el ecosistema de Anthropic, sino en ofrecer un entorno capaz de combinar modelos locales, ejecución híbrida y flujos de trabajo más controlados, especialmente útil para documentos, código y automatización.
¿Por qué LM Studio Bionic es una alternativa real a Claude?
Claude mantiene una posición sólida en experiencia integrada, razonamiento prolongado y madurez general. Sin embargo, Bionic avanza por una ruta distinta: en lugar de concentrar toda la operación en un solo ecosistema, permite decidir cuándo usar inferencia local, cuándo recurrir a modelos en la nube y qué parte del flujo debe permanecer en el equipo por privacidad o control.
Esta diferencia modifica el punto de comparación. La decisión ya no depende únicamente de qué modelo responde mejor en términos absolutos, sino de qué herramienta ofrece mejores condiciones para construir una operación sostenible. Desde esa perspectiva, Bionic destaca por cuatro razones:
- Privacidad: Permite ejecutar modelos en local para tareas donde la confidencialidad es prioritaria.
- Flexibilidad: Ofrece acceso a modelos abiertos en la nube cuando el trabajo supera el margen razonable del hardware disponible.
- Automatización: Integra herramientas como MCP y Skills para convertir tareas repetitivas en procesos reutilizables.
- Costos modulables: Facilita una lógica de gastos más flexible, ideal para equipos que buscan ahorrar en proyectos de IA sin sacrificar calidad.
Bionic no es una extensión menor de LM Studio clásico, sino una aplicación independiente, construida sobre el mismo runtime, pero orientada a convertir modelos abiertos en agentes de trabajo dentro de proyectos concretos.
¿Qué ofrece la versión más reciente de Bionic?
La versión pública más reciente es Bionic 1.1.1. Esta actualización ha consolidado tres avances clave:
- Estabilidad y velocidad: La experiencia general del agente ha ganado en solidez y rapidez.
- Skills integrados: Los Skills ya forman parte del flujo habitual de trabajo, no de una función secundaria.
- Manejo de sesiones: Permisos y archivos ofrecen una estructura más consistente para tareas reales de código y documentación.
Con estos cambios, Bionic deja de ser una promesa para entusiastas y se posiciona como una herramienta viable en flujos profesionales donde importan el control del entorno, la reutilización de procesos y la reducción de dependencia de servicios cerrados.
¿Cómo se compara LM Studio Bionic con Claude?
Tabla comparativa:
| Característica | Claude | LM Studio Bionic |
|---|---|---|
| Enfoque principal | Experiencia integrada dentro del ecosistema Anthropic. | Agente para modelos abiertos con ejecución local, remota o en la nube. |
| Privacidad operativa | Depende del plan, la retención y la configuración aplicable. | Permite procesamiento local; en la nube, comunicaciones con Zero Data Retention por defecto. |
| Flexibilidad de modelos | Se concentra en la familia Claude. | Combina modelos locales compatibles con LM Studio y modelos abiertos en Secure Cloud. |
| Integraciones | Muy maduras dentro del producto y sus conectores. | Integra MCP, Skills, trabajo con archivos, shell y sesiones sobre proyectos. |
| Estructura de costos | Suscripciones, límites y créditos según el modelo y el plan. | Uso local sin costo en la nube y pago por consumo en modelos remotos. |
| Perfil de uso | Ideal para quienes priorizan pulido general, consistencia y capacidad de frontera. | Ideal para quienes priorizan control, arquitectura híbrida y costos modulables. |
¿Qué modelos locales funcionan en PCs con 8 GB a 12 GB de VRAM?
En hardware con 8 GB a 12 GB de VRAM, algunos modelos locales pueden ofrecer resultados competitivos en tareas delimitadas, como redacción, clasificación, extracción de datos, revisión documental, automatización ligera y primera pasada de código. Sin embargo, este rendimiento no equivale al comportamiento de Claude Fable 5.1 en sesiones largas o razonamiento profundo.
La clave está en elegir el modelo más eficiente para el hardware disponible. En este terreno, los modelos Mixture-of-Experts (MoE) y las variantes low-bit son especialmente relevantes, ya que permiten alcanzar un nivel alto de utilidad con un consumo de memoria mucho más contenido.
Modelos recomendados:
| Modelo o familia | Tipo | Encaje práctico en 8 GB a 12 GB de VRAM | Fortaleza principal | Límite frente a Claude |
|---|---|---|---|---|
| Bonsai 27B 1-bit / ternary | Low-bit derivado de Qwen3.6 27B | Muy favorable. Footprints bajos para el modelo de lenguaje. | Resumen, análisis estructurado, tareas de agente medias y productividad diaria. | No alcanza el mismo nivel en razonamiento prolongado ni en tareas largas y ambiguas. |
| Gemma 4 E4B | Denso eficiente | Muy cómodo para hardware común. | Clasificación, borradores, soporte documental y tareas rápidas. | Funciona como reemplazo parcial, no como equivalente de frontera. |
| Gemma 4 26B A4B | MoE | Interesante cerca del techo del rango, siempre con cuantización y contexto prudente. | Equilibrio entre velocidad, herramientas y riqueza funcional. | Su viabilidad depende más del ajuste técnico que en modelos más pequeños. |
| Qwen3.5 35B A3B / Qwen3.6 35B A3B | MoE | Más razonables en 12 GB bien ajustados que en 8 GB estrictos. | Código, uso de herramientas y trabajo técnico más ambicioso. | No sostienen la misma consistencia que Claude en sesiones extensas. |
| Qwen3-Coder-30B-A3B-Instruct | MoE para coding agent | Muy atractivo para usuarios técnicos con cuantización adecuada. | Repositorios acotados, refactors pequeños y documentación técnica. | Se queda por debajo en proyectos muy extensos o con alta ambigüedad. |
En resumen, en hardware de 8 GB a 12 GB de VRAM, sí existen modelos locales capaces de resolver una parte importante del trabajo diario con un nivel competitivo. La diferencia está en que esa capacidad debe entenderse por tarea y no como equivalencia total frente a un modelo premium de frontera.
¿Por qué los modelos MoE son tan importantes en Bionic?
Los modelos Mixture-of-Experts (MoE) permiten una relación especialmente atractiva entre calidad percibida, consumo de memoria y velocidad efectiva. En lugar de activar toda la red en cada token, solo emplean una fracción de su capacidad total. Para hardware de escritorio, esta arquitectura resulta útil porque acerca comportamientos más ricos sin exigir el costo completo de un modelo denso.
Dentro del ecosistema de LM Studio, Bionic convive con varias familias donde esta lógica ya es central, como Qwen3, Qwen3.5 en variantes A3B, Qwen3-Coder-30B-A3B, Gemma 4 26B A4B y GLM-4.7-Flash 30B-A3B. Para quienes evalúan migrar desde Claude, este punto modifica la percepción del producto: Bionic no solo admite modelos locales, sino que se apoya en una generación de modelos abiertos mucho más madura y eficiente.
¿Cómo se manejan los Skills en Bionic?
En la versión actual, los Skills ya no funcionan como un añadido menor, sino que forman parte del flujo central de trabajo. Su función es precisa: encapsular un método, una tarea repetible o una capacidad especializada para que el agente la reutilice sin necesidad de repetir instrucciones extensas en cada conversación.
Este cambio aporta dos beneficios claros:
- Reducción de dependencia: Minimiza la necesidad de prompts largos, frágiles y difíciles de mantener.
- Estabilidad: Permite trasladar flujos ya probados a un formato más estable.
Para quienes vienen de Claude, la ventaja es evidente: la migración no obliga a reconstruir desde cero todo el conocimiento operativo si ese trabajo ya puede convertirse en una biblioteca de Skills reutilizables.
¿Cómo se crean, instalan e importan los Skills?
Bionic ofrece una transición natural entre conversación, reutilización y biblioteca. En la versión actual, el agente puede usar, instalar, crear e importar Skills sin separar ese proceso del trabajo diario.
Acciones disponibles:
| Acción | Cómo funciona en Bionic | Valor práctico |
|---|---|---|
| Usar un Skill | Se invoca con @ dentro del chat y Bionic lo carga según el contexto. | Permite aplicar rutinas repetibles sin reescribir el método completo. |
| Crear un Skill | Puede pedirse al agente que lo genere a partir de una conversación o una tarea ya resuelta. | Convierte una buena sesión en un proceso reutilizable. |
| Instalar un Skill | Puede instalarse desde una URL o mediante comandos como /install-skill. | Facilita incorporar flujos publicados por terceros o por el propio equipo. |
| Importar desde otras apps | En Settings > Skills > Skills from other apps se gestionan Skills visibles desde otras herramientas compatibles. | Reduce la fricción al migrar desde entornos como Claude Code o Codex. |
| Cargar un SKILL.md | Puede añadirse manualmente desde Settings > Skills. | Permite mantener bibliotecas propias en formato estándar. |
¿Cómo migrar desde Claude sin perder productividad?
Una migración ordenada no comienza con la descarga de modelos, sino con la identificación de tareas. Primero conviene separar qué procesos se repiten, cuáles exigen privacidad local y cuáles justifican el uso de modelos en la nube. A partir de ahí, resulta más sencillo asignar cada parte del flujo al recurso adecuado.
La transición suele ser más fluida cuando sigue esta secuencia:
- Convertir prompts, criterios y rutinas repetitivas en Skills.
- Elegir un modelo local base para la mayor parte del trabajo cotidiano.
- Reservar los modelos cloud de Bionic para tareas largas, técnicas o ambiguas.
- Mover primero tareas acotadas y dejar para el final los procesos más críticos.
En ese punto, la relación con Claude Code también cambia. En lugar de plantear un reemplazo total, muchas operaciones pueden repartirse: Claude para las tareas más exigentes en juicio y Bionic para la base recurrente del trabajo operativo.
¿Cómo se comparan los costos de Bionic y Claude?
La comparación más útil no se limita a enfrentar una suscripción con una herramienta gratuita. El contraste más revelador aparece al revisar el costo por token cuando el trabajo requiere modelos de alta capacidad.
Costos por millón de tokens:
| Modelo | Input por millón | Cached o cache read | Output por millón | Lectura práctica |
|---|---|---|---|---|
| Claude Fable 5.1 | 10 USD | 0.25 USD | 50 USD | Modelo premium para trabajo de agente de máxima exigencia. |
| Claude Sonnet 5 | 2 USD | 0.20 USD | 10 USD | Opción más equilibrada dentro del ecosistema Claude para uso general. |
| Kimi K3 en Bionic | 3 USD | 0.30 USD | 15 USD | Más económico que Fable 5.1 para cargas exigentes. |
| GLM-5.3 en Bionic | 1.40 USD | 0.14 USD | 4.40 USD | Muy competitivo en relación precio-capacidad. |
| DeepSeek V4 Pro en Bionic | 1.74 USD | 0.15 USD | 3.48 USD | Alternativa fuerte para trabajo técnico intensivo con costo moderado. |
| Kimi-K2.7-Code en Bionic | 0.95 USD | 0.16 USD | 4 USD | Opción especialmente atractiva para coding agent con presupuesto contenido. |
Costo aproximado para 2 millones de tokens de entrada y 500 mil de salida:
| Modelo | Costo aproximado | Lectura rápida |
|---|---|---|
| Claude Fable 5.1 | 45 USD | Referencia premium de mayor costo. |
| Claude Sonnet 5 | 9 USD | Más equilibrado para uso general dentro de Claude. |
| Kimi K3 en Bionic | 13.5 USD | Más económico que Fable 5.1 para cargas exigentes. |
| GLM-5.3 en Bionic | 5 USD | Muy competitivo en costo y capacidad. |
| DeepSeek V4 Pro en Bionic | 5.22 USD | Buena alternativa para trabajo técnico intensivo. |
| Kimi-K2.7-Code en Bionic | 3.9 USD | Una de las rutas más económicas para desarrollo asistido. |
Este contraste no implica que Claude deje de tener sentido. Lo que muestra es que Bionic permite diseñar una arquitectura de costos más flexible, donde los modelos premium pueden reservarse para las tareas realmente difíciles y el resto del flujo puede apoyarse en opciones locales o cloud considerablemente más baratas.
¿Qué ocurre al comparar Bionic con Claude Pro?
Claude Pro mantiene un precio base competitivo para muchos perfiles, pero esto no equivale a acceso ilimitado a Claude Fable 5.1. En la línea actual, Fable 5.1 funciona con usage credits en varios escenarios, por lo que el costo total puede crecer más allá de la suscripción mensual cuando una operación depende de ese modelo con frecuencia.
Frente a ello, Bionic propone otra lógica:
- Trabajo local: No añade costo cloud.
- Trabajo remoto: Se paga por consumo.
- Modelos abiertos: Las partes más pesadas del flujo pueden resolverse con modelos cuyas tarifas son más bajas.
Para equipos que administran costos con precisión, esta diferencia resulta más útil que una comparación superficial entre planes de entrada.
¿Para quién tiene más sentido migrar a Bionic?
Bionic resulta especialmente atractivo para:
- Desarrolladores y equipos pequeños que buscan una mezcla racional entre privacidad, costo y control técnico.
- Usuarios avanzados que se benefician de una capa de procesos reutilizables, algo que los Skills refuerzan de manera clara.
En cambio, quienes priorizan una experiencia más cerrada, un razonamiento sostenido en el nivel más alto del mercado y una menor necesidad de configuración probablemente seguirán encontrando en Claude una opción más directa.
¿Vale la pena migrar a LM Studio Bionic?
La respuesta depende del tipo de operación que cada equipo quiera construir. Si la prioridad es obtener la experiencia más pulida posible dentro de un solo proveedor, Claude mantiene una posición muy sólida. Pero si el objetivo es articular una estructura más flexible, con alternativas a Ollama, modelos locales, ejecución híbrida y procesos reutilizables, Bionic ya puede considerarse una plataforma seria.
Su valor principal no está en superar a Claude en todos los frentes, sino en cambiar la ecuación económica y operativa del trabajo con IA. En hardware común de 8 GB a 12 GB de VRAM, esa diferencia resulta especialmente útil: no porque permita sustituir por completo a un modelo frontier, sino porque vuelve posible absorber una parte importante del trabajo diario con más control, mayor privacidad operativa y costos más previsibles.
Lo más leído en Actualización






OpenAI lanza GPT-Live-1.1 y GPT-Live-1.1 Quip, una actualización que hace las conversaciones cotidianas de ChatGPT Voice más naturales en diversos idiomas. Los usuarios en México reciben Tinta y Arrullo, dos nuevas voces en español de México, junto con mejor comprensión de acentos y respuestas más variadas.
Lo más leído en Actualización
El usuario @soyaakinohara6 compartió en X una instalación de Windows 11 que consume apenas 2.5GB de 16GB de RAM en reposo, un 16 por ciento de utilización. El método: instalar con Rufus, eliminar todo el bloatware y luego aplicar la actualización 26H2.
Lo más leído en Actualización
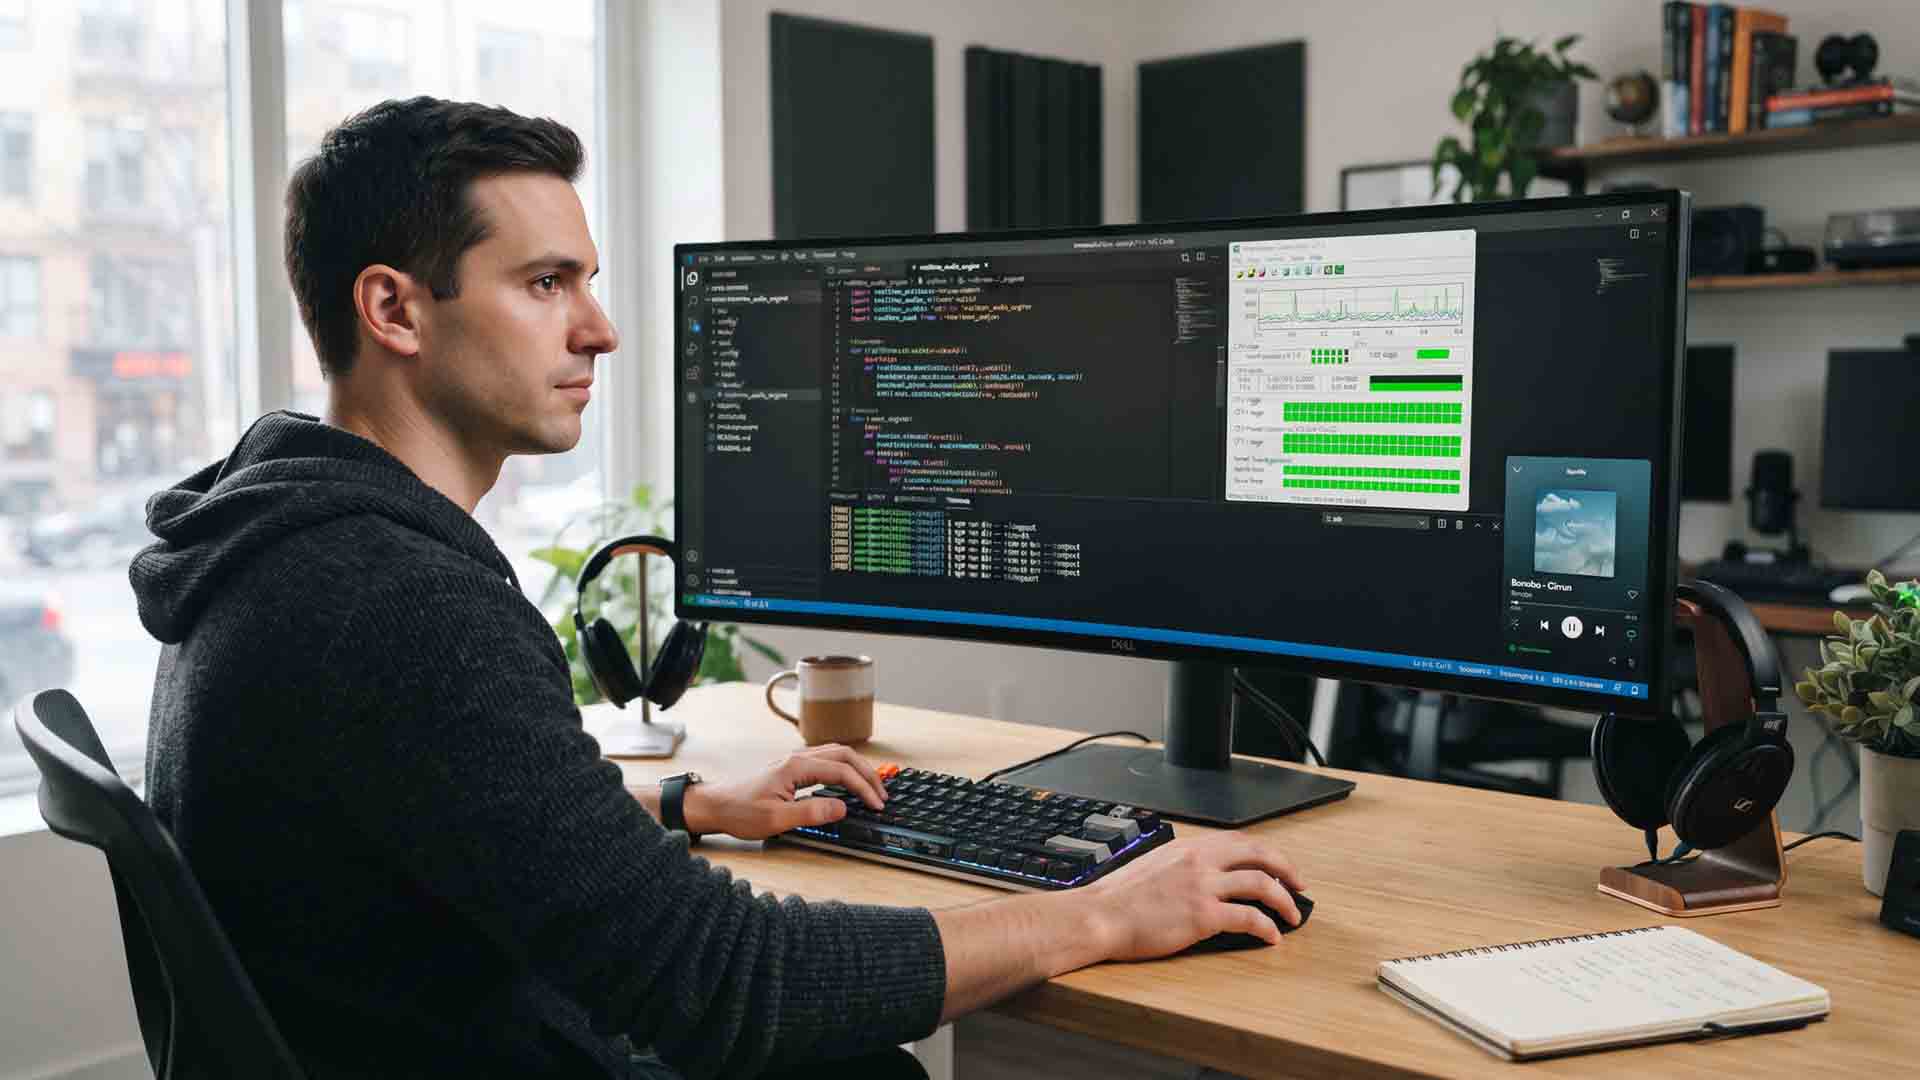
Tu PC puede tener hardware de sobra y aun así sentirse lenta: tirones en los juegos, chasquidos en el audio, un ratón que se atasca. La causa suele ser un controlador que retiene el procesador más de la cuenta. LatencyMon, una herramienta gratuita para Windows, te dice exactamente cuál es el culpable. Te explicamos cómo usarla.
Lo más leído en Actualización
Lo más leído
-
 Consola
Nintendo Switch 2 fue liberada por primera vez con ayuda de la IA
-
 Entretenimiento
Revisión: Terry’s Terraforming – Planetas en realidad virtual
-
 Apps
Claude Duet vs Hermes Agent la carrera del agente de IA proactivo
-
 Curiosidades
Un flag de llama.cpp permite correr un modelo 35B en 8GB de VRAM
-
 Desarrolladores
PHP2Shell: vulnerabilidades detectadas con IA afectan 70% de la web
-

 Apps11 años ago
AMPcast, la herramienta de Pandora que permite a los artistas grabar mensajes de audio directamente a sus seguidores
-
 Blogs5 años ago
Conoce los mejores sitios de Torrents para descargar todo tipo de contenidos
-
Android5 años ago
Aprende cómo usar Discord para ver películas con tus amigos
-
Arte y Cultura14 años ago
Colección de fondos de pantalla basados en Super Héroes
-

 Almacenamiento2 años ago
Cómo usar TeraBox: La guía definitiva para aprovechar 1 TB de almacenamiento en la nube
-
Diseño13 años ago
css3ps: plugin que convierte archivos PSD a CSS3
-
Apps9 años ago
Picturethat, app que usa la Realidad Aumentada para visualizar cómo quedarían los cuadros antes de colgarlos
-
Eventos Especiales13 años ago
Especial Día de la Madres: fondos de pantalla especiales para Mamá