
Apple
Muse Voice Transcribe el primer modelo de audio en tiempo real de Meta

Meta lanza Muse Voice Transcribe, su primer modelo de audio en tiempo real con diarización para 20+ hablantes y soporte multilingüe. Un avance en transcripción de voz con IA que redefine la interacción humana con la tecnología.
Imagina poder transcribir una conversación en tiempo real, con 20 personas hablando al mismo tiempo, en varios idiomas y sin perder precisión. Muse Voice Transcribe, desarrollado por los Laboratorios de Superinteligencia de Meta, hace esto posible. Este modelo pionero no solo transcribe audio, sino que también identifica quién habla (diarización) y detecta cuándo termina cada intervención (detección de puntos finales), todo en tiempo real y con soporte para más de 70 idiomas.
¿Qué es Muse Voice Transcribe?
Muse Voice Transcribe es el primer modelo de percepción de audio en tiempo real de Meta, diseñado para ofrecer transcripción automática de voz a texto (ASR) con capacidades avanzadas. A diferencia de modelos tradicionales, este sistema destaca por:
- Transcripción en tiempo real: Procesa audio en bloques de 80 ms, emitindo texto casi al instante.
- Diarización para 20+ hablantes: Identifica y diferencia las voces de múltiples personas en una conversación.
- Detección de puntos finales: Reconoce cuándo un hablante termina su intervención.
- Soporte multilingüe: Compatible con más de 70 idiomas, con 25 validados oficialmente por Meta, y capaz de manejar code-switching (cambio de idioma dentro de una misma oración).
- Contexto largo: Procesa audios de más de una hora sin necesidad de posprocesamiento.
Según la documentación oficial de Meta, este modelo ocupa el primer lugar en los benchmarks de Artificial Analysis para transcripción en tiempo real y diarización, gracias a su precisión y velocidad. Lo cierto es que su capacidad para adaptar dinámicamente el retraso de transcripción según la dificultad de cada palabra lo sitúa en la frontera de Pareto entre velocidad y exactitud.

¿Cómo funciona el modelo?
Muse Voice Transcribe pertenece a la familia de modelos Muse Spark y utiliza un enfoque autoregresivo multimodal. Aquí te explicamos su funcionamiento:
Procesamiento de audio en tiempo real
El audio se divide en bloques de 80 ms (12.5 Hz). Cada bloque se transforma en un token blando. En cada paso, el modelo decide si:
- Continuar escuchando el siguiente bloque de audio (emitiendo un token especial
<|next_audio|>). - Emitir un token de texto (para transcribir lo escuchado).
Cuando el flujo de audio se detiene, se inserta un token <|empty_audio|> para indicar que no hay más audio. El modelo entonces emite todos los tokens de texto restantes.
El retraso adaptativo es clave: el modelo ajusta dinámicamente cuánto audio necesita escuchar antes de transcribir una palabra. Esto se logra mediante aprendizaje por refuerzo, donde se combinan recompensas por Word Error Rate (WER) y retraso. Así, Muse Voice Transcribe logra un equilibrio óptimo entre velocidad y precisión.

Diarización y detección de puntos finales
Para la diarización, el modelo introduce tokens especiales:
<|start_of_turn|>: Marca un posible cambio de hablante.<|speaker_{A-Z}|>: Diferencia al hablante (ej:<|speaker_A|>).
Ejemplo de secuencia para diarización (simplificado):
<|start_of_turn|>Hola, ¿cómo estás?<|speaker_A|><|start_of_turn|>Bien, ¿y tú?<|speaker_B|>Para la detección de puntos finales, se usan:
<|speech_onset|>: Inicio del habla.<|speech_endpoint|>: Fin del habla.

Capacidades destacadas
Cobertura de idiomas
Muse Voice Transcribe está entrenado con más de 70 idiomas, de los cuales 25 están extensamente validados. En su lanzamiento inicial, Meta recomienda probar estos 25 idiomas, aunque el soporte para otros también está disponible.
El modelo soporta naturalmente la alternancia de idiomas (code-switching), ya sea dentro de una oración o entre oraciones. Además, utiliza biasing de contexto, lenguaje y palabras clave para mejorar la precisión. Por ejemplo, si mencionas “Meta”, “Muse” o “Menlo Park”, el modelo los reconoce correctamente porque entiende tu contexto.
Contexto largo
Una de las ventajas más significativas es su capacidad para procesar audios largos de más de una hora con 20 o más hablantes, sin requerir posprocesamiento. Esto lo hace ideal para:
- Reuniones extensas.
- Podcasts con múltiples participantes.
- Eventos en vivo con interacciones complejas.
¿Dónde está disponible?
Muse Voice Transcribe ya está disponible a través de:
- Meta AI para Mac.
- Meta Model API.
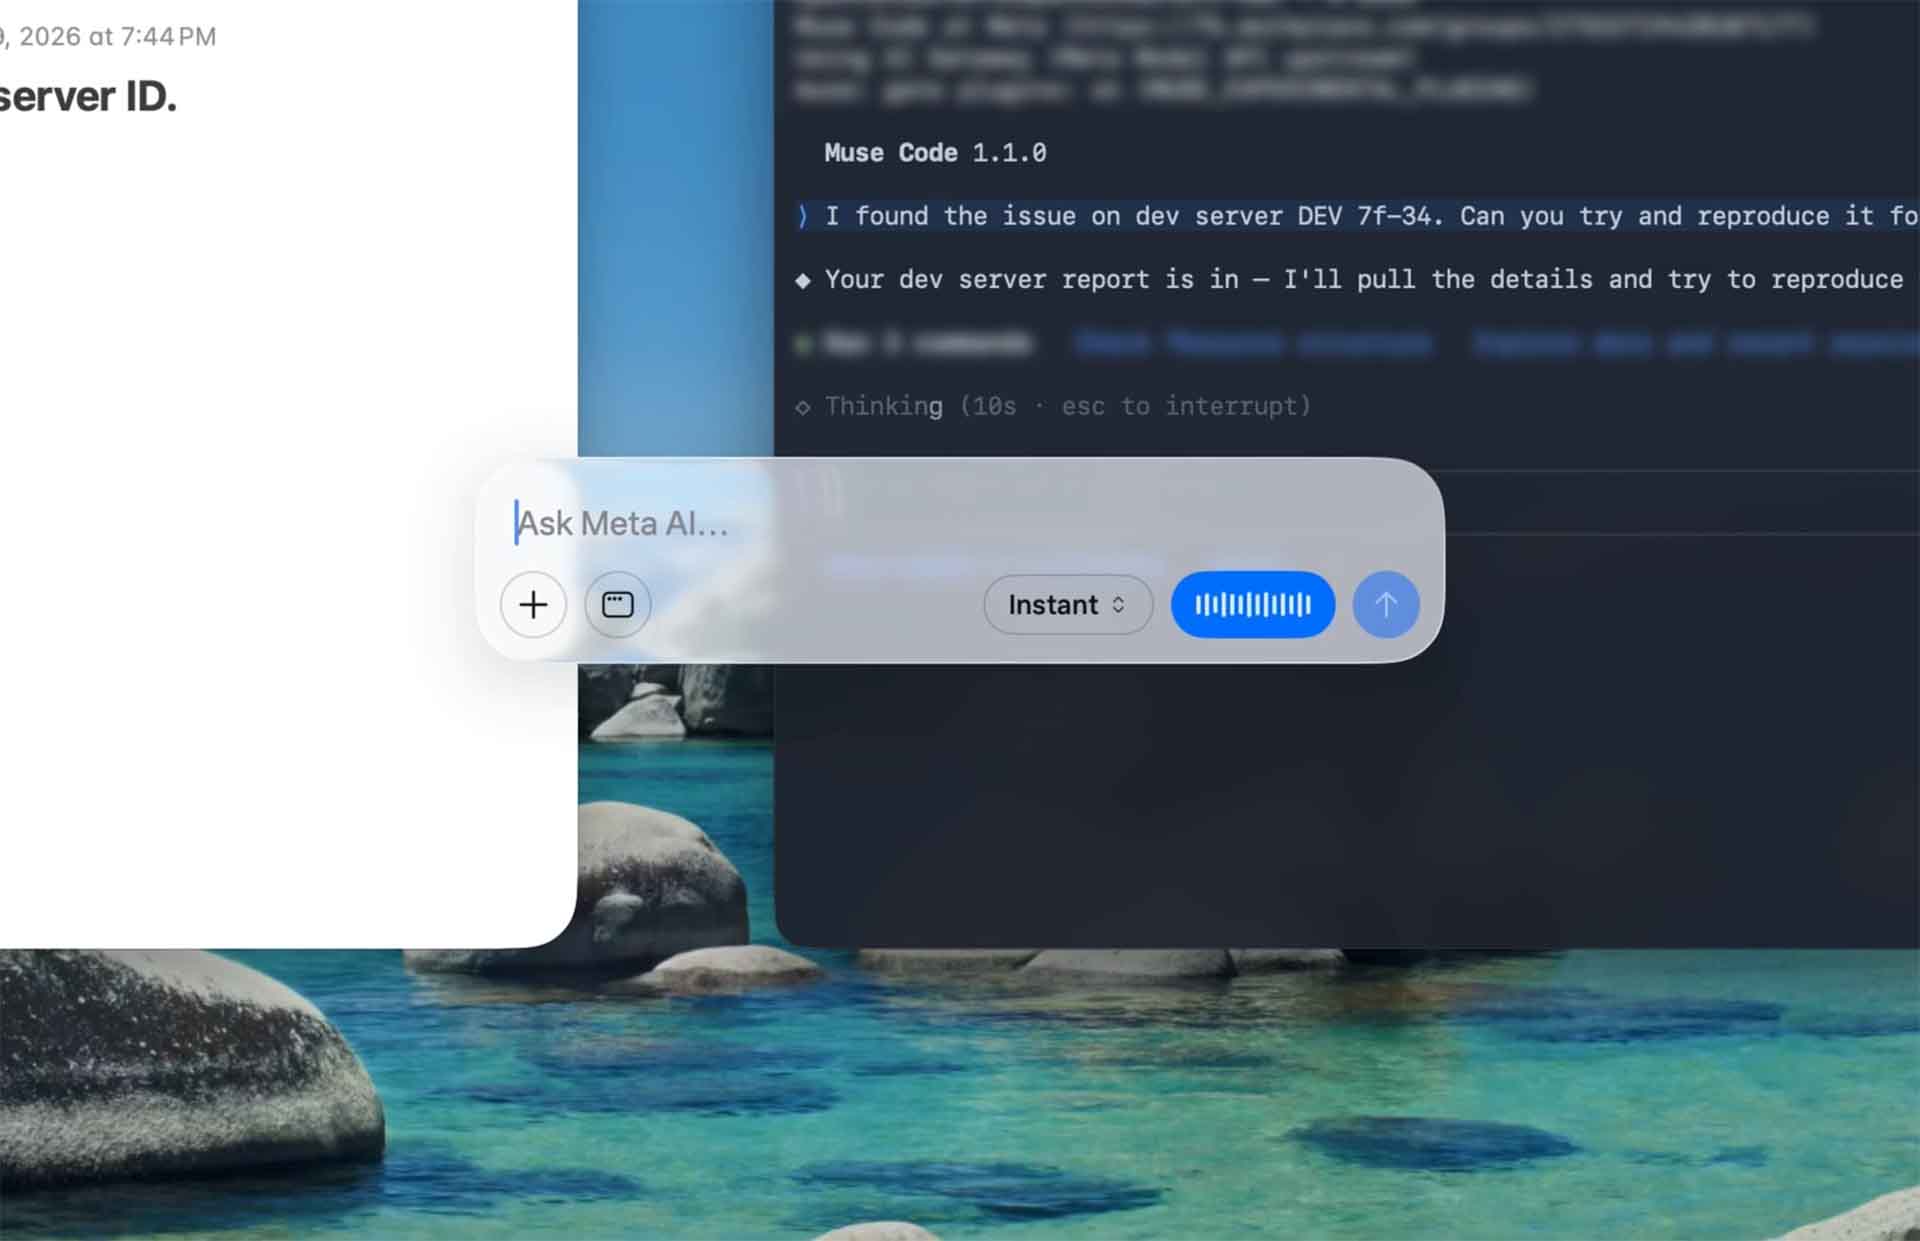
- Muse Code (para desarrolladores).
Además, ya está integrado en Meta AI y Muse Code, permitiendo dictado por voz en tiempo real con solo mantener presionada la tecla Fn.
Comparación con otros modelos
Si bien existen otros modelos de transcripción como Gemini 3.5 Transcribe de Google, Muse Voice Transcribe destaca por su enfoque en la diarización en tiempo real y su capacidad para manejar conversaciones caóticas con solapamientos, interrupciones y acentos variados. Esto lo hace especialmente útil para entornos donde la interacción humana es compleja y dinámica.
En el ámbito de la aplicación de la voz en la IA, este modelo representa un salto cualitativo. Mientras que otros sistemas se enfocan en comandos de voz simples, Muse Voice Transcribe permite transcribir conversaciones naturales, con todo su desorden y riqueza.
Para quienes buscan modelos multimodales como Qwen3.5-Omni, es importante señalar que Muse Voice Transcribe se especializa en audio, ofreciendo un rendimiento superior en tareas específicas de transcripción y diarización.






Los smartphones nuevos vienen cargados con aplicaciones preinstaladas, pero esta comodidad suele tener un costo oculto en términos de privacidad. Desde utilidades del fabricante hasta aplicaciones de terceros, muchas de ellas pueden nunca usarse y, sin embargo, siguen activas en segundo plano. La realidad es que este bloatware aumenta la recolección de datos y puede recopilar información personal que el usuario nunca pretendió compartir. Un estudio de Surfshark analiza qué es lo que realmente se oculta en la pantalla de inicio de tu dispositivo.

iOS 27 ya está disponible y su propuesta va más allá del cambio anual de costumbre. Apple reorganiza parte de la experiencia del iPhone alrededor de Siri AI, Apple Intelligence y una serie de mejoras concretas en Fotos, Safari, Wallet, Salud, Mensajes y CarPlay. Esta guía reúne 29 novedades y aclara algo esencial antes de actualizar: no todas se activan en todos los modelos, ni en todos los idiomas, ni en todos los mercados.
-

 Apps11 años ago
AMPcast, la herramienta de Pandora que permite a los artistas grabar mensajes de audio directamente a sus seguidores
-
 Blogs5 años ago
Conoce los mejores sitios de Torrents para descargar todo tipo de contenidos
-
Android5 años ago
Aprende cómo usar Discord para ver películas con tus amigos
-
Arte y Cultura13 años ago
Colección de fondos de pantalla basados en Super Héroes
-

 Almacenamiento2 años ago
Cómo usar TeraBox: La guía definitiva para aprovechar 1 TB de almacenamiento en la nube
-
Diseño13 años ago
css3ps: plugin que convierte archivos PSD a CSS3
-
Apps9 años ago
Picturethat, app que usa la Realidad Aumentada para visualizar cómo quedarían los cuadros antes de colgarlos
-
Eventos Especiales13 años ago
Especial Día de la Madres: fondos de pantalla especiales para Mamá