

Digitalización
Gemma 4: la inteligencia artificial multimodal llega a tus dispositivos NVIDIA

¿Imaginas ejecutar un modelo de inteligencia artificial capaz de analizar videos, traducir audio en tiempo real y generar código, todo en tu Jetson Orin Nano o computadora con tarjeta RTX, sin depender de la nube?
Gemma 4 de Google DeepMind lo hace posible. Esta nueva familia de modelos de código abierto no solo mejora el rendimiento en razonamiento y generación de código, sino que integra capacidades multimodales nativas para procesar texto, imagen, audio y video en un solo sistema. Con cuatro variantes optimizadas, desde modelos ultraeficientes para dispositivos edge hasta soluciones de alto rendimiento para centros de datos, Gemma 4 promete llevar la inteligencia artificial avanzada a cualquier entorno, con soberanía total sobre los datos y sin restricciones de licencia.
La clave de Gemma 4 radica en su arquitectura Mixture of Experts (MoE) y su compatibilidad con hardware de NVIDIA, que permite desplegar modelos en una amplia gama de sistemas, desde tarjetas gráficas para consumidores hasta supercomputadoras personales. Además, su licencia Apache 2.0 elimina las barreras legales que limitaban el uso comercial en versiones anteriores, ofreciendo a desarrolladores y empresas la flexibilidad para innovar sin depender de servicios en la nube.
¿Qué es Gemma 4 y por qué representa un avance?
Gemma 4 es la última generación de modelos de inteligencia artificial de código abierto desarrollados por Google DeepMind, basada en la misma investigación que impulsó a Gemini 3. A diferencia de sus predecesores, Gemma 4 no solo mejora en precisión y eficiencia, sino que integra capacidades multimodales nativas, permitiendo procesar texto, imágenes, audio y video en un solo modelo. Esto lo hace ideal para aplicaciones que requieren interacción con el mundo físico, como robótica, automatización industrial o asistentes de voz avanzados.
La familia Gemma 4 incluye cuatro variantes principales:
- Gemma 4 31B: Modelo denso con 31 mil millones de parámetros, optimizado para entornos de alto rendimiento como servidores o estaciones de trabajo con tarjetas gráficas NVIDIA H100.
- Gemma 4 26B MoE: Arquitectura Mixture of Experts con 26 mil millones de parámetros, donde solo se activan 3.8 mil millones durante la inferencia, reduciendo costos computacionales.
- Gemma 4 E4B: Modelo compacto con 4.5 mil millones de parámetros efectivos, diseñado para dispositivos edge como Jetson Orin Nano o computadoras con tarjetas RTX.
- Gemma 4 E2B: Variante ultraeficiente con 2.3 mil millones de parámetros, ideal para dispositivos embebidos o móviles.
Todos los modelos soportan un contexto extendido de hasta 256 mil tokens en las variantes más grandes, lo que permite analizar documentos completos o repositorios de código en una sola solicitud. Además, Gemma 4 fue entrenado en más de 140 idiomas, garantizando un rendimiento consistente en contextos globales.
Comparativa con Gemma 3:
| Gemma 3 (27B) | Gemma 4 31B | Gemma 4 26B MoE | Gemma 4 E4B | |
|---|---|---|---|---|
| Razonamiento (AIME 2026) | 20.8% | 89.2% | 88.3% | 42.5% |
| Generación de código (LiveCodeBench) | 29.1% | 80.0% | 77.1% | 52.0% |
| Contexto (tokens) | 8K | 256K | 256K | 128K |
| Hardware mínimo recomendado | GPU A100 | H100 / RTX 6000 | RTX 4090 | Jetson Orin Nano |
La mejora en benchmarks es significativa: mientras Gemma 3 alcanzaba un 20.8% en razonamiento lógico, Gemma 4 31B logra un 89.2%. Incluso los modelos edge superan a Gemma 3 en la mayoría de las métricas, a pesar de ser una fracción de su tamaño, gracias a técnicas como las incrustaciones por capa, que optimizan el uso de recursos sin sacrificar calidad.
Implementación en dispositivos edge: Jetson, RTX y DGX Spark
Una de las mayores ventajas de Gemma 4 es su compatibilidad con el ecosistema de NVIDIA, que permite desplegar modelos en una amplia gama de hardware, desde dispositivos edge hasta supercomputadoras personales. A continuación, te explicamos cómo implementarlo en cada plataforma:
Jetson Orin Nano: inteligencia artificial física y robótica
Los modelos Gemma 4 E2B y E4B están optimizados para ejecutarse en Jetson Orin Nano, ofreciendo inferencia multimodal con latencia cercana a cero. Esto los hace ideales para aplicaciones en robótica, automatización industrial y sistemas embebidos que requieren procesamiento en tiempo real.
Guía rápida para desplegar Gemma 4 E2B en Jetson Orin Nano:
- Instala el contenedor oficial de NVIDIA:
docker pull nvcr.io/nvidia/l4t-ml:r36.2.0-py3 - Clona el repositorio de Gemma 4 para Jetson:
git clone https://github.com/NVIDIA-AI-IOT/gemma-jetson.git - Ejecuta el modelo E2B con llama.cpp:
cd gemma-jetson
./run_gemma4.sh --model e2b --quantize q4_0
Nota: Usa
--quantize q4_0para reducir el uso de memoria. - Prueba con un prompt multimodal:
python3 demo.py --image "ruta/a/tu/imagen.jpg" --prompt "Describe esta imagen y genera código Python para analizarla."
Recursos adicionales:
- Jetson AI Lab (tutoriales oficiales y contenedores preconfigurados).
- Repositorio en GitHub con ejemplos prácticos.
Errores comunes y soluciones:
- Error de memoria: Usa
--quantize q4_0o reduce el contexto a 64K tokens. - Falta de soporte para audio: Solo los modelos E2B y E4B soportan procesamiento de audio. Verifica la variante que estás usando.
- Lentitud en inferencia: Activa el modo
--n_gpu_layers 32para maximizar el uso de la GPU.
Tarjetas RTX: inteligencia artificial local para creadores y profesionales
Las tarjetas gráficas NVIDIA RTX, como las series 40 y 50, permiten ejecutar Gemma 4 con aceleración por Tensor Cores, ofreciendo un rendimiento optimizado para generación de código, edición de video con inteligencia artificial y análisis de datos locales. Estas tarjetas son ideales para desarrolladores, creadores de contenido y profesionales que necesitan potencia computacional sin depender de la nube.
Ventajas clave:
- Rendimiento optimizado para tareas como generación de código, análisis de documentos y procesamiento de imágenes.
- Soporte para herramientas como Ollama y Unsloth, que proporcionan modelos cuantizados para inferencia eficiente.
- Compatibilidad con CUDA y frameworks como PyTorch, facilitando la personalización mediante fine-tuning.
Los usuarios de tarjetas RTX pueden comenzar con las guías detalladas disponibles en el RTX AI Garage, donde se explican los pasos para desplegar Gemma 4 con herramientas como vLLM o llama.cpp.
DGX Spark: prototipado seguro y flujos de trabajo con agentes de inteligencia artificial
Para entornos empresariales, DGX Spark, con su chip Grace Blackwell y 128 GB de memoria unificada, es la plataforma ideal para ejecutar el modelo Gemma 4 31B con pesos en formato BF16. Esta configuración es perfecta para investigación, desarrollo de agentes de inteligencia artificial complejos y aplicaciones que requieren alto rendimiento y seguridad.
Características destacadas:
- Inferencia de alta velocidad gracias a vLLM, que maximiza el rendimiento en tareas concurrentes.
- Posibilidad de realizar fine-tuning con NeMo Automodel, adaptando Gemma 4 a dominios específicos sin perder eficiencia.
- Acceso gratuito a Gemma 4 31B mediante la API de NVIDIA NIM, disponible en el catálogo de NVIDIA.
Casos de uso prácticos: aplicaciones reales de Gemma 4
Robótica y automatización industrial
La combinación de visión por computadora, procesamiento de audio y razonamiento lógico permite a los robots equipados con Gemma 4:
- Interpretar comandos de voz y responder con acciones físicas, como mover brazos robóticos en líneas de producción.
- Analizar imágenes de sensores para detectar anomalías en tiempo real, mejorando la seguridad y eficiencia en entornos industriales.
- Operar en entornos sin conexión a internet, lo que es crucial para aplicaciones en salud, logística o manufactura.
Un ejemplo concreto es el uso de Gemma 4 en drones agrícolas, donde el modelo puede analizar imágenes de cultivos para detectar plagas o enfermedades, y generar informes detallados sin necesidad de enviar datos a servidores externos.
Desarrollo de aplicaciones móviles y embebidas
Con las variantes E2B y E4B de Gemma 4, los desarrolladores pueden crear aplicaciones móviles avanzadas que funcionen completamente offline. Algunos ejemplos incluyen:
- Asistentes de voz: Aplicaciones que traducen y resumen audio en tiempo real, sin depender de servicios en la nube.
- Realidad aumentada: Herramientas que interpreten imágenes del entorno y generen respuestas contextuales, como guías turísticas interactivas.
- Generación de código: Entornos de desarrollo móviles que sugieran o completen código en tiempo real, incluso sin conexión.
Ejemplo práctico: asistente de voz offline con Gemma 4 E2B en Android
Herramientas necesarias: Android Studio, Gemma 4 E2B (a través de Ollama), MediaPipe para procesamiento de audio.
- Integra Ollama en tu aplicación:
implementation 'com.ollama:ollama-android:0.1.2' - Descarga el modelo E2B cuantizado:
Ollama.pullModel("gemma4:e2b-q4_0") - Procesa el audio con MediaPipe y envía la entrada a Gemma 4:
val audioInput = MediaPipeAudio.process(microphoneStream) val response = Ollama.generate( model = "gemma4:e2b-q4_0", prompt = "Traduce este audio a texto y resume: $audioInput" ) - Muestra la respuesta en la interfaz de usuario:
textViewResponse.text = response.generatedText
Resultado: Una aplicación que traduce y resume voz en tiempo real, funcionando completamente offline.
Puedes encontrar ejemplos completos en el repositorio de Ollama para Android.
Seguridad y privacidad en sectores regulados
La capacidad de ejecutar Gemma 4 localmente es clave para industrias con estrictos requisitos de privacidad, como:
- Salud: Procesamiento de historiales médicos con inteligencia artificial sin enviar datos sensibles a servidores externos.
- Finanzas: Análisis de transacciones o detección de fraudes en entornos locales, cumpliendo con regulaciones de protección de datos.
- Gobierno: Implementación de chatbots o sistemas de análisis con soberanía total sobre los datos.
Por ejemplo, un hospital podría usar Gemma 4 para analizar radiografías y generar informes médicos sin exponer información confidencial de los pacientes a servicios en la nube.
¿Cómo empezar con Gemma 4 hoy?
Gemma 4 está disponible bajo la licencia Apache 2.0, lo que permite su uso comercial sin restricciones. Aquí tienes los pasos para comenzar:
1. Descarga los modelos
Los pesos de Gemma 4 están disponibles en las siguientes plataformas:
- Hugging Face (todas las variantes).
- Ollama (para despliegue local rápido).
- Kaggle (para experimentación y competencia).
2. Guías de implementación según tu hardware
- Jetson Orin Nano: Jetson AI Lab (tutoriales oficiales y contenedores).
- Tarjetas RTX: RTX AI Garage (guías para PCs y workstations).
- DGX Spark: DGX Spark Playbooks (para prototipado avanzado).
3. Herramientas de optimización
Para maximizar el rendimiento de Gemma 4, considera estas herramientas:
- vLLM: Inferencia de alta velocidad para modelos grandes.
- Unsloth: Modelos cuantizados para dispositivos edge.
- NeMo Automodel: Fine-tuning avanzado con PyTorch.
Preguntas frecuentes sobre Gemma 4
¿Puedo usar Gemma 4 en proyectos comerciales?
Sí. La licencia Apache 2.0 permite su uso comercial sin restricciones, a diferencia de versiones anteriores de Gemma que tenían limitaciones legales.
¿Qué hardware necesito para ejecutar Gemma 4 31B?
Se recomienda una tarjeta gráfica NVIDIA H100 (con 80 GB de VRAM) o una RTX 6000 Ada para inferencia sin cuantización. Para variantes cuantizadas (BF16), una RTX 4090 es suficiente.
¿Gemma 4 soporta generación de imágenes?
No directamente. Gemma 4 puede analizar imágenes (reconocimiento óptico de caracteres, descripción, clasificación) y generar texto basado en ellas, pero no crea imágenes desde cero. Para generación de imágenes, combina Gemma 4 con herramientas como Stable Diffusion.
¿Cómo cuantizar Gemma 4 para ahorrar recursos?
Puedes usar herramientas como llama.cpp con el siguiente comando para reducir el uso de VRAM:
./quantize ./gemma-4-31b.gguf ./gemma-4-31b-q4_0.gguf q4_0Esto reduce el tamaño del modelo en un ~50% con mínima pérdida de precisión.
¿Dónde puedo encontrar ejemplos de código para integrar Gemma 4 en mis proyectos?
Consulta los siguientes recursos:
Arquitectura Mixture of Experts (MoE) de Gemma 4
La arquitectura Mixture of Experts (MoE) de Gemma 4 permite activar solo un subconjunto de los parámetros totales del modelo durante la inferencia, lo que reduce significativamente el consumo de recursos sin sacrificar el rendimiento. En el caso del modelo 26B MoE, solo se activan 3.8 mil millones de sus 26 mil millones de parámetros, logrando una eficiencia comparable a la de un modelo denso de 4 mil millones de parámetros.
Esta arquitectura es ideal para aplicaciones que requieren alto rendimiento con recursos limitados, como dispositivos edge o sistemas embebidos. Además, Gemma 4 utiliza técnicas como las incrustaciones por capa (PLE), que optimizan el uso de memoria y aceleran la inferencia en hardware con restricciones.




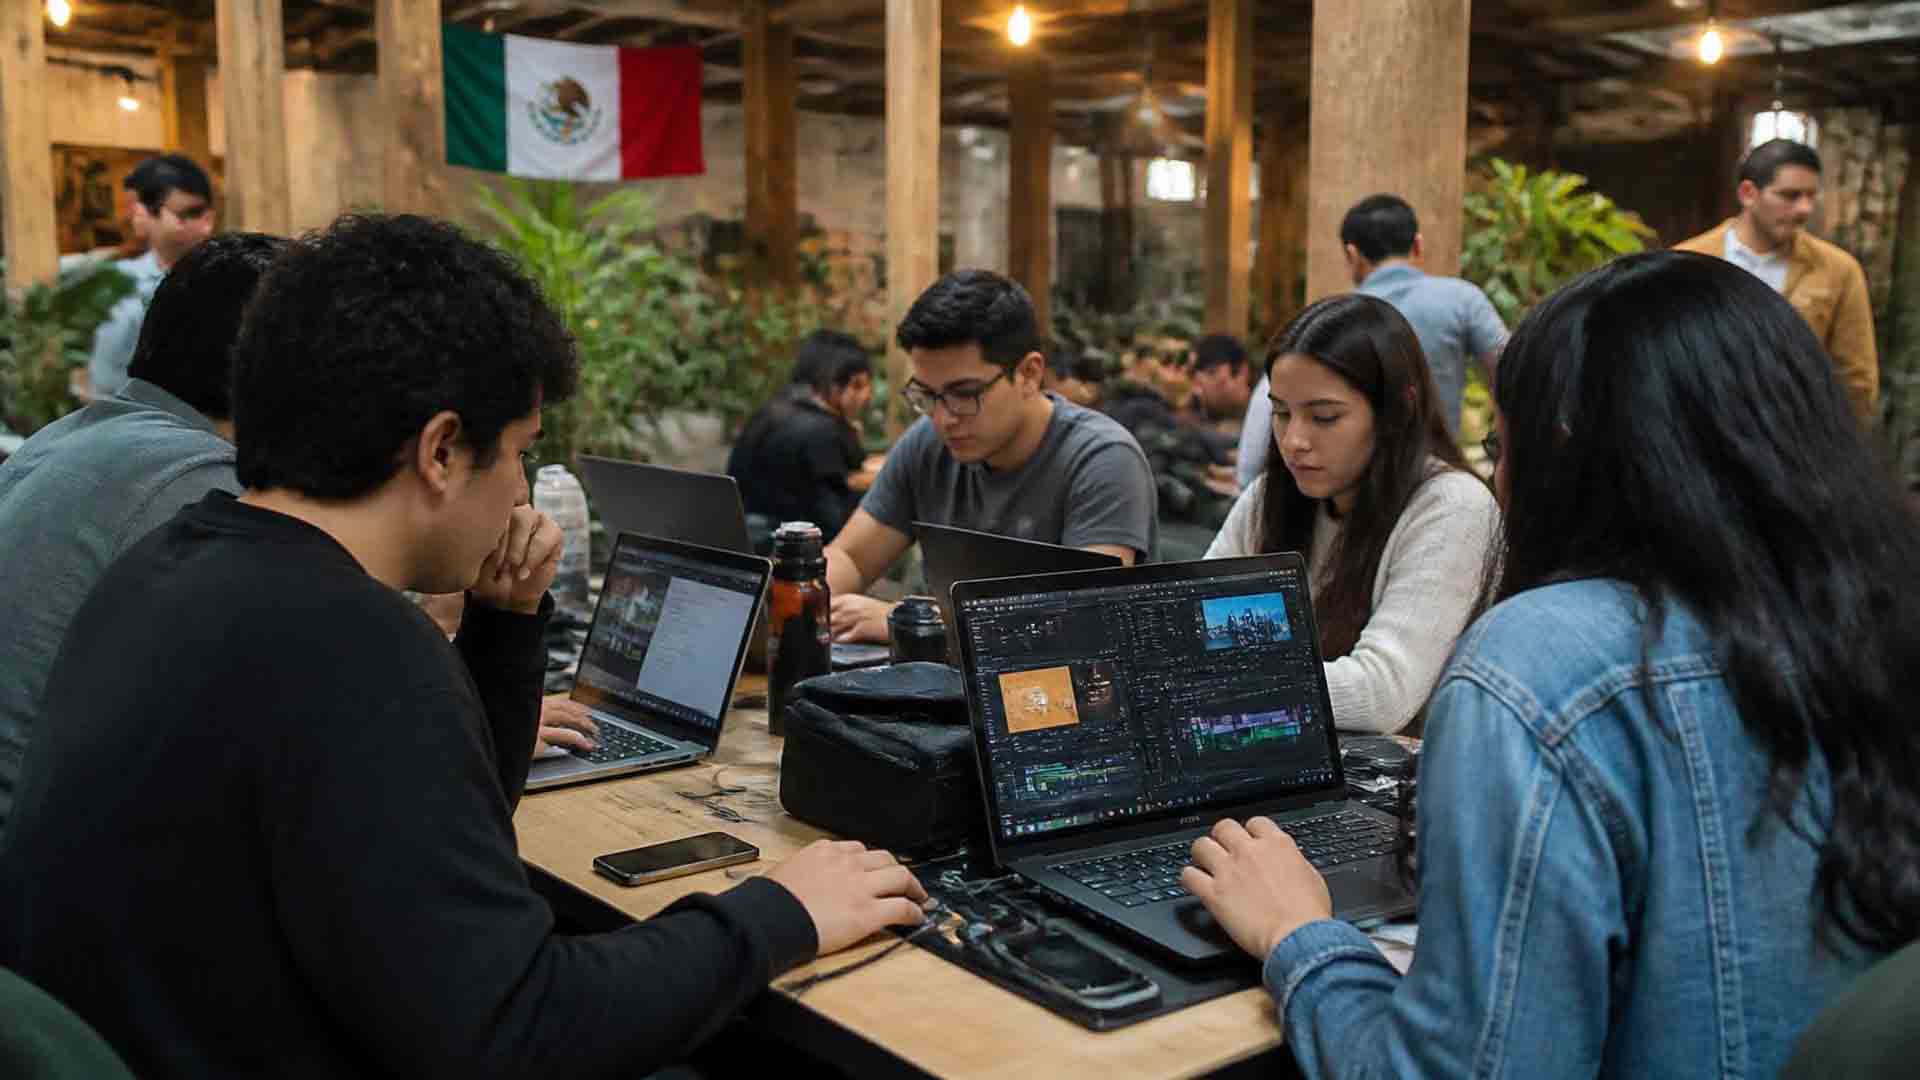
CapCut participará en México Tech Week 2026 con el CapCut Design Studio: Speed-to-Scale Hackathon, una activación gratuita para crear en cuatro horas una pieza lista para mostrar usando herramientas de IA. El cupo es de 30 lugares con registro previo.
¿Y si pudieras contratar un equipo de asistentes de IA que trabajara en tu propia computadora, con tus archivos, tu navegador y el plan de ChatGPT, Claude, Gemini o Grok que ya pagas? Eso es exactamente lo que propone OpenBot, una aplicación de escritorio gratuita que convierte varios agentes de IA en compañeros de trabajo persistentes, con espacios de trabajo dedicados, colas de tareas y hasta colaboración entre agentes.

Google lanzó Nano Banana 2.1, la actualización de su modelo de generación y edición de imágenes por IA: mejor calidad visual, texto más legible, consistencia de personajes y un precio en la API reducido a casi la mitad respecto a Nano Banana 2.
-

 Apps11 años ago
AMPcast, la herramienta de Pandora que permite a los artistas grabar mensajes de audio directamente a sus seguidores
-
 Blogs5 años ago
Conoce los mejores sitios de Torrents para descargar todo tipo de contenidos
-
Android5 años ago
Aprende cómo usar Discord para ver películas con tus amigos
-
Arte y Cultura14 años ago
Colección de fondos de pantalla basados en Super Héroes
-

 Almacenamiento2 años ago
Cómo usar TeraBox: La guía definitiva para aprovechar 1 TB de almacenamiento en la nube
-
Diseño13 años ago
css3ps: plugin que convierte archivos PSD a CSS3
-
Apps9 años ago
Picturethat, app que usa la Realidad Aumentada para visualizar cómo quedarían los cuadros antes de colgarlos
-
Eventos Especiales13 años ago
Especial Día de la Madres: fondos de pantalla especiales para Mamá