


Digitalización
Caída masiva de Amazon Web Services afecta a cientos de servicios globales el 20 de octubre de 2025

Amazon Web Services experimentó una interrupción masiva a nivel global el 20 de octubre de 2025 que afectó a cientos de plataformas, aplicaciones y servicios en todo el mundo.
La falla comenzó a las 12:11 AM hora del Pacífico (3:11 AM hora del Este, 2:11 AM hora central de México) cuando AWS reportó un problema operacional en su centro de datos de Virginia del Norte, considerado uno de los núcleos más importantes de la infraestructura global de internet.
Origen técnico del problema
El problema raíz se localizó en Amazon DynamoDB, un servicio de base de datos NoSQL que gestiona más de 500,000 solicitudes por segundo para más de un millón de clientes a nivel mundial. AWS confirmó en su panel de estado que experimentaba tasas elevadas de error y latencias para múltiples servicios en la región US-EAST-1. A las 2:01 AM hora del Pacífico (5:01 AM hora del Este, 4:01 AM hora central de México), AWS identificó la causa relacionada con la resolución DNS del punto de acceso API de DynamoDB.
Durante el pico de la interrupción, AWS reportó 58 servicios afectados en total, siendo DynamoDB el único completamente interrumpido. Entre los otros 20 servicios con impacto operacional se encontraban Amazon Elastic Compute Cloud y servicios críticos de autenticación como Identity and Access Management, lo que explica el efecto en cadena que provocó la caída simultánea de miles de plataformas dependientes.

Servicios afectados en Norteamérica y México
La interrupción tuvo un impacto significativo en el mercado norteamericano y mexicano, afectando plataformas de diversos sectores. En el ámbito de videojuegos, Fortnite, Roblox, Pokémon GO, Clash Royale y Epic Games Store reportaron interrupciones totales o parciales. Las plataformas de streaming Disney+, Hulu y Prime Video enfrentaron problemas de acceso para millones de usuarios durante las primeras horas de la mañana.
El sector financiero fue especialmente golpeado, con Coinbase, Robinhood, Venmo y Chime experimentando dificultades de acceso. Los usuarios reportaron imposibilidad para realizar transacciones, consultar saldos o acceder a sus cuentas durante las horas críticas. En el transporte, United Airlines y Delta Air Lines tuvieron problemas con sus aplicaciones móviles, impidiendo que pasajeros realizaran procesos de documentación o consultaran reservaciones.
Aplicaciones de comunicación como Signal y Zoom reportaron problemas de conectividad, mientras que servicios de productividad como Duolingo, Canva y Slack quedaron inaccesibles para millones de usuarios. Los dispositivos inteligentes de Amazon, incluyendo Ring (timbres inteligentes) y Alexa (asistentes de voz), dejaron de funcionar correctamente, dejando a los usuarios sin acceso a sus sistemas de seguridad doméstica y automatización.
Cronología de la recuperación
AWS publicó su primera actualización crítica a la 1:26 AM hora del Pacífico (4:26 AM hora del Este, 3:26 AM hora central de México), confirmando que los ingenieros estaban trabajando activamente tanto en la mitigación del problema como en la comprensión total de la causa raíz. La compañía indicó que estaba explorando múltiples estrategias paralelas para acelerar la recuperación.
Aproximadamente dos horas y media después del inicio, alrededor de las 5:30-6:00 AM hora central de México, AWS reportó signos significativos de recuperación. El número de incidencias reportadas en Downdetector comenzó a descender, aunque la recuperación completa tomó varias horas adicionales. Los reportes en Downdetector alcanzaron aproximadamente 50,000 informes para servicios de Amazon durante el pico del incidente, evidenciando la magnitud del impacto en usuarios finales.
Impacto económico estimado
Amazon Web Services genera ingresos anuales de 107,000 millones de dólares, representando el 17% de los ingresos totales de Amazon y consolidándose como líder del mercado de computación en la nube frente a competidores como Microsoft Azure y Google Cloud. AWS proporciona infraestructura de computación en la nube a más de 76.8 millones de sitios web a nivel mundial.
Considerando que AWS procesa billones de transacciones diarias y que la interrupción duró aproximadamente dos horas y media en su fase crítica, las pérdidas económicas para empresas dependientes podrían estimarse en cientos de millones de dólares. Plataformas de comercio electrónico pierden en promedio entre 5,600 y 300,000 dólares por cada minuto de inactividad, según su tamaño y volumen de transacciones. Para gigantes como Amazon.com, la caída representa pérdidas aproximadas de 220,000 dólares por minuto, lo que resultaría en más de 33 millones de dólares durante las dos horas y media críticas.
El sector financiero enfrentó pérdidas adicionales por transacciones canceladas, con Coinbase procesando normalmente más de 2,000 millones de dólares en operaciones diarias. La imposibilidad de ejecutar operaciones durante las horas de mayor actividad en mercados asiáticos representa pérdidas significativas para operadores e inversionistas.
Contexto histórico y frecuencia de interrupciones
Esta caída representa la interrupción más significativa de AWS en 2025 y una de las más severas desde el incidente de diciembre de 2021, cuando una falla en la región US-EAST-1 duró más de cinco horas. En 2024, AWS experimentó tres interrupciones importantes: en marzo (duración de 3 horas), junio (duración de 1.5 horas) y noviembre (duración de 2 horas), todas relacionadas con problemas en servicios de base de datos o redes.
El tiempo de recuperación de dos horas y media se considera dentro del promedio para incidentes de esta magnitud en servicios de nube. Microsoft Azure reportó en 2024 un tiempo medio de recuperación de 3.2 horas para interrupciones mayores, mientras que Google Cloud mantuvo un promedio de 2.8 horas. Sin embargo, la frecuencia de estas caídas en AWS ha aumentado un 40% comparado con el periodo 2020-2022, generando preocupaciones sobre la resiliencia de la infraestructura a medida que aumenta la demanda.
Declaraciones oficiales
Aravind Srinivas, director ejecutivo de Perplexity, comunicó a través de la plataforma X: “Perplexity está actualmente caído. El problema subyacente está relacionado con AWS. Estamos trabajando activamente para solucionarlo”. Coinbase informó a sus usuarios que múltiples clientes enfrentaban dificultades para acceder a sus servicios debido a la interrupción de AWS.
AWS publicó en su panel de estado: “Confirmamos tasas elevadas de error y latencias para varios servicios en la región US-EAST-1. Los ingenieros fueron inmediatamente involucrados y están trabajando activamente tanto en la mitigación de los problemas como en la comprensión completa de la causa raíz”. La compañía recomendó a los usuarios “continuar reintentando cualquier solicitud fallida” mientras se implementaba la solución.
Lecciones aprendidas sobre dependencia tecnológica
El incidente evidencia los riesgos de la centralización en infraestructura de nube. Virginia del Norte alberga el 70% de todo el tráfico global de internet y concentra la mayor densidad de centros de datos del planeta, convirtiéndola en un punto único de falla para miles de servicios digitales. Esta concentración geográfica y técnica crea vulnerabilidades sistémicas que afectan simultáneamente a sectores críticos como salud, finanzas, transporte y comunicaciones.
La arquitectura de servicios modernos, donde aplicaciones dependen de múltiples microservicios interconectados, amplifica el impacto de fallas en componentes fundamentales como DynamoDB. Una interrupción en un servicio de base de datos puede paralizar decenas de servicios dependientes, creando efectos en cascada difíciles de predecir y mitigar.
Empresas tecnológicas y analistas de infraestructura recomiendan estrategias de arquitectura multi-nube, donde servicios críticos se distribuyen entre proveedores (AWS, Azure, Google Cloud) y regiones geográficas. Esta redundancia incrementa costos operativos entre 30% y 50%, pero reduce significativamente el riesgo de interrupciones totales. Sin embargo, menos del 25% de empresas implementan verdadera redundancia multi-nube debido a complejidades técnicas y presupuestarias.
Recomendaciones para usuarios y empresas
Los usuarios pueden monitorear el estado de AWS en tiempo real a través del AWS Health Dashboard, accesible en health.aws.amazon.com, donde la compañía publica actualizaciones oficiales sobre interrupciones y mantenimientos programados. Plataformas independientes como Downdetector.com ofrecen reportes en tiempo real basados en experiencias de usuarios, proporcionando visibilidad temprana de problemas antes de confirmaciones oficiales.
Para empresas que dependen de AWS, los expertos recomiendan implementar planes de continuidad que incluyan respaldos automáticos en regiones geográficas distintas, configuración de conmutación automática hacia servicios alternativos y sistemas de monitoreo que detecten anomalías antes de que se conviertan en interrupciones totales. Documentar dependencias críticas y establecer protocolos de comunicación con clientes durante caídas reduce el impacto en reputación y satisfacción del usuario.
Desarrolladores deben implementar patrones de diseño resilientes como circuit breakers (cortacircuitos), que detectan fallas en servicios externos y previenen que errores se propaguen, y estrategias de reintentos con retroceso exponencial, que permiten que aplicaciones se recuperen automáticamente cuando los servicios subyacentes se restauran. Estas prácticas, aunque agregan complejidad al desarrollo, son esenciales para mantener disponibilidad en entornos donde las interrupciones de terceros son inevitables.
Perspectivas futuras
El aumento en la frecuencia de interrupciones de infraestructura de nube plantea cuestionamientos sobre la sostenibilidad del modelo actual de centralización. Reguladores en Europa y Estados Unidos están considerando normativas que exijan niveles mínimos de redundancia y transparencia en reportes de interrupciones para proveedores de servicios críticos.
La industria tecnológica explora alternativas como computación en el borde (edge computing), que distribuye procesamiento más cerca de los usuarios finales, reduciendo dependencia de centros de datos centralizados. Sin embargo, estas tecnologías aún están en etapas tempranas y no pueden reemplazar completamente la escala y eficiencia de proveedores consolidados como AWS.
Amazon ha anunciado inversiones de más de 150,000 millones de dólares en infraestructura de centros de datos para 2025-2030, con énfasis en diversificación geográfica y mejoras en resiliencia. Sin embargo, mientras la demanda por servicios de nube continúe creciendo a tasas superiores al 30% anual, las presiones sobre infraestructura existente seguirán generando riesgos de interrupciones periódicas.




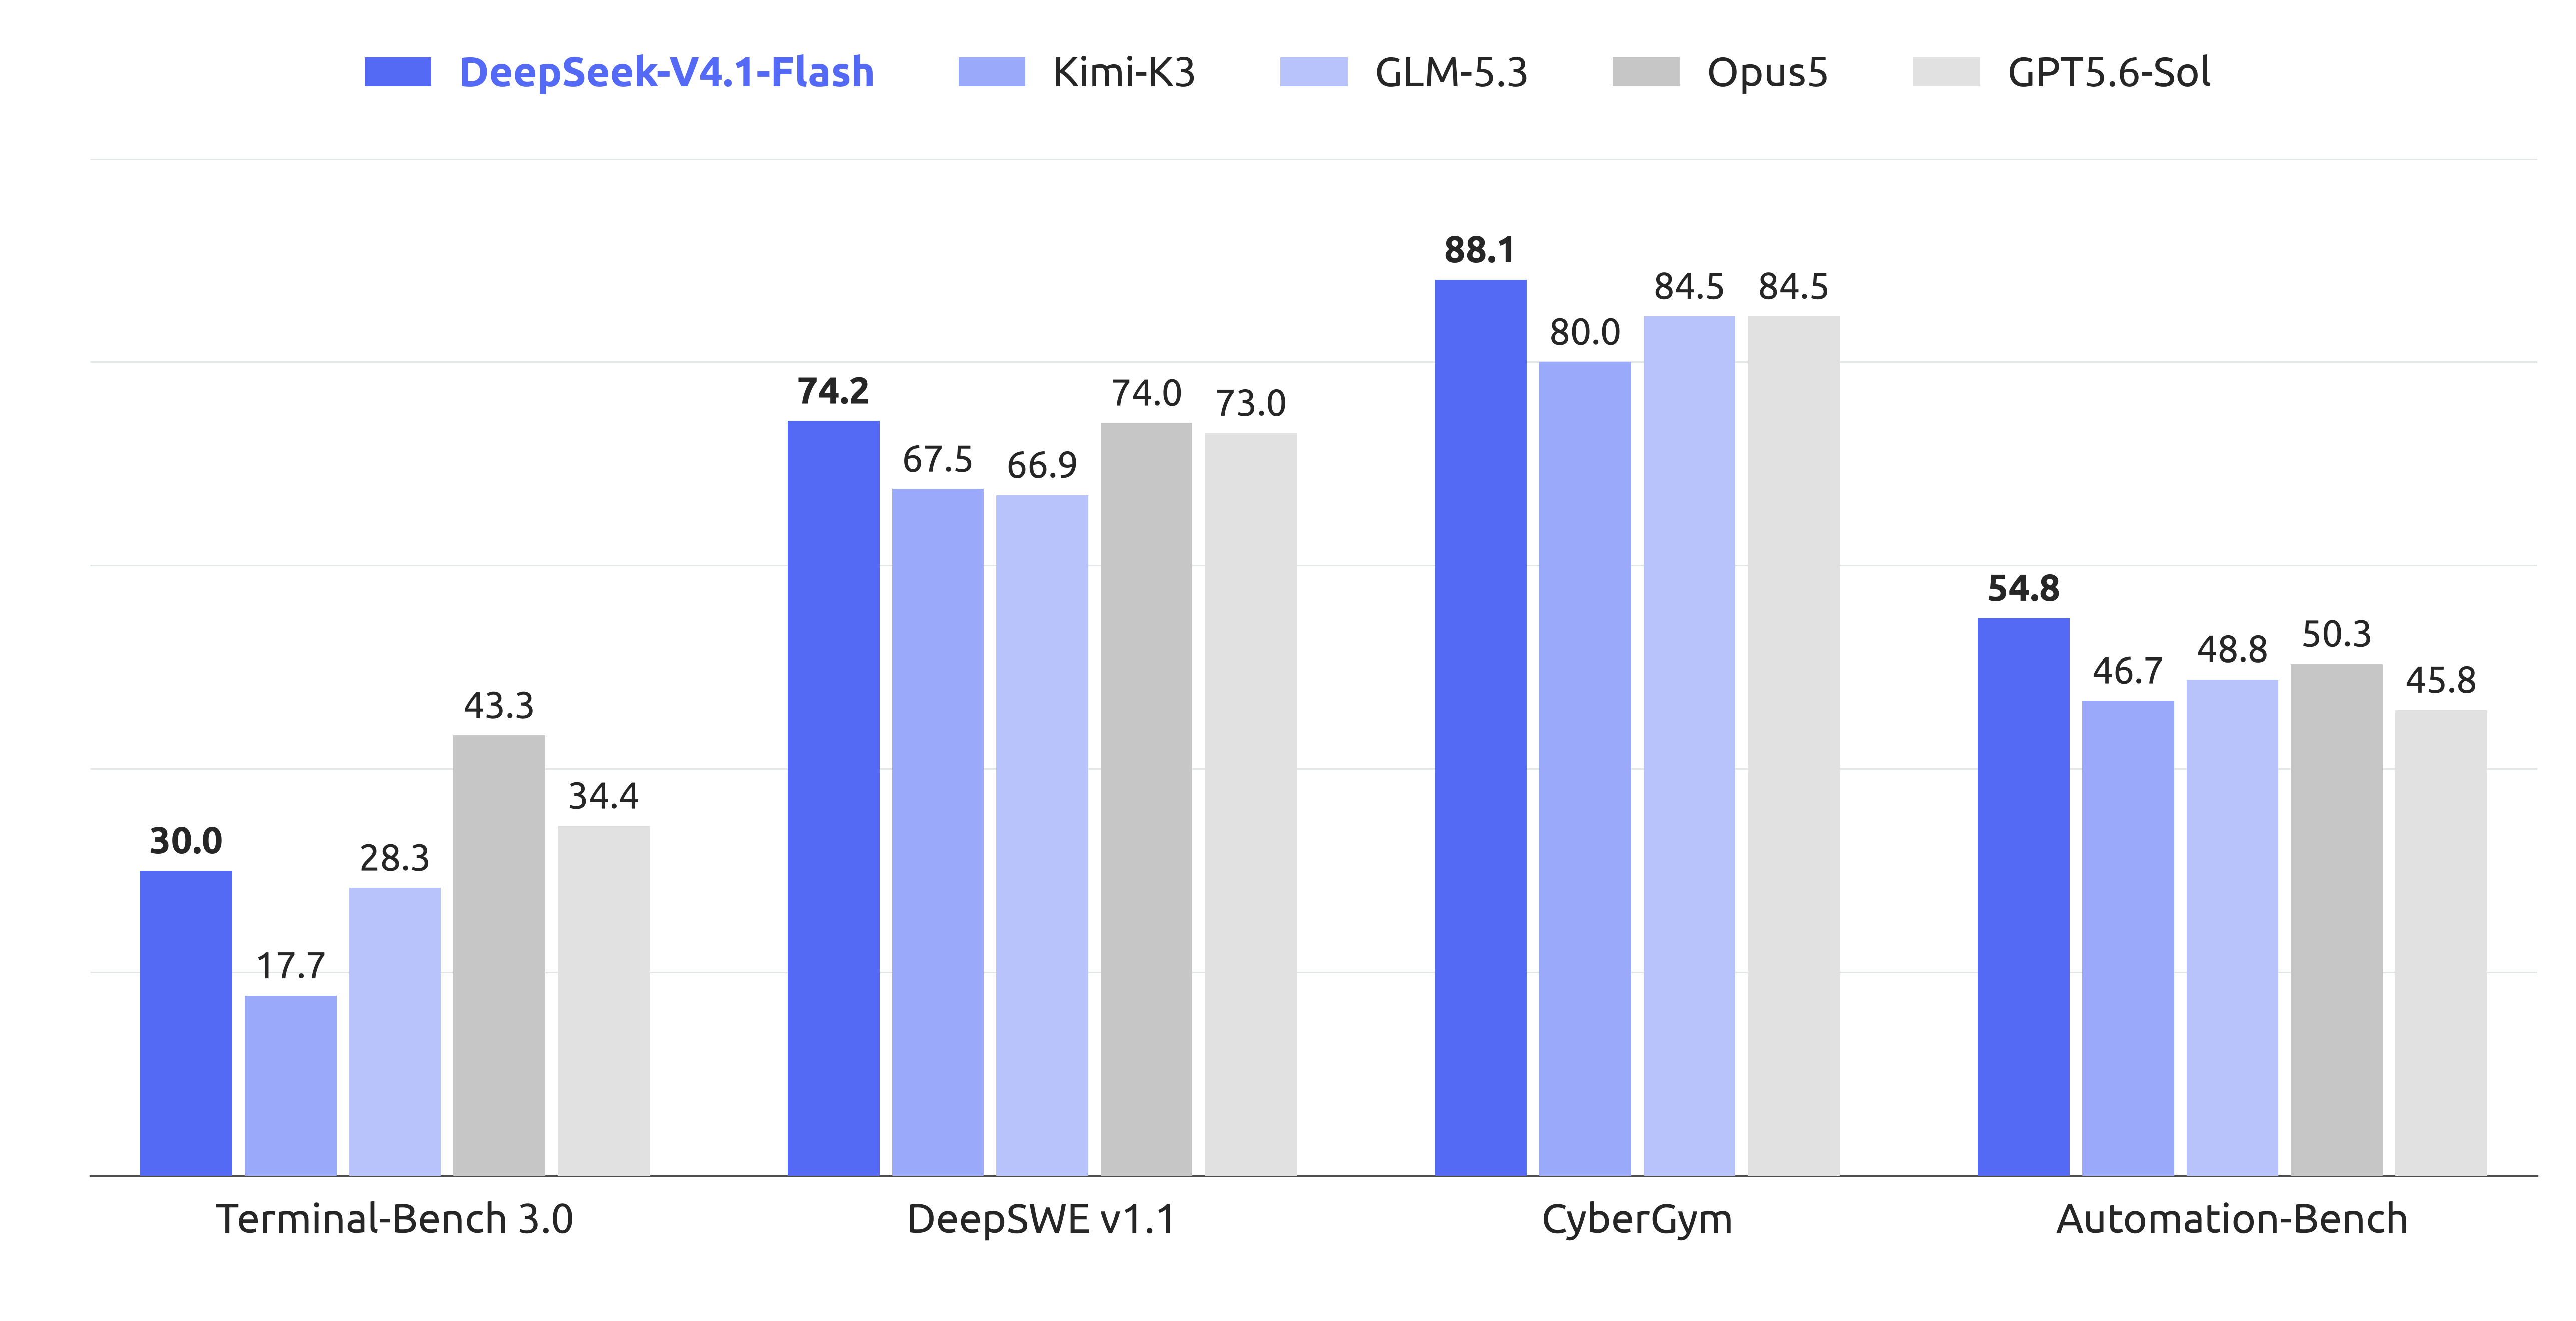
DeepSeek ha presentado V4.1-Flash, su modelo de inteligencia artificial más pequeño y económico hasta la fecha, con precios desde $0.003 por millón de tokens gracias a su sistema de caché. Según la compañía, este modelo supera a GPT-5.6 Sol de OpenAI y a Claude Opus 5 de Anthropic en tareas de programación y ciberseguridad, marcando un hito en la relación costo-rendimiento.
Este lanzamiento podría redefinir el mercado de los modelos de lenguaje, ofreciendo una alternativa accesible para desarrolladores y empresas.
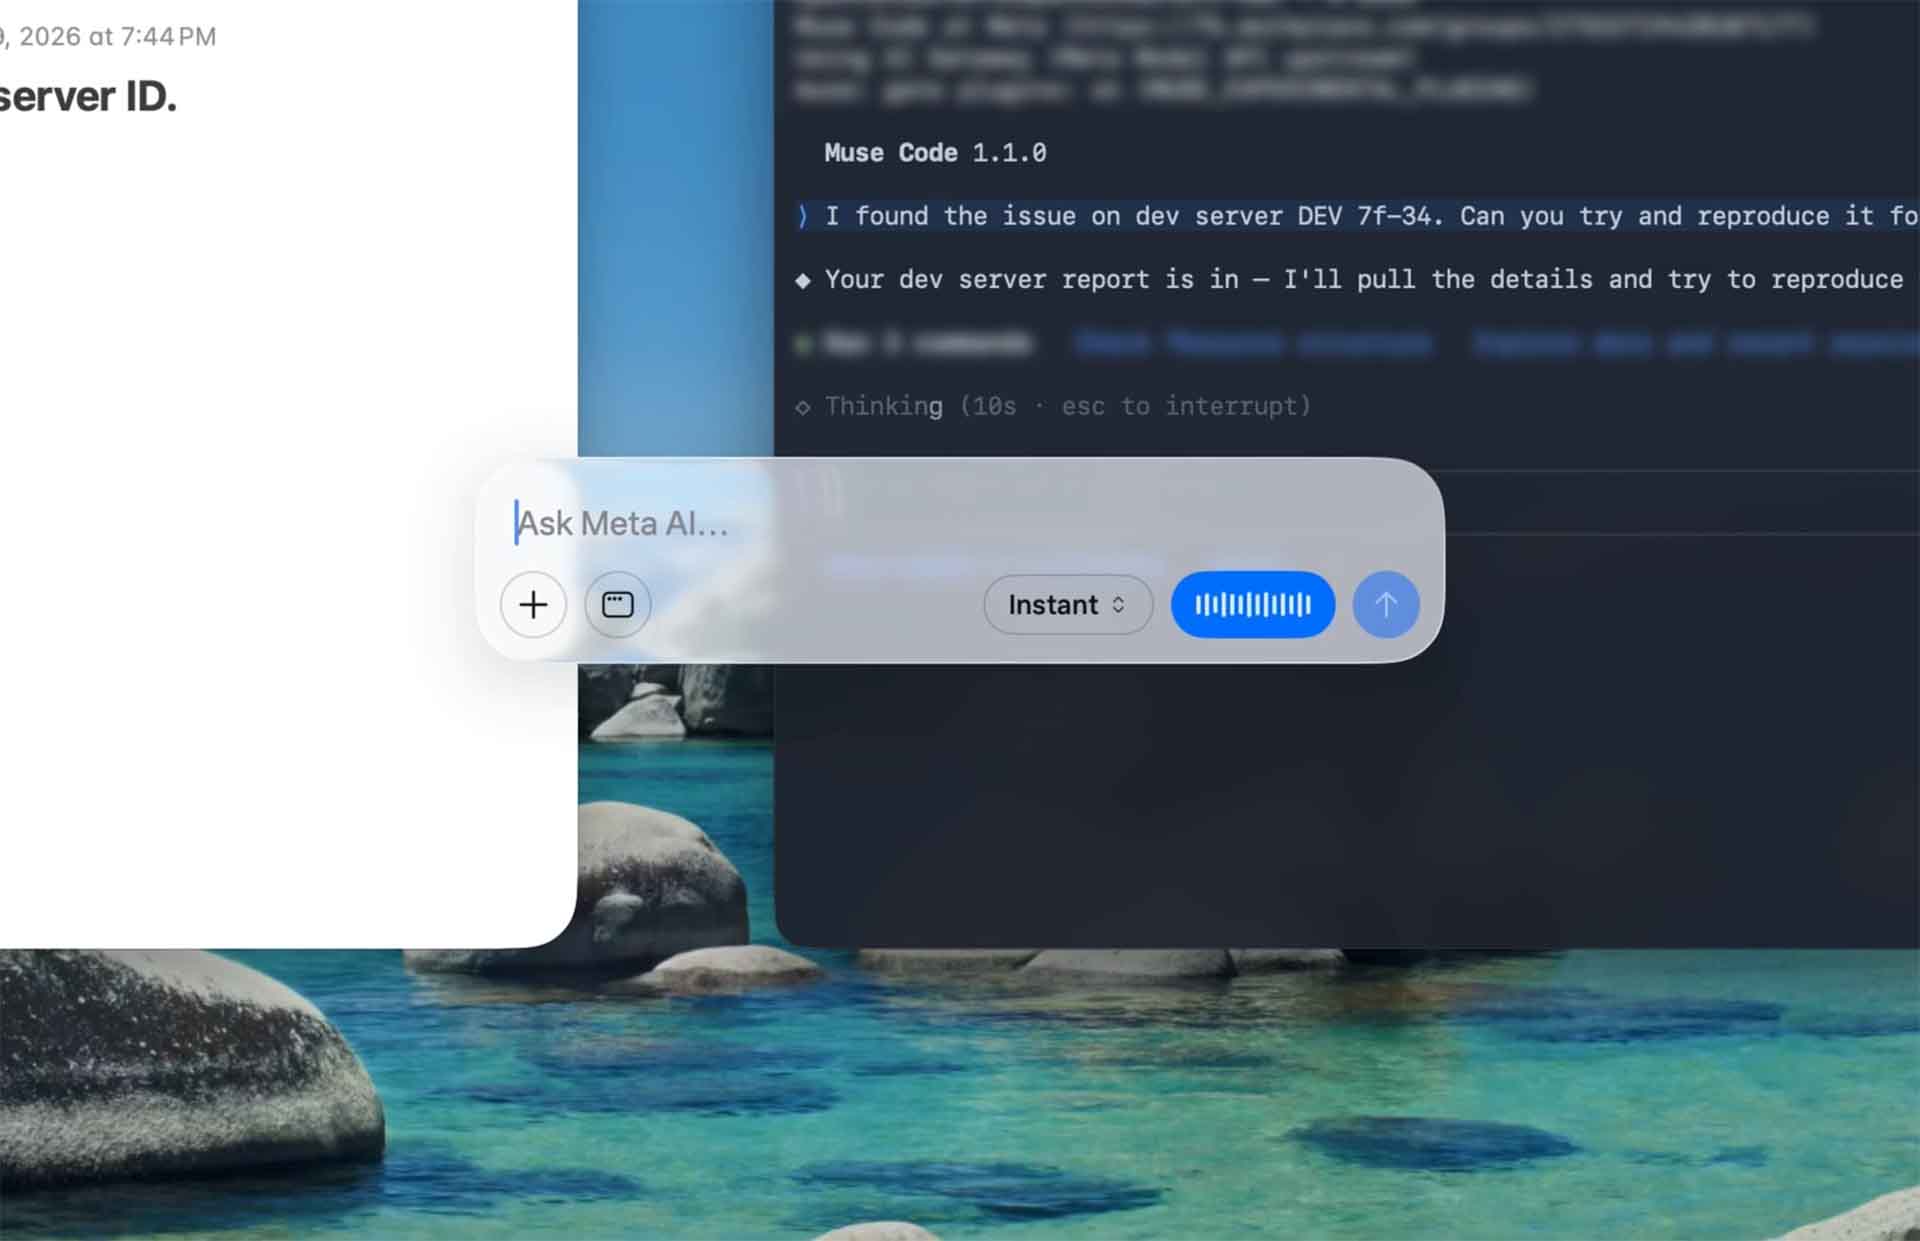
Meta lanza Muse Voice Transcribe, su primer modelo de audio en tiempo real con diarización para 20+ hablantes y soporte multilingüe. Un avance en transcripción de voz con IA que redefine la interacción humana con la tecnología.
Google ha presentado Gemini 3.5 Transcribe, su modelo más avanzado de transcripción de voz a texto, diseñado para ofrecer precisión y eficiencia en tiempo real. A diferencia de los modelos tradicionales, que tienen dificultades con el ruido de fondo, la jerga técnica o las disfluencias en el habla, este nuevo modelo convierte el audio en bruto en texto pulido, formateado y listo para usar.
-

 Apps11 años ago
AMPcast, la herramienta de Pandora que permite a los artistas grabar mensajes de audio directamente a sus seguidores
-
 Blogs5 años ago
Conoce los mejores sitios de Torrents para descargar todo tipo de contenidos
-
Android5 años ago
Aprende cómo usar Discord para ver películas con tus amigos
-
Arte y Cultura13 años ago
Colección de fondos de pantalla basados en Super Héroes
-

 Almacenamiento2 años ago
Cómo usar TeraBox: La guía definitiva para aprovechar 1 TB de almacenamiento en la nube
-
Diseño13 años ago
css3ps: plugin que convierte archivos PSD a CSS3
-
Apps9 años ago
Picturethat, app que usa la Realidad Aumentada para visualizar cómo quedarían los cuadros antes de colgarlos
-
Eventos Especiales13 años ago
Especial Día de la Madres: fondos de pantalla especiales para Mamá