

Blogs
CM3leon: un modelo de IA generativa para generación de texto e imágenes

En los últimos meses, el interés y la investigación en los modelos de IA generativa se han acelerado gracias a los avances en el procesamiento del lenguaje natural, que permite a las máquinas comprender y expresar el lenguaje, así como a los sistemas que pueden generar imágenes a partir de texto.
[adsenseyu1]
En este sentido, Meta ha presentado CM3leon, un modelo base único que realiza tanto generación de texto a imagen como generación de imagen a texto.
Introduciendo a CM3leon
CM3leon es el primer modelo multimodal entrenado con una receta adaptada de modelos de lenguaje solo de texto, que incluye una etapa de preentrenamiento con recuperación a gran escala y una segunda etapa de ajuste fino multitarea supervisado. Esta receta es simple, produce un modelo sólido y también demuestra que los transformers basados en tokenización se pueden entrenar de manera tan eficiente como los modelos de difusión generativos existentes. CM3leon logra un rendimiento de vanguardia en generación de texto a imagen, a pesar de ser entrenado con cinco veces menos cálculos que los métodos basados en transformers anteriores. CM3leon tiene la versatilidad y efectividad de los modelos autorregresivos, al tiempo que mantiene costos de entrenamiento bajos y eficiencia en inferencia. Es un modelo causal multimodal enmascarado (CM3) porque puede generar secuencias de texto e imágenes condicionadas a secuencias arbitrarias de otros contenidos de imágenes y texto. Esto amplía enormemente la funcionalidad de los modelos anteriores que solo podían hacer generación de texto a imagen o de imagen a texto.
El poder de la multitarea en CM3leon
Mientras que los modelos generativos basados en texto suelen ser multitarea y ajustarse a una amplia gama de tareas diferentes para mejorar su capacidad para seguir instrucciones, los modelos de generación de imágenes suelen especializarse en tareas particulares. Aplicamos un ajuste multitarea a gran escala a CM3leon tanto para la generación de imágenes como para la generación de texto, y demostramos que mejora significativamente el rendimiento en tareas como la generación de subtítulos de imágenes, la respuesta a preguntas visuales, la edición basada en texto y la generación condicional de imágenes. Esto proporciona otro ejemplo sólido de cómo las recetas de escalado desarrolladas para modelos solo de texto se generalizan directamente a nuestros modelos de generación de imágenes basados en tokenización.
El rendimiento de CM3leon en tareas
Con las capacidades de CM3leon, las herramientas de generación de imágenes pueden producir imágenes más coherentes que sigan mejor las indicaciones de entrada. Por ejemplo, muchos modelos de generación de imágenes tienen dificultades para recuperar las formas globales y los detalles locales. CM3leon se destaca en esta área. A continuación, se muestra un vistazo a las capacidades de CM3leon en una variedad de tareas, todas realizadas con un solo modelo:
Generación y edición de imágenes guiadas por texto
La generación de imágenes puede ser un desafío cuando se trata de objetos complejos o cuando la indicación incluye muchas restricciones que deben incluirse en la salida. La edición de imágenes guiada por texto (por ejemplo, “cambiar el color del cielo a azul brillante”) es desafiante porque requiere que el modelo comprenda simultáneamente las instrucciones textuales y el contenido visual. CM3leon sobresale en todos los casos, como se puede observar en los ejemplos a continuación.
Texto a imagen
Dado un texto de indicación con una estructura potencialmente muy compleja, generar una imagen coherente que siga la indicación. Por ejemplo, las siguientes cuatro imágenes se crearon para las siguientes indicaciones: (1) Un pequeño cactus con un sombrero de paja y gafas de sol neón en el desierto del Sahara. (2) Una foto de primer plano de una mano humana, modelo de mano. Alta calidad. (3) Un personaje principal de mapache en un anime preparándose para una batalla épica con una espada samurái. Postura de batalla. Fantasía, ilustración. (4) Una señal de alto en estilo de fantasía con el texto “1991”.

Edición de imágenes guiada por texto
Dada una imagen y una indicación de texto, editar la imagen según las instrucciones del texto. Debido a la generalidad de los modelos CM3leon, esto se logró con el mismo modelo que todas las demás tareas anteriores y posteriores, a diferencia de modelos anteriores como InstructPix2Pix, que solo se ajustan para la edición de imágenes guiada por texto.

Tareas de texto

El modelo CM3leon también puede seguir una serie de indicaciones diferentes para generar subtítulos cortos o largos y responder preguntas sobre una imagen.
Por ejemplo, imagina un perro llevando un palo.
Pregunta de indicación: ¿Qué está llevando el perro?
Generación del modelo: Palito
Indicación: Describe la imagen dada con mucho detalle.
Generación del modelo: En esta imagen, hay un perro sosteniendo un palo en su boca. Hay hierba en la superficie. En el fondo de la imagen, hay árboles.
Evaluación empírica del rendimiento de CM3leon en diversas tareas de generación de imágenes y preguntas visuales
Evaluamos empíricamente nuestros modelos ajustados a instrucciones en diversas tareas de generación de subtítulos de imágenes y respuesta a preguntas visuales y los comparamos con modelos anteriores de referencia de vanguardia. A pesar de que los modelos CM3leon vieron significativamente menos datos de texto (~3B tokens) en comparación con Flamingo (100B) y OpenFlamingo (40B), lograron niveles de rendimiento en modo cero (zero-shot) equivalentes a los de OpenFlamingo en la generación de subtítulos de MS-COCO y la respuesta a preguntas de VQA2, e incluso superaron a Flamingo por casi 10 puntos en la tarea VizWiz.
Edición de imágenes guiada por estructura
La edición de imágenes guiada por estructura implica comprender e interpretar no solo instrucciones textuales, sino también información estructural o de diseño proporcionada como entrada. Esto permite que los modelos CM3leon creen ediciones visualmente coherentes y contextualmente apropiadas en una imagen al adherirse a las pautas de estructura o diseño proporcionadas.
Objeto a imagen
Dada una descripción de texto de la segmentación del cuadro delimitador de la imagen, generar una imagen.

Segmentación a imagen
Dada una imagen que contiene solo la segmentación (sin clases de texto), generar una imagen. La entrada aquí denota la imagen de la cual extraemos la segmentación.

Resultados de superresolución
Todas las imágenes generadas anteriormente muestran los resultados sin procesar del modelo CM3leon. Sin embargo, un truco común para la generación de imágenes es agregar una etapa de superresolución entrenada por separado para producir imágenes de mayor resolución a partir de las salidas originales del modelo. Esto funciona muy bien con CM3leon, como mostramos en los ejemplos a continuación para la tarea de generación de texto a imagen.
Cuatro imágenes de ejemplo para cada una de las siguientes indicaciones: (1) Una taza de café humeante con montañas al fondo. Descansando durante un viaje por carretera. (2) Hermosa y majestuosa carretera durante el atardecer. Estética. (3) Isla circular pequeña en medio de un lago. Bosques rodeando el lago. Alto contraste.

Más ejemplos para las indicaciones: (1) Tortuga nadando bajo el agua. Estética. Fantasía. (2) Elefante nadando bajo el agua. Estética. Fantasía. (3) Rebaño de ovejas. Estética. Fantasía.

Cómo construimos CM3leon
Arquitectura
La arquitectura de CM3Leon utiliza un transformer solo de decodificador similar a los modelos basados en texto bien establecidos. Sin embargo, lo que distingue a CM3Leon es su capacidad para ingresar y generar tanto texto como imágenes. Esto permite que CM3Leon maneje con éxito la variedad de tareas que hemos compartido anteriormente.
Entrenamiento
El entrenamiento de CM3leon se basa en la recuperación mejorada, siguiendo nuestro trabajo reciente, lo que mejora significativamente la eficiencia y controlabilidad del modelo resultante. Finalmente, como se describe anteriormente, realizamos un ajuste fino de instrucciones en una amplia gama de tareas diferentes de generación de imágenes y texto.
A medida que la industria de IA continúa evolucionando, los modelos generativos como CM3leon se vuelven cada vez más sofisticados. Estos modelos aprenden la relación entre las imágenes y el texto mediante el entrenamiento con millones de ejemplos de imágenes, pero también pueden reflejar cualquier sesgo presente en los datos de entrenamiento. Si bien la industria aún se encuentra en las primeras etapas de comprender y abordar estos desafíos, creemos que la transparencia será clave para acelerar el progreso.
Por lo tanto, y como se describe en nuestro artículo, hemos entrenado a CM3leon utilizando un conjunto de datos con licencia. Esto demuestra que es posible lograr un rendimiento sólido con una distribución de datos muy diferente a la de todos los modelos anteriores. Al hacer nuestro trabajo transparente, esperamos fomentar la colaboración e innovación en el campo de la IA generativa. Creemos que al trabajar juntos, podemos crear modelos que no solo sean más precisos, sino también más justos y equitativos para todos.
Abriendo el camino a los modelos de lenguaje multimodales
Con el objetivo de crear modelos generativos de alta calidad, creemos que el sólido rendimiento de CM3leon en una variedad de tareas es un paso hacia una generación e comprensión de imágenes de mayor fidelidad. Modelos como CM3leon podrían ayudar en última instancia a impulsar la creatividad y mejorar las aplicaciones en el metaverso. Esperamos explorar los límites de los modelos de lenguaje multimodales y lanzar más modelos en el futuro.






¿Cansado de que tus proyectos de inteligencia artificial se queden en el “hola mundo”? Con Hermes Agent, puedes crear agentes autónomos que investiguen, codifiquen y desplieguen soluciones por ti. En esta guía, te mostramos cómo pasar de cero a un agente funcional en menos de 30 minutos, desde la instalación básica hasta la orquestación de flujos multiagente, con ejemplos de código, comandos CLI y recomendaciones para optimizar tu contenido.
La inteligencia artificial está transformando la creación de contenido visual. En 2026, herramientas como Runway, Pika y Synthesia permiten generar videos ultrarealistas, avatares con voz natural y efectos cinematográficos a partir de texto o imágenes. Esta guía comparativa analiza las 15 plataformas más destacadas, sus funciones, ventajas y casos de uso ideales para que elijas la que mejor se adapte a tus necesidades.
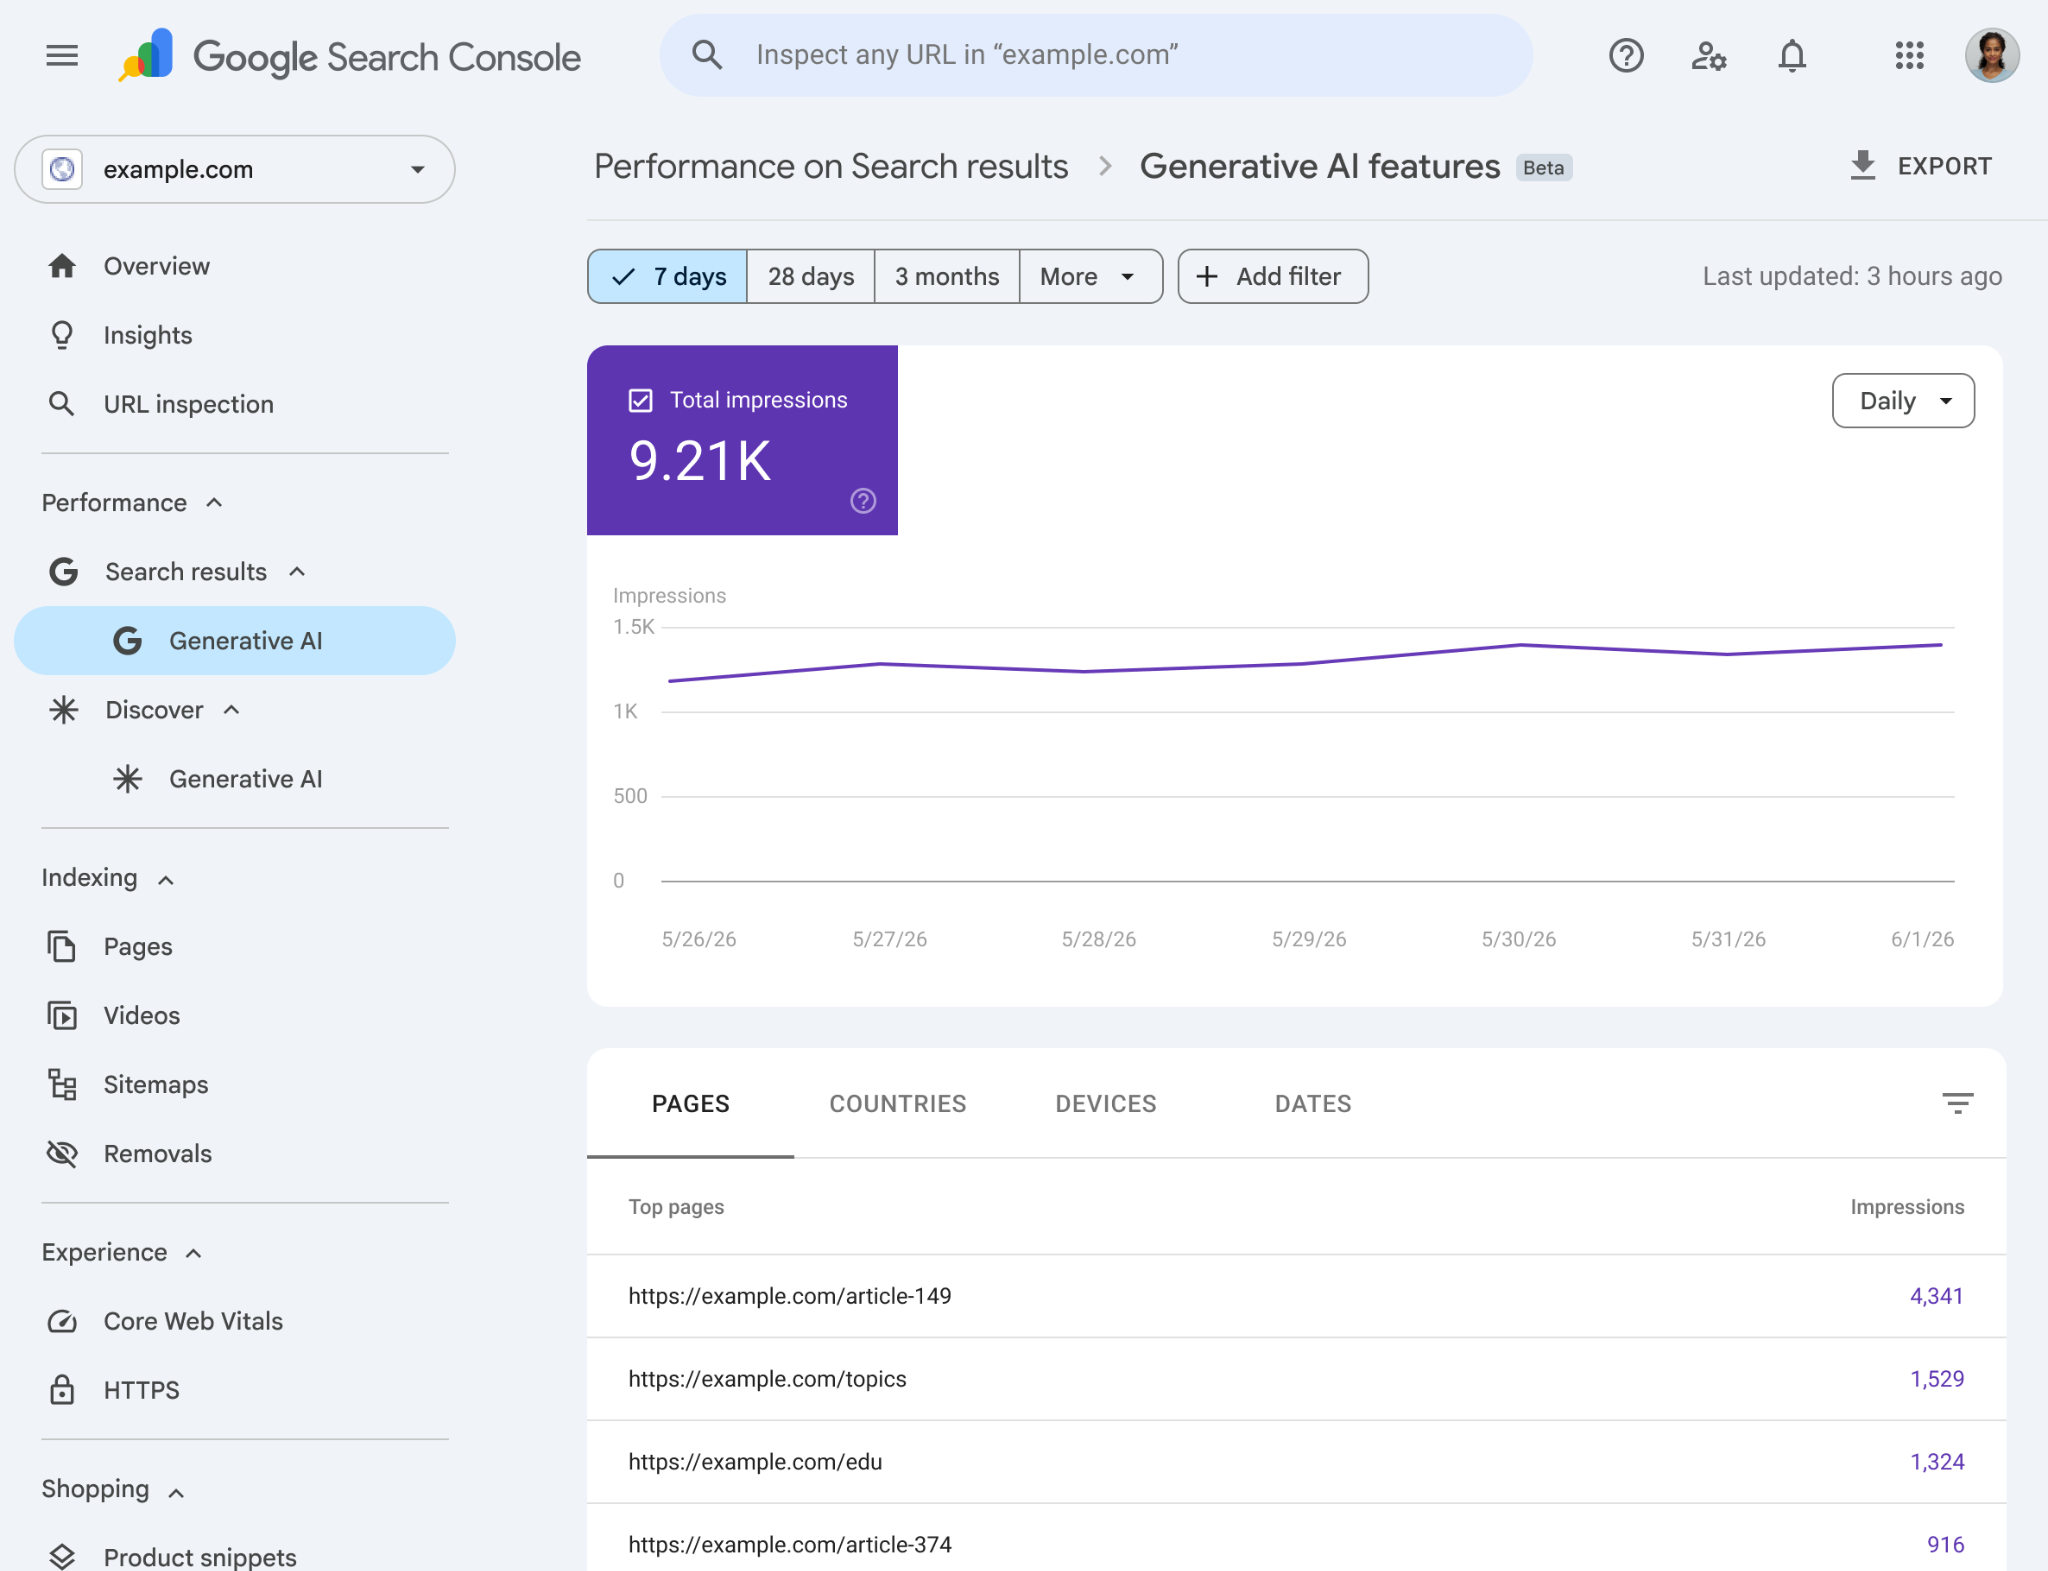
El 3 de junio de 2026, Google anunció el lanzamiento de nuevos informes en Search Console para medir el rendimiento de la inteligencia artificial generativa en la Búsqueda y en Discover. Estos informes permiten analizar la visibilidad de un sitio en funciones como Vistas creadas con IA y el Modo IA, además de ofrecer datos detallados sobre impresiones, páginas, países y dispositivos.
-

 Apps11 años ago
AMPcast, la herramienta de Pandora que permite a los artistas grabar mensajes de audio directamente a sus seguidores
-
 Blogs5 años ago
Conoce los mejores sitios de Torrents para descargar todo tipo de contenidos
-
Android5 años ago
Aprende cómo usar Discord para ver películas con tus amigos
-
Arte y Cultura14 años ago
Colección de fondos de pantalla basados en Super Héroes
-

 Almacenamiento2 años ago
Cómo usar TeraBox: La guía definitiva para aprovechar 1 TB de almacenamiento en la nube
-
Diseño13 años ago
css3ps: plugin que convierte archivos PSD a CSS3
-
Apps9 años ago
Picturethat, app que usa la Realidad Aumentada para visualizar cómo quedarían los cuadros antes de colgarlos
-
Eventos Especiales13 años ago
Especial Día de la Madres: fondos de pantalla especiales para Mamá