


Curiosidades
Seed-OSS-36B de ByteDance Guía para descargar instalar y usar este modelo de IA con 512K de contexto

Seed-OSS-36B, lanzado por ByteDance el 20 de agosto de 2025, es el primer modelo de inteligencia artificial open-source con 512 000 tokens de contexto nativo, licencia Apache 2.0 y capacidades de razonamiento avanzado.
Esta guía te enseña desde cero cómo descargarlo, instalarlo en Windows, Mac o Linux, configurar su API para herramientas como Jan.ai, y alternativas prácticas si no tienes hardware propio. También incluye ejemplos por industria, comparativas técnicas y limitaciones reales para que tomes una decisión informada.
¿Qué es Seed-OSS-36B y por qué es revolucionario?
Desarrollado por el Seed Team de ByteDance, este modelo fue lanzado el 20 de agosto de 2025 como una respuesta open-source a los modelos cerrados de OpenAI y Anthropic. A diferencia de otros proyectos, Seed-OSS-36B está optimizado para uso internacional, con soporte multilingüe robusto y tres variantes diseñadas para investigación, desarrollo comercial y workflows agentes.
Características clave
- 512 000 tokens de contexto nativo: equivalente a unas 1 600 páginas de texto, ideal para analizar documentos completos sin fragmentación.
- Thinking Budget: permite ajustar la profundidad del razonamiento (ej. 512 tokens para respuestas rápidas o 8 192 para análisis complejos).
- Tres variantes:
- Seed-OSS-36B-Base: con datos sintéticos, para tareas generales.
- Seed-OSS-36B-Base-woSyn: sin datos sintéticos, ideal para investigación.
- Seed-OSS-36B-Instruct: optimizado para seguir instrucciones y workflows agentes.
- Licencia Apache 2.0: uso comercial gratuito, sin regalías.
- Benchmarks destacados:
- 91.7 % en AIME24 (razonamiento matemático).
- 67.4 en LiveCodeBench v6 (programación).
- 94.6 en RULER (manejo de contexto largo).
¿Para quién es útil?
- Desarrolladores que necesitan integrar IA con contexto ultra-largo en sus aplicaciones.
- Empresas que buscan reducir costos de APIs comerciales.
- Investigadores que requieren un modelo base sin restricciones de licencia.
- Usuarios avanzados que quieren experimentar con IA local sin depender de la nube.
¿Se puede usar Seed-OSS-36B en línea?
No existe una versión oficial en línea de Seed-OSS-36B. ByteDance lo diseñó como un modelo open-source y autoalojado. Sin embargo, hay alternativas prácticas si no tienes hardware propio.
Opción 1: Servicios en la nube con GPU
Puedes alquilar servidores con GPU en plataformas como:
- RunPod: instancias con GPUs A100 RTX 4090 desde 0.50 USD por hora.
- Lambda Labs: especializado en IA, con instancias desde 0.60 USD por hora.
- Google Colab Pro: permite usar GPUs A100, pero con limitaciones de tiempo y contexto.
Pasos para usar Seed-OSS-36B en RunPod:
- Crea una cuenta en runpod.io.
- Selecciona un pod con al menos 48 GB de VRAM (ej. A100 48GB).
- Conéctate vía SSH y sigue los pasos de instalación descritos más adelante (usa cuantización 4-bit).
- Expón el puerto 4321 para acceder a la API desde Jan.ai o tu aplicación.
Opción 2: APIs de terceros (no oficiales)
Algunos desarrolladores podrían ofrecer acceso a Seed-OSS-36B a través de APIs no oficiales. Riesgos: sin garantías de disponibilidad o soporte, posibles problemas de seguridad y privacidad. Evita compartir datos sensibles con servicios no verificados.
Opción 3: Alternativas en línea con contexto largo
| Modelo o Plataforma | Contexto (tokens) | Tipo de acceso |
|---|---|---|
| Mistral Large | 32K | API de pago |
| Claude 3 Opus | 200K | API de pago |
| Perplexity AI | 50K | Gratis con límites |
| Hugging Face Inference | 8K–32K | API gratuita limitada |
| Groq Cloud | 32K | API de pago rápida |
Limitaciones técnicas
- Requisitos de hardware:
- Precisión bfloat16: 72 GB de VRAM para contexto completo.
- Cuantización 4-bit: 20–24 GB de VRAM, posible pérdida de calidad.
- En CPU es extremadamente lento y poco práctico.
- Velocidad de inferencia: 20 tokens/seg en RTX 4090 con 4-bit; latencia puede superar 5 s en contextos largos.
- Soporte comunitario: sin soporte oficial; dudas en foros como Reddit r/LocalLLaMA o Hugging Face Discussions.
Limitaciones de uso
- No entiende automáticamente documentos complejos; requiere prompts bien estructurados y técnicas como RAG.
- En tareas creativas puede ser menos fluido que GPT-4.
- No incluye filtros de contenido robustos; debes implementar tu propia moderación.
- Ejecutar el modelo tiene costos: entre 3 y 30 USD por hora en la nube.
¿Cuándo NO usar Seed-OSS-36B?
- Si necesitas baja latencia (chatbots en tiempo real).
- Si trabajas con hardware limitado (laptops sin GPU).
- Si buscas una solución plug-and-play sin configuración técnica.
- Si tu aplicación requiere soporte oficial y SLAs.
Guía de descarga e instalación (Windows, Mac, Linux)
Requisitos previos
- Hardware: GPU NVIDIA con 24 GB de VRAM mínimo (recomendado RTX 4090, A100, H100).
- Software: Python 3.10 o superior, Git y Git LFS, CUDA 12.x para GPU NVIDIA.
- Disco: 70 GB para el modelo completo.
Paso 1: Instalación de dependencias
En Windows (PowerShell como administrador)
winget install -e --id Git.Git
winget install -e --id Python.Python.3.10
git lfs install
python -m venv seed_env
.\seed_env\Scripts\activate
pip install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu121
pip install transformers accelerate
En Mac (Terminal)
brew install git git-lfs [email protected]
git lfs install
python3 -m venv seed_env
source seed_env/bin/activate
pip install torch torchvision torchaudio
En Linux (Ubuntu/Debian)
sudo apt update
sudo apt install -y git git-lfs python3.10-venv python3-pip
git lfs install
python3 -m venv seed_env
source seed_env/bin/activate
pip install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu121
pip install transformers accelerate
Paso 2: Descarga del modelo
| Variante | Uso recomendado | Tamaño |
|---|---|---|
| Seed-OSS-36B-Base | Tareas generales, fine-tuning | 70 GB |
| Seed-OSS-36B-Base-woSyn | Investigación, pre-entrenamiento | 70 GB |
| Seed-OSS-36B-Instruct | Seguimiento de instrucciones, agentes | 70 GB |
git lfs install
git clone https://huggingface.co/ByteDance-Seed/Seed-OSS-36B-Instruct
Paso 3: Cuantización (opcional pero recomendado)
pip install bitsandbytesfrom transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig
quant_config = BitsAndBytesConfig(
load_in_4bit=True,
bnb_4bit_compute_dtype="bfloat16",
bnb_4bit_quant_type="nf4",
)
model_id = "ByteDance-Seed/Seed-OSS-36B-Instruct"
tokenizer = AutoTokenizer.from_pretrained(model_id, trust_remote_code=True)
model = AutoModelForCausalLM.from_pretrained(
model_id,
quantization_config=quant_config,
device_map="auto",
trust_remote_code=True
)Paso 4: Ejecución básica
messages = [{"role": "user", "content": "Explica la fotosíntesis como si tuviera 10 años."}]
inputs = tokenizer.apply_chat_template(
    messages,
    tokenize=True,
    add_generation_prompt=True,
    return_tensors="pt",
    thinking_budget=512
)
outputs = model.generate(inputs.to(model.device), max_new_tokens=256)
print(tokenizer.decode(outputs[0], skip_special_tokens=True))
Configuración de la API para Jan.ai y otras herramientas
Opción 1: API local con vLLM (recomendado)
pip install vllmpython -m vllm.entrypoints.openai.api_server \
--model ./Seed-OSS-36B-Instruct \
--tensor-parallel-size 1 \
--chat-template ./Seed-OSS-36B-Instruct/chat_template.jinja \
--port 4321 \
--served-model-name seed_osscurl http://localhost:4321/v1/chat/completions \
-H "Content-Type: application/json" \
-d '{
"model": "seed_oss",
"messages": [
{"role": "system", "content": "Eres un asistente útil."},
{"role": "user", "content": "¿Cuál es la capital de Francia?"}
],
"thinking_budget": 512
}'Opción 2: Integración con Jan.ai
- Descarga e instala Jan.ai (jan.ai).
- Abre Jan.ai y haz clic en Add Model.
- Selecciona Custom Model.
- En Model URL ingresa: http://localhost:4321
- En Model Name escribe: seed_oss
- Guarda y selecciona el modelo en el menú.
Opción 3: API con FastAPI (desarrolladores)
pip install fastapi uvicornfrom fastapi import FastAPI
from pydantic import BaseModel
from transformers import AutoModelForCausalLM, AutoTokenizer
app = FastAPI()
class ChatRequest(BaseModel):
prompt: str
thinking_budget: int = 512
model_id = "./Seed-OSS-36B-Instruct"
tokenizer = AutoTokenizer.from_pretrained(model_id, trust_remote_code=True)
model = AutoModelForCausalLM.from_pretrained(model_id, device_map="auto", trust_remote_code=True)
@app.post("/chat")
def chat(request: ChatRequest):
messages = [{"role": "user", "content": request.prompt}]
inputs = tokenizer.apply_chat_template(
messages,
tokenize=True,
add_generation_prompt=True,
return_tensors="pt",
thinking_budget=request.thinking_budget
)
outputs = model.generate(inputs.to(model.device), max_new_tokens=512)
return {"response": tokenizer.decode(outputs[0], skip_special_tokens=True)}
# Ejecutar: python api.py
# Consultar: curl -X POST http://localhost:8000/chat -H "Content-Type: application/json" -d '{"prompt": "Explica relatividad", "thinking_budget": 1024}'
Ejemplos prácticos por industria
1. Desarrollo de software
Analiza el siguiente código Python y responde:
1. ¿Hay errores de seguridad?
2. ¿Cómo optimizar rendimiento?
3. ¿Sigue las mejores prácticas?

Código:
[Pega aquí tu código]
2. Servicios legales
Revisa el contrato y responde:
1. Cláusulas de terminación anticipada
2. Posibles cláusulas abusivas según ley local
3. Plazos de notificación

Contrato:
[Pega aquí el texto]
3. Investigación académica
Resume los hallazgos clave de estos estudios en una tabla con título, metodología, resultados y limitaciones.

Estudios:
[Pega aquí los textos]
Comparativa con alternativas open-source
| Modelo | Contexto (tokens) | MATH Score | VRAM (bfloat16) | Licencia | Mejor para | Enlace |
|---|---|---|---|---|---|---|
| Seed-OSS-36B | 512K | 81.7 | 72 GB | Apache 2.0 | Contexto largo, razonamiento adaptable, agentes | Hugging Face |
| Llama 3 70B | 8K | ~50 | 140 GB | Llama 3 | Equilibrio general, chatbots | Hugging Face |
| Qwen2 72B | 32K | 63.5 | 144 GB | Qwen | Multilingüe, programación | Hugging Face |
| Mistral 8x22B | 64K | ~70 | 192 GB | Apache 2.0 | Alto rendimiento, multitarea | Hugging Face |
| DeepSeek 67B | 128K | ~65 | 134 GB | DeepSeek | Programación, análisis de código | Hugging Face |
Conclusión y próximos pasos
Seed-OSS-36B es ideal si necesitas contexto ultra-largo, control total sobre el razonamiento y licencia permisiva. Empieza evaluando tu hardware, prueba con contextos pequeños y únete a la comunidad para resolver dudas. Si no tienes GPU, considera RunPod o las alternativas en línea mencionadas.





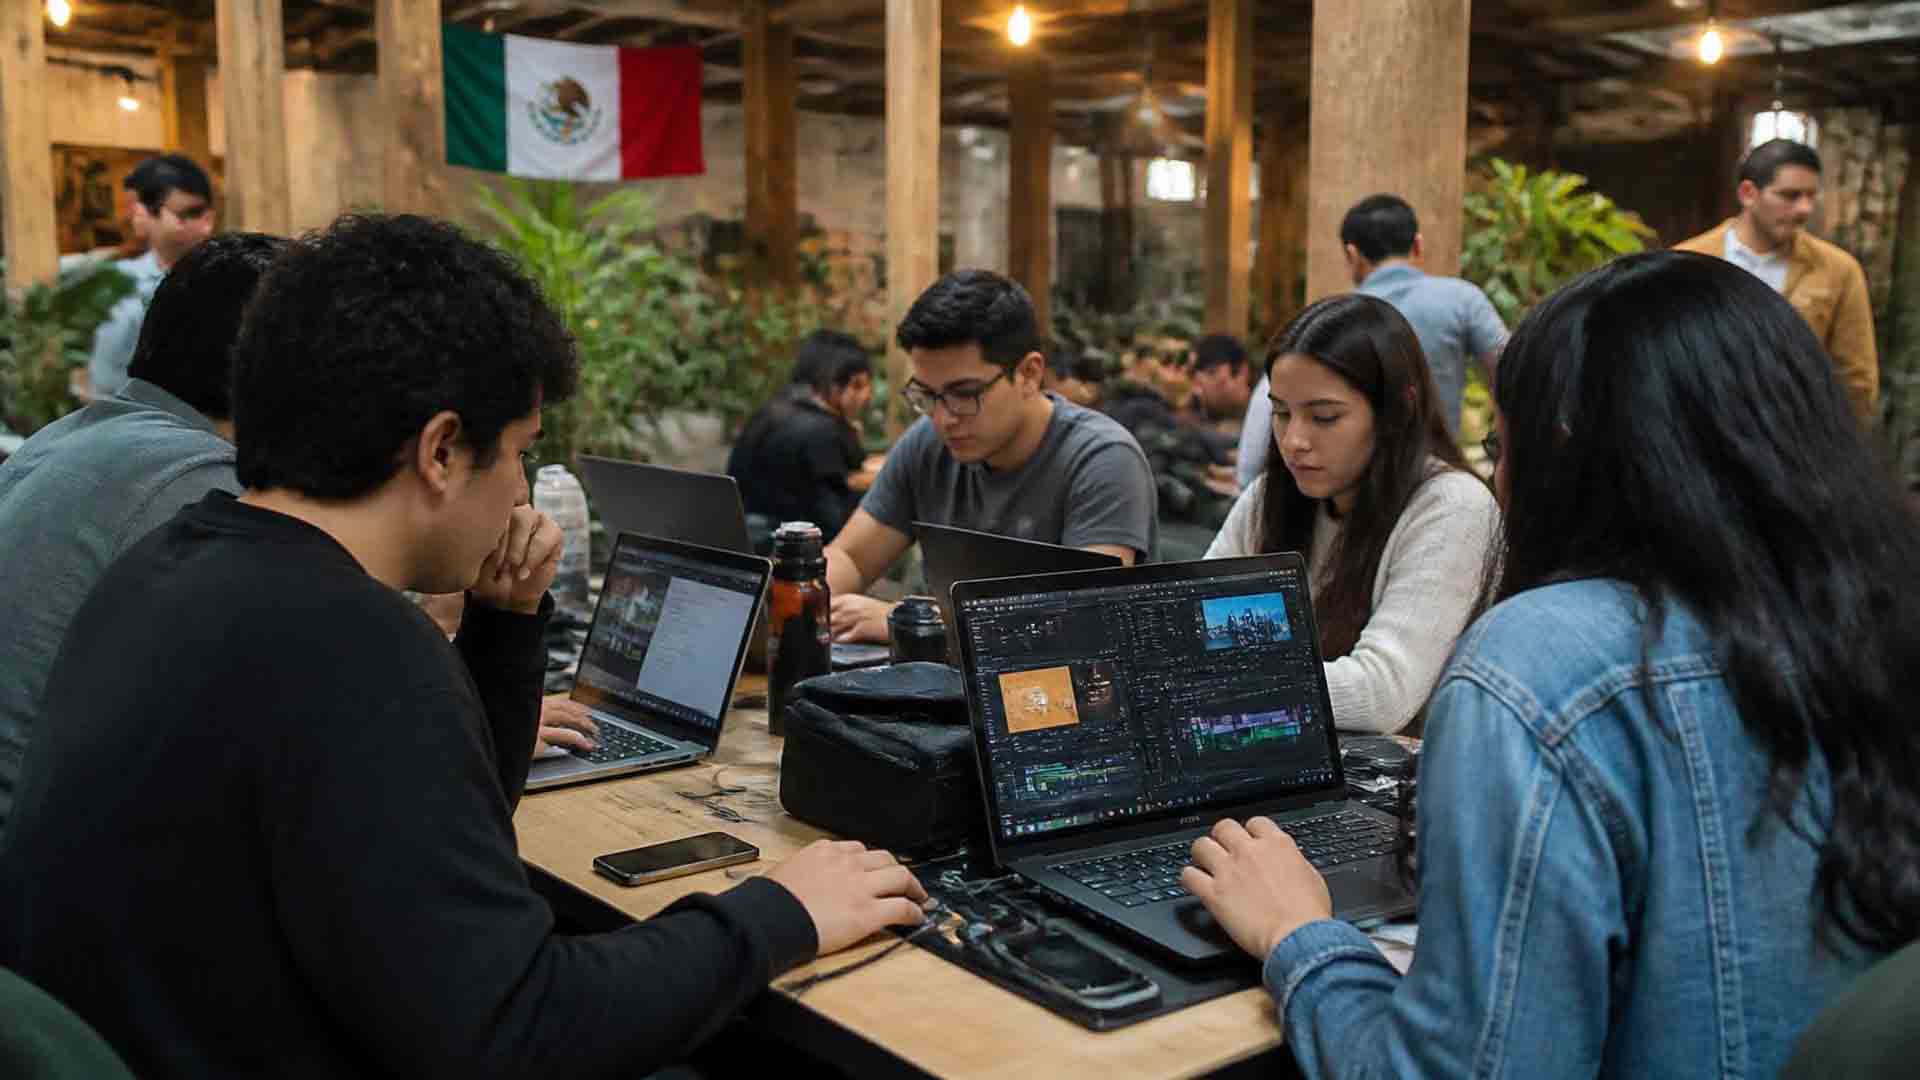
CapCut participará en México Tech Week 2026 con el CapCut Design Studio: Speed-to-Scale Hackathon, una activación gratuita para crear en cuatro horas una pieza lista para mostrar usando herramientas de IA. El cupo es de 30 lugares con registro previo.
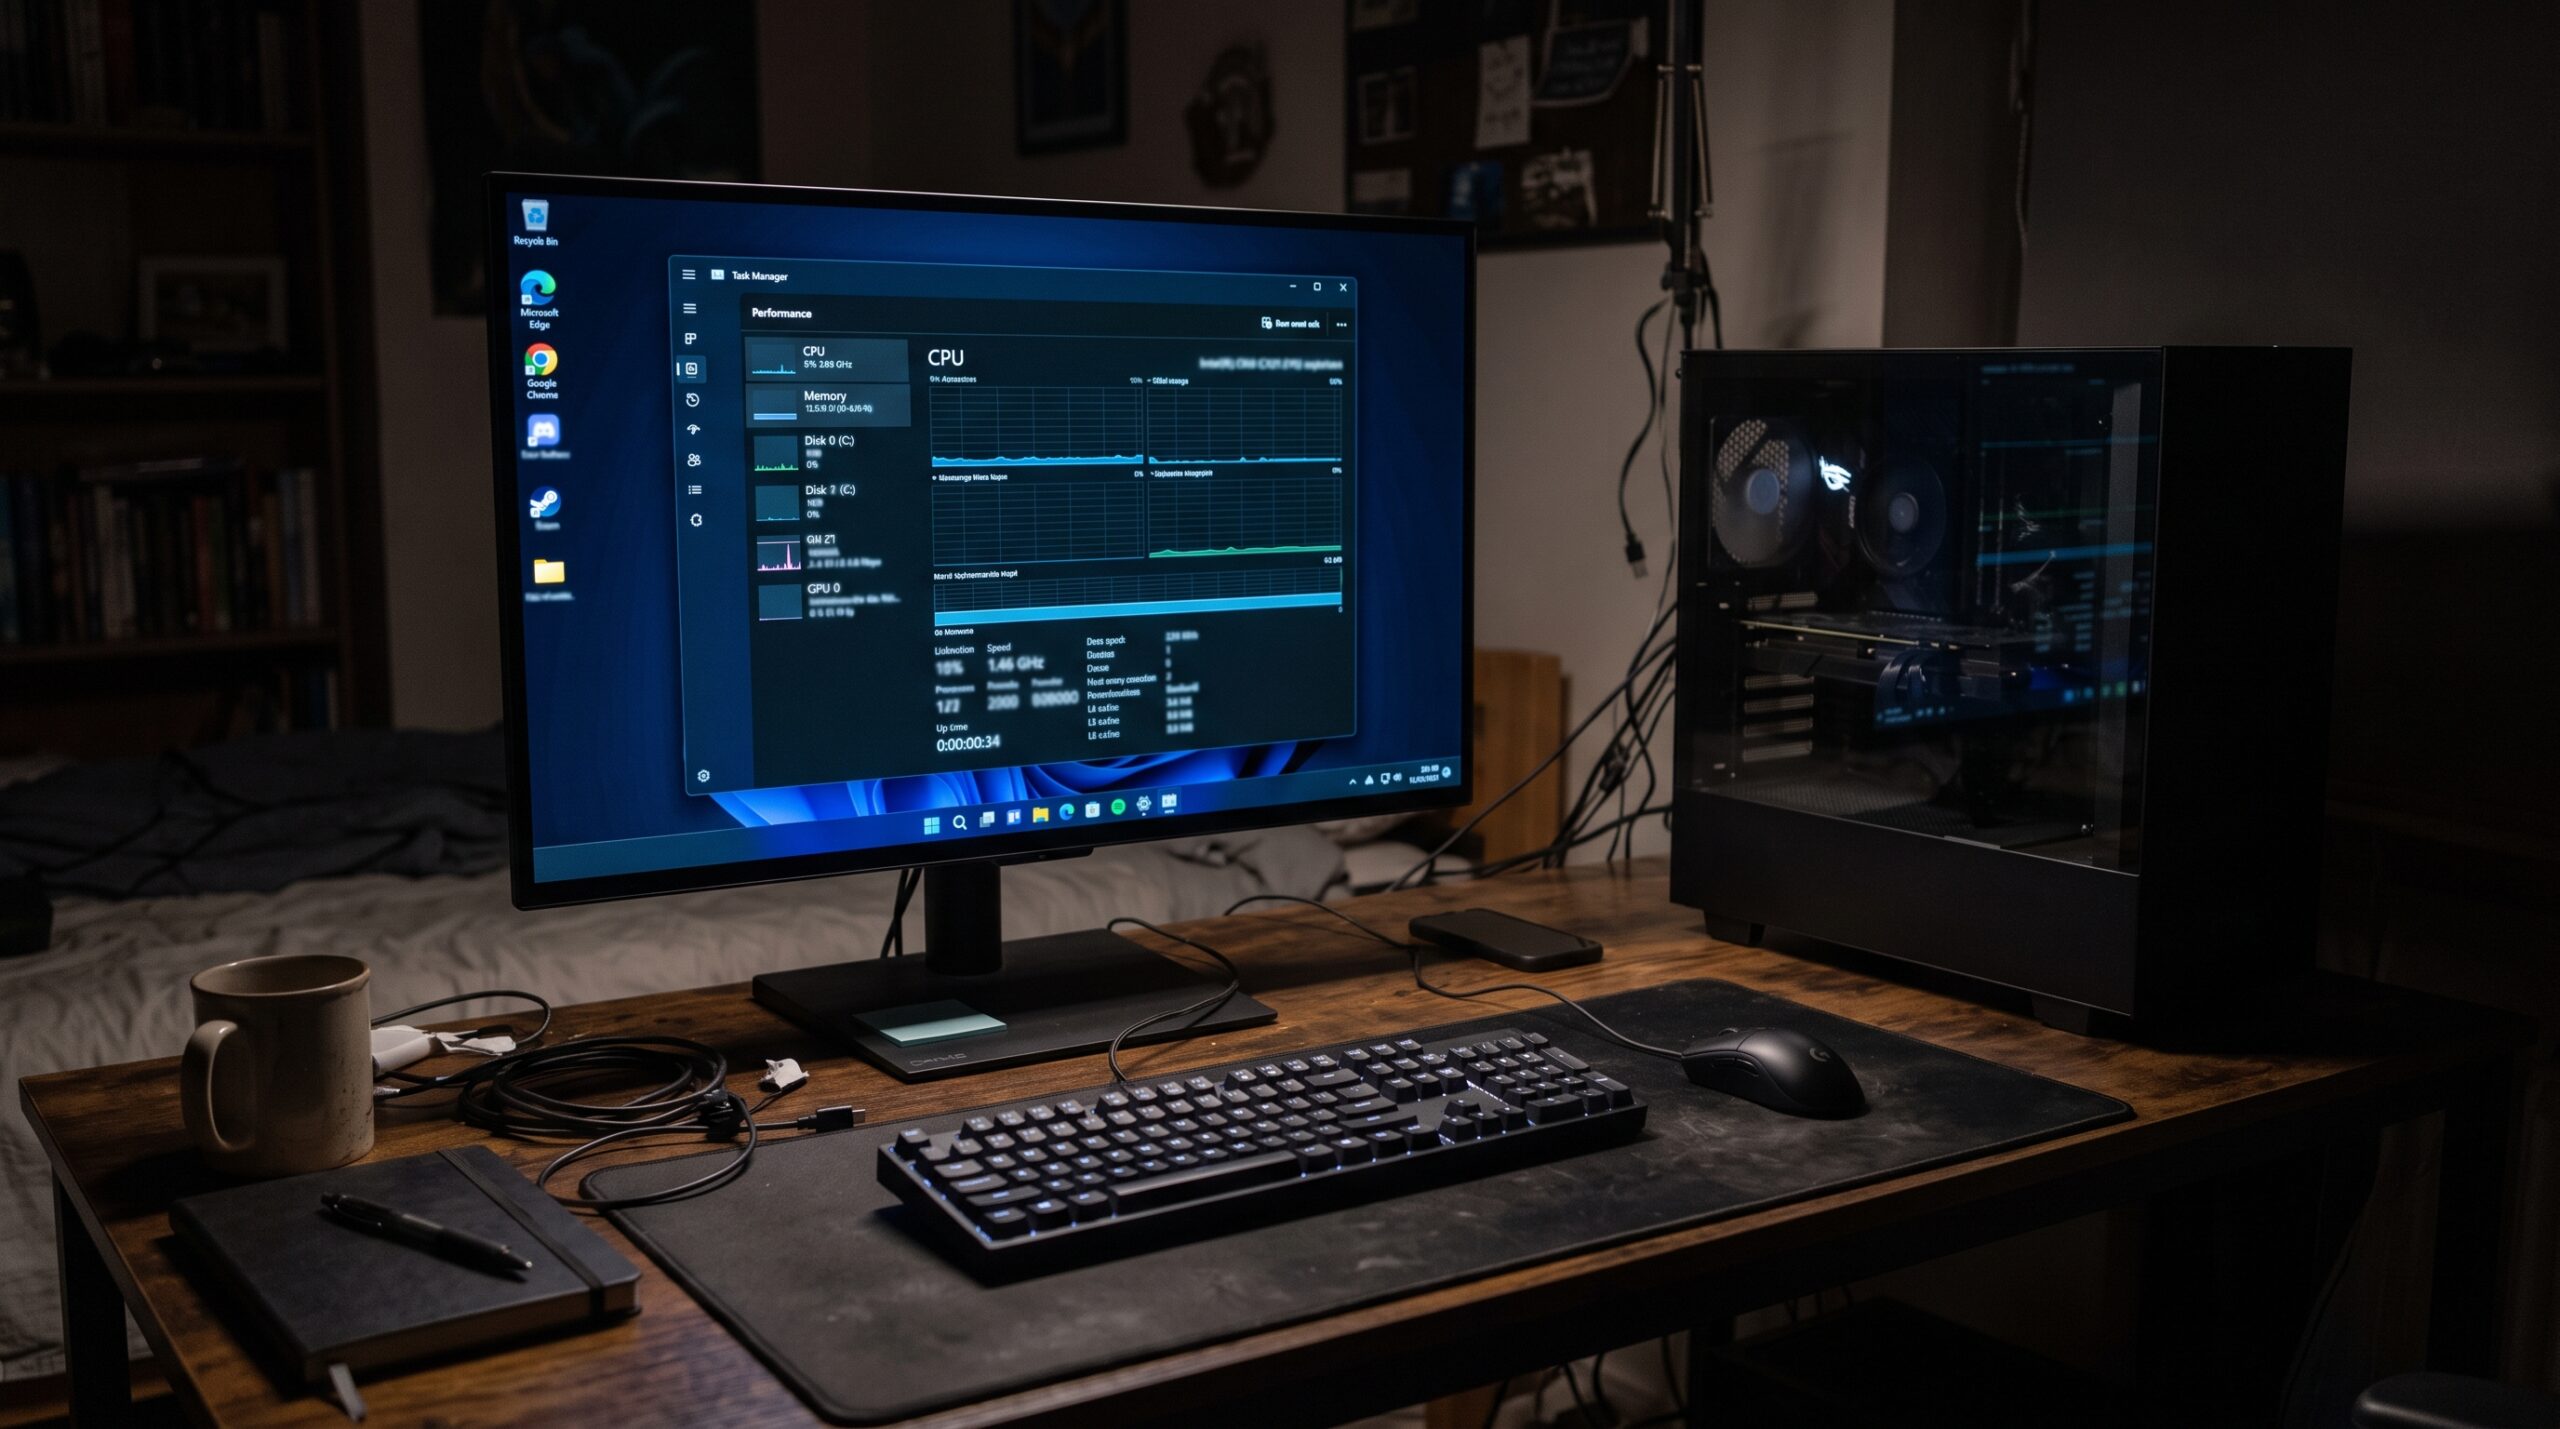
El usuario @soyaakinohara6 compartió en X una instalación de Windows 11 que consume apenas 2.5GB de 16GB de RAM en reposo, un 16 por ciento de utilización. El método: instalar con Rufus, eliminar todo el bloatware y luego aplicar la actualización 26H2.
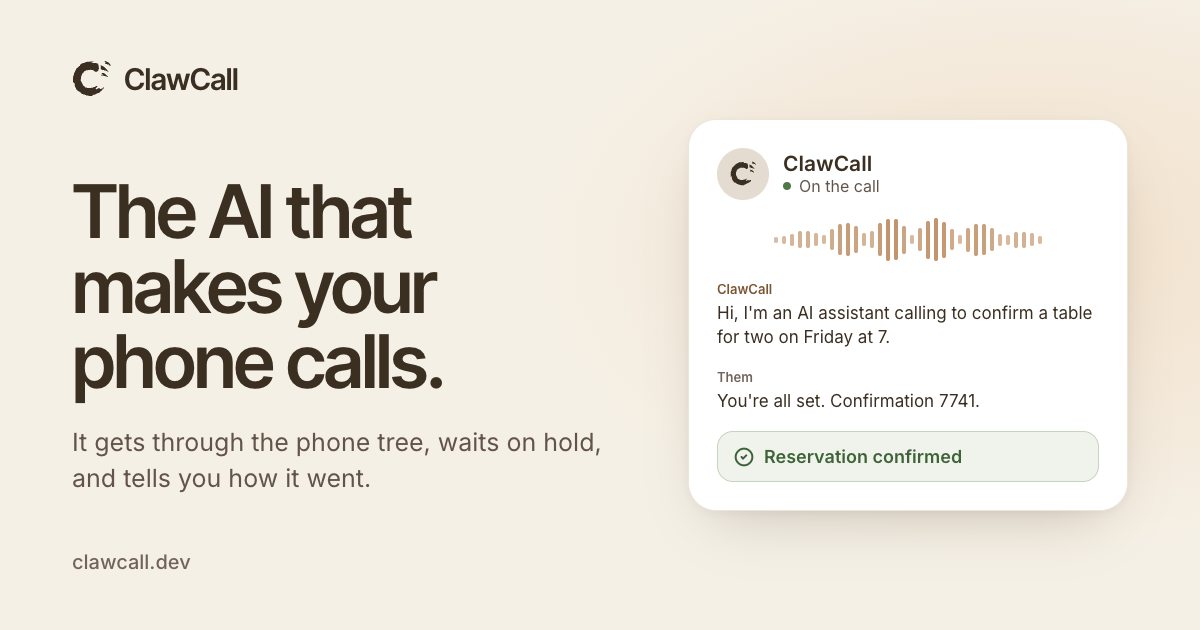
ClawCall es una inteligencia artificial que marca números de Estados Unidos, atraviesa los menús telefónicos, espera en la fila de retención y conversa con quien atienda. Al final reporta el resultado y la transcripción capturada. Funciona desde ChatGPT, Claude, iMessage y una API REST, con las primeras 30 llamadas gratis.
-

 Apps11 años ago
AMPcast, la herramienta de Pandora que permite a los artistas grabar mensajes de audio directamente a sus seguidores
-
 Blogs5 años ago
Conoce los mejores sitios de Torrents para descargar todo tipo de contenidos
-
Android5 años ago
Aprende cómo usar Discord para ver películas con tus amigos
-
Arte y Cultura14 años ago
Colección de fondos de pantalla basados en Super Héroes
-

 Almacenamiento2 años ago
Cómo usar TeraBox: La guía definitiva para aprovechar 1 TB de almacenamiento en la nube
-
Diseño13 años ago
css3ps: plugin que convierte archivos PSD a CSS3
-
Apps9 años ago
Picturethat, app que usa la Realidad Aumentada para visualizar cómo quedarían los cuadros antes de colgarlos
-
Eventos Especiales13 años ago
Especial Día de la Madres: fondos de pantalla especiales para Mamá