
Audio
VibeVoice la familia open source de voz con IA que impulsa Microsoft

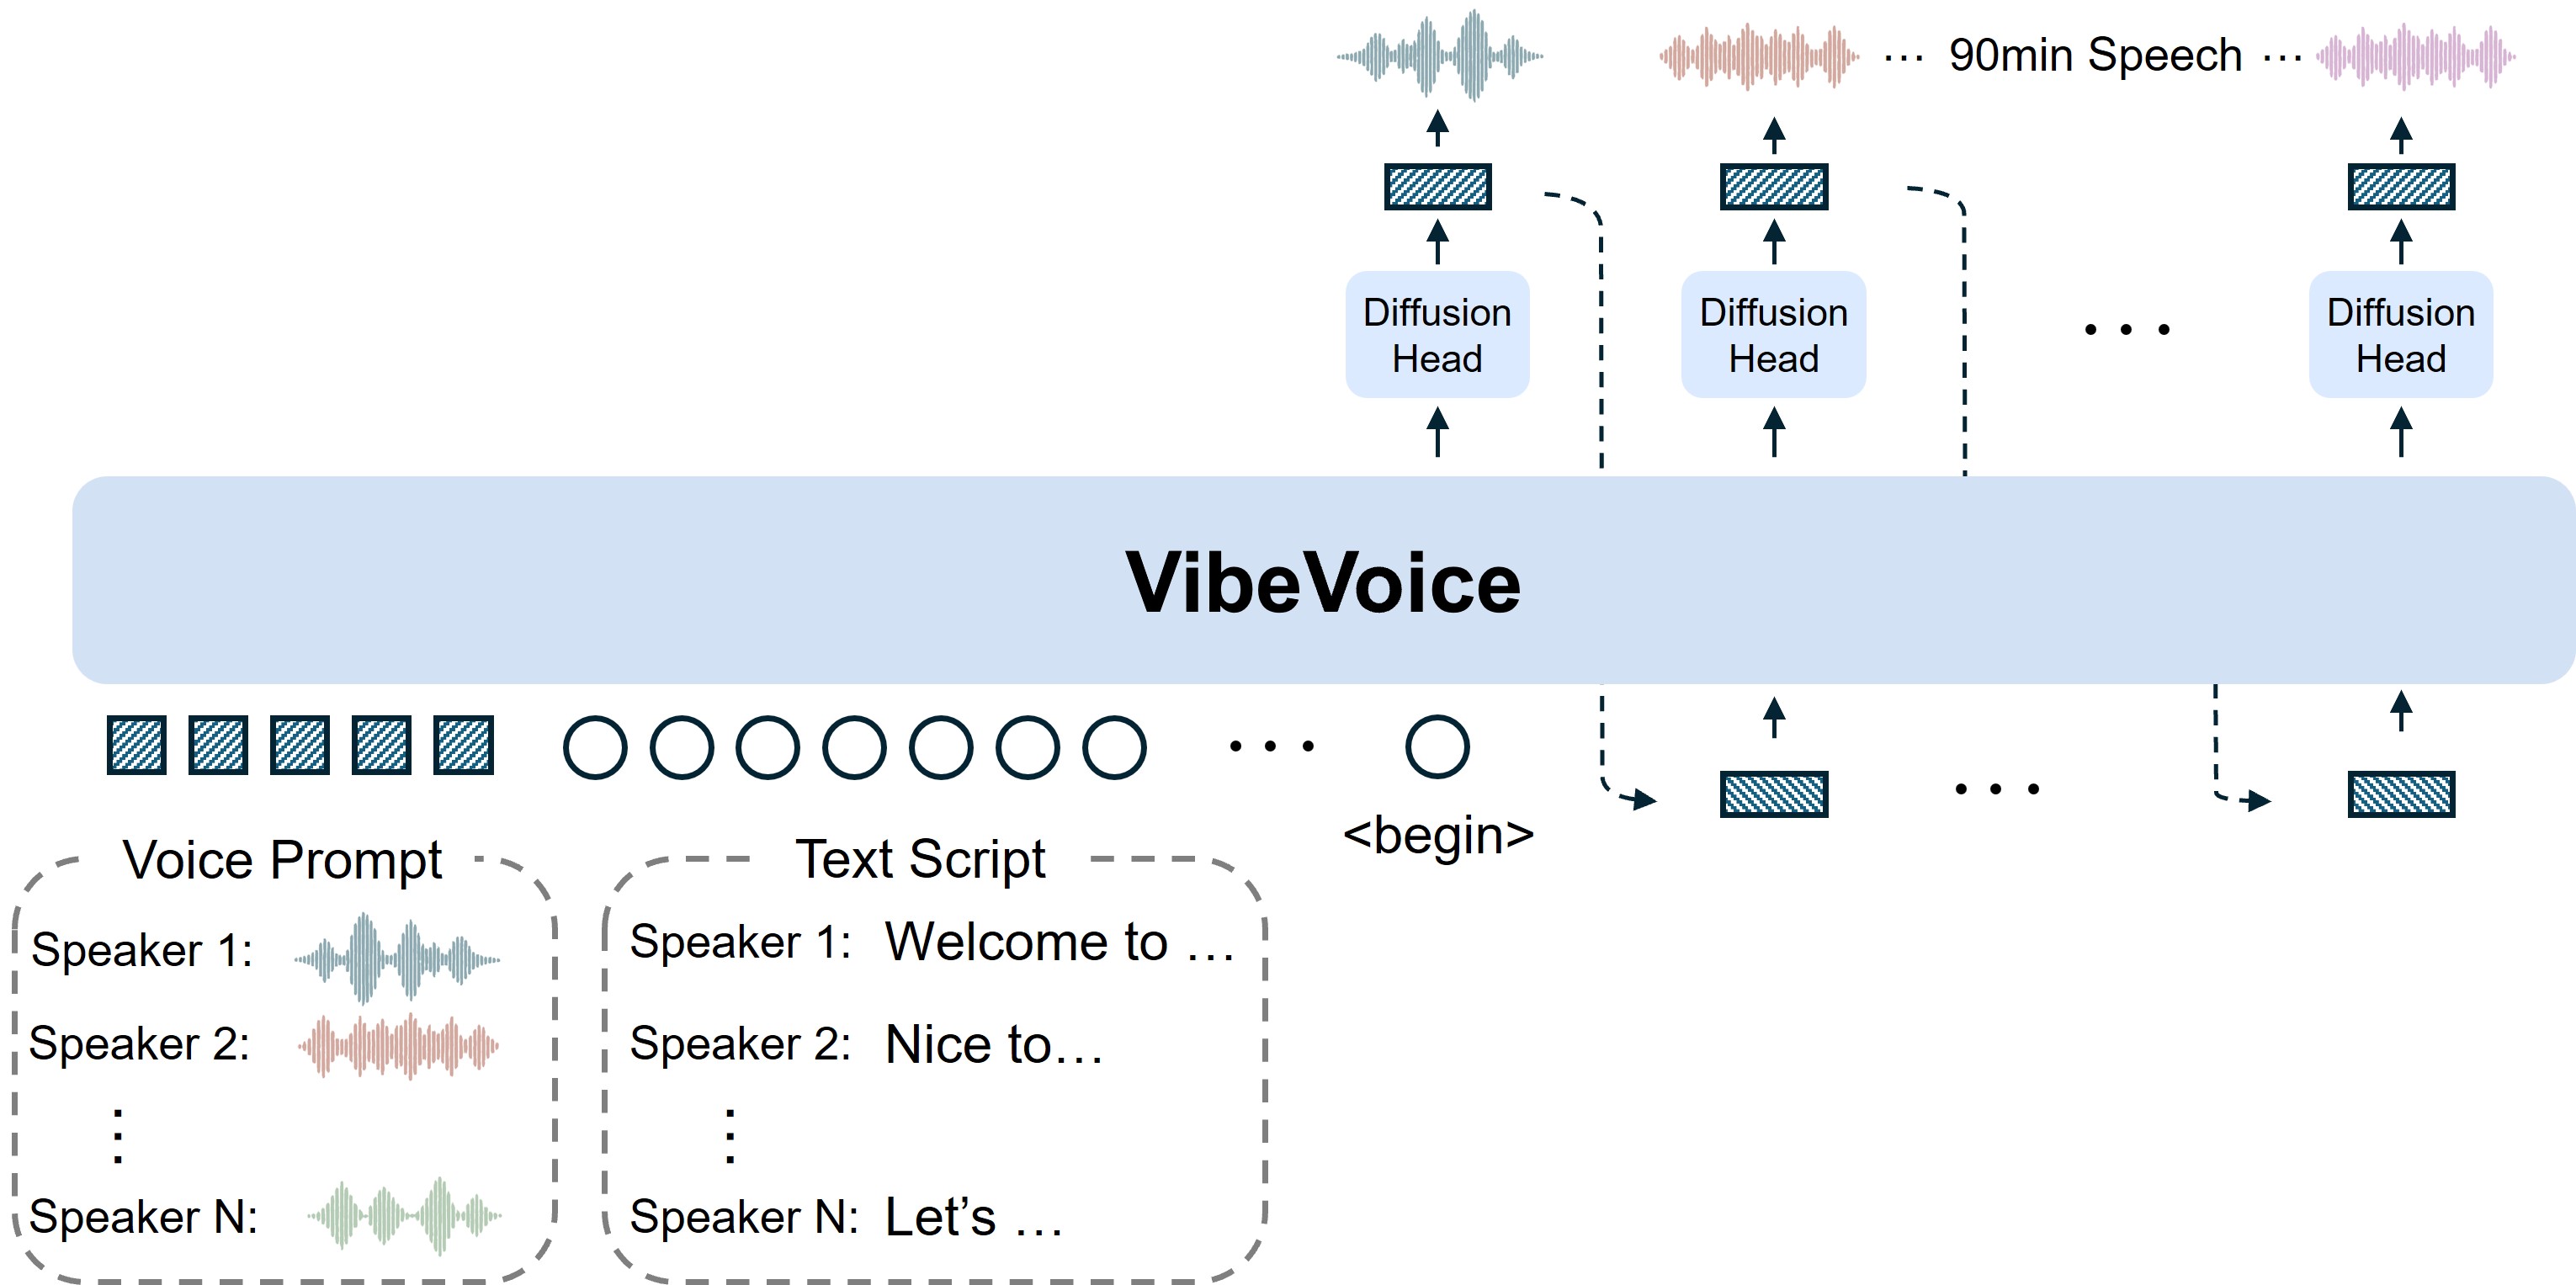
VibeVoice es la familia de modelos de voz con inteligencia artificial publicada como código abierto por Microsoft en GitHub. Combina reconocimiento de voz capaz de transcribir 60 minutos de audio en una sola pasada con síntesis de voz experimental en tiempo real, usando tokenizadores de voz a 7.5 Hz y un marco de difusión de siguiente token.
¿Qué es VibeVoice y qué modelos incluye?
El proyecto, disponible bajo licencia MIT y con más de 56,000 estrellas en GitHub, define su ambición en una frase: Open-Source Frontier Voice AI. La familia cubre dos direcciones del audio con IA: el reconocimiento automático de voz (ASR, por sus siglas en inglés) y la síntesis de texto a voz (TTS), con un componente central compartido.
Esa base común son los tokenizadores continuos de voz, acústico y semántico, que operan a una tasa de fotogramas ultrabaja de 7.5 Hz. Su función es preservar la fidelidad del audio mientras reducen drásticamente el costo computacional de las secuencias largas. Sobre ellos trabaja un marco de next-token diffusion: un modelo de lenguaje interpreta el contexto textual y el flujo del diálogo, y una cabeza de difusión genera los detalles acústicos de alta fidelidad.
| Modelo | Tarea | Estado verificado |
|---|---|---|
| VibeVoice-ASR-7B | Voz a texto | Audio de 60 minutos en una sola pasada |
| VibeVoice-ASR-Streaming | Transcripción en vivo | 10 idiomas con palabras clave personalizadas |
| VibeVoice-ASR-BitNet | ASR en CPU | Comprimido de 4.62 GB a 1.58 GB, sin GPU |
| VibeVoice-TTS-1.5B | Texto a voz | Pesos en Hugging Face; código retirado del repositorio |
| VibeVoice-Realtime-0.5B | TTS en tiempo real | Primera voz audible en ~300 ms |
¿Por qué su ASR de audio largo es diferente?
El componente más activo del proyecto es VibeVoice-ASR, publicado como pesos abiertos en enero de 2026. Su propuesta distintiva frente a los transcribidores convencionales es que no trocea el audio en fragmentos cortos que pierden contexto global: acepta hasta 60 minutos de audio continuo dentro de una longitud de 64,000 tokens, manteniendo el seguimiento de hablantes y la coherencia semántica durante toda la hora.
El resultado no es un texto plano, sino una transcripción estructurada que responde las tres preguntas de una conversación: quién habló, cuándo y qué dijo. El modelo integra en una sola pasada reconocimiento, diarización y marcas de tiempo. Además, los usuarios pueden suministrar hotwords personalizados —nombres propios, términos técnicos, contexto del tema— para guiar el reconocimiento y mejorar la precisión en dominios específicos. Es nativamente multilingüe, con soporte declarado para más de 50 idiomas.
Vale la pena señalar la velocidad de evolución: en marzo de 2026 el modelo se integró a Azure AI Foundry Labs para pruebas directas desde la nube de Microsoft y llegó a la biblioteca Transformers de Hugging Face; en julio apareció la variante BitNet para CPU y en septiembre el modelo de streaming. Para transcribir mientras el audio aún llega, ASR-Streaming emite texto por cada fragmento en 10 idiomas, con palabras clave personalizables.
¿Cómo logra correr sin GPU?
La variante VibeVoice-ASR-BitNet es quizá el anuncio más práctico para el usuario común. Se trata de un motor de inferencia para CPU que comprime el modelo de 4.62 GB a 1.58 GB mediante cuantización heterogénea (I8_S + I2_S), logrando inferencia en tiempo real —factor RTF menor a 1— con apenas 3 hilos de procesador. Dicho en simple: transcribe más rápido de lo que dura el audio, sin tarjeta gráfica.
Esa apuesta por el cómputo local conecta con una tendencia que ya analizamos en OneDigital, como el caso de la voz conversacional de PersonaPlex ejecutándose de forma local en tu PC: el audio con IA ya no exige forzosamente nube ni hardware caro.
¿Qué ofrece el lado de síntesis de voz?
Aquí la historia tiene un giro que conviene contar completo. En agosto de 2025 Microsoft liberó VibeVoice-TTS, un modelo capaz de sintetizar hasta 90 minutos de habla con hasta 4 hablantes distintos en una sola pasada, manteniendo consistencia y turnos de habla naturales; el trabajo fue aceptado como presentación Oral en ICLR 2026. Pocas semanas después, en septiembre, la compañía retiró el código TTS del repositorio: detectó usos contrarios a su intención declarada y, apelando al uso responsable de la IA, lo removió. Los pesos permanecen publicados en Hugging Face, pero el propio README deshabilita su opción de prueba rápida.
Lo que sí sigue disponible para experimentación es VibeVoice-Realtime-0.5B, un modelo ligero de síntesis en tiempo real con entrada de texto en flujo, generación robusta de formas largas de unos 10 minutos y primera voz audible en alrededor de 300 milisegundos. En diciembre de 2025 se añadieron voces experimentales en nueve idiomas —incluido el español— y 11 estilos de voz en inglés, lo que lo vuelve accesible para hispanohablantes que quieran probarlo en Colab.
En el terreno comercial del TTS, la competencia sigue siendo dura: herramientas como la clonación de voz gratuita de Chatterbox TTS que compite con ElevenLabs muestran lo dinámico que está el ecosistema open source de voz.
¿Qué riesgos y límites reconoce Microsoft?
El propio repositorio es explícito: la voz sintética de alta calidad puede usarse para suplantación, fraude o desinformación, y el modelo hereda sesgos de su modelo base, Qwen2.5 1.5B en esta versión. Microsoft recomienda verificar transcripciones, evitar usos engañosos y divulgar cuándo el contenido fue generado por IA. Y hay una advertencia clave para empresas: no recomienda su uso en aplicaciones comerciales o del mundo real sin pruebas adicionales; el proyecto está destinado a investigación y desarrollo.
¿Cómo empezar a usarlo?
Para desarrolladores, las rutas de entrada son razonablemente amables. Los pesos están publicados en Hugging Face, existe un playground oficial para probar ASR sin instalar nada, el código de finetuning está disponible para ajustar el modelo a dominios propios, y la inferencia acelerada con vLLM está documentada para quienes necesiten servirlo a escala. El sitio oficial del proyecto concentra demos, documentación y ejemplos.
Quien busque solo dictado práctico en español tiene alternativas más sencillas de adopción, pero para quien construye productos de voz, un ASR de hora completa con diarización y marcas de tiempo es una pieza poco común en el mundo abierto, comparable en espíritu a lo que significó Dia para el texto a voz abierto.
¿Cuántos idiomas soporta VibeVoice?
Depende del componente. VibeVoice-ASR declara soporte nativo para más de 50 idiomas, la variante de streaming reconoce 10 idiomas con palabras clave personalizadas, y las voces experimentales de VibeVoice-Realtime cubren nueve idiomas, entre ellos el español, además de 11 estilos de voz en inglés.
¿Se puede usar VibeVoice en un producto comercial?
No sin precaución. Microsoft aclara en el propio repositorio que la familia está destinada a investigación y desarrollo, y que no recomienda su uso en aplicaciones comerciales o del mundo real sin pruebas y desarrollo adicionales. También pide divulgar cuándo el contenido fue generado con IA y cumplir las leyes aplicables de cada jurisdicción.
Conclusión: ¿qué tan relevante es VibeVoice?
Mucho, y por una razón que va más allá de los números. Microsoft está aportando al dominio abierto algo que pocos labs entregan: reconocimiento de voz de audio largo con estructura de quién-cuándo-qué, variantes que corren en CPU de consumo y transparencia total sobre riesgos, hasta el punto de retirar su propio TTS ante usos indebidos. El repositorio oficial de VibeVoice en GitHub queda como referencia para cualquiera que trabaje en transcripción, podcasts o accesibilidad. Si la cadencia de 2026 se mantiene, la familia seguirá creciendo por el lado de ASR, y ese es el frente que conviene vigilar.
Lo más leído en Audio
-
 Apps
Hex herramienta gratuita que convierte tu voz en texto
Hex es una herramienta de dictado por voz local para Mac, Windows y Linux. Mantienes presionada una tecla,…
-
Audio
VibeVoice la familia open source de voz con IA que impulsa Microsoft
VibeVoice es la familia de modelos de voz con inteligencia artificial publicada como código abierto por Microsoft en…






Hex es una herramienta de dictado por voz local para Mac, Windows y Linux. Mantienes presionada una tecla, hablas, y el texto se pega en cualquier aplicación. Su reconocimiento de voz funciona en el propio dispositivo, sin suscripciones ni nube.
Lo más leído en Audio
-
Apps
Hex herramienta gratuita que convierte tu voz en texto
Hex es una herramienta de dictado por voz local para Mac, Windows y Linux. Mantienes presionada una tecla,…
-
Audio
VibeVoice la familia open source de voz con IA que impulsa Microsoft
VibeVoice es la familia de modelos de voz con inteligencia artificial publicada como código abierto por Microsoft en…
Este 23 de octubre se cumplen 25 años de la presentación del iPod original, uno de los productos más importantes de Apple y un impulsor clave de su expansión más allá del Mac. Steve Jobs lo presentó en 2001 con una promesa que se volvió icónica: “1,000 canciones en tu bolsillo”.
Lo más leído en Audio
-
Apps
Hex herramienta gratuita que convierte tu voz en texto
Hex es una herramienta de dictado por voz local para Mac, Windows y Linux. Mantienes presionada una tecla,…
-
Audio
VibeVoice la familia open source de voz con IA que impulsa Microsoft
VibeVoice es la familia de modelos de voz con inteligencia artificial publicada como código abierto por Microsoft en…
SoundCraft es una estación de trabajo de audio digital (DAW) de código abierto escrita en Rust que busca replicar el flujo de trabajo de Avid Pro Tools sin licencias ni suscripciones. Es un proyecto clean-room, es decir, reconstruido desde cero sin copiar código propietario, y forma parte del ecosistema de aplicaciones Crafting del equipo ArtCraft.
Lo más leído en Audio
-
Apps
Hex herramienta gratuita que convierte tu voz en texto
Hex es una herramienta de dictado por voz local para Mac, Windows y Linux. Mantienes presionada una tecla,…
-
Audio
VibeVoice la familia open source de voz con IA que impulsa Microsoft
VibeVoice es la familia de modelos de voz con inteligencia artificial publicada como código abierto por Microsoft en…
Lo más leído
-
 Comunicados de Prensa
Muse, el agente personal de IA de Meta diseñado para hacer las cosas por ti, ya está disponible en México, el primer país de América Latina en tenerlo
-
 Consola
Podcast ONE: 6 de noviembre de 2026
-
3D
Img2threejs reconstruye imágenes en modelos 3D con Three.js puro
-
 Arte y Cultura
Cirque du Soleil ECHO llega oficialmente a Ciudad de México tras el izamiento de su icónica Gran Carpa para el estreno de su más reciente producción
-
 Comunicados de Prensa
Etheria: Restart estrena SS6.4 Eidolon Scourge y anticipa colaboración con Guilty Gear
-

 Apps11 años ago
AMPcast, la herramienta de Pandora que permite a los artistas grabar mensajes de audio directamente a sus seguidores
-
 Blogs5 años ago
Conoce los mejores sitios de Torrents para descargar todo tipo de contenidos
-
Android5 años ago
Aprende cómo usar Discord para ver películas con tus amigos
-
Arte y Cultura14 años ago
Colección de fondos de pantalla basados en Super Héroes
-

 Almacenamiento2 años ago
Cómo usar TeraBox: La guía definitiva para aprovechar 1 TB de almacenamiento en la nube
-
Diseño13 años ago
css3ps: plugin que convierte archivos PSD a CSS3
-
Apps9 años ago
Picturethat, app que usa la Realidad Aumentada para visualizar cómo quedarían los cuadros antes de colgarlos
-
Eventos Especiales14 años ago
Especial Día de la Madres: fondos de pantalla especiales para Mamá