


Curiosidades
¿Por qué un LLM local puede ser mejor que muchas herramientas de corrección con IA?

La corrección asistida por inteligencia artificial sigue siendo útil, pero no siempre en la forma en que hoy la ofrecen muchas plataformas. Cuando un corrector deja de limitarse a detectar erratas, problemas gramaticales o frases poco fluidas y empieza a reformular el tono, condensar ideas o uniformar la redacción, deja de comportarse como un apoyo discreto y empieza a invadir la voz de quien escribe. En ese escenario, un LLM local, bien configurado y con instrucciones restrictivas, puede convertirse en una alternativa más útil para quien busca corregir sin reescribir.
La lógica es simple: en vez de pedirle a la IA que “mejore” un texto, conviene pedirle que apenas lo toque. Cuando se hace bien, el resultado no es una nueva versión con estilo genérico, sino el mismo borrador con errores corregidos, frases incómodas suavizadas y problemas de claridad resueltos. Todo, además, sin enviar el contenido a servidores externos.
¿Qué cambió en la corrección asistida?
Durante años, muchas herramientas de corrección digital cumplieron una función sencilla y útil: señalar faltas, advertir repeticiones y detectar construcciones poco felices. Con la expansión de los asistentes generativos, ese papel se amplió hasta volverse más intrusivo. Hoy, buena parte de las sugerencias ya no corrige: reinterpreta. Reescribe frases completas, altera el registro y empuja el texto hacia una neutralidad que a menudo suena correcta, pero también intercambiable.
Ese cambio puede ser cómodo para quien quiere producir texto más rápido, pero resulta menos atractivo para quien escribe con una voz propia y solo necesita una revisión técnica. En esos casos, el problema no es la corrección asistida, sino el exceso de intervención.
Ahí es donde un modelo local cobra sentido. No sustituye el acto de escribir, sino que recupera una idea más sobria del corrector: una herramienta que ayuda a pulir sin apropiarse del texto.
¿Cómo pedirle a una IA que corrija sin reescribir?
La clave está en reducir al máximo el margen de interpretación del modelo. En vez de pedir una “mejora”, conviene fijar límites precisos: corregir erratas, ajustar gramática, suavizar frases torpes y no tocar nada que ya funcione. Ese enfoque convierte al modelo en un corrector sobrio, no en un coautor.
Una formulación útil en inglés es esta:
- “Please clean this up very, very slightly.”
- “Do not change anything that does not need to be changed. Keep all edits extremely minor and focus only on improving flow, grammar, clarity, or awkward phrasing where necessary.”
- “Do not rewrite sentences just because you think they could sound better. Do not change my tone, voice, structure, or wording unless there is a clear reason to.”
- “I want the final version to remain as close to my original as possible.”
- “Again: keep the changes very minor.”
Para quien trabaja en español, conviene usar una versión equivalente:
- “Corrige este texto de forma muy, muy ligera.”
- “No cambies nada que no necesite cambiarse. Mantén todas las ediciones al mínimo y céntrate solo en mejorar el flujo, la gramática, la claridad o una redacción forzada cuando sea necesario.”
- “No reescribas oraciones solo porque creas que podrían sonar mejor. No cambies el tono, la voz, la estructura ni la elección de palabras salvo que haya una razón clara para hacerlo.”
- “Quiero que la versión final se mantenga lo más cercana posible al original.”
- “De nuevo: haz cambios mínimos.”
Hay un ajuste práctico que mejora todavía más este flujo. En lugar de pedir solo el texto corregido, conviene añadir una instrucción final como esta: “Devuélveme primero la versión corregida y después una lista breve de los cambios realizados.” Así se conserva visibilidad editorial y se evita aceptar modificaciones invisibles o discutibles.
¿Qué configuración conviene usar?
Para este uso, la configuración importa tanto como el modelo. Lo recomendable es usar una temperatura baja, idealmente entre 0.1 y 0.3, para reducir adornos y evitar que el sistema “embellezca” el texto por iniciativa propia. También conviene desactivar, cuando sea posible, modos de razonamiento extensivo o respuestas con explicaciones largas, porque suelen empeorar una tarea que exige contención.
En otras palabras: para corregir un párrafo no hace falta una IA brillante; hace falta una IA obediente.
¿Qué modelo local usar según tu equipo?
La corrección ligera no exige un modelo gigante. Lo que necesita es comprensión suficiente, seguimiento fiel de instrucciones y un comportamiento estable. Por eso los modelos pequeños y medianos suelen ser más que adecuados si están bien cuantizados y el prompt está bien planteado.
| Perfil de equipo | Modelos adecuados | Notas para corrección |
|---|---|---|
| Celular, mini PC o laptop con 8 GB de RAM | Gemma 4 E2B, Gemma 4 E4B, Qwen3.5 0.8B, Qwen3.5 2B, TinyLlama 1.1B | Suficientes para ortografía, gramática y ajustes menores de fluidez; son la opción más razonable cuando la prioridad es privacidad y ligereza |
| GPU de entrada con 4 GB de VRAM | Qwen3.5 2B, Qwen3.5 4B, Gemma 4 E2B o E4B cuantizado | Funcionan mejor con textos breves o medianos y cuantizaciones conservadoras; siguen siendo preferibles a modelos más ambiciosos para esta tarea específica |
| GPU media o alta con 8 a 12 GB de VRAM | Llama 3.1 8B, Qwen3.5 9B, Gemma 4 12B cuantizado, DeepSeek-R1-Distill-Qwen-7B | Ofrecen más margen para documentos largos, aunque los modelos centrados en razonamiento conviene usarlos con cautela para evitar sobreedición |
La regla práctica sigue siendo sencilla: para esta tarea, el mejor modelo no siempre es el más grande, sino el que menos ganas tiene de reescribir. Por eso una opción pequeña y disciplinada suele rendir mejor que una muy capaz, pero demasiado intervencionista.
La instalación básica puede hacerse con Ollama. Comandos como ollama pull gemma4, ollama pull qwen3.5:0.8b o ollama pull llama3.1:8b bastan para empezar, según el equipo disponible. Si la máquina es modesta, también conviene elegir cuantizaciones ligeras y evitar contextos innecesariamente largos.
¿Por qué Gemma 4 destaca en este caso?
Gemma 4 resulta especialmente atractivo porque combina variantes ligeras con buen seguimiento de instrucciones y un diseño orientado al uso local. La familia fue presentada por Google en abril de 2026 y sus variantes pequeñas, como E2B y E4B, están pensadas para ejecutarse en hardware contenido. Además, las versiones compactas ofrecen hasta 128K de contexto, mientras que los modelos superiores llegan a 256K, algo útil cuando se revisan borradores extensos.
Eso no significa que Gemma 4 sea el único candidato válido, pero sí uno de los más equilibrados para quien quiere un corrector privado, rápido y razonablemente preciso. En corrección ligera, esa mezcla de eficiencia y obediencia vale más que una inteligencia espectacular.
¿Por qué un modelo local y no un corrector en la nube?
| Aspecto | Herramientas de corrección con IA | LLM local con prompt restrictivo |
|---|---|---|
| Tipo de cambios | Suelen reformular, ajustar tono y sugerir reescrituras con demasiada frecuencia | Puede limitarse a erratas, gramática, claridad y frases torpes si recibe instrucciones precisas |
| Voz del autor | Tienden a homogeneizar el estilo | Preserva mejor la redacción original |
| Privacidad del texto | Normalmente implican procesamiento externo | Permite que el borrador permanezca en el dispositivo |
| Requisitos | Cuenta, navegador, extensión o servicio activo | Modelo local, memoria suficiente y una configuración mínima |
La nube sigue siendo más cómoda para mucha gente, y eso no va a cambiar pronto. Pero la comodidad no siempre es el criterio principal. Quien trabaja con borradores sensibles, textos inéditos, material de clientes o documentos internos tiene buenas razones para no pegar ese contenido en un servicio remoto, incluso si solo necesita una revisión menor.
Ahí es donde el modelo local gana por acumulación de ventajas: privacidad, control, coste marginal prácticamente nulo y una experiencia menos invasiva cuando el objetivo no es escribir más rápido, sino escribir mejor sin perder la propia voz.
¿Qué límites tiene este método?
Conviene no exagerar sus virtudes. Un LLM local no reemplaza una edición de fondo, ni garantiza criterio estilístico, ni corrige con la misma sensibilidad en todos los idiomas. También puede pasar por alto errores, proponer cambios innecesarios o interpretar mal un matiz si el prompt es ambiguo.
Por eso el mejor uso no es delegar el texto, sino revisarlo con una herramienta contenida. El modelo local funciona mejor como segunda lectura técnica que como autoridad editorial. Su fortaleza está en detectar roces, no en decidir el sentido final de una frase.
¿Vale la pena dejar atrás ciertos correctores con IA?
No para todo el mundo, pero sí para un perfil muy claro de usuario. Quien solo necesita una segunda lectura técnica, valora su estilo y no quiere compartir borradores con terceros puede encontrar en un LLM local una alternativa más afinada que muchas herramientas de corrección actuales. No porque el modelo local sea superior en todos los escenarios, sino porque se deja encerrar mejor dentro de una tarea modesta: corregir sin apropiarse del texto.
En el fondo, la promesa no es futurista. Es más bien conservadora. Se trata de recuperar la idea de un corrector que corrige, no de un asistente que reescribe. Y hoy, con un modelo local pequeño, una temperatura baja y un prompt restrictivo en inglés o en español, eso ya es perfectamente viable.
Lo más leído en Curiosidades
-
 Consola
PS5LM convierte tu PS5 en un servidor de modelos de IA local
PS5LM es un proyecto de código abierto que ejecuta llama.cpp directamente en la GPU de una PlayStation 5…
-
 Curiosidades
Tareas personales en el trabajo: la nueva jornada laboral que ya es realidad
Casi 6 de cada 10 profesionales europeos realizan tareas personales durante su jornada laboral varias veces a la…






Casi 6 de cada 10 profesionales europeos realizan tareas personales durante su jornada laboral varias veces a la semana, según una encuesta de LiveCareer a 1.000 trabajadores de Alemania, España, Francia e Italia. El 72% afirma que esos descansos breves lo hacen más productivo, no menos.
Lo más leído en Curiosidades
-
Consola
PS5LM convierte tu PS5 en un servidor de modelos de IA local
PS5LM es un proyecto de código abierto que ejecuta llama.cpp directamente en la GPU de una PlayStation 5…
-
Curiosidades
Tareas personales en el trabajo: la nueva jornada laboral que ya es realidad
Casi 6 de cada 10 profesionales europeos realizan tareas personales durante su jornada laboral varias veces a la…
PS5LM es un proyecto de código abierto que ejecuta llama.cpp directamente en la GPU de una PlayStation 5 con jailbreak, convirtiendo la consola en un servidor privado de modelos de lenguaje para toda la red doméstica. Sin nube, sin cuentas y sin necesidad de una PC encendida: cualquier laptop, teléfono o herramienta de programación puede consultar al modelo cargado en la consola. Te contamos cómo funciona esta peculiar herramienta.
Lo más leído en Curiosidades
-
Consola
PS5LM convierte tu PS5 en un servidor de modelos de IA local
PS5LM es un proyecto de código abierto que ejecuta llama.cpp directamente en la GPU de una PlayStation 5…
-
Curiosidades
Tareas personales en el trabajo: la nueva jornada laboral que ya es realidad
Casi 6 de cada 10 profesionales europeos realizan tareas personales durante su jornada laboral varias veces a la…
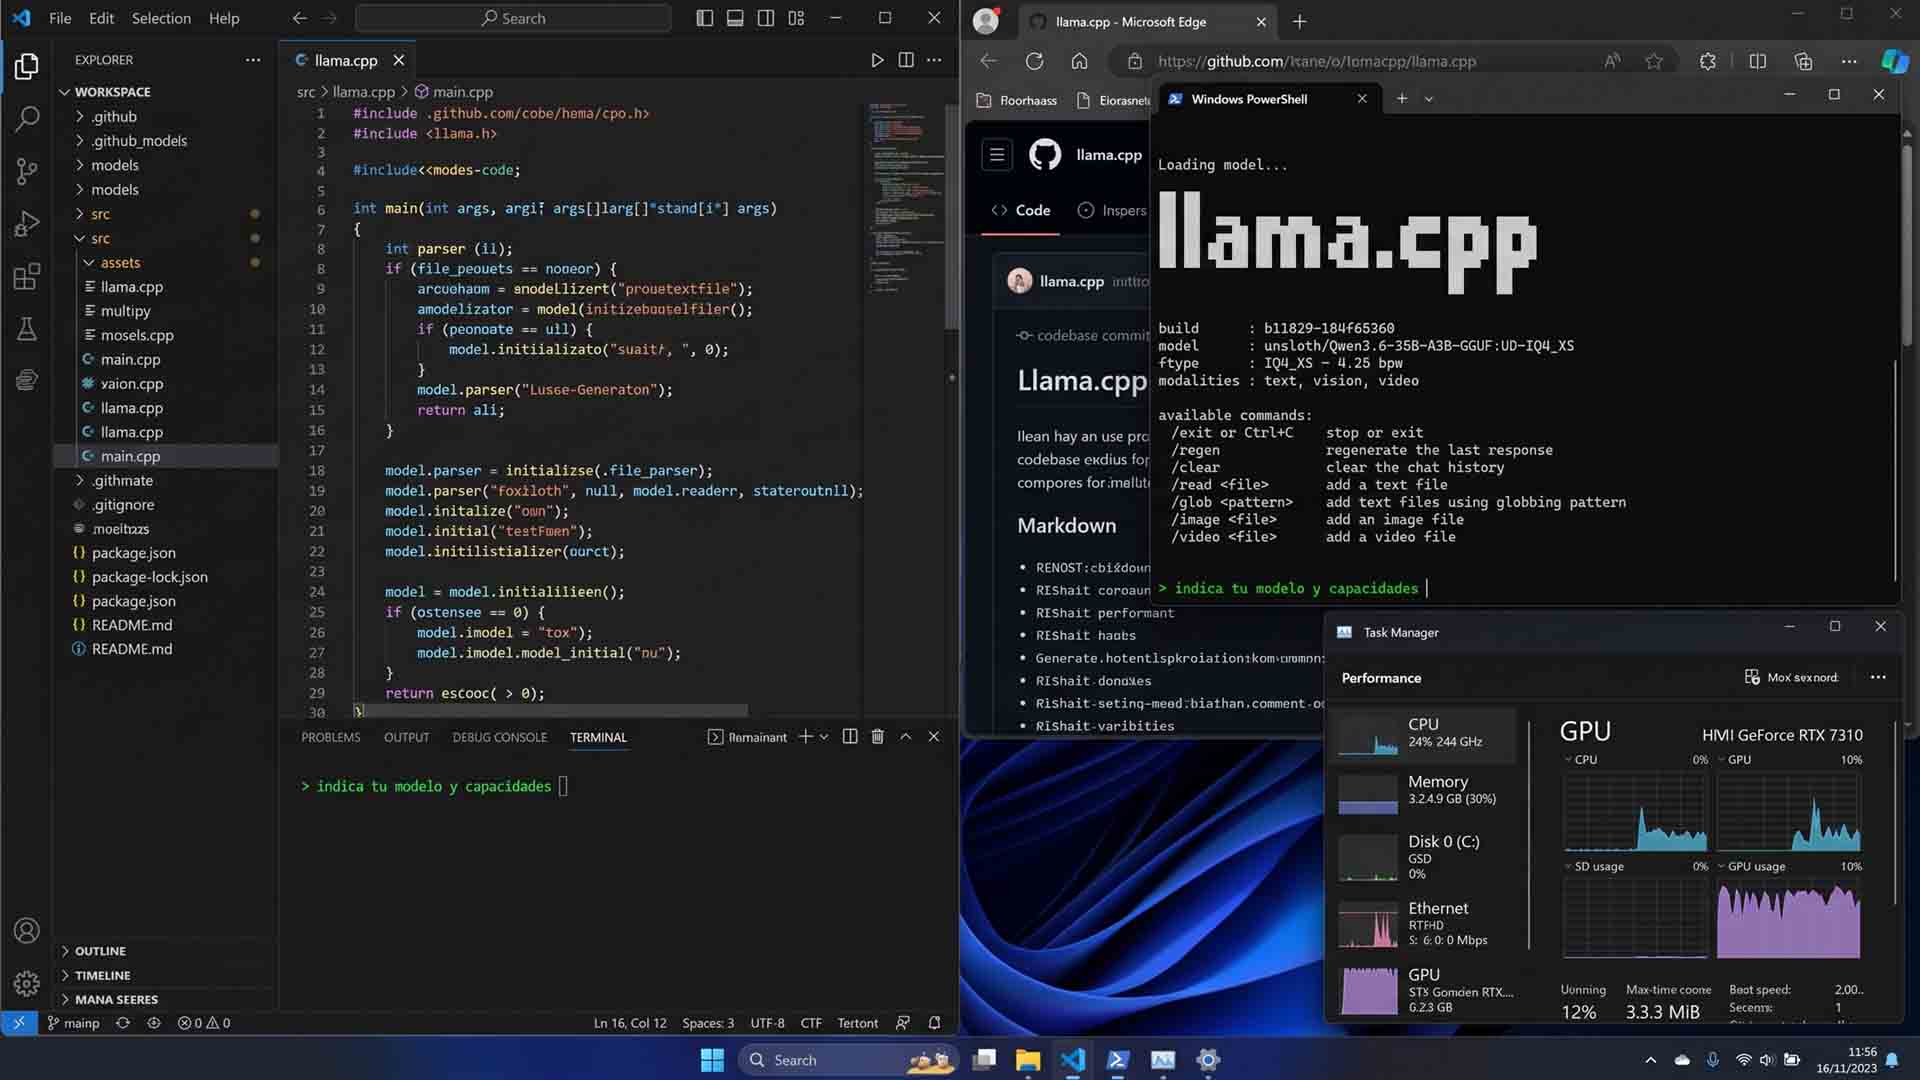
Una prueba documentada muestra cómo el flag –n-cpu-moe de llama.cpp descarga los expertos de un modelo Mixture-of-Experts a la RAM del sistema y multiplica por ocho la velocidad de generación en una GPU de laptop de 8GB. Aquí la guía completa paso a paso para Windows.
Lo más leído en Curiosidades
-
Consola
PS5LM convierte tu PS5 en un servidor de modelos de IA local
PS5LM es un proyecto de código abierto que ejecuta llama.cpp directamente en la GPU de una PlayStation 5…
-
Curiosidades
Tareas personales en el trabajo: la nueva jornada laboral que ya es realidad
Casi 6 de cada 10 profesionales europeos realizan tareas personales durante su jornada laboral varias veces a la…
Lo más leído
-
 Consola
Revisión: Polican: Vuelta a la Carga – Plataformas 2D con diez héroes y mucho humor
-
 Gadgets
ESP32 iPhone Agent: una IA controla tu iPhone con una placa de 7 dólares
-
 Consola
Revisión: The Séance of Blake Manor – Misterio a contrarreloj
-
 Apple
Apple lanza MacBook Pro e iMac con chip M6 y iPad mini con OLED
-
Android
Pokémon GO aclara los detalles de los GO Stamp Rally del Área Silvestre 2026

-

 Apps11 años ago
AMPcast, la herramienta de Pandora que permite a los artistas grabar mensajes de audio directamente a sus seguidores
-
 Blogs5 años ago
Conoce los mejores sitios de Torrents para descargar todo tipo de contenidos
-
Android5 años ago
Aprende cómo usar Discord para ver películas con tus amigos
-
Arte y Cultura14 años ago
Colección de fondos de pantalla basados en Super Héroes
-

 Almacenamiento2 años ago
Cómo usar TeraBox: La guía definitiva para aprovechar 1 TB de almacenamiento en la nube
-
Diseño13 años ago
css3ps: plugin que convierte archivos PSD a CSS3
-
Apps9 años ago
Picturethat, app que usa la Realidad Aumentada para visualizar cómo quedarían los cuadros antes de colgarlos
-
Eventos Especiales13 años ago
Especial Día de la Madres: fondos de pantalla especiales para Mamá