
Curiosidades
La caída global de AWS y cómo un error en DynamoDB afectó servicios en todo el mundo

El 19 de octubre de 2025, un error en Amazon DynamoDB provocó una interrupción masiva en los servicios de Amazon Web Services (AWS), afectando a empresas y usuarios en todo el mundo durante más de ocho horas.
Según el informe técnico oficial de AWS, el incidente comenzó con una en un sistema automatizado que gestionaba los registros DNS de DynamoDB. Este error eliminó accidentalmente el registro DNS principal, haciendo que el servicio perdiera la referencia a su propia base de datos. La de Amazon fue necesaria para restaurar el acceso, pero el impacto ya se había propagado a otros servicios críticos.
El incidente fue cubierto en tiempo real por OneDigital, donde se detalló cómo cientos de servicios globales se vieron afectados.
¿Qué ocurrió exactamente?
El origen del problema
El fallo se originó en el sistema automatizado que gestionaba los registros DNS de DynamoDB. Una condición de competencia, un error poco común en el que dos procesos intentan ejecutar operaciones simultáneas, provocó que el sistema eliminara el registro DNS principal de DynamoDB. Como resultado, el servicio dejó de ser accesible para otros componentes de AWS que dependían de él.
Este error no solo afectó a DynamoDB, sino que también generó una cascada de fallos en otros servicios de AWS, como Amazon Cognito, AWS Lambda y Amazon API Gateway. Según el , la recuperación requirió la intervención manual de los equipos técnicos, lo que prolongó la interrupción.
El efecto dominó en los servicios de AWS
Fallo en el sistema de nombres de dominio
El registro DNS eliminado era esencial para que otros servicios de AWS pudieran localizar y comunicarse con DynamoDB. Sin este registro, los servicios que dependían de DynamoDB para almacenar configuraciones, metadatos o estados de sesión quedaron inaccesibles.
Servicios críticos afectados
La caída de DynamoDB impactó directamente en varios servicios clave de AWS:
- Amazon Cognito: Servicio de autenticación y gestión de usuarios.
- AWS Lambda: Plataforma de computación sin servidor.
- Amazon API Gateway: Servicio para crear y gestionar APIs.
- Amazon Connect: Centro de contacto en la nube.
Impacto en aplicaciones y sitios web
La interrupción se propagó rápidamente a aplicaciones y sitios web de terceros que dependían de AWS, incluyendo plataformas de transmisión en directo, servicios financieros, aplicaciones de productividad y sistemas de logística. Según informes de Ookla, más de en todo el mundo se registraron durante el incidente.
¿Por qué fue difícil resolver el problema?
Complejidad del sistema automatizado
El sistema de gestión de DNS de DynamoDB está diseñado para ser altamente automatizado y resistente a fallos. Sin embargo, la condición de competencia que ocurrió no estaba contemplada en los protocolos de recuperación automática, lo que obligó a los ingenieros de Amazon a intervenir manualmente.
Dependencia global de DynamoDB
DynamoDB es un servicio crítico que soporta miles de aplicaciones en la nube. Su caída no solo afectó a AWS internamente, sino que también impactó a clientes en todo el mundo, desde nuevas empresas hasta grandes corporaciones.
Fallas en la redundancia
A pesar de las múltiples capas de redundancia de AWS, el error en el sistema de DNS no fue mitigado por los , lo que expuso una vulnerabilidad crítica en la arquitectura de AWS.
Lecciones aprendidas y medidas correctivas
Refuerzo de protocolos de redundancia
Amazon anunció que está reforzando los protocolos de redundancia para los , asegurando que el sistema pueda recuperarse automáticamente incluso en casos de condiciones de competencia.
Mejoras en la detección de errores
Se implementarán nuevos mecanismos para detectar y mitigar condiciones de competencia en tiempo real, evitando que errores similares escalen a nivel global.
Comunicación transparente
AWS se comprometió a mejorar la comunicación durante incidentes, proporcionando actualizaciones más frecuentes y detalladas a los clientes afectados.
¿Cómo verificar si mis servicios se vieron afectados?
Revisión de registros en AWS CloudTrail
a las APIs de AWS. Para verificar si hubo errores durante el incidente:
- Abre la consola de AWS CloudTrail.
- Filtra los eventos por fecha (19 y 20 de octubre de 2025).
- Busca errores relacionados con DynamoDB, Cognito, Lambda o API Gateway.
- Presta atención a códigos de error como ResourceNotFoundException o ThrottlingException.
Uso de
El Personal Health Dashboard de AWS muestra alertas personalizadas sobre incidentes que afectan directamente a tus recursos. Revisa si hay notificaciones para regiones específicas o servicios críticos.
Análisis de métricas en CloudWatch
CloudWatch proporciona métricas en tiempo real. Revisa:
- Latencia aumentada en llamadas a DynamoDB.
- Errores 5XX en tus APIs o aplicaciones.
- Caídas en el tráfico durante el período del incidente.
Herramientas de terceros
Plataformas como Statuspage o Downdetector pueden confirmar si otros usuarios reportaron fallos en los mismos servicios que utilizas.
Acciones inmediatas durante una caída de AWS
Activación del plan de contingencia
- Conmutación por error: Redirige el tráfico a otra región de AWS o a un proveedor alternativo.
- Modo degradado: Desactiva funcionalidades no críticas para mantener operativas las esenciales.
Comunicación del incidente
- Notifica a tus usuarios mediante mensajes en la aplicación, redes sociales y correo electrónico.
- Utiliza un status page público para mantener informados a los usuarios.
Monitoreo del estado de AWS
Consulta el AWS Health Dashboard para obtener actualizaciones oficiales. Suscríbete a las notificaciones por RSS o correo electrónico.
Priorización de la recuperación
- Restaura servicios críticos primero.
- Usa snapshots recientes para recuperar bases de datos o instancias afectadas.
Alternativas a DynamoDB para evitar dependencia única
| Alternativa | Proveedor | Ventajas | Casos de uso recomendados |
|---|---|---|---|
| Firestore | Google Cloud | Escalabilidad automática, integración con Firebase. | Aplicaciones móviles, juegos, internet de las cosas. |
| Cosmos DB | Microsoft Azure | Baja latencia global, soporte para múltiples modelos de datos. | Aplicaciones empresariales, comercio electrónico. |
| MongoDB Atlas | Multi-nube | Flexibilidad de esquema, alta disponibilidad. | Aplicaciones modernas, análisis de datos. |
| Cassandra | Auto-gestionado o Astra DB | Alta disponibilidad, tolerancia a fallos. | Big data, series temporales, mensajería. |
Recomendación: Implementa una para servicios críticos. Por ejemplo, usa DynamoDB como principal y Firestore como respaldo.
Cómo configurar alertas proactivas en AWS
Alertas en CloudWatch
- Ve a CloudWatch > Alarmas > Crear alarma.
- Selecciona métricas clave como SuccessfulRequestLatency o SystemErrors en DynamoDB.
- Define umbrales y configura notificaciones por SMS, correo electrónico o Slack.
Uso de AWS Chatbot
directamente a tus canales de comunicación como Slack o Microsoft Teams. Configura un canal para recibir alertas de CloudWatch.
Automatización con AWS Step Functions
Crea flujos de trabajo automatizados para reiniciar instancias fallidas, escalar recursos bajo demanda o ejecutar scripts de recuperación.
Ejemplo de plan de contingencia para caídas de AWS
Identificación de servicios críticos
- Lista los servicios de AWS que son esenciales.
- Priorízalos según su impacto en el negocio.
Protocolos de conmutación por error
| Servicio | Acción de conmutación por error | Responsable |
|---|---|---|
| DynamoDB (us-east-1) | Conmutar a una réplica en us-west-2 o a Firestore. | Equipo de DevOps |
| API Gateway | Redirigir tráfico a un endpoint en Azure API Management. | Equipo de backend |
| Lambda | Ejecutar funciones en Google Cloud Functions. | Equipo de desarrollo |
Canales de comunicación
- Interno: Slack, correo electrónico.
- Externo: Status page, redes sociales, correo a clientes.
Pruebas del plan
Realiza para validar que el plan funciona. Usa herramientas como controlados.





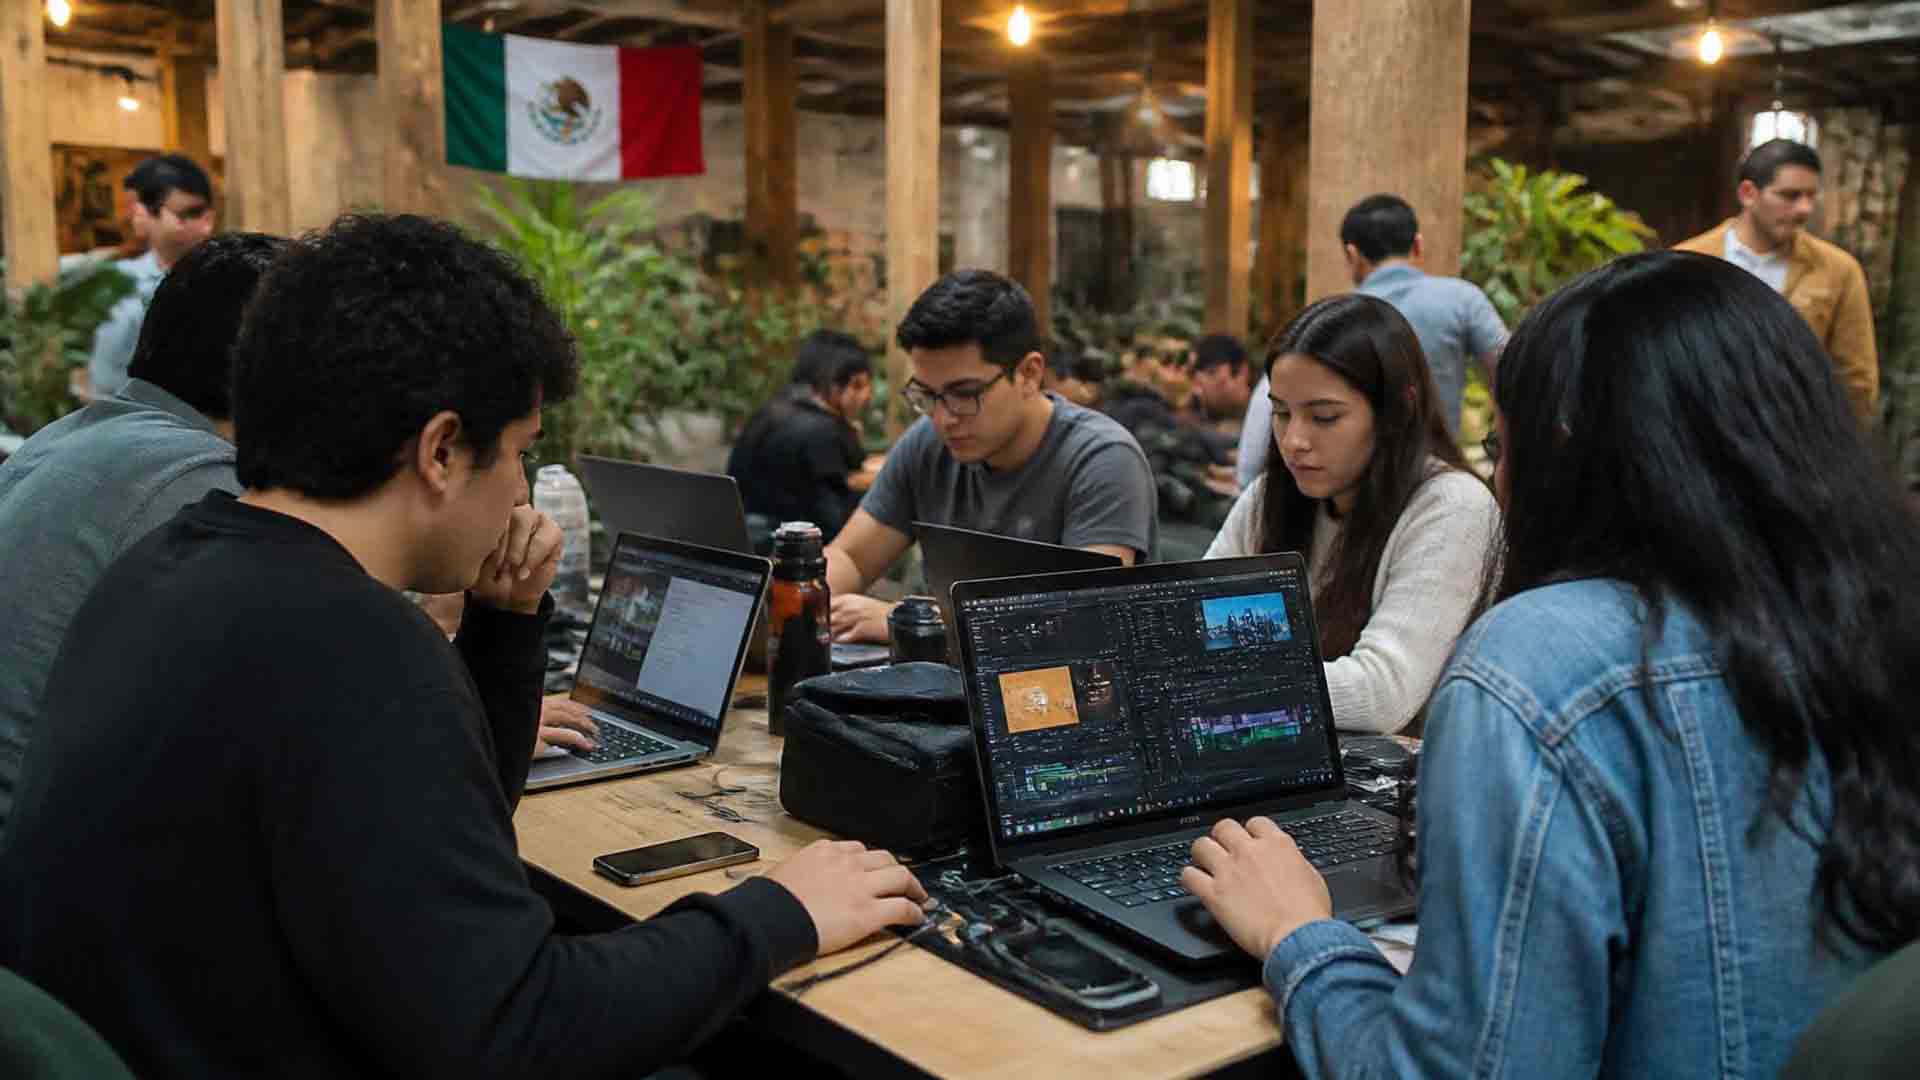
CapCut participará en México Tech Week 2026 con el CapCut Design Studio: Speed-to-Scale Hackathon, una activación gratuita para crear en cuatro horas una pieza lista para mostrar usando herramientas de IA. El cupo es de 30 lugares con registro previo.
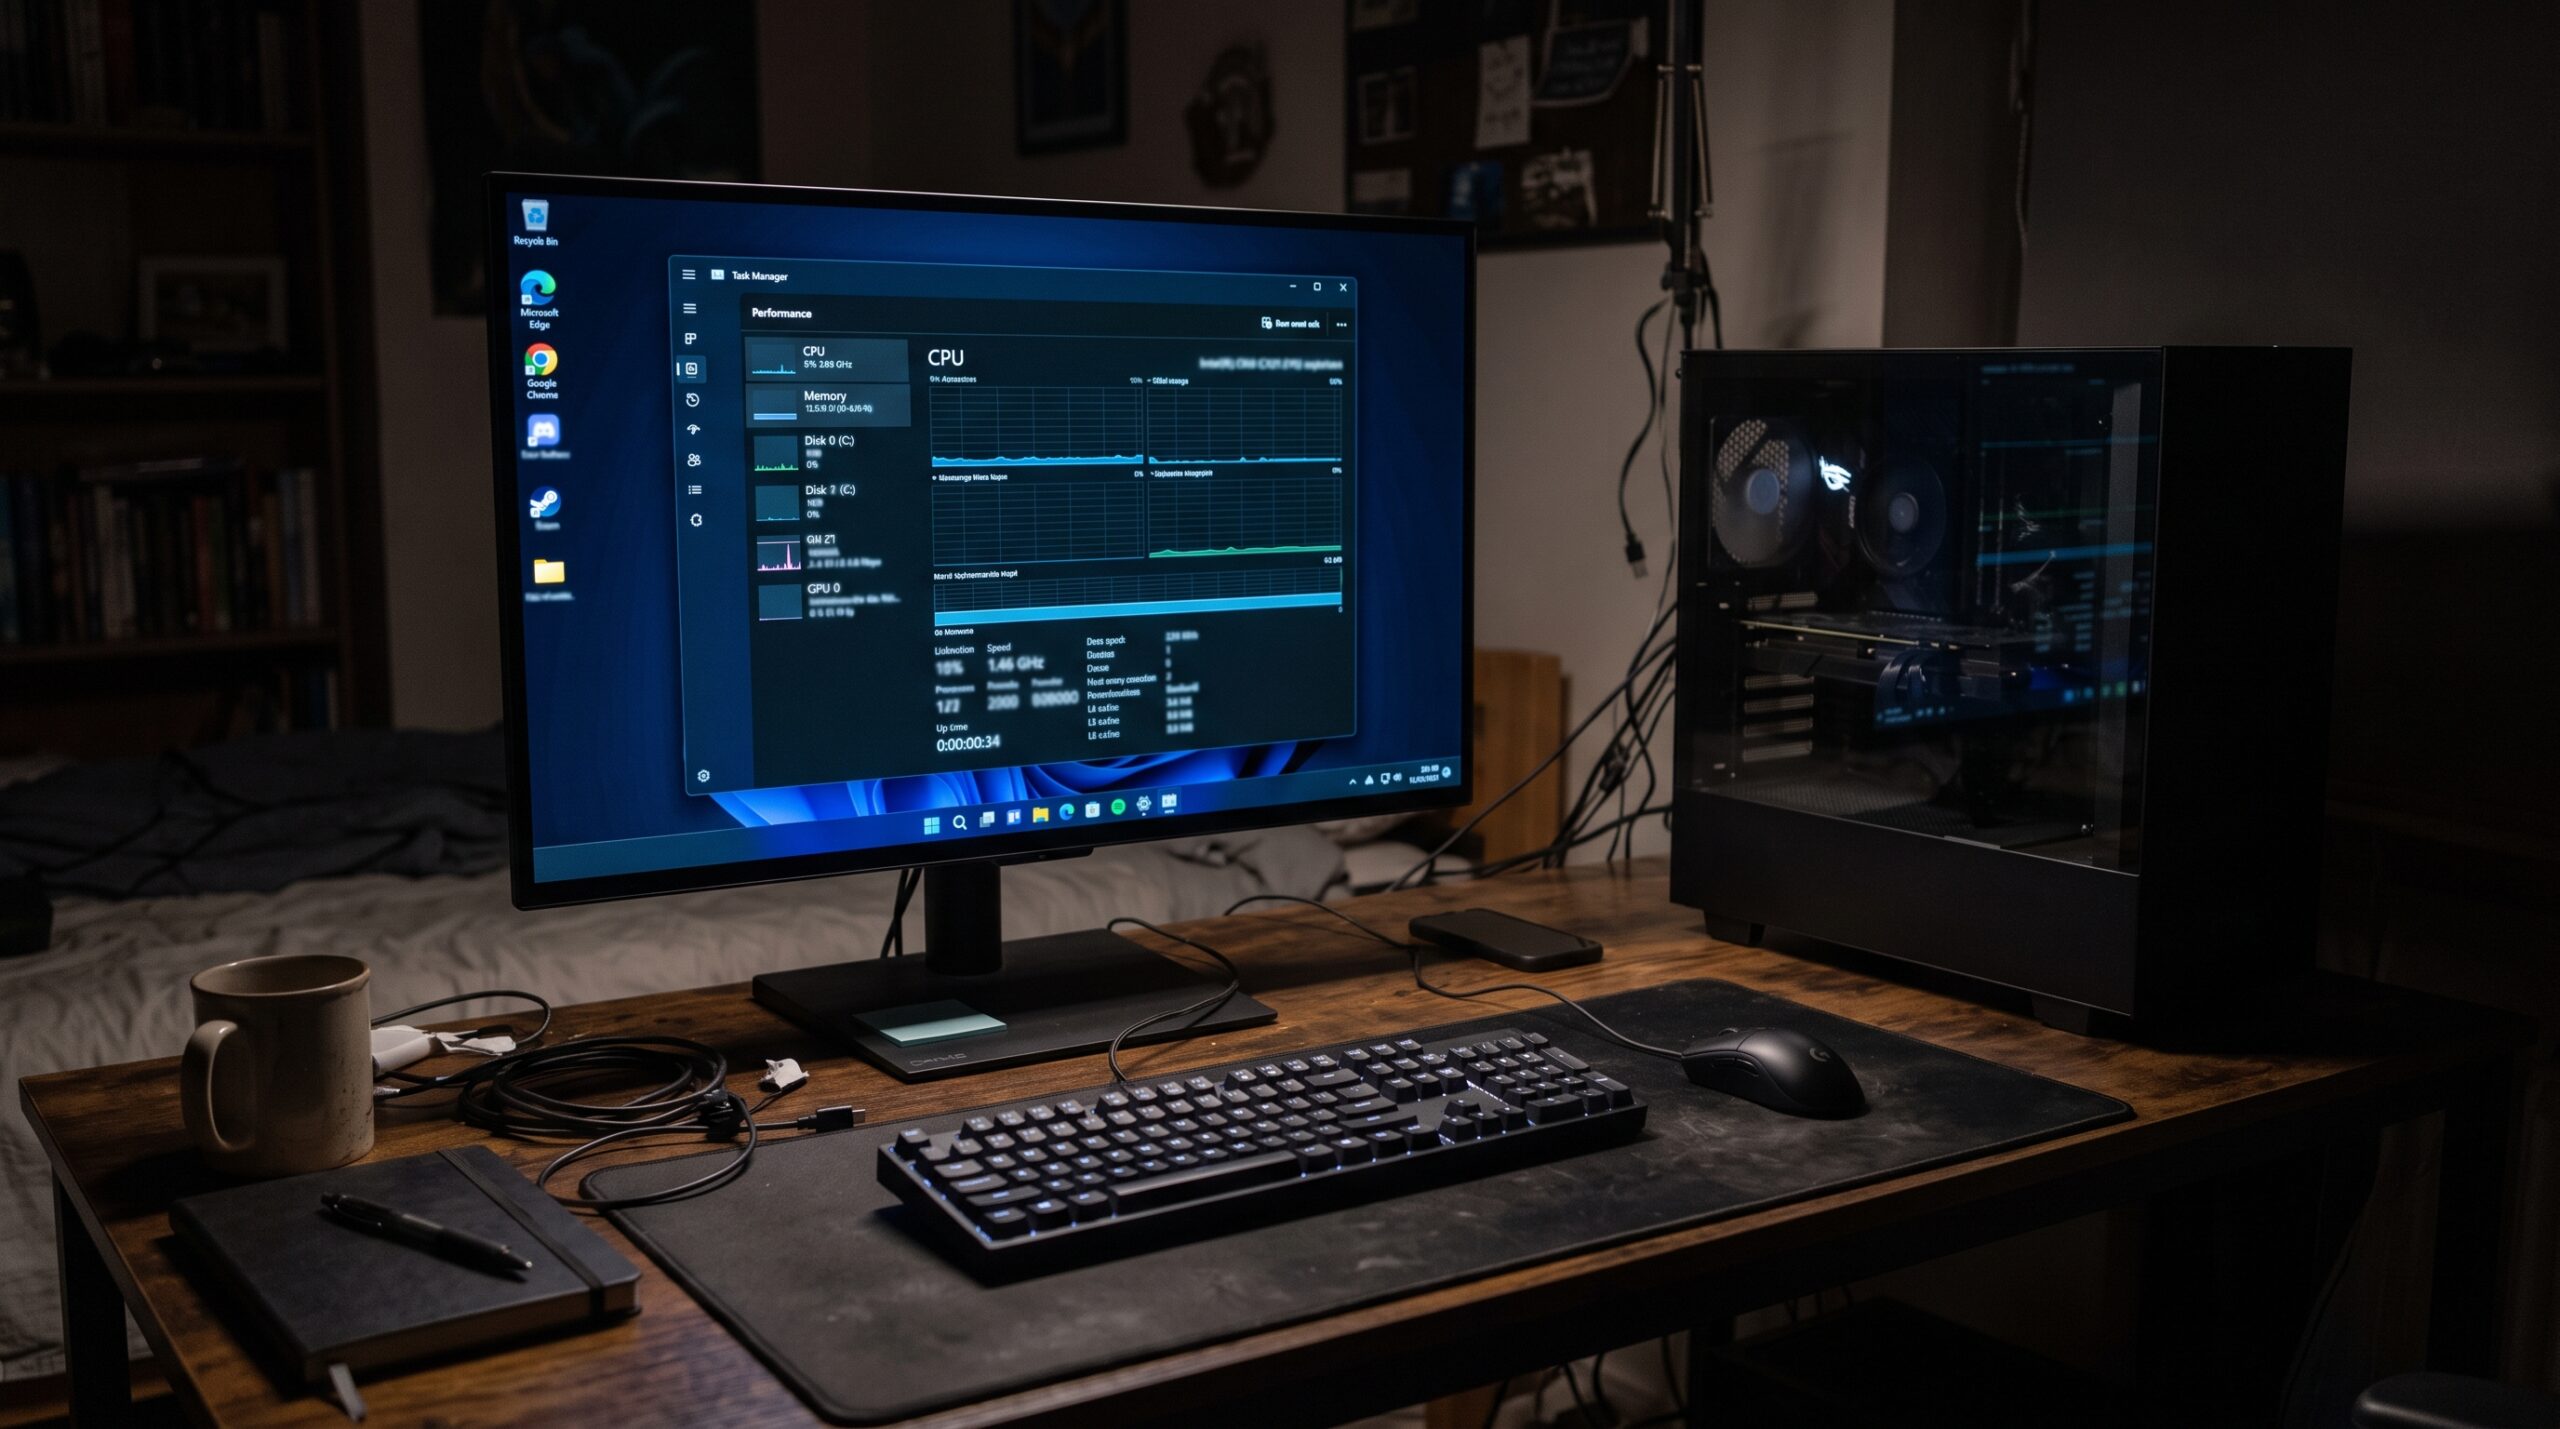
El usuario @soyaakinohara6 compartió en X una instalación de Windows 11 que consume apenas 2.5GB de 16GB de RAM en reposo, un 16 por ciento de utilización. El método: instalar con Rufus, eliminar todo el bloatware y luego aplicar la actualización 26H2.
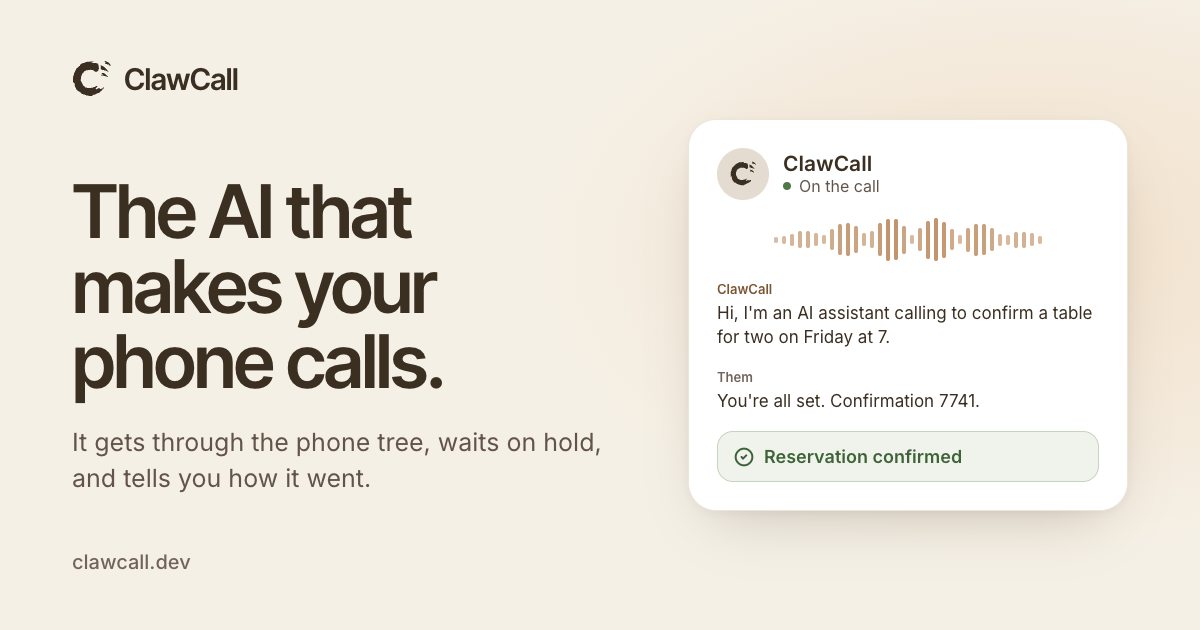
ClawCall es una inteligencia artificial que marca números de Estados Unidos, atraviesa los menús telefónicos, espera en la fila de retención y conversa con quien atienda. Al final reporta el resultado y la transcripción capturada. Funciona desde ChatGPT, Claude, iMessage y una API REST, con las primeras 30 llamadas gratis.
-

 Apps11 años ago
AMPcast, la herramienta de Pandora que permite a los artistas grabar mensajes de audio directamente a sus seguidores
-
 Blogs5 años ago
Conoce los mejores sitios de Torrents para descargar todo tipo de contenidos
-
Android5 años ago
Aprende cómo usar Discord para ver películas con tus amigos
-
Arte y Cultura14 años ago
Colección de fondos de pantalla basados en Super Héroes
-

 Almacenamiento2 años ago
Cómo usar TeraBox: La guía definitiva para aprovechar 1 TB de almacenamiento en la nube
-
Diseño13 años ago
css3ps: plugin que convierte archivos PSD a CSS3
-
Apps9 años ago
Picturethat, app que usa la Realidad Aumentada para visualizar cómo quedarían los cuadros antes de colgarlos
-
Eventos Especiales13 años ago
Especial Día de la Madres: fondos de pantalla especiales para Mamá