

Herramientas
Clairic: el modelo de extracción de Cloudflare que no genera texto

Cloudflare presentó Clairic, el primer modelo de extracción de la clase System One, disponible como vista previa en Workers AI. Extrae, calcula, estima y pronostica valores desde datos no estructurados con una sola pasada de cómputo, sin generar tokens de salida. La compañía promete liberar sus pesos abiertos próximamente.
¿Qué es Clairic y por qué no es un LLM?
Clairic responde con valores concretos, no con texto. A diferencia de los modelos de lenguaje como GPT, Claude o Gemini, que escriben token por token, Clairic procesa la entrada en una única pasada paralela y devuelve datos con tipo: números, fechas, textos exactos, listas y distribuciones de probabilidad. El anuncio está firmado por Alex Reneau, Michelle Chen y Kevin Flansburg en el blog de ingeniería de Cloudflare.
La inspiración llega de Pensar rápido, pensar despacio de Daniel Kahneman, popularizado por TypeSafe con su modelo Jev: sistemas rápidos y precisos frente a los modelos deliberativos de System Two. Cloudflare detectó que hoy llegan miles de llamadas a LLMs de frontera con salidas estructuradas que repiten los mismos patrones: ¿cuál es el total de la factura?, ¿cuándo se entregó?, ¿cuánto costará la reparación? Preguntas que no necesitan razonamiento, solo lectura precisa.
Este movimiento se suma a la estrategia más amplia de la compañía por definir la Internet agéntica de Cloudflare, donde humanos y agentes de IA colaboran bajo reglas claras.
¿Cómo encaja entre los modelos System One y System Two?
Hasta ahora, todo modelo System One era un modelo de decisión: Jev y Clef reciben un estado y una lista de preguntas, y devuelven probabilidades. Clairic abre una clase nueva: los modelos de extracción, que responden con valores extraídos del texto, calculados a partir de él o pronosticados más allá de él.
| System One: extraer | System One: decidir | System Two | |
|---|---|---|---|
| Modelos de ejemplo | Clairic | Jev, Clef | GPT, Claude, Gemini, DeepSeek |
| Muestreo | Una pasada paralela | Una pasada paralela | Un token a la vez |
| Propósito | Predecir valores | Tomar decisiones | Escribir y razonar |
| Salida | Valores tipados con probabilidades calibradas | Decisiones tipadas con probabilidades | Cadenas de texto libre |
| ¿Respuesta siempre válida? | Sí: valor de su tipo o null | Sí: siempre una de tus opciones | No: hay que validar el texto |

Al no generar tokens, Clairic no puede escribir mal un dato ni alucinar en el sentido habitual de un LLM. La salida es un valor del tipo solicitado, o null cuando no encuentra respuesta en la entrada, siempre acompañado de un puntaje de confianza.
¿Cómo funciona una petición?
El modelo recibe un state (el texto a leer más hasta cuatro imágenes opcionales) y un mapa de campos con tipo. Cada campo admite instrucciones en lenguaje natural y devuelve una respuesta tipada. Los tipos disponibles incluyen texto, número, fecha, hora, duración, lista, estimación y pronóstico. No hay límite de campos: si no caben en una pasada, el servidor las divide en pasadas paralelas y fusiona las respuestas. Y como no hay tokens de salida, no se cobra por ellos.
Extraer valores sin alucinar
La extracción es probablemente el trabajo más común que hoy se delega a LLMs, y también uno de los más frágiles. El JSON puede salir mal formado, un dígito puede malinterpretarse y no hay forma de rastrear de dónde salió cada dato. Clairic, en cambio, entrega valores anclados al texto original con desfases de caracteres que permiten citar la posición exacta de cada dato en la fuente.
En el ejemplo publicado, un correo de queja por un producto dañado se convierte en valores tipados: número de orden, fecha de entrega, monto pagado, días transcurridos y lista de daños. Dos detalles resultan particularmente interesantes. El monto pagado no aparece escrito en ningún lado: el modelo sumó precio e impuesto en la misma pasada. Y cuando se le pidió un número de rastreo inexistente, devolvió null en lugar de inventar una respuesta plausible, exactamente el punto donde un LLM suele fallar.
Clairic también procesa imágenes
Cloudflare mostró una fotografía real de un recibo con texto imperfecto y ángulo complicado, y Clairic extrajo número de orden, fecha, cantidades y precios, identificando además que no había descuento.

¿Qué ventaja tienen las estimaciones y pronósticos?
Donde un LLM devuelve un número sin decir qué tan seguro está, Clairic responde con una distribución completa: mediana, intervalo del 80% y percentiles a demanda. La anchura del intervalo refleja la confianza del modelo, información útil para decidir qué se automatiza y qué pasa a revisión humana. En un ejemplo con ventas comparables de viviendas, el modelo devolvió una estimación de 418,000 dólares con un rango acotado entre 370,000 y 470,000.
En los pronósticos, Cloudflare puso a prueba el modelo contra datos públicos de la TSA, el número diario de personas revisadas en aeropuertos de Estados Unidos. Durante 21 días consecutivos, el error promedio fue de 3.3% y 17 de los 21 valores reales cayeron dentro del intervalo del 80%. El modelo capturó el ritmo semanal por sí solo, aunque falló en el fin de semana del Día de la Raza: pronostica patrones de la serie, no eventos que la serie no muestra.

La cascada que ahorra tiempo y dinero
La propuesta de Cloudflare es combinar clases de modelos: Clairic convierte datos crudos en valores tipados, el modelo de decisión Clef convierte valores en decisiones y el LLM convierte decisiones en palabras. Cada paso recibe una entrada más limpia que el anterior, y el LLM nunca ve el correo original, lo que también reduce la superficie de ataque ante inyección de instrucciones. Cloudflare construyó una demo en vivo para probar el flujo completo.
Vale la pena señalar los números del ejercicio: la cascada Clairic → Clef → GLM-5.3 terminó la tarea en 19.3 segundos contra 61.7 segundos de la versión todo-LLM, un 69% menos de tiempo. El costo bajó de 11,740 a 6,032 dólares por millón de reclamaciones, un 49% menos. Y la estimación de reparación fue idéntica en cada corrida, mientras el LLM cambió de respuesta en cada intento. Bajo la versión todo-LLM, Gemma 4 y Qwen fallaron en la tarea al no poder deducir valores como el costo de reparación.

Para los equipos que ya despliegan inteligencia artificial en producción, este tipo de arquitecturas complementa las opciones recogidas en la guía de herramientas de IA por categorías, donde la especialización ya marcaba la tendencia frente a los asistentes generalistas.
Limitaciones que conviene conocer
Cloudflare es honesta con las fronteras actuales del modelo. La lectura es sólida, pero la aritmética de más de dos pasos aún falla: para cadenas largas de cálculo, recomienda dejar que el modelo prediga valores y que el código haga las matemáticas. Las estimaciones necesitan evidencia en la entrada, la calibración de los intervalos no está garantizada en datos desconocidos y el pronóstico es básico, sin pretender sustituir modelos de series de tiempo entrenados a medida. La recomendación oficial es usar los puntajes de confianza para decidir qué automatizar y qué enviar a revisión.
Disponibilidad en Workers AI
Clairic está disponible como vista previa en Workers AI bajo el identificador @cf/cloudflare/clairic, invocable desde un Worker con env.AI.run() o desde la API REST. Es un checkpoint temprano que la compañía seguirá mejorando antes de liberar los pesos abiertos. El anuncio completo, con todos los ejemplos de código y las comparativas de latencia y costo, está en el blog oficial de Cloudflare.
La integración llega además en un momento en que la infraestructura de IA de la compañía crece, como ya ocurrió con la adquisición de Replicate por Cloudflare, que puso decenas de miles de modelos a un solo comando de distancia para los desarrolladores.
Una curiosidad de cierre: el nombre Clairic combina la raíz clair (clarividencia, por su capacidad de estimar), el trabajo clerical que automatiza y la idea de ser el modelo de AI Regression de Cloudflare. Nombres con oficio, vaya.
Meta descripcion: Explicamos Clairic, el primer modelo de extracción System One de Cloudflare: qué es, cómo extrae valores sin generar texto, sus estimaciones y pronósticos, y sus límites actuales.
Palabras clave:
Lo más leído en Herramientas





Podcast ONE: 23 de octubre de 2026
Lo más leído en Herramientas
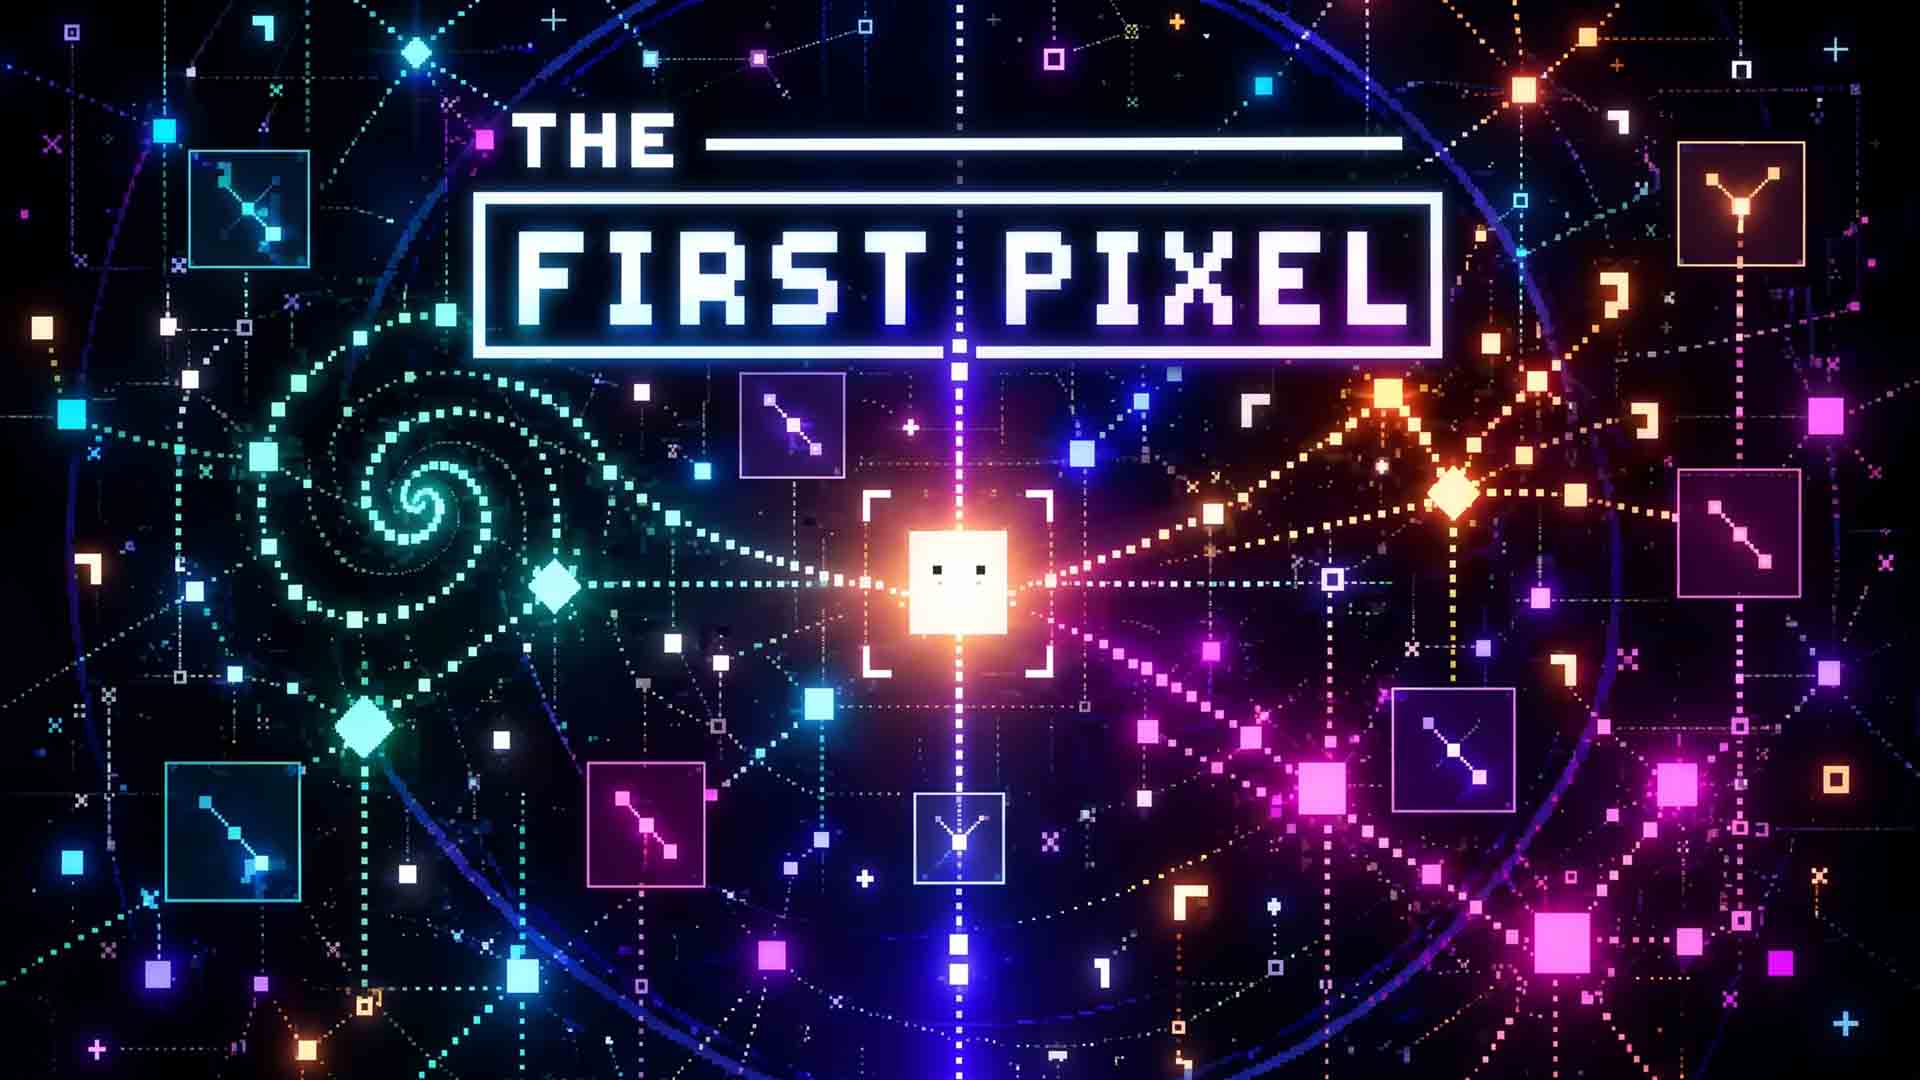
The First Pixel arranca con un espacio en blanco, un único píxel y una sola decisión: hacer clic. Esta demo gratuita para PC propone un incremental misterioso donde la observación pesa tanto como los números, con señales, patrones, memoria y cien reliquias perdidas como hilo conductor.
Lo más leído en Herramientas
Comunicados de Prensa
NVIDIA amplía RTX Spark con nuevas herramientas y modelos de IA local en GTC Berlín
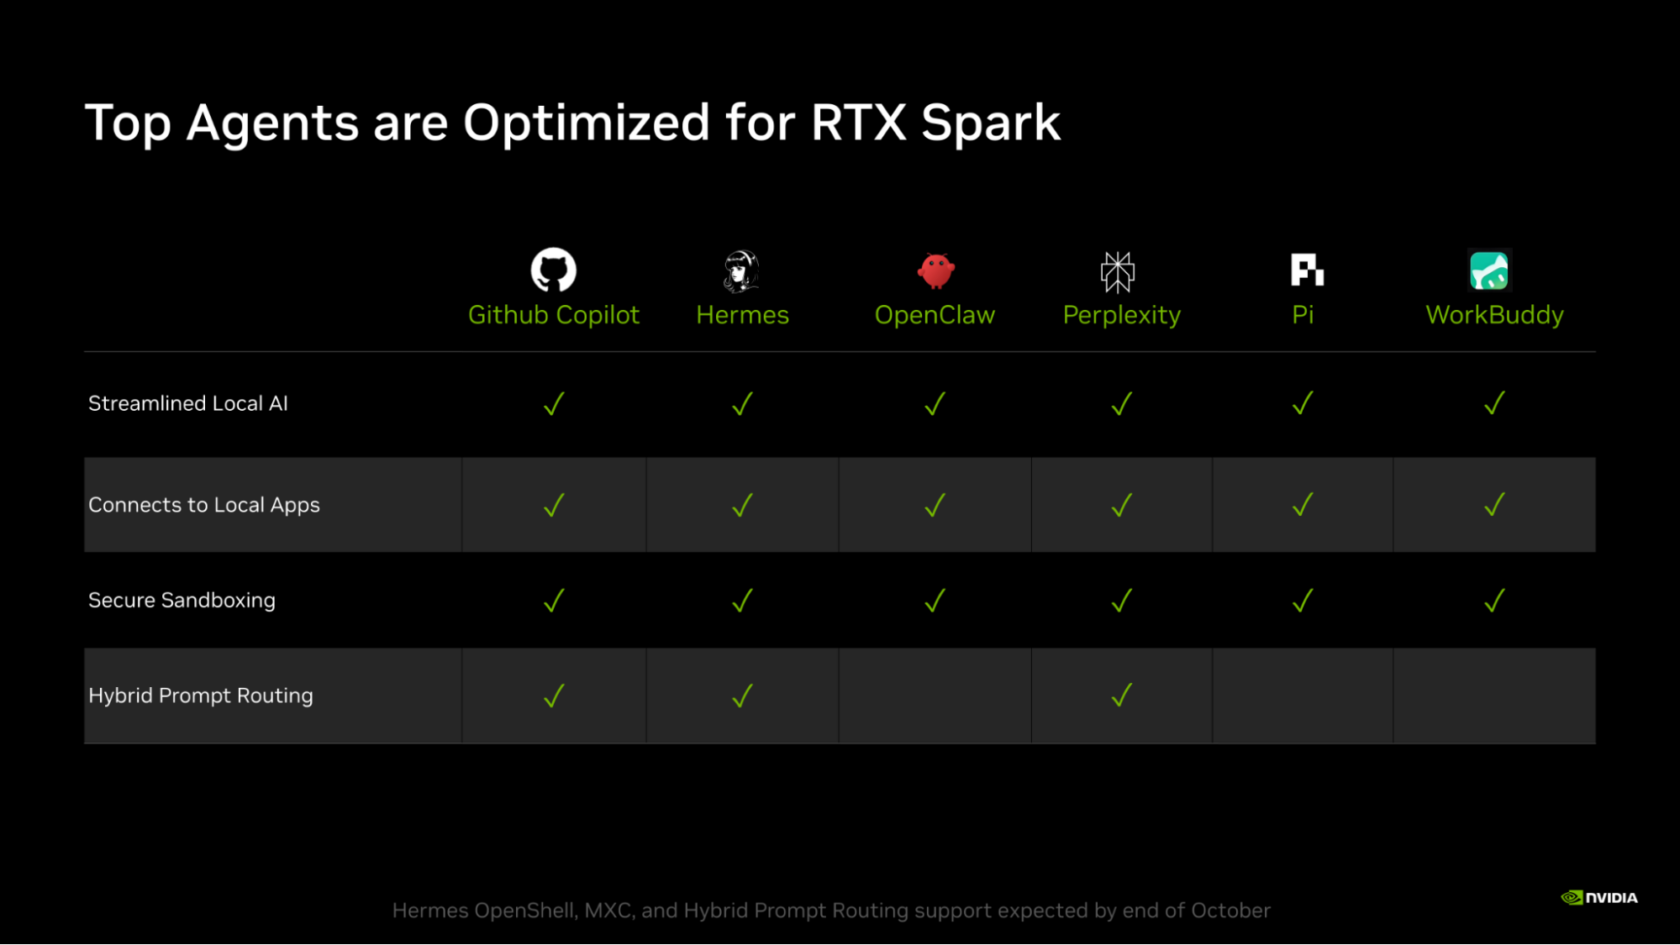
NVIDIA anunció en GTC Berlín nuevas herramientas, modelos de IA y optimizaciones para RTX Spark, la plataforma que ejecuta agentes de IA personales en PC con Windows. El anuncio incluye la aplicación Underdog Desktop Agent, el modelo de programación Recursive Flint y compatibilidad desde el primer día con Nemotron, GLM, DeepSeek, Qwen, MiniMax y FLUX.3.
Lo más leído en Herramientas
Lo más leído
-
 Consola
Juega gratis en el navegador más de 240 títulos sin instalar nada
-
 Entretenimiento
Primeras impresiones: The First Pixel Demo – Un píxel que despierta
-
 Consola
Revisión: Call of Duty: Modern Warfare 4 – Edición Bóveda
-
 Consola
Podcast ONE: 23 de octubre de 2026
-
Herramientas
Clairic: el modelo de extracción de Cloudflare que no genera texto
-

 Apps11 años ago
AMPcast, la herramienta de Pandora que permite a los artistas grabar mensajes de audio directamente a sus seguidores
-
 Blogs5 años ago
Conoce los mejores sitios de Torrents para descargar todo tipo de contenidos
-
Android5 años ago
Aprende cómo usar Discord para ver películas con tus amigos
-
Arte y Cultura14 años ago
Colección de fondos de pantalla basados en Super Héroes
-

 Almacenamiento2 años ago
Cómo usar TeraBox: La guía definitiva para aprovechar 1 TB de almacenamiento en la nube
-
Diseño13 años ago
css3ps: plugin que convierte archivos PSD a CSS3
-
Apps9 años ago
Picturethat, app que usa la Realidad Aumentada para visualizar cómo quedarían los cuadros antes de colgarlos
-
Eventos Especiales13 años ago
Especial Día de la Madres: fondos de pantalla especiales para Mamá